Apuntes · Capítulo 15Flujo e intratabilidad
Qué hacer con un problema difícil
Qué hacer con un problema difícil
La semana pasada terminó con una lista de problemas NP-completos y una advertencia: “es NP-completo” no quiere decir “no se puede resolver”. Quiere decir que, salvo que P = NP, ningún algoritmo va a ser rápido en todos los casos y exacto en todos los casos a la vez. Una empresa que tiene que repartir mañana no se queda en esa frase. Tiene que hacer algo.
Esta semana es ese algo, y lo vamos a trabajar con un solo problema a lo largo de todo el capítulo: el viajero, con las capitales regionales del Perú. Ya lo conocen. En la semana 10 lo resolvimos con Held-Karp, en O(n²·2ⁿ), y la semana pasada vieron a qué familia pertenece. Vamos a medir distancias reales, a calcular el óptimo de varias formas y a compararlo con métodos que no lo buscan.
Lo importante es no mezclar tres cosas muy distintas, aunque todas se usen para lo mismo:
- Una búsqueda exacta con poda da el óptimo siempre y garantiza eso, pero su tiempo puede ser exponencial.
- Un algoritmo de aproximación es polinomial y tiene una garantía demostrada, sin conocer el óptimo: “esto es a lo sumo el doble del óptimo”.
- Una heurística suele dar buenas respuestas, y no promete nada.
La primera sesión desarrolla esas tres opciones. La segunda presenta la programación lineal como idea, que se puede cortar si falta tiempo, y luego repasa el curso con una pregunta: dado un problema nuevo, ¿qué técnica sirve?
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Las preguntas antes de elegir, El viajero con datos de verdad y Aproximación: garantía sin conocer el óptimo.
En clase: Sesión A, de Búsqueda exacta: backtracking con poda a Heurísticas: mejora local con 2-opt. Sesión B, ✂️ Programación lineal como idea si hay tiempo, y Repaso: dado un problema nuevo, ¿qué técnica sirve?
Después de clase: La comparación completa, el Resumen y los Ejercicios, para repasar, y la lista de resultados para el final. Antes del laboratorio, El código de la semana. Para ampliar, Qué sigue y las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: las notas Approximation Algorithms de Erickson, aparte del libro, en especial J.3 (Greedy Vertex Cover), J.5 (Vertex Cover Redux), J.8 y J.9 (Traveling Salesman: The Bad News y The Good News), disponibles en https://jeffe.cs.illinois.edu/teaching/algorithms/notes/J-approx.pdf, y la sec. 2.4 (The General Pattern) del libro. CLRS, capítulo Approximation Algorithms, 4.ª edición. Sesión B: las notas Linear Programming de Erickson, aparte del libro, en especial H.1 a H.3, disponibles en https://jeffe.cs.illinois.edu/teaching/algorithms/notes/H-lp.pdf. CLRS, capítulo Linear Programming, 4.ª edición. Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-15. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los dos problemas de laboratorio están enlab/peru_exactylab/peru_tour, cada uno con su propiomake test. Algunos ejemplos usanheld_karp.hde la semana 10.
Las preguntas antes de elegir
Frente a un problema NP-difícil no se empieza programando. Se hacen cuatro preguntas, más o menos en este orden.
¿La entrada es pequeña? Exponencial no significa inútil. Doce clientes se resuelven con Held-Karp sin que nadie note la espera. Si n es chico y va a seguir siéndolo, el problema difícil está resuelto: se usa un algoritmo exacto y se sigue con otra cosa. Hay que hacer la cuenta, y hacerla también con la memoria.
¿Mi entrada tiene una estructura especial? La demostración de NP-completitud habla del problema general. El suyo puede ser un caso particular, y ya vimos dos en este curso:
- Cobertura de vértices en árboles. En un grafo general es NP-difícil, como se vio en las semanas 13 y 14. En un árbol, la semana 9 la resolvió con programación dinámica en tiempo lineal: en cada nodo, dos estados, dentro o fuera. Lo que hace posible esa tabla es que quitar un nodo separa el árbol en partes independientes.
- Mochila con números pequeños. La mochila de decisión es NP-completa, pero la semana 7 la resolvió en O(nW). Ese tiempo es pseudopolinomial: no es polinomial en los bits de W, pero si W es chico, es excelente. La dificultad estaba en los números enormes.
También hay fronteras que conviene recordar de la semana pasada: 2-SAT frente a 3-SAT, 2-coloreo frente a 3-coloreo. Una restricción del enunciado que parecía un detalle puede cambiar el problema de clase.
¿Sirve una respuesta cercana? Si el dinero que se ahorraría el óptimo no paga el tiempo de encontrarlo, una respuesta cercana basta. Y hay dos formas de “cercana”: con garantía o sin garantía. Es el centro de la sesión.
¿Ya existe un solucionador? En la semana 13 usaron minisat para resolver sudokus: se traduce el problema y se deja
que una herramienta madura haga la búsqueda. Para SAT, y para la programación lineal que veremos después, hay
solucionadores que aguantan instancias enormes en la práctica, aunque ninguno promete serlo en todas. Antes de escribir
su propia búsqueda, vean si su problema se escribe en el idioma de uno.
| Pregunta | Si la respuesta es sí | Qué se obtiene | Qué se pierde |
|---|---|---|---|
| ¿Entrada pequeña? | Held-Karp, búsqueda con poda | El óptimo | Nada, mientras n siga chico |
| ¿Estructura especial? | Un algoritmo para ese caso | El óptimo, en tiempo polinomial | Solo sirve para ese caso |
| ¿Sirve algo cercano, con garantía? | Algoritmo de aproximación | Polinomial, con factor demostrado | El óptimo |
| ¿Sirve algo cercano, sin garantía? | Heurística | Suele ser muy bueno | La garantía |
| ¿Hay un solucionador? | Traducir el problema | Una herramienta probada | El control sobre el tiempo |
Idea clave. Estas opciones no se excluyen. Un programa serio suele combinarlas. Una heurística da un buen recorrido, y ese recorrido ayuda a una búsqueda exacta a podar. Una aproximación da un tope, y un algoritmo exacto corta cuando ya no puede mejorarlo.
El viajero con datos de verdad
Toda la sesión usa capitales.csv: 26 lugares del Perú, las sedes de los gobiernos regionales, incluidas Huacho y
Callao, más Lima. Las coordenadas son de GeoNames, con licencia CC BY 4.0, y capitales.md
explica de qué archivo salieron y qué se conservó. Para comparar con menos ciudades, usamos subconjuntos fijos: las
primeras 10, 15 y 20 filas del archivo, que está en orden alfabético, salvo Huaraz y Huánuco, que están invertidos.
Antes de cualquier algoritmo hay que decidir qué es la distancia, y aquí hay tres decisiones.
No es una carretera. La distancia de este capítulo es la del gran círculo: el camino más corto sobre la superficie de una esfera, aquí de radio 6371 km. De Cusco a Puerto Maldonado por carretera hay mucho más que eso, porque hay una cordillera en medio. Tampoco es una ruta aérea real. Es un modelo, elegido porque tiene una propiedad que vamos a necesitar.
Se calcula con la fórmula de haversine, con φ la latitud y λ la longitud, en radianes:
h = sin²((φ₂ − φ₁) / 2) + cos φ₁ · cos φ₂ · sin²((λ₂ − λ₁) / 2)
distancia = 2 · R · arcsen(√h)
Esta fórmula se porta bien con puntos muy cercanos, como Lima y Callao, que es donde otras se quedan sin precisión.
Se guarda en metros enteros, redondeados hacia arriba. Aquí conviene detenerse, porque es una decisión con consecuencias. Veamos primero qué propiedad hay que cuidar.
La desigualdad triangular
Una matriz de distancias cumple la desigualdad triangular si para tres nodos cualesquiera a, b, c:
d(a, c) ≤ d(a, b) + d(b, c)Es decir, ir directo nunca es peor que pasar por un tercero. Un viajero con esta propiedad, además de distancias simétricas y no negativas, es un viajero métrico. Veremos que de ella depende una garantía entera, así que queremos que se cumpla exactamente en nuestros datos.
El gran círculo la cumple para valores reales. La razón es corta: d(a, c) es el largo de la curva más corta de a a c, y pegar la curva más corta de a a b con la de b a c da una curva de a a c, que entonces no puede ser más corta que aquella.
El problema aparece al redondear. Si se redondea al entero más cercano, la desigualdad se puede romper. Con tres puntos sobre el ecuador, separados 1000,4 m:
$ build/metric_demo
...
Tres puntos sobre el ecuador:
  reales: ab = 1000.400, bc = 1000.400, ac = 2000.800
  al más cercano: 1000 + 1000 < 2001
  hacia arriba: 1001 + 1001 >= 2001
Redondear hacia arriba, en cambio, la conserva siempre.
Afirmación. Si a ≤ b + c con a, b y c reales, entonces ⌈a⌉ ≤ ⌈b⌉ + ⌈c⌉.
Técnica. Directa, usando que el techo es el menor entero que no queda debajo.
Demostración. Como b ≤ ⌈b⌉ y c ≤ ⌈c⌉, tenemos a ≤ b + c ≤ ⌈b⌉ + ⌈c⌉. El lado derecho es un entero que no queda debajo de a, y ⌈a⌉ es el menor entero con esa propiedad. Por lo tanto, ⌈a⌉ ≤ ⌈b⌉ + ⌈c⌉. ∎
Tener enteros trae otras dos ventajas, que veremos con la heurística y con el laboratorio: comparar dos recorridos es exacto, sin tolerancias, y cada mejora baja el largo en al menos 1 m. Un metro más o menos no le importa a nadie en un recorrido de miles de kilómetros.
La demostración vale para los valores exactos, pero la computadora calcula con double. Por eso también hay que mirar
los datos. metric_demo revisa todas las ternas ordenadas:
$ build/metric_demo
26 lugares, 325 pares
más cercanos: Callao y Lima, 11595.553 m
más lejanos: Tacna y Tumbes, 1953471.901 m
lo más cerca de un entero que queda una distancia: 0.000237 m
peor error relativo de tratar los grados como un plano: 3.577 %

Desigualdad triangular, d(a,c) <= d(a,b) + d(b,c), en todas las ternas:
  double, en metros: 0 de 15600 ternas la rompen
  entero, redondeado hacia arriba: 0 de 15600 ternas la rompen
  entero, al más cercano: 0 de 15600 ternas la rompen
la terna más justa: Callao, Chiclayo, Piura, le sobran 0.003 m
...
En estos 26 lugares, ninguna forma de guardar la distancia rompe la desigualdad, ni siquiera el redondeo al más cercano, que en general sí puede. Fíjense en la terna más justa: el rodeo por Chiclayo de Callao a Piura alarga el camino solo 3 mm, aunque la ciudad queda a unos 29 m del gran círculo. Pasó por suerte de las posiciones. Con otra capital, o con otros datos, ese redondeo podría haber fallado por 1 m, y el redondeo hacia arriba no.
La cuarta línea importa por otro motivo. Ninguna distancia real queda a menos de 0,2 mm de un entero, y el error de
cálculo de un double en estas cuentas es mucho menor. Por eso ⌈⌉ da el mismo entero en cualquier programa que use
esta fórmula con double, y dos programas distintos pueden comparar resultados exactos.
En C++.
geo.htienegreat_circle_m, el valor real en metros, ydistance_m, el entero.distance_matrixarma la matriz simétrica, yfirst_placestoma las primeras n filas. Lima y Callao están a 11596 m: es el par más cercano y un buen caso de borde.
Error común. Tratar los grados como si fueran un plano y usar √(Δlat² + Δlon²). Un grado de longitud mide menos cuanto más lejos del ecuador. En el Perú, que está cerca del ecuador, el peor error en estos datos es 3,577 %. Suena poco, pero basta para elegir otro recorrido, como muestra uno de los casos del laboratorio. Más al sur, sería peor.
Búsqueda exacta: backtracking con poda
Empecemos por la opción que no renuncia a nada. El backtracking de un viajero arma el recorrido ciudad por ciudad. Cada nodo del árbol de búsqueda es un recorrido parcial: salió de 0 y lleva visitadas algunas ciudades. Sus hijos son las formas de agregar una más.
Sin poda, ese árbol es enorme. A profundidad k hay (n − 1)(n − 2)⋯(n − k) nodos, y en total, con n = 10, son 986410 nodos. Con 26 ciudades, sus hojas son 25! ≈ 1,55 × 10²⁵.
Pero hay ramas que no vale la pena explorar. Si ya conocemos un recorrido de largo B, y una rama no puede bajar de B, se corta. Esa es la poda (pruning), y su forma más general se llama ramificación y acotamiento (branch and bound): ramificar es crear los hijos, acotar es calcular, para cada nodo, una cota de lo mejor que puede dar esa rama.
algoritmo buscar(último, resto, largo)
    si resto está vacío entonces
        mejor ← mín(mejor, largo + d(último, 0))
        devolver
    fin si
    si largo + cota(último, resto) ≥ mejor entonces
        devolver
    fin si
    para cada v en resto, de más cerca a más lejos de último hacer
        buscar(v, resto - {v}, largo + d(último, v))
    fin para
fin algoritmo
mejor empieza en infinito, y buscar(0, {1, …, n − 1}, 0) hace el recorrido. Probar primero lo más cercano no cambia
el resultado. Sirve para encontrar pronto un buen recorrido y podar más desde el principio.
Cuándo una cota es válida
Todo depende de una sola condición sobre cota:
Condición. cota(último, resto) nunca pasa del largo de la mejor forma de terminar el recorrido desde
último, pasando por todorestoy volviendo a 0. Es una cota inferior.
Teorema. Si la cota cumple esa condición, el algoritmo devuelve el óptimo.
Técnica. Se razona sobre qué se pierde con cada corte.
Demostración. Sin poda, el algoritmo recorre todos los recorridos y mejor termina siendo el mínimo. Veamos qué se
pierde al podar en un nodo. Se poda si largo + cota ≥ mejor. Cualquier recorrido completo de esa rama mide largo más lo
que cueste terminarlo, y eso último es al menos cota, por la condición. Así, ese recorrido mide por lo menos largo +
cota ≥ mejor. Por lo tanto, la rama no tiene ningún recorrido estrictamente mejor que mejor, que ya es el largo de un
recorrido real. Ningún corte pierde el óptimo, y mejor llega a él. ∎
Error común. Usar una “cota” que puede pasarse, como el largo del árbol duplicado que veremos enseguida, o un promedio. Esa cota poda demasiado, y el programa devuelve una respuesta que no es óptima sin avisar de nada. Una cota más floja solo cuesta tiempo. Una cota que se pasa cuesta la correctitud.
La cota más simple es 0: se poda solo si lo ya recorrido alcanza a mejor. Es válida, porque las distancias no son
negativas, pero no mira lo que falta.
Una mejor mira lo que falta. Para terminar, hay que salir de último hacia algún nodo de resto, pasar por todos los
nodos de resto y volver a 0 desde alguno de ellos.
Afirmación. Sea A el peso de un árbol de expansión mínima de resto. Entonces la siguiente es una cota inferior
válida:
cota = mín sobre r en resto de d(último, r) + A + mín sobre r en resto de d(r, 0)Técnica. Se parte cualquier forma de terminar en tres pedazos, y se acota cada uno.
Demostración. Tomemos una forma cualquiera de terminar: último → r₁ → r₂ → ⋯ → rₖ → 0, con r₁, …, rₖ una permutación
de resto. La primera arista mide al menos el primer mínimo, y la última, al menos el segundo. Las del medio forman un
camino que pasa por todos los nodos de resto. Un camino así es un árbol de expansión de resto, y entonces pesa al
menos A. Sumando, esa forma de terminar mide al menos la cota. ∎
Fíjense en dos cosas. La demostración no usó la desigualdad triangular, así que esta cota sirve para cualquier viajero simétrico con pesos no negativos. Y el árbol de expansión mínima, que viene de la semana 6, cuesta O(r²) con Prim sobre r nodos en cada nodo de la búsqueda. Es trabajo extra por nodo, y se paga si poda lo suficiente.
Medir la poda
bound.h implementa las tres versiones. Devuelve el costo y la cantidad de nodos visitados, sin el recorrido. Contar
nodos es mejor que medir segundos, porque el número no depende de la máquina:
$ build/bound_demo
 n  sin poda      lo recorrido  con cota de árbol  costo (m)
 6       326           290                 86    2646313
 8     13700          6290                535    3085034
10    986410        146810               3157    3167199
11   9864101        802246               8567    3177709
12         -       4768125              23473    3180694
13         -      24676909              49358    3200397
El guion quiere decir que esa versión no se corrió. Las pruebas comprueban que las tres dan el mismo costo que Held-Karp en 200 instancias al azar, métricas y no métricas, y que la cota nunca se pasa del mejor final posible, calculado a la fuerza.
Con los casos grandes, en una corrida de cada uno, con -O2 y con tiempos que dependen de la máquina:
$ build/bound_bench
 n  poda                       nodos       costo     tiempo
15  lo recorrido           622800727    3225.0 km    21.44 s
15  con cota de árbol         71523    3225.0 km     0.02 s
20  con cota de árbol      13042082    4640.2 km     4.93 s
26  con cota de árbol      18575558    5621.6 km    14.91 s
Con 15 ciudades, la cota de árbol visita unas 8700 veces menos nodos. Con 26 termina, y da 5621,6 km, el óptimo de las 26 capitales con esta distancia. Es un resultado exacto para una instancia en la que Held-Karp necesitaría unos 2²⁵ × 25 × 8 bytes ≈ 6,7 GB solo para su tabla.
No saquen de aquí una ley. Pasar de 20 a 26 ciudades aumentó poco los nodos, porque el tamaño del árbol podado depende de cómo son los datos, no solo de n. No hay una fórmula para predecirlo, y en el peor caso sigue siendo exponencial. Una variante de esta búsqueda que además recuerda el recorrido tardó, en una corrida, 5,44 s con las primeras 20 filas y 0,49 s con las últimas 20.
Idea clave. La poda cambia el tiempo y no la respuesta. Una búsqueda con poda es un algoritmo exacto, no una aproximación. No hay factor, no hay “casi”: el resultado es el óptimo, y el precio es que no sabemos de antemano cuánto va a tardar.
En la práctica. Una búsqueda exacta en serio arranca con un buen recorrido, de una heurística, y usa cotas mucho más fuertes que esta. Con esas ideas, los programas especializados han resuelto instancias de miles de ciudades con óptimo demostrado. Son tan exponenciales como esta en el peor caso. Solo que los casos que importan no son el peor.
Aproximación: garantía sin conocer el óptimo
Supongamos ahora que renunciamos al óptimo, pero no a la garantía.
Un algoritmo de aproximación (approximation algorithm) para un problema de minimización corre en tiempo polinomial y tiene factor de aproximación (approximation ratio) α ≥ 1 si, para toda instancia:
valor que devuelve ≤ α · OPTdonde OPT es el valor óptimo. En un problema de maximización, se pide valor ≥ OPT / α.
Hay tres palabras que importan: es polinomial, es para toda instancia, y está demostrado. Medir el resultado en 100 instancias no da un factor. La pregunta difícil es otra: ¿cómo se demuestra que algo está cerca de OPT, si OPT es justamente lo que no se sabe calcular?
La respuesta es la idea de toda esta parte. No se compara contra OPT. Se compara contra una cota inferior de OPT, algo que sí se puede calcular y que se sabe que no pasa de OPT:
valor que devuelve ≤ α · (cota inferior) ≤ α · OPTSi L ≤ OPT y el algoritmo da a lo sumo αL, ya está. Entonces, diseñar una aproximación consiste en encontrar la cota inferior correcta, y después un método que la use. Esta sesión tiene dos ejemplos: un matching maximal para la cobertura de vértices y un árbol de expansión mínima para el viajero.
Cobertura de vértices: factor 2
Recuerden: una cobertura de vértices es un conjunto de nodos que toca a todas las aristas, y encontrar una mínima es NP-difícil en un grafo general. Queremos una de tamaño a lo sumo el doble del mínimo.
Una idea parecida que falla
Lo primero que se le ocurre a cualquiera: revisar las aristas, y por cada una sin cubrir elegir una de sus puntas. Eso siempre da una cobertura, y elige solo un nodo por arista. Parece muy económico:
$ build/cover_demo
Estrella con centro 0 y 6 hojas:
  una sola punta: {1, 2, 3, 4, 5, 6}
  matching maximal, 1 aristas: {0, 1}
  mayor grado: {0}
  óptimo por fuerza bruta: 1
...
La regla eligió las seis hojas, y bastaba con el centro. Con n − 1 hojas, da n − 1 frente a 1. Ningún factor constante le sirve. Lo que pasa es que escoger una punta “por casualidad” no dice nada de lo que hace el óptimo.
La idea que sí funciona
Ahora, una que suena peor: por cada arista sin cubrir, elegir las dos puntas.
algoritmo cobertura_por_matching(aristas)
    C ← vacío
    M ← vacío
    para cada arista {u, v} en aristas hacer
        si u no está en C y v no está en C entonces
            M ← M + {{u, v}}
            C ← C + {u, v}
        fin si
    fin para
    devolver C
fin algoritmo
El conjunto M tiene una propiedad con nombre. Es un matching: sus aristas no comparten nodos, porque una arista solo entra si sus dos puntas estaban libres. Y es un matching maximal: no se le puede agregar ninguna arista más.
Error común. Confundir maximal con máximo. Maximal es que no le cabe nada más, sin sacar algo. Máximo es que no existe otro más grande. Este algoritmo encuentra un matching maximal con un solo recorrido por las aristas. Encontrar uno máximo, en un grafo bipartito, requiere lo de la semana 12, y en un grafo general, algo más. Aquí no hace falta.
El camino 0-1-2-3 muestra la diferencia. Si la primera arista es 1-2, el matching se queda con ella sola, pues las otras dos tocan a 1 o a 2. Es maximal, de tamaño 1, y no es máximo, porque {0-1, 2-3} tiene tamaño 2:
$ build/cover_demo
...
Camino 0-1-2-3, primero la arista 0-1:
  una sola punta: {1, 3}
  matching maximal, 2 aristas: {0, 1, 2, 3}
  mayor grado: {1, 2}
  óptimo por fuerza bruta: 2

Camino 0-1-2-3, primero la arista 1-2:
  una sola punta: {2, 1}
  matching maximal, 1 aristas: {1, 2}
  mayor grado: {1, 2}
  óptimo por fuerza bruta: 2

Una sola arista:
  una sola punta: {1}
  matching maximal, 1 aristas: {0, 1}
  mayor grado: {0}
  óptimo por fuerza bruta: 1
...
La demostración
Teorema. cobertura_por_matching corre en tiempo lineal en la cantidad de aristas y devuelve una cobertura C con
|C| ≤ 2 · OPT, donde OPT es el tamaño de una cobertura mínima.
Técnica. La cota inferior es el tamaño del matching: se compara contra |M|, no contra OPT.
C es una cobertura. Tomemos una arista {u, v} cualquiera. Cuando el ciclo la revisó, o alguna de sus puntas ya estaba en C, o no, y entonces se agregaron las dos. En los dos casos, al terminar, tiene una punta en C.
Cota inferior: OPT ≥ |M|. Sea C* una cobertura cualquiera, en particular una mínima. Cada arista de M tiene al menos una punta en C*, porque C* es una cobertura. Las aristas de M no comparten nodos, así que esas puntas son todas distintas: una por arista. Por lo tanto, |C*| ≥ |M|.
El tamaño. Cada arista de M puso exactamente dos nodos en C, sin repetir, así que |C| = 2|M|.
Conclusión. |C| = 2|M| ≤ 2 · OPT. ∎
El argumento nunca calculó OPT, y aun así dice algo sobre él en todas las instancias. Fíjense en dónde se usó que M es un matching: que las aristas sean disjuntas es lo que obliga a C* a pagar un nodo distinto por cada una. Sobre una lista de aristas cualquiera, ese paso no vale.
¿Se puede mejorar el factor con este análisis? No. Con una sola arista, el algoritmo elige 2 nodos y el óptimo es 1. El factor 2 se alcanza exactamente, y así el análisis no tiene holgura.
Idea clave. El óptimo está obligado a pagar algo por cada arista de M. Y este algoritmo paga exactamente el doble de eso. La demostración de un factor casi siempre tiene esta forma: lo que “tiene que pagar” cualquier solución, frente a lo que paga el algoritmo.
¿Y el mayor grado?
La regla natural de un greedy sería elegir el nodo que cubre más aristas sin cubrir, y repetir. En los ejemplos de arriba le fue muy bien. Corramos una comparación honesta:
$ build/cover_demo
...
300 grafos al azar, 16 nodos, cada arista con probabilidad 1/4:
  promedio del óptimo: 8.71333
  promedio del matching: 13.18, peor razón 2
  promedio del mayor grado: 9, peor razón 1.25
En estos grafos, el mayor grado gana con mucha ventaja. Si esto fuera todo lo que supiéramos, lo elegiríamos sin pensar. Pero no tiene factor 2. Hay una familia de grafos en su contra.
Para un k dado, hay k nodos a la izquierda. Para cada i de 2 a k, se agrega un grupo de ⌊k/i⌋ nodos a la derecha, y cada uno se une a i nodos de la izquierda, sin repetir nodos de la izquierda dentro del grupo.
Afirmación. En esa familia, la regla del mayor grado elige todos los nodos de la derecha, sin importar cómo desempate.
Técnica. Inducción sobre los grupos, de i = k hacia abajo.
Demostración. Mantenemos este invariante: cuando quedan por elegir los grupos 2, …, i, un nodo del grupo i tiene grado i, porque no se ha elegido ninguno de sus vecinos, y un nodo de la izquierda tiene grado a lo sumo i − 1, porque toca a lo sumo un nodo de cada grupo restante. Los grupos menores tienen grado menor que i. Por lo tanto, la regla elige un nodo del grupo i y nunca uno de la izquierda. Elegir un nodo de la derecha no le baja el grado a ningún otro de la derecha, ya que no hay aristas entre ellos. Al terminar el grupo i, el invariante vale con i − 1. ∎
Los k nodos de la izquierda ya son una cobertura, así que OPT ≤ k. En cambio, la regla elige Σ ⌊k/i⌋ nodos, de i = 2 a k, que es al menos Σ (k/i − 1) = k(1/2 + ⋯ + 1/k) − (k − 1). Dividido entre k, esa suma crece sin límite, como el logaritmo de k.
$ build/cover_demo
...
La trampa del mayor grado:
   k  nodos  aristas  mayor grado  matching  mayor grado / k
   6  14  27  8  12  1.33333
  12  35  115  23  24  1.91667
  24  84  467  60  48  2.5
  48  198  1882  150  96  3.125
  96  459  7561  363  192  3.78125
 192  1047  30298  855  384  4.45312
En todas las filas el matching tiene exactamente k aristas: eso demuestra que OPT ≥ k y, con OPT ≤ k, que OPT = k. Así que la última columna es la razón verdadera. Con k = 24 ya pasa de 2, y sigue creciendo. Mientras tanto, el matching da 2k, justo en su garantía.
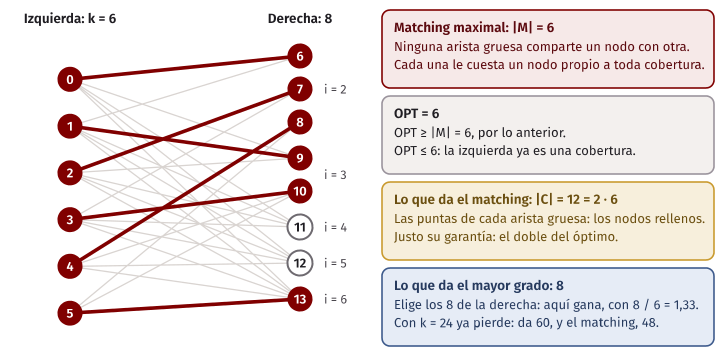
Hay que ser precisos con lo que eso dice. La regla del mayor grado sí tiene una garantía: Erickson (J.3) demuestra que es una O(log n)-aproximación. Lo que no tiene es un factor constante, y por eso no tiene factor 2. En los grafos al azar midió mucho mejor que el matching, y aun así el peor caso que se puede garantizar es peor. Las dos cosas son ciertas.
En la práctica. Se puede correr las dos reglas y quedarse con la menor. El resultado mantiene el factor 2, porque es a lo sumo lo que dio el matching, y suele ser tan bueno como el del mayor grado.
El viajero métrico: duplicar el árbol
Ahora, el problema de la semana. Queremos un recorrido de largo a lo sumo el doble del óptimo. Siguiendo la receta, primero la cota inferior.
El árbol de expansión mínima es una cota inferior
Teorema. Con pesos no negativos, sea A el peso de un árbol de expansión mínima, y OPT el largo del recorrido más corto. Entonces A ≤ OPT.
Técnica. Se transforma el recorrido óptimo en un árbol de expansión.
Demostración. Tomen el recorrido óptimo y quítenle una arista cualquiera. Queda un camino que pasa por todos los nodos. Ese camino es conexo y no tiene ciclos, así que es un árbol de expansión. Su peso es a lo sumo OPT, porque quitar una arista con peso no negativo no aumenta la suma. Y A es el peso del menor de todos los árboles de expansión, así que A ≤ OPT. ∎
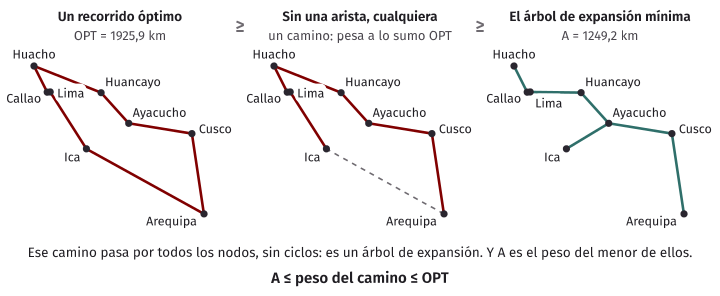
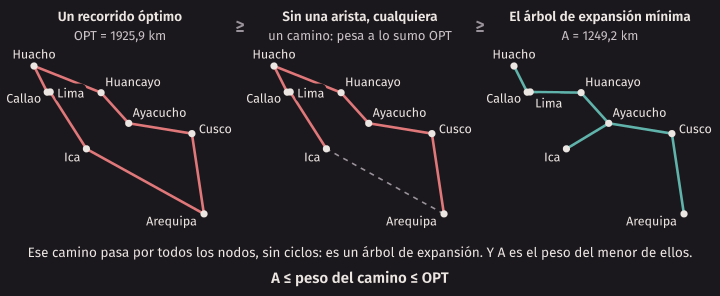
Esta es la pregunta 2 de repaso, y la idea es la misma de antes: el óptimo también “tiene que pagar” al menos el árbol. No hace falta conocer el óptimo, y el árbol se calcula con Prim o Kruskal, de la semana 6, en tiempo polinomial.
El algoritmo
algoritmo arbol_duplicado(d, n)
    T ← árbol de expansión mínima de d, con raíz en 0
    caminata ← recorrer T con DFS, escribiendo cada nodo al llegar y al volver a él
    recorrido ← caminata, conservando de cada nodo solo su primera aparición
    devolver recorrido
fin algoritmo
Un DFS recorre cada arista del árbol dos veces, una de ida y otra de vuelta, de modo que la caminata mide exactamente 2A. Pero repite nodos, y eso no es un recorrido del viajero. Por eso hay un tercer paso, atajar: si la caminata va a volver a un nodo ya visitado, se salta directo al siguiente nuevo. El resultado es justo el preorden del árbol.
Veámoslo paso a paso, con ocho capitales del centro y del sur:
$ build/double_tree_demo
Aristas del árbol de expansión mínima, con raíz en Lima:
  Lima - Callao: 11,6 km
  Lima - Huancayo: 197,7 km
  Callao - Huacho: 115,9 km
  Huancayo - Ayacucho: 162,2 km
  Ayacucho - Ica: 192,2 km
  Ayacucho - Cusco: 247,5 km
  Cusco - Arequipa: 322,1 km
peso del árbol: 1249,2 km

Caminata, cada arista dos veces:
  Lima Callao Huacho Callao Lima Huancayo Ayacucho Ica Ayacucho Cusco Arequipa Cusco Ayacucho Huancayo Lima
largo de la caminata: 2498,4 km

Atajando las repeticiones:
  Lima Callao Huacho Huancayo Ayacucho Ica Cusco Arequipa y de vuelta a Lima
largo del recorrido: 2261,4 km
óptimo, con Held-Karp: 1925,9 km
dos veces el árbol: 2498,4 km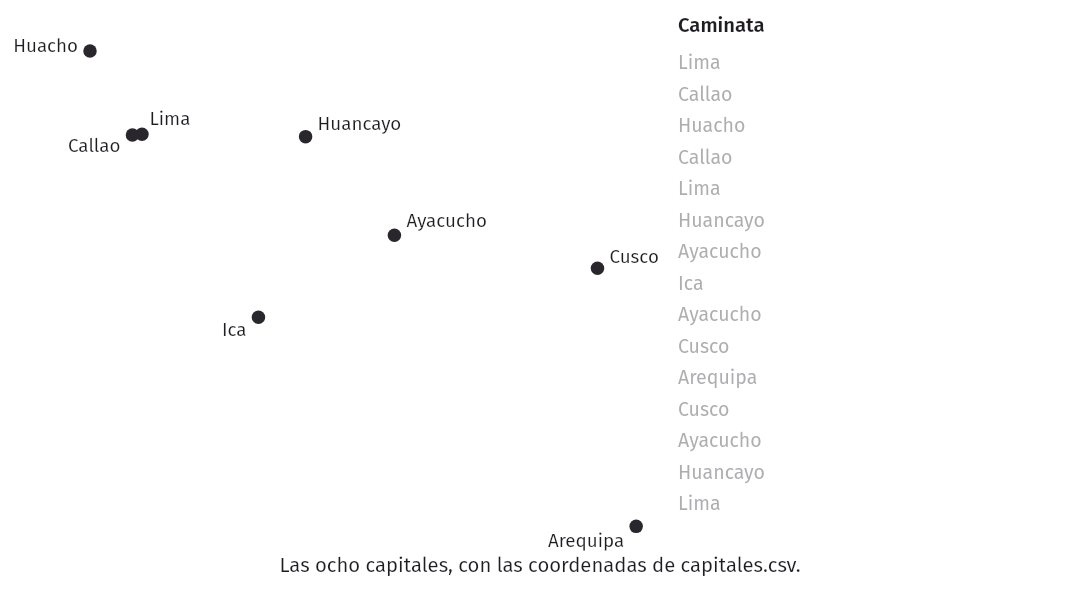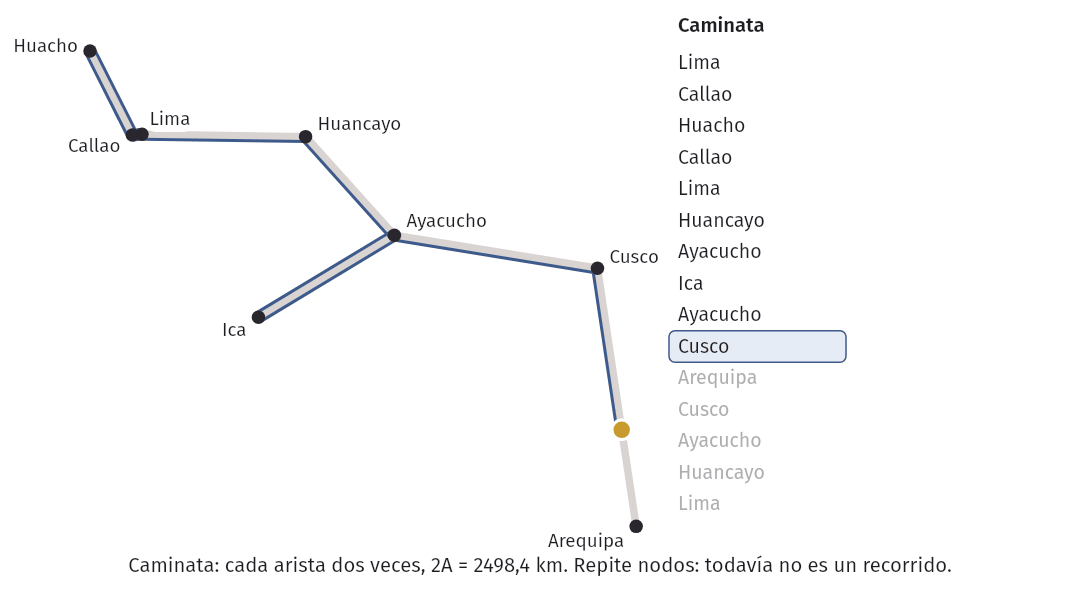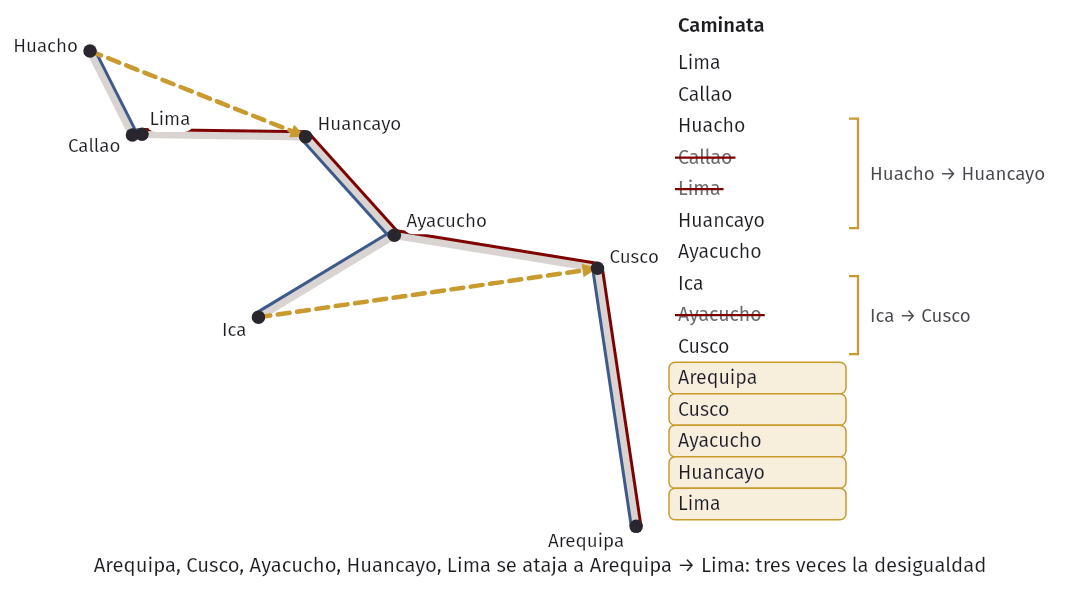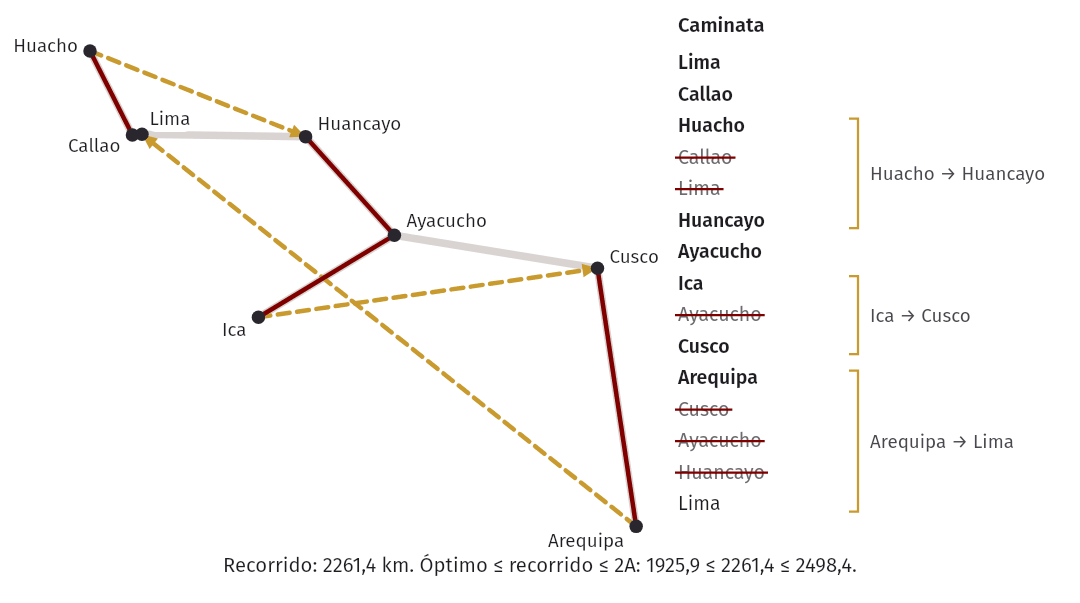
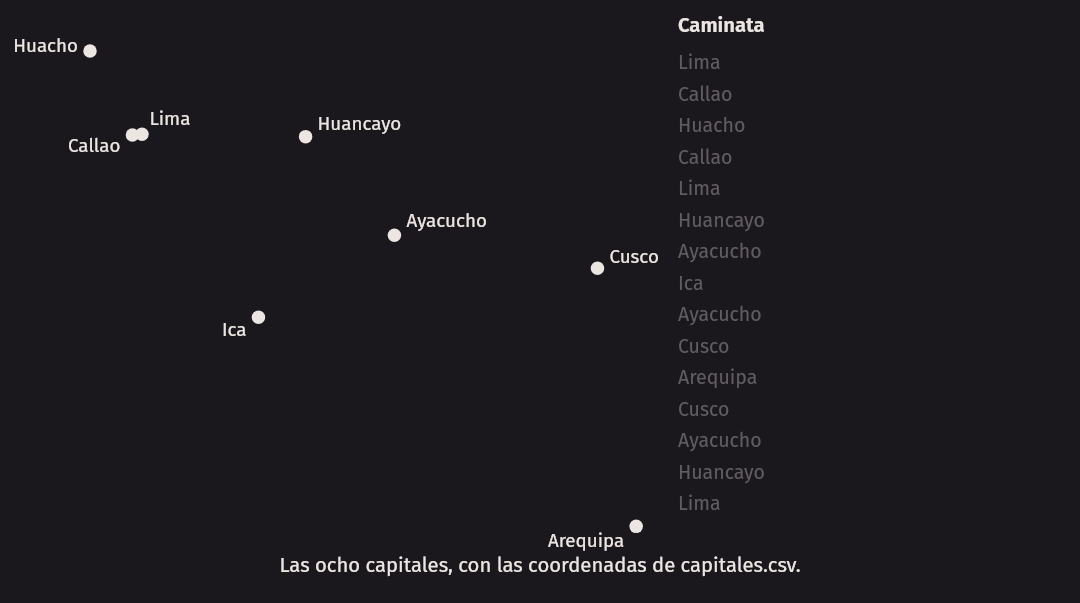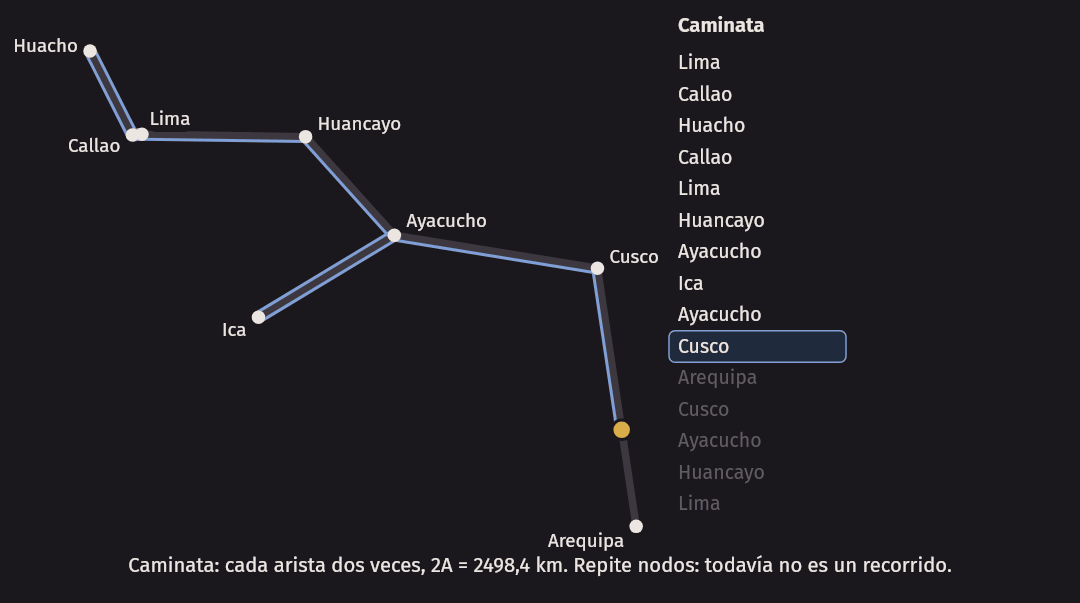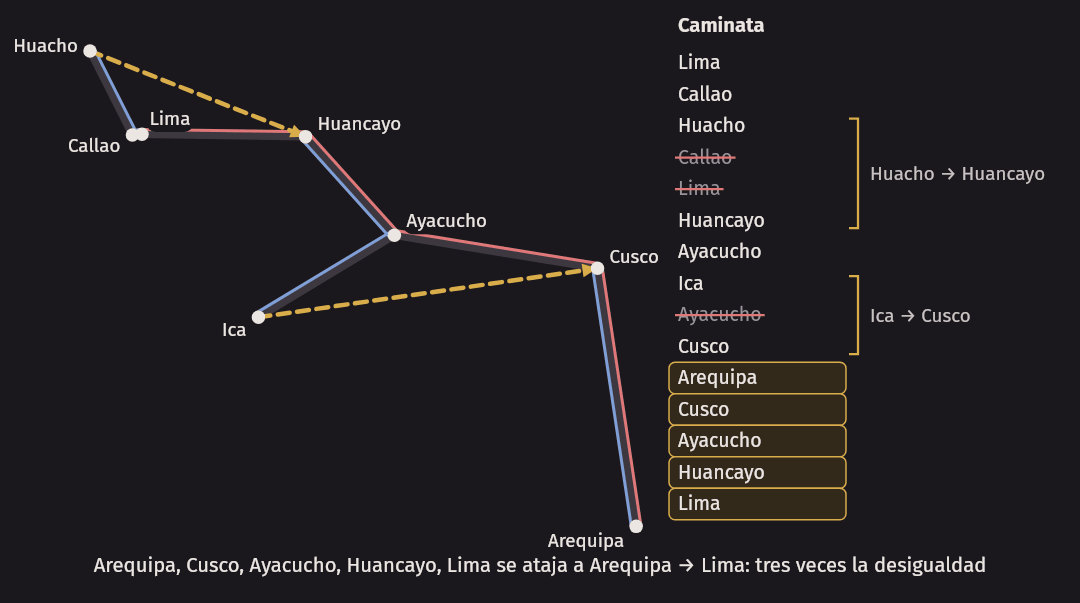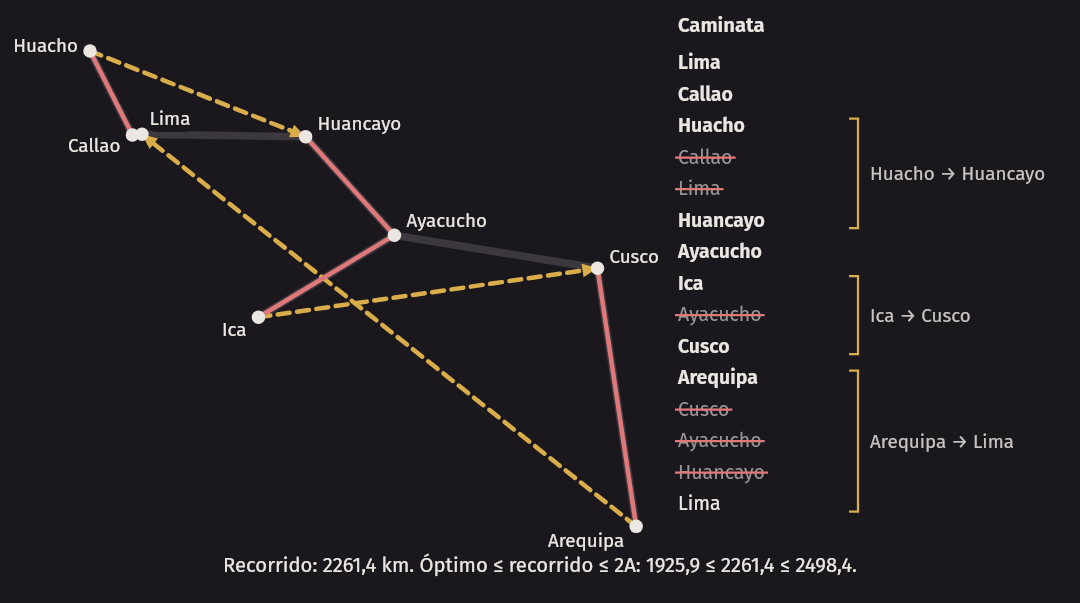
Sigamos los atajos. La caminata empieza Lima, Callao, Huacho, y vuelve a Callao y a Lima, que ya se visitaron, para ir luego a Huancayo. El recorrido, en cambio, va de Huacho directo a Huancayo.
| Tramo de la caminata | Lo que hace el recorrido | Por qué no se alarga |
|---|---|---|
| Huacho, Callao, Lima, Huancayo | Huacho → Huancayo | Dos veces la desigualdad triangular |
| Ica, Ayacucho, Cusco | Ica → Cusco | d(Ica, Cusco) ≤ d(Ica, Ayacucho) + d(Ayacucho, Cusco) |
| Arequipa, Cusco, Ayacucho, Huancayo, Lima | Arequipa → Lima | Tres veces la desigualdad triangular |
El resultado cumple lo prometido: 1925,9 ≤ 2261,4 ≤ 2498,4 = 2A, y 2261,4 / 1925,9 está lejos de 2.
La demostración
Teorema. Con una matriz de distancias simétrica, no negativa y que cumple la desigualdad triangular,
arbol_duplicado da en tiempo polinomial un recorrido de largo a lo sumo 2 · OPT.
Técnica. La cota inferior es A, y se encadenan tres desigualdades.
Es un recorrido. Un árbol de expansión contiene todos los nodos, así que la caminata los visita a todos. Al conservar la primera aparición de cada uno, cada nodo queda exactamente una vez.
La caminata mide 2A. El DFS pasa por cada arista exactamente dos veces, una en cada sentido. Con distancias simétricas, las dos pasadas cuestan lo mismo. Por lo tanto, la caminata mide 2A.
Atajar no alarga. Consideren un tramo de la caminata entre dos nodos consecutivos del recorrido, x e y: x, z₁, …, zₖ, y, donde los zᵢ son repetidos. Aplicando la desigualdad triangular k veces:
d(x, y) ≤ d(x, z₁) + d(z₁, y) ≤ d(x, z₁) + d(z₁, z₂) + d(z₂, y) ≤ ⋯ ≤ d(x, z₁) + ⋯ + d(zₖ, y)Así, cada tramo del recorrido no mide más que el tramo de la caminata que reemplaza, y lo mismo vale para el último tramo, que vuelve a la raíz. Sumando, el recorrido mide a lo sumo lo que mide la caminata.
Conclusión. largo del recorrido ≤ 2A ≤ 2 · OPT. La última desigualdad es el teorema anterior. ∎
Esta es la pregunta 3 de repaso. La desigualdad triangular se usa en un solo paso: al atajar. La cota A ≤ OPT no la necesita, y la caminata de largo 2A tampoco. Sin ella, se tiene una caminata barata con nodos repetidos, y nada dice que quitar las repeticiones la mantenga barata. Enseguida veremos cuánto puede costar eso.
Error común. Omitir el paso de atajar y entregar la caminata. Mide exactamente 2A y su análisis es perfecto, pero no es una solución: pasa varias veces por la misma ciudad. El verificador del laboratorio rechaza esa salida. En un problema de aproximación hay que comprobar primero que la respuesta sea válida, y solo después cuánto mide.
En la práctica. Factor 2 es una garantía modesta, y se conoce algo mejor: el algoritmo de Christofides, de 1976, tiene factor 3/2 en el caso métrico, con un matching de costo mínimo. No lo vemos aquí. Lo que queremos es la forma del argumento.
Una idea parecida, sin garantía de este curso
Antes de ver los números, comparemos con el greedy que se le ocurre a todo el mundo: desde donde estoy, voy a la ciudad libre más cercana. Se llama vecino más cercano (nearest neighbor). Cada paso es barato y el total puede quedar mal, porque al final hay que volver desde donde se terminó, y lo que se dejó para el final está lejos. En nuestros datos eso se nota: con las primeras 15 filas da 4736,1 km, y el árbol duplicado da 3359,2 km. Este curso no demuestra ningún factor para esa regla, y no vamos a afirmar ninguno. Los números completos están en la comparación.
Comprobar el factor con los datos
Las pruebas no se quedan con el ejemplo. Paso a paso, y en 12 subconjuntos de capitales y 300 instancias métricas al
azar, comprueban que la caminata tiene 2n − 1 nodos y mide exactamente 2A, que A ≤ OPT, y que el recorrido atajado es
válido y mide a lo sumo 2A. Con las primeras filas de capitales.csv:
| n | A (km) | Árbol duplicado (km) | 2A (km) | Óptimo (km) | Duplicado / óptimo |
|---|---|---|---|---|---|
| 10 | 1918,2 | 3386,4 | 3836,4 | 3167,2 | 1,069 |
| 15 | 2175,8 | 3359,2 | 4351,7 | 3225,0 | 1,042 |
| 20 | 3080,2 | 5142,1 | 6160,4 | 4640,2 | 1,108 |
| 26 | 4187,4 | 6762,8 | 8374,9 | 5621,6 | 1,203 |
Los números de esta tabla vienen de make bench, y se muestra la salida completa más adelante. Con n = 26, el óptimo
viene de la búsqueda con cota. En estas cuatro instancias, la razón medida queda bien por debajo de 2. Eso es una
medición de estas cuatro instancias. La garantía de 2 es lo que vale siempre.
Sin desigualdad triangular no hay garantía posible
¿La hipótesis métrica es un detalle técnico? No. Sin ella, no solo falla este algoritmo: falla cualquiera, salvo que P = NP.
Teorema. Sea α ≥ 1 una constante. Si existe un algoritmo polinomial con factor α para el viajero general, simétrico con pesos positivos, entonces P = NP.
Técnica. Una reducción, en el sentido de la semana 13, desde el problema del ciclo hamiltoniano: dado un grafo, ¿hay un ciclo que pase exactamente una vez por cada nodo? Se sabe que es NP-completo, aunque en este curso no lo demostramos.
La construcción. Dado un grafo G con n ≥ 3 nodos, se construye un viajero sobre los mismos nodos, con estos pesos, donde W = ⌈αn⌉ + 1:
peso(u, v) = 1     si {u, v} es arista de G
peso(u, v) = W     si no lo es
W se escribe con O(log n) bits, y hay O(n²) pesos: la construcción es polinomial. Luego se corre el supuesto algoritmo, y se responde “sí hay ciclo” si y solo si su recorrido mide a lo sumo αn.
Si G tiene ciclo hamiltoniano, la respuesta es sí. Ese ciclo es un recorrido que solo usa aristas de G, y mide n. Por lo tanto, OPT = n, ya que ningún recorrido de n aristas de peso al menos 1 mide menos. El algoritmo devuelve a lo sumo α · OPT = αn.
Si G no tiene ciclo hamiltoniano, la respuesta es no. Todo recorrido usa al menos un par que no es arista de G, porque si no, sería un ciclo hamiltoniano. Así, todo recorrido mide al menos W + (n − 1) > αn, incluido el que devuelva el algoritmo.
Conclusión. En los dos casos, comparar con αn da la respuesta correcta, en tiempo polinomial. Eso resuelve en tiempo polinomial un problema NP-completo, y entonces P = NP. ∎
La idea no depende de que α sea constante: con α(n) calculable en tiempo polinomial y que se pueda escribir con una cantidad polinomial de bits, funciona igual. Fíjense en por qué esto no contradice el factor 2: estos pesos no cumplen la desigualdad triangular, ya que 1 + 1 < W. Justo esa es la libertad que hace falta para que un solo par malo arruine un recorrido.
hamilton_demo la corre con α = 2, en dos grafos de 6 nodos. El óptimo, calculado con Held-Karp, cae a un lado u otro
de αn = 12, según haya ciclo o no. Y el árbol duplicado, que aquí no tiene ninguna garantía, cae bien lejos en el
primero:
$ build/hamilton_demo
Un ciclo de 6 nodos con la numeración desordenada: sí hay ciclo hamiltoniano
  n = 6, W = 13, alfa·n = 12
  óptimo: 6 <= 12
  árbol duplicado: 0 3 1 5 4 2, largo 30

Dos nodos unidos a otros cuatro, K(2,4): no hay ciclo hamiltoniano
  n = 6, W = 13, alfa·n = 12
  óptimo: 30 > 12
  árbol duplicado: 0 2 1 3 4 5, largo 30
En el primer grafo, el árbol duplicado da 30 y el óptimo es 6: cinco veces más. Las pruebas corren esta reducción en 600 grafos al azar, con α de 1 a 4, y comparan con un árbitro que prueba todos los ciclos.
Idea clave. No todos los problemas NP-difíciles se aproximan igual de bien. La cobertura de vértices tiene factor 2. El viajero métrico, también. El viajero general no tiene ningún factor constante, salvo que P = NP. La NP-dificultad no predice esto: hay que estudiar cada problema, y cada versión.
Heurísticas: mejora local con 2-opt
El árbol duplicado da un recorrido garantizado, pero con 20 ciudades mide 5142,1 km y el óptimo 4640,2 km: queda espacio. Se puede mejorar sin ninguna teoría: tomar un recorrido y arreglarlo mientras se pueda. Eso es una búsqueda local.
El movimiento
Tomen dos aristas del recorrido sin nodos en común. Quitarlas parte el recorrido en dos caminos. Hay una sola forma de volver a unir esos dos caminos en un recorrido, distinta de la original, y es invirtiendo uno de ellos:
antes:    … a → b → ⋯ → c → e …
después:  … a → c → ⋯ → b → e …        (el tramo de b a c, al revés)
La otra forma de reconectar, a con e y b con c, dejaría dos ciclos separados. El cambio se llama 2-opt, porque cambia 2 aristas. Lo que se gana solo depende de ellas: con distancias simétricas, el tramo interno mide lo mismo en cualquier sentido. Así:
ganancia = d(a, b) + d(c, e) − d(a, c) − d(b, e)algoritmo dos_opt(d, t, n)
mejoró ← verdadero
mientras mejoró hacer
mejoró ← falso
para i desde 1 hasta n - 2 hacer
para j desde i + 1 hasta n - 1 hacer
a ← t[i - 1]
b ← t[i]
c ← t[j]
e ← t[(j + 1) mod n]
si d(a, c) + d(b, e) < d(a, b) + d(c, e) entonces
invertir t[i], …, t[j]
mejoró ← verdadero
fin si
fin para
fin para
fin mientras
devolver t
fin algoritmoEl nodo t[0] se queda fijo, sin perder generalidad, porque el recorrido es un ciclo. Cuando i = 1 y j = n − 1, a y e
son el mismo nodo: ese caso solo invierte el recorrido entero y la ganancia es 0, así que no se aplica. Los pares
restantes son justo los pares de aristas sin nodos en común.
Se calcula la ganancia en O(1) e invertir cuesta O(n). Una pasada entera mira O(n²) pares.
Termina
Teorema. Si las distancias son enteras y no negativas, dos_opt termina, y el recorrido final es un óptimo
local: ningún cambio de dos aristas lo acorta.
Técnica. Una cantidad que baja estrictamente, y que no puede bajar para siempre.
Demostración. Cada cambio aplicado baja el largo del recorrido estrictamente, y como es entero, baja al menos 1. El
largo es un entero no negativo, así que solo puede bajar una cantidad finita de veces. Aunque los pesos fueran reales,
habría terminación, porque hay una cantidad finita de recorridos y ninguno se repite, ya que el largo siempre baja.
Cuando el ciclo mientras termina, una pasada completa no aplicó ningún cambio, y entonces ningún par da ganancia
positiva. ∎
Fíjense en lo que no dice el teorema. No dice que sean pocos cambios, ni que el resultado sea óptimo. Dice que termina y que no se puede mejorar con este movimiento.
En C++. Por eso conviene el entero. Con
double, una ganancia de 10⁻¹² puede ser ruido de redondeo, y hay que decidir una tolerancia o arriesgarse a que el ciclo no termine. Con metros enteros,<significa lo que dice.
Empezar en el árbol: nunca empeora
Afirmación. Si dos_opt empieza con el recorrido del árbol duplicado, el resultado también mide a lo sumo 2 · OPT,
en el caso métrico.
Demostración. Cada cambio aplicado acorta el recorrido, así que el largo final es a lo sumo el inicial, que es a lo sumo 2 · OPT. ∎
Vean de dónde sale esa garantía: del punto de partida, no de 2-opt. Si dos_opt empieza con otro recorrido, no
heredamos ese factor.
Error común. Llamar “aproximación” a una heurística que no tiene garantía demostrada. “2-opt es una aproximación” es falso tal como está dicho. “2-opt me dio 1,05 veces el óptimo en mis datos” es una medición de esos datos. “Empezando en el árbol duplicado, el resultado es a lo sumo 2 · OPT” es un teorema, por el punto de partida. Las tres frases dicen cosas distintas, y conviene usar la que corresponde.
Esta es la pregunta 4 de repaso. Una aproximación es un algoritmo polinomial con una garantía demostrada para toda instancia. Una heurística es un método sin esa demostración. Puede ser mucho mejor en la práctica, y varias lo son, pero no se puede afirmar nada de un caso nuevo sin correrlo y, si se quiere comparar, sin conocer también el óptimo.
Paso a paso con 20 ciudades
$ build/two_opt_demo
Las primeras 20 filas. Árbol duplicado, 5142.1 km:
  Abancay Cusco Arequipa Moquegua Ayacucho Huancavelica Huancayo Cerro de Pasco Huánuco Huaraz Cajamarca Chachapoyas Moyobamba Iquitos Chiclayo Piura Huacho Callao Lima Ica
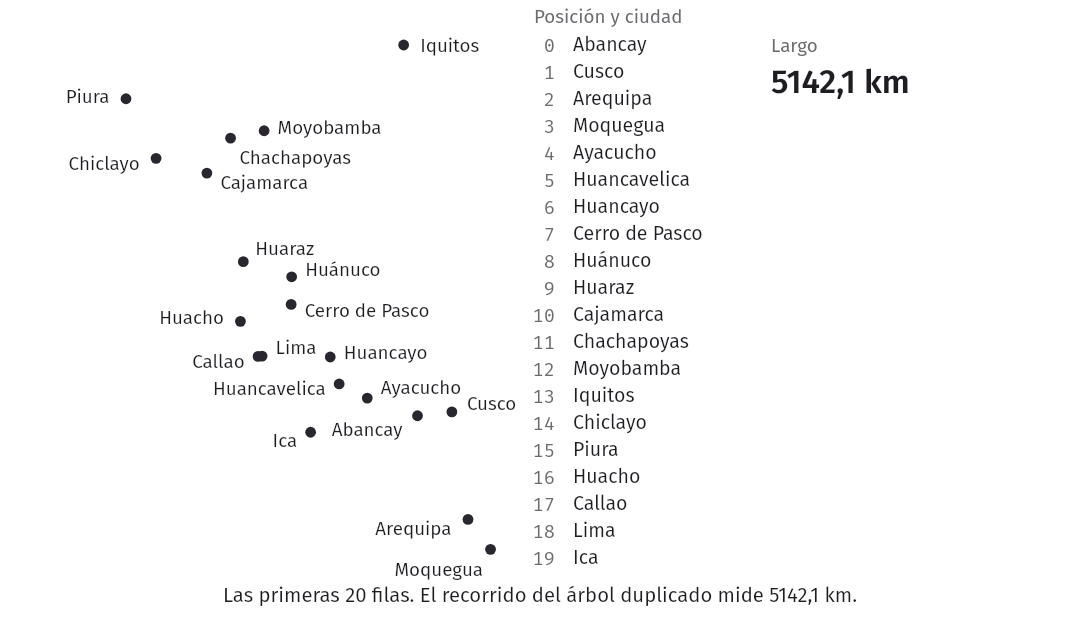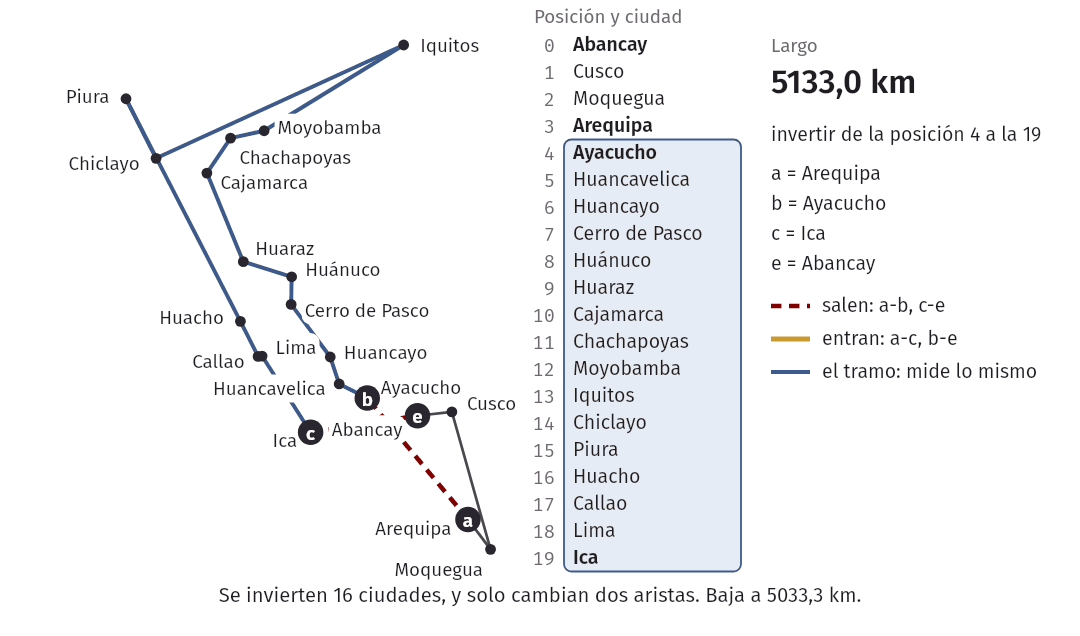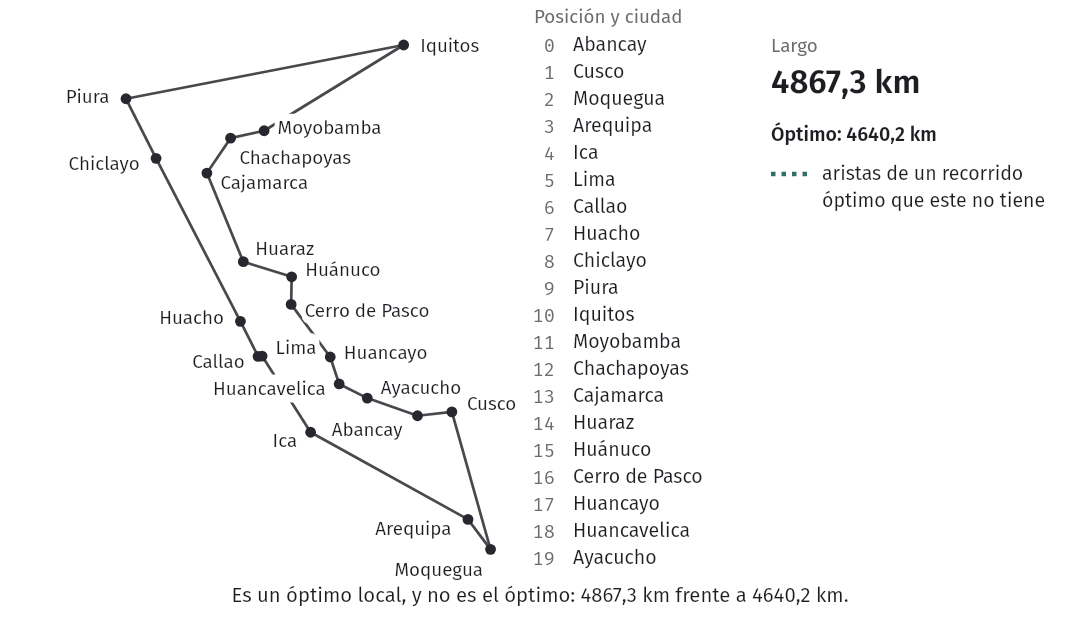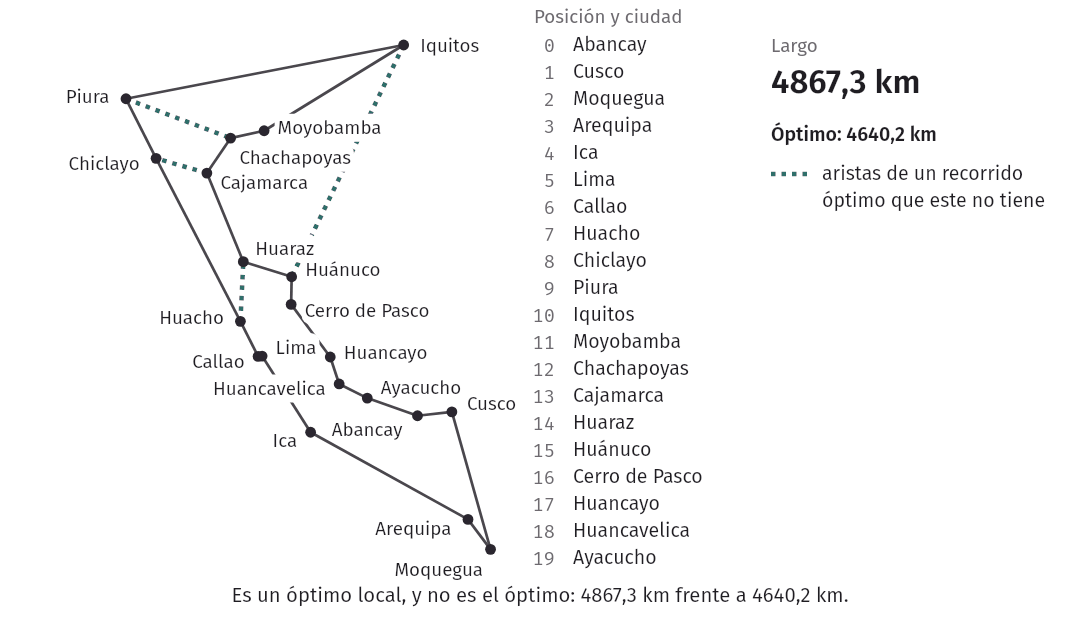
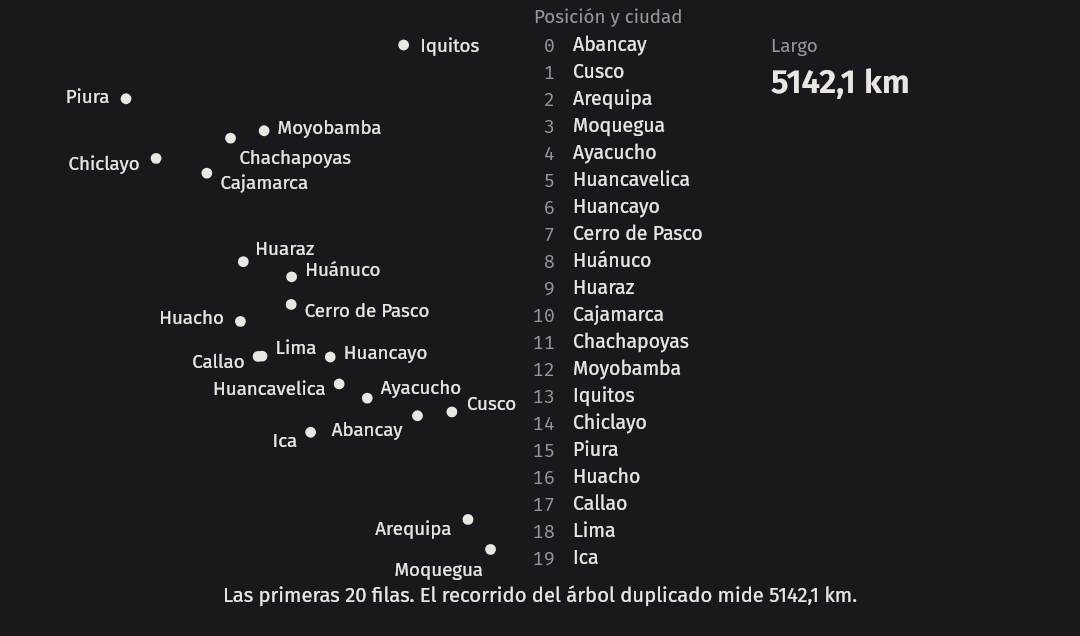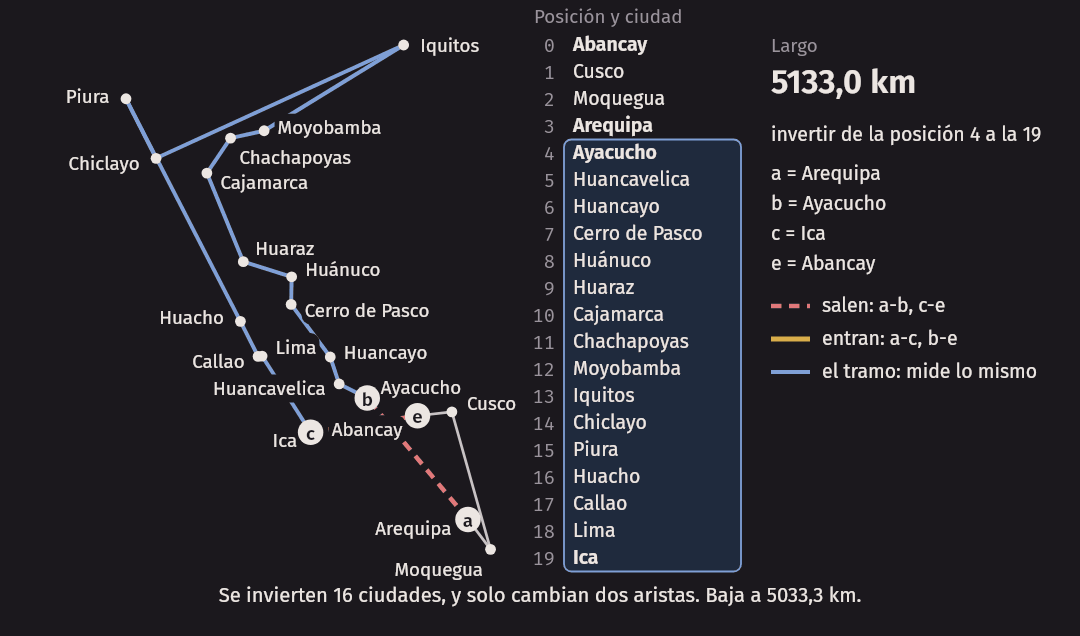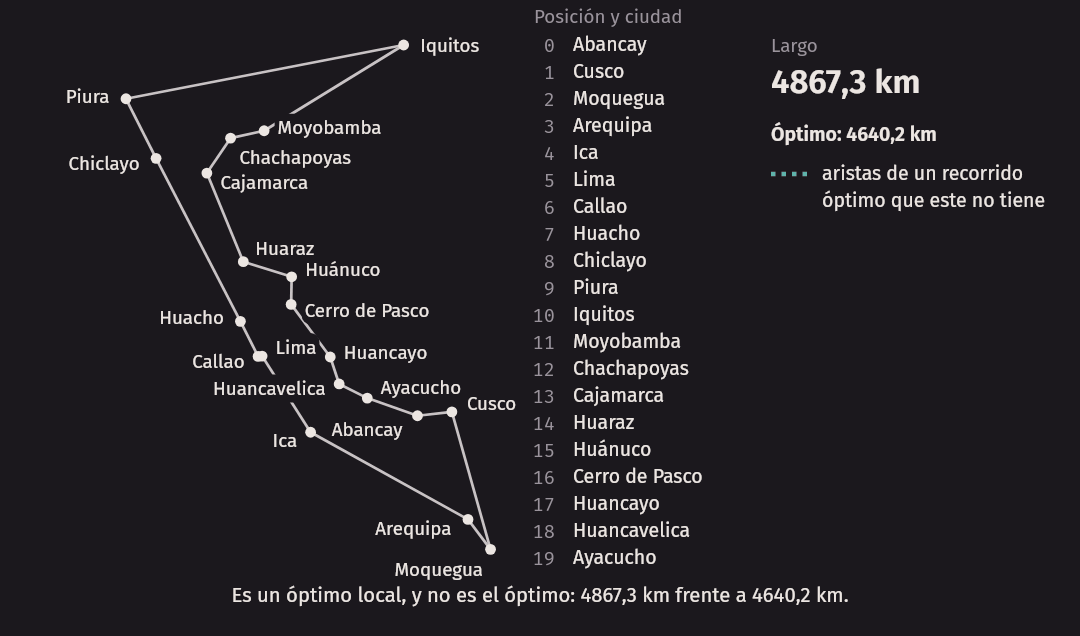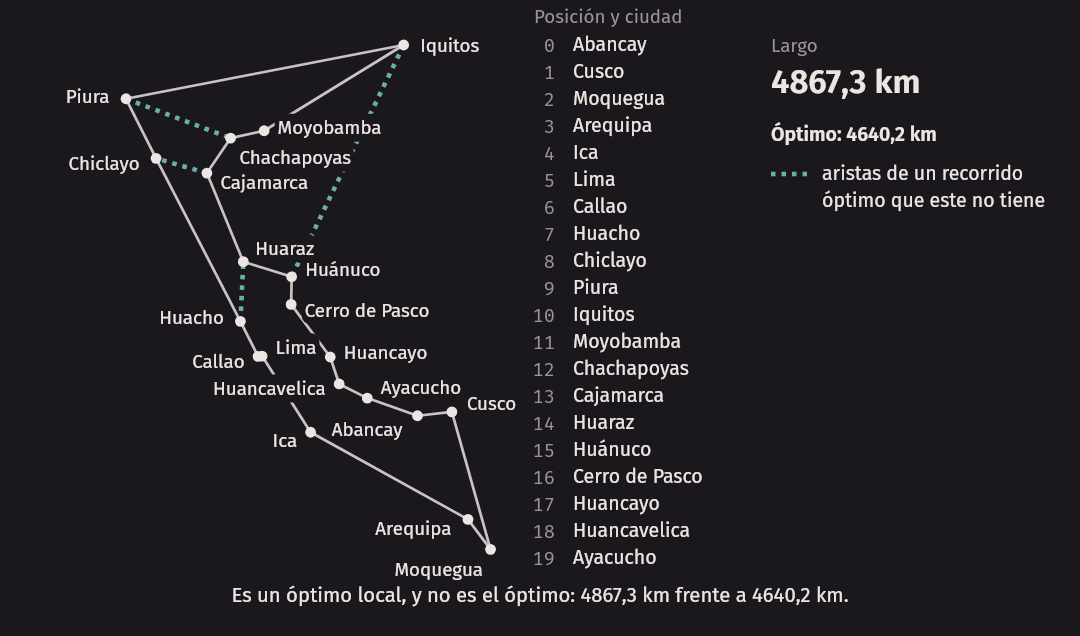
  invertir de la posición 2 a la 3: 5133.0 km
  invertir de la posición 4 a la 19: 5033.3 km
  invertir de la posición 8 a la 9: 4867.3 km
Después de 2-opt:
  Abancay Cusco Moquegua Arequipa Ica Lima Callao Huacho Chiclayo Piura Iquitos Moyobamba Chachapoyas Cajamarca Huaraz Huánuco Cerro de Pasco Huancayo Huancavelica Ayacucho
óptimo, con Held-Karp: 4640.2 km
...
Vamos por el primer cambio. El recorrido tiene … Cusco, Arequipa, Moquegua, Ayacucho …. El tramo de las posiciones 2 y 3 es Arequipa, Moquegua, y se invierte: ahora va Cusco, Moquegua, Arequipa, Ayacucho, y baja 9,1 km. El segundo cambio mueve casi todo el recorrido e invierte 16 ciudades, con un solo par de aristas cambiado. Después de 3 cambios, ya no se puede mejorar con este movimiento, y el recorrido mide 4867,3 km: es un óptimo local, y no es el óptimo, que es 4640,2 km.
Dónde termina depende de dónde empieza
Un óptimo local no es único. two_opt_demo también lanza 2-opt desde 2000 recorridos al azar, con las mismas 20
ciudades:
$ build/two_opt_demo
...
2-opt desde 2000 recorridos al azar, las mismas 20 filas:
  mejor 4640.2 km, mediana 4640.2 km, peor 4882.0 km
  llegaron al óptimo: 1215 de 2000
  peor largo / óptimo: 1.052
En estos datos le fue muy bien: más de la mitad de los intentos llegó al óptimo, y el peor se quedó 5,2 % arriba. Pero es una medición de 20 ciudades concretas, y no hay nada aquí que se pueda extender a un caso nuevo. Sí hay una lección práctica: correr 2-opt desde varios puntos de partida y quedarse con el mejor cuesta poco y suele ayudar. Y con 26 ciudades, como se verá en la tabla, partir del árbol y partir del vecino más cercano dieron resultados bien distintos.
Idea clave. Un óptimo local solo promete que este movimiento no lo mejora. Ni el factor de aproximación ni el óptimo salen de ahí.
El 2-opt del código
tour.h tiene two_opt_plain, que hace lo mismo que el pseudocódigo con menos eficiencia, para mantener la idea a la
vista: invierte el tramo, mide todo el recorrido y deshace si no mejoró.
inline std::vector<Move> two_opt_plain(const Matrix& d, Tour& t) {
    const int n = static_cast<int>(t.size());
    std::vector<Move> moves;
    long long current = tour_length(d, t);
    bool improved = true;
    while (improved) {
        improved = false;
        for (int i = 1; i + 1 < n; i++) {
            for (int j = i + 1; j < n; j++) {
                std::reverse(t.begin() + i, t.begin() + j + 1);
                const long long candidate = tour_length(d, t);
                if (candidate < current) {
                    current = candidate;
                    moves.push_back({i, j, candidate});
                    improved = true;
                } else {
                    std::reverse(t.begin() + i, t.begin() + j + 1);
                }
            }
        }
    }
    return moves;
}
Cada intento cuesta O(n), en lugar del O(1) del pseudocódigo. Con 26 ciudades ni se nota. Con mil lugares sí se nota, y ese es justamente un punto del laboratorio.
La comparación completa
Con todo esto, la tabla que pide el laboratorio. Cada método corre con las primeras 10, 15 y 20 filas, y con las 26. Es
lo que da make bench, con -O2. Cada tiempo es el menor de tres corridas, salvo la búsqueda con cota con 20 y 26
ciudades, que corrió una vez. Los tiempos dependen de la máquina, que además estaba compartida, y un 0.000 s solo
significa menos de un milisegundo:
$ build/compare_bench
n = 10                       largo     / óptimo    tiempo
  árbol de expansión mínima   1918.2 km    0.606     0.000 s
  árbol duplicado             3386.4 km    1.069     0.000 s
  duplicado + 2-opt            3178.9 km    1.004     0.000 s
  vecino más cercano          3513.3 km    1.109     0.000 s
  vecino + 2-opt               3178.9 km    1.004     0.000 s
  Held-Karp                    3167.2 km    1.000     0.000 s
  búsqueda con cota           3167.2 km    1.000     0.001 s

n = 15                       largo     / óptimo    tiempo
  árbol de expansión mínima   2175.8 km    0.675     0.000 s
  árbol duplicado             3359.2 km    1.042     0.000 s
  duplicado + 2-opt            3259.5 km    1.011     0.000 s
  vecino más cercano          4736.1 km    1.469     0.000 s
  vecino + 2-opt               3225.0 km    1.000     0.000 s
  Held-Karp                    3225.0 km    1.000     0.008 s
  búsqueda con cota           3225.0 km    1.000     0.023 s

n = 20                       largo     / óptimo    tiempo
  árbol de expansión mínima   3080.2 km    0.664     0.000 s
  árbol duplicado             5142.1 km    1.108     0.000 s
  duplicado + 2-opt            4867.3 km    1.049     0.000 s
  vecino más cercano          6218.7 km    1.340     0.000 s
  vecino + 2-opt               4827.8 km    1.040     0.000 s
  Held-Karp                    4640.2 km    1.000     0.466 s
  búsqueda con cota           4640.2 km    1.000     7.708 s

n = 26                       largo     / óptimo    tiempo
  árbol de expansión mínima   4187.4 km    0.745     0.000 s
  árbol duplicado             6762.8 km    1.203     0.000 s
  duplicado + 2-opt            5719.3 km    1.017     0.000 s
  vecino más cercano          6799.2 km    1.209     0.000 s
  vecino + 2-opt               6344.0 km    1.128     0.000 s
  búsqueda con cota           5621.6 km    1.000    23.516 s
El árbol de la primera fila no es un recorrido. Está para ver la cota inferior: en estos cuatro casos, el óptimo la
supera bastante. Held-Karp no aparece con 26: no se corrió, porque su tabla necesitaría unos 6,7 GB. La búsqueda con
cota sí terminó. La misma búsqueda de bound_bench tardó 4,93 s y 14,91 s en otras corridas de esta misma medición. Ese
es el tamaño del ruido de una máquina compartida: las cuentas de nodos no cambian, y los tiempos sí.
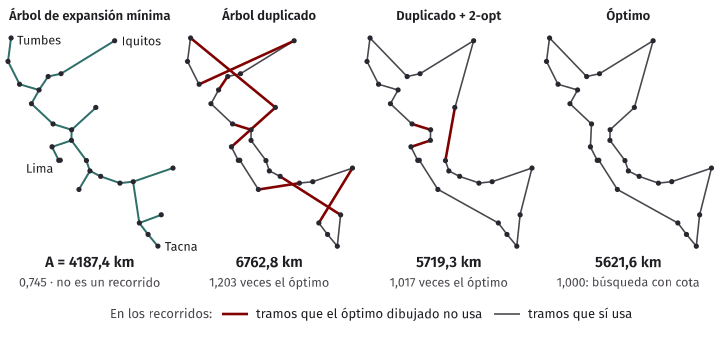
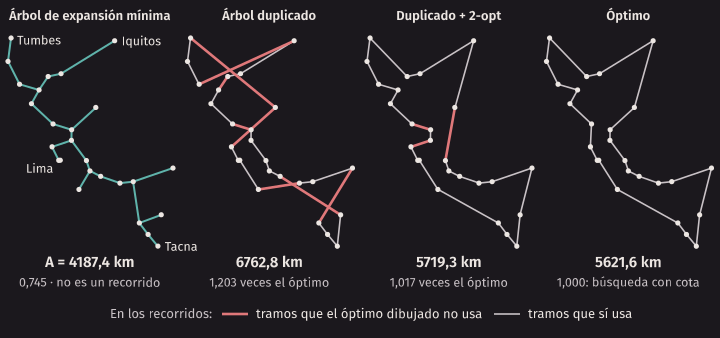
Qué se puede leer aquí, sin pasarse:
- El factor 2 se cumple en las cuatro filas, y queda lejos: el árbol duplicado midió entre 1,042 y 1,203 veces el óptimo en estas instancias.
- 2-opt mejoró mucho a su punto de partida. Desde el árbol, quedó entre 1,004 y 1,049.
- No hay un ganador entre los dos puntos de partida. Con 15 y 20, partir del vecino fue mejor. Con 26, partir del árbol fue mucho mejor: 1,017 frente a 1,128.
- El vecino más cercano solo fue el peor recorrido en cada n, y llegó a 1,469 con 15. Eso tampoco es una ley. Son estas cuatro instancias.
- Los exactos cuestan más, y qué tanto más depende del método y de los datos. Con 20 ciudades, Held-Karp fue mucho más rápido que la búsqueda con cota, pero es la búsqueda la que termina con 26.
En la práctica. Con 26 ciudades y una hora de trabajo, uno correría 2-opt desde varios puntos, en milisegundos, y usaría ese largo para hacer podar a la búsqueda exacta. Si la búsqueda no termina a tiempo, el recorrido de 2-opt ya está disponible. Eso es lo que quiere decir que estas opciones se pueden combinar.
Cuánta memoria toma Held-Karp
El laboratorio pide llegar a n = 20, y hay que decidir el tamaño de la tabla. La tabla de la semana 10 es std::vector
de std::vector, con long long. Se puede gastar bastante menos. Esta es una medición del pico de memoria de un
proceso (ru_maxrss), al llenar cada tabla, en el orden de la lista:
$ build/memory_bench
tabla para n = 20                                 la cuenta         pico
2^19 x 20, int                                     40.0 MiB     43.1 MiB
2^19 x 20, long long                               80.0 MiB     83.1 MiB
2^20 x 20, int                                     80.0 MiB     83.1 MiB
2^20 x 20, long long                              160.0 MiB    163.1 MiB
2^20 filas de 20, vector de vectores, long long    160.0 MiB    203.0 MiB
Tres decisiones cambian esa cuenta. Fijar la ciudad 0 baja las filas de 2²⁰ a 2¹⁹. Un largo menor que unos 4 × 10⁸
metros cabe en int, porque 20 tramos no pasan de 20 veces media circunferencia terrestre, que son unos 20016 km. Y una
matriz contigua no paga los 40 MiB extra de un millón de vectores pequeños. Todas son decisiones de sentido común, y el
límite de 256 MiB del laboratorio no obliga a ninguna: la tabla más grande de esta lista ya entra.
✂️ Programación lineal como idea
Esta sección se puede cortar, o dejar como lectura si falta tiempo. Es una idea, no una técnica que vayan a programar: en el entorno del curso no hay un solucionador de programación lineal, y aquí no se corre ninguno. Los ejemplos se hacen a mano.
Qué es
Un problema de programación lineal (linear programming) pide darle valores reales a unas variables, de modo que se maximice o minimice una función lineal, con restricciones que también son lineales. Por ejemplo:
maximizar   3x + 2y
sujeto a    x + y ≤ 4
            x ≤ 3
            y ≤ 3
            x ≥ 0,  y ≥ 0
Cada restricción deja afuera un semiplano. Lo que queda es un polígono, con esquinas (0, 0), (3, 0), (3, 1), (1, 3) y (0, 3). Una función lineal crece en una sola dirección. Por lo tanto, su máximo sobre un polígono acotado se alcanza en una esquina. Probándolas: 0, 9, 11, 9 y 6. El óptimo es 11, en (3, 1). Las pruebas lo comprueban con cada esquina y con una grilla fina de puntos. En más dimensiones, el polígono es un poliedro y hay muchísimas esquinas, pero la idea se mantiene.
Se resuelve en tiempo polinomial
Un programa lineal se resuelve en tiempo polinomial en la cantidad de bits de la entrada. Los dos métodos que lo garantizan son el elipsoide (Khachiyan, 1979) y los puntos interiores (Karmarkar, 1984). El método que más se conoce en la práctica es símplex (Dantzig), que camina de esquina en esquina mejorando el valor. Símplex suele ser muy rápido, pero no se conoce ninguna versión con una cota polinomial de peor caso, y hay ejemplos en los que las reglas clásicas tardan un tiempo exponencial. Es una buena lección: lo que funciona en la práctica y lo que está garantizado en el peor caso no siempre coinciden. Hay solucionadores maduros de código abierto, como HiGHS y GLPK, que manejan programas con muchísimas variables.
Flujo máximo como programa lineal
Muchos problemas del curso se escriben así. Flujo máximo, con una variable f(u, v) por arista:
maximizar    Σ f(s, w) − Σ f(u, s)
sujeto a     Σ f(v, w) − Σ f(u, v) = 0      para cada nodo v distinto de s y de t
             f(u, v) ≤ c(u, v)              para cada arista
             f(u, v) ≥ 0                    para cada arista
Cada línea es lo que ya sabían: la función es el valor del flujo, la primera restricción es la conservación, y las otras dos son la capacidad. No hay nada nuevo que modelar. Se puede ver en Erickson, H.3.
Con capacidades enteras, las esquinas de este poliedro resultan ser enteras. Es una propiedad de la matriz de estas restricciones, que no vamos a demostrar. Es el mismo fenómeno de la integralidad de la semana 11, visto desde otro lado. Cuidado: habla de las esquinas. Como vimos en la semana 12, también hay flujos máximos con fracciones. Un método que no devuelve una esquina puede dar uno de esos.
Con enteros es otro problema
Si se exige que las variables sean enteras, el problema cambia de clase. La programación lineal entera es NP-difícil. La reducción es directa, desde cobertura de vértices:
minimizar   Σ x(v)
sujeto a    x(u) + x(v) ≥ 1        para cada arista {u, v}
            x(v) entero, 0 ≤ x(v) ≤ 1
Una cobertura C da una solución, con x(v) = 1 si v está en C y 0 si no, y de valor |C|. Una solución entera da una cobertura, con los nodos en los que vale 1, de tamaño igual al valor. Los óptimos coinciden, así que un algoritmo polinomial para programación lineal entera daría uno para la cobertura de vértices.
Quitar “entero” no resuelve el problema original. En un triángulo, x = ½ en cada nodo cumple todas las restricciones y vale 3/2. Sumando las tres restricciones, 2(x₀ + x₁ + x₂) ≥ 3, de modo que 3/2 es el mínimo. El óptimo entero es 2. Una mitad de nodo no significa nada, igual que la “media silla” de la semana 12.
Pero sí sirve como cota inferior, y eso ya lo sabemos aprovechar. Si LP es el óptimo fraccionario, entonces LP ≤ OPT, porque toda solución entera también es fraccionaria. Tomen los nodos con x(v) ≥ ½. Es una cobertura: cada arista tiene x(u) + x(v) ≥ 1, y entonces alguna de sus puntas llega a ½. Y su tamaño es a lo sumo 2·Σ x(v) = 2·LP ≤ 2·OPT. Es otra forma de obtener el factor 2, con la misma receta. Se llama redondeo.
Idea clave. Lineal con reales es polinomial. Lineal con enteros es NP-difícil. Es otra frontera como las de la semana pasada: una palabra del enunciado, “entero”, cambia todo.
Repaso: dado un problema nuevo, ¿qué técnica sirve?
Durante 15 semanas, cada problema llegó con su técnica. En un examen, y en el trabajo, llega solo. Esto es lo que conviene preguntarse.
Primero, escriban bien el problema: qué entra, qué sale y qué se optimiza. Luego miren el tamaño. Con n = 20, se puede pensar en exponencial. Con n = 10⁶, hace falta O(n log n). Muchas veces el límite ya descarta la mitad de las ideas.
| Señal en el problema | Técnica | Semanas | Cómo se justifica |
|---|---|---|---|
| Se puede partir en pedazos del mismo tipo, y combinar | Divide y vencerás | 2, 3 | Recurrencia y teorema maestro |
| Una decisión local es segura y deja un problema del mismo tipo | Greedy | 4, 5, 6 | Argumento de intercambio. Antes, buscar un contraejemplo |
| Las decisiones dependen unas de otras, con subproblemas repetidos | Programación dinámica | 7, 9, 10 | Subproblema, recurrencia, orden. Inducción |
| Grafo con pesos, ir de un lugar a otro | Caminos mínimos | 5, 10 | Sin pesos negativos, Dijkstra. Con ellos, Bellman-Ford |
| Conectar todo al menor costo | Árbol de expansión mínima | 6 | Propiedad del corte |
| Asignar con cupos, caminos disjuntos, elegir con dependencias | Flujo o corte | 11, 12 | Reducción, con las dos direcciones |
| Nada de lo anterior, y se parece a un problema del mapa | Sospechar NP-dificultad | 13, 14 | Reducción desde un problema difícil conocido |
| Es NP-difícil y hay que responder | Las opciones de hoy | 15 | Poda, caso especial, aproximación, heurística, solucionador |
La misma idea, con otra restricción, cambia de técnica. Clases sin cruces: greedy. Clases sin cruces con pesos: programación dinámica. Elegir un conjunto independiente en un grafo cualquiera: NP-difícil. Antes de codificar, conviene buscar un contraejemplo de la idea rápida, y antes de rendirse, buscar qué tiene de especial esta entrada.
Pregunta 5 de repaso: cuatro problemas
Asignar 50 médicos a turnos con cupos. Flujo, como la asignación con cupos de la semana 12. Cada médico puede tomar ciertos turnos, y cada turno admite una cierta cantidad: una red con s → médico, médico → turno y turno → t, y capacidades que representan esas cantidades. No se necesita más que flujo máximo, y la integralidad garantiza una asignación entera. El greedy “cada uno a su primera opción libre” ya falló en la semana 12. Si además cada asignación tuviera un costo, haría falta otro problema, flujo de costo mínimo, que este curso no vio.
Visitar 12 clientes en orden óptimo. Es el viajero, NP-difícil, pero con n = 12 la entrada es pequeña, y se pide el óptimo. Held-Karp hace (n − 1)(n − 2)·2ⁿ⁻³ = 11 · 10 · 512 = 56320 transiciones, con una tabla chica. Incluso las 11! = 39916800 permutaciones se pueden correr. Aproximar no tiene sentido cuando se puede tener el óptimo en milisegundos.
Elegir la mayor cantidad de clases sin cruces en un aula, entre 10000. Greedy: ordenar por hora de fin y tomar la primera que no se cruce, de la semana 4, demostrado con un argumento de intercambio. Es O(n log n). Con 10000 clases, un algoritmo exponencial está descartado, y la versión sin pesos no necesita tabla alguna.
Alinear dos cadenas de ADN. Programación dinámica: distancia de edición o alineamiento, de la semana 7, en O(nm). El subproblema es un par de prefijos. Con un millón de bases por cadena, la tabla entera ya no cabe. Si solo interesa el costo, basta con guardar dos filas.
Error común. Decir “es un problema de grafos, entonces Dijkstra” o “es de optimización, entonces programación dinámica”. La técnica no sale del tema. Sale de la estructura: qué decisión es segura, qué tiene que recordar un subproblema, qué se conserva. Y siempre hace falta la demostración.
Qué sigue
Este curso cierra aquí su contenido, y la semana 16 es el examen final. Tres cursos continúan lo que empezó aquí:
- Teoría de la Computación. Qué se puede calcular y qué no. Allí está la demostración de Cook-Levin que dejamos enunciada, y problemas más allá de NP, incluidos los que ninguna computadora puede resolver.
- Probabilidad y algoritmos aleatorizados. Algoritmos que tiran monedas, como el quicksort aleatorizado de la semana 4, y cómo se analizan.
- Algoritmos Avanzados. Más técnicas, más estructuras y mejores factores de aproximación.
El código de la semana
| Archivo | Qué contiene |
|---|---|
capitales.csv, capitales.md |
Los 26 lugares, y de dónde salieron |
geo.h |
Haversine, metros hacia arriba, la matriz, leer el archivo |
tour.h |
Prim, caminata, atajar, árbol duplicado, vecino más cercano, 2-opt de ejemplo |
bound.h |
La búsqueda con tres formas de podar. Solo da el costo y los nodos |
cover.h |
Matching maximal, una punta, mayor grado, el árbitro y la trampa |
metric_demo.cpp |
La desigualdad triangular en todas las ternas |
cover_demo.cpp |
Las tres reglas de cobertura |
double_tree_demo.cpp |
El árbol duplicado con ocho capitales |
hamilton_demo.cpp |
La reducción desde el ciclo hamiltoniano |
two_opt_demo.cpp |
2-opt paso a paso, y desde 2000 inicios |
bound_demo.cpp |
Nodos visitados con y sin poda |
compare_bench.cpp, bound_bench.cpp, memory_bench.cpp |
Las mediciones de make bench |
test_examples.cpp |
Las pruebas |
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
Todas las pruebas de la semana 15 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- En los 26 lugares, las distancias son simétricas y cumplen la desigualdad triangular en todas las ternas, Lima y Callao están a 11596 m, y Tacna y Tumbes a 1953472 m. Con 3000 ternas de puntos al azar en todo el globo, también vale redondeando hacia arriba. Redondear al más cercano la rompe en el ejemplo del ecuador.
- Prim coincide con Kruskal en 300 instancias.
- El factor 2, paso por paso, en 12 subconjuntos de capitales y en 300 instancias métricas: la caminata mide 2A, A ≤ OPT, el recorrido atajado es válido y mide a lo sumo 2A. Después de 2-opt, es un óptimo local, no empeoró, cada cambio bajó el largo y sigue siendo a lo sumo 2A.
- Sin desigualdad triangular, en el ciclo desordenado, el árbol duplicado da 30 y el óptimo es 6.
- La reducción desde el ciclo hamiltoniano acierta en 600 grafos, con α de 1 a 4.
- La cota de árbol nunca se pasa del mejor final posible, en 200 instancias, y las tres podas dan el mismo costo que Held-Karp en otras 200. Las cuentas de nodos con n = 10 son las de la tabla.
- En 1500 grafos, el matching maximal es un matching, es maximal, y da una cobertura de tamaño a lo sumo 2 · OPT con |M| ≤ OPT. En la trampa, el mayor grado elige justo los nodos de la derecha, y el matching tiene k aristas.
- Las esquinas del programa lineal de ejemplo, el triángulo con ½ y las 56320 transiciones de la pregunta 5.
El laboratorio
Esta semana hay dos problemas, y juntos son el trabajo de comparar. Cada uno tiene su enunciado, y un verificador, porque hay muchas respuestas correctas. Los dos leen coordenadas: la distancia, con su redondeo hacia arriba, es parte del trabajo. Límites: memoria de 256 MiB, en los dos, y el juez no la mide: el enunciado dice cómo comprobarla.
lab/peru_exact, hasta 20 ciudades. Hay que dar el largo mínimo y el recorrido. El verificador comprueba que el
largo sea el mínimo, que cada ciudad aparezca una vez, y mide de nuevo lo que escribieron. held_karp.h de la semana 10
calcula solo el costo, así que la parte nueva es reconstruir: piensen qué valor de la tabla tiene que coincidir con qué,
para saber de dónde se llegó a cada casilla. Una búsqueda con poda como la de bound.h podría pasar algunos casos, pero
no se espera que pase todos en 2 segundos.
lab/peru_tour, hasta 1500 lugares. El verificador acepta un recorrido si, además de ser válido y tener el largo
que dicen, no pasa de 2A y ningún cambio de dos aristas lo acorta. Vean qué teorema de este capítulo garantiza la
primera condición, y por qué un recorrido no puede quedar debajo de la cota A sin que el programa esté mal. El
verificador mira el resultado, no el método: un 2-opt que arranque en otro lado también puede pasar, aunque entonces
nadie puede garantizarles el factor. El two_opt_plain de tour.h da la respuesta correcta, y es demasiado lento para
los casos grandes. Hay que calcular la ganancia en O(1), como dice el pseudocódigo.
Los puntos 3 y 4 de la guía los hacen ustedes con sus programas: armen su tabla de largo y tiempo con 10, 15 y 20
ciudades, y con las 26 solo los métodos que terminen, y comprueben el factor. Con make bench tienen los números del
capítulo para comparar: sus óptimos deben coincidir exactamente. Sus largos con 2-opt pueden ser otros si revisan los
cambios en otro orden, y sus tiempos serán otros.
Resumen
- Ante un problema NP-difícil, se pregunta: ¿la entrada es pequeña?, ¿tiene estructura especial?, ¿sirve algo cercano?, ¿hay un solucionador? Se pueden combinar.
- Casos especiales ya vistos: cobertura de vértices en árboles, con programación dinámica lineal. Mochila con números pequeños, en O(nW).
- Backtracking con poda: una cota inferior válida corta ramas sin perder el óptimo. Exacto y, en el peor caso, exponencial. Una cota que se pasa rompe la correctitud.
- Cota del viajero: salir, árbol de expansión mínima de lo que falta, volver. Con 15 capitales visitó unas 8700 veces menos nodos que la cota simple, y terminó con las 26.
- Aproximación: polinomial, con garantía demostrada para toda instancia. Se demuestra contra una cota inferior de OPT, sin conocerlo.
- Cobertura de vértices: un matching maximal, las dos puntas. |C| = 2|M| ≤ 2·OPT, porque M es disjunto. Maximal, no máximo.
- Viajero métrico: A ≤ OPT, la caminata mide 2A, y atajar no alarga por la desigualdad triangular. Factor 2.
- Sin desigualdad triangular: con pesos 1 y W = ⌈αn⌉ + 1, un factor α constante decidiría el ciclo hamiltoniano. No existe, salvo que P = NP.
- Heurística: 2-opt invierte un tramo mientras acorte. Termina en un óptimo local. No garantiza nada por sí misma. Desde el árbol duplicado, conserva el factor 2 por dónde empezó.
- Mediciones con estas capitales: con 26, el óptimo es 5621,6 km, el árbol duplicado 1,203 veces eso, y más 2-opt, 1,017. Son mediciones de esas instancias.
- ✂️ Programación lineal: con reales, polinomial, con elipsoide y puntos interiores. Símplex, sin cota polinomial conocida, es muy usado. Con enteros, NP-difícil. Flujo es un programa lineal con esquinas enteras.
- Repaso: la técnica sale de la estructura y de los límites. Y sigue haciendo falta demostrar.
Ejercicios
-
Corran
cobertura_por_matchinga mano en un ciclo de 6 nodos, primero con las aristas en el orden del ciclo y después con otro orden que les dé un matching maximal más chico. ¿Qué cobertura da cada uno? ¿Cuál es OPT? -
Demuestren que un matching maximal tiene al menos la mitad de las aristas de un matching máximo. Pista: cada arista de un matching máximo toca algún nodo del maximal.
-
Muestren, para cada k, un grafo en el que
cobertura_por_matchingda exactamente 2k y OPT = k. ¿Depende del orden de las aristas? -
Una cobertura C con factor 2 da un conjunto independiente V − C. ¿Tiene ese conjunto algún factor de aproximación? Pista: tomen un grafo que sea un matching perfecto, y el conjunto que da el algoritmo.
-
Demuestren que redondear hacia abajo tampoco conserva la desigualdad triangular, con un ejemplo numérico de tres reales. ¿Qué tiene de especial el techo?
-
Demuestren que también es una cota inferior válida el peso de un árbol de expansión mínima de los nodos de
restojunto conúltimoy 0. Cambiencompletion_boundpor esa cota y comparen los nodos visitados en la tabla debound_demo. ¿Cuál visita menos en estos datos? -
Modifiquen
bound.hpara que la búsqueda arranque conmejorigual al largo de un recorrido dado, y no en infinito. Prueben con el resultado de árbol duplicado + 2-opt y comparen los nodos visitados con n = 20. ¿Sigue siendo exacta? Demuéstrenlo. ¿Qué pasa simejorarranca con un valor menor que el óptimo? -
En un viajero métrico, ¿en qué paso de la demostración del factor 2 falla, si la matriz no es simétrica? Busquen una matriz de 3 o 4 ciudades, no simétrica, y que sí cumpla la desigualdad triangular, en la que la caminata no mida el doble del árbol.
-
Adapten la demostración de inaproximabilidad a un factor α(n) = 2ⁿ. ¿Cuántos bits tiene W? ¿Sigue siendo polinomial la construcción? ¿Y con α(n) = 2^(2ⁿ)?
-
Dibujen 4 puntos en un cuadrado. Escriban un recorrido con dos tramos que se cruzan, apliquen el cambio de 2-opt y demuestren que, en el plano, quitar un cruce nunca alarga. Pista: usen la desigualdad triangular en los triángulos que forma el punto de cruce con los extremos de los tramos.
-
Escriban un programa que corra 2-opt desde 200 recorridos al azar con las 26 capitales, con
two_opt_plain, y cuenten cuántos llegan a 5621,6 km. Comparen con los dos arranques de la tabla. ¿Pueden afirmar algo del caso de otro país? -
✂️ Escriban el programa lineal de un flujo máximo en una red de 4 nodos y 5 aristas, con los números que quieran. Luego escriban a mano un flujo con fracciones que sea máximo. ¿Es una esquina del poliedro?
-
Para cada problema, elijan una técnica y justifíquenla, como en la pregunta 5: (a) elegir el subconjunto de 10⁵ tareas de mayor beneficio con hora fija de inicio y fin; (b) saber si 30 estudiantes se pueden sentar en 30 sillas con compatibilidades dadas; (c) pintar con 3 colores un mapa de 200 regiones de forma que dos vecinas no compartan color; (d) visitar 5000 tiendas con un recorrido que, con garantía, mida a lo sumo el doble del óptimo, con distancias de gran círculo.