Apuntes · Capítulo 1Demostrar y dividir
Demostrar un algoritmo
Demostrar un algoritmo
En Estructuras de Datos ustedes usaron Dijkstra para encontrar rutas y Huffman para comprimir archivos. Los programaron, los probaron y funcionaron. Pero nadie demostró que funcionan siempre. ¿Por qué Dijkstra puede dar por definitivo un nodo sin mirar los demás caminos? ¿Por qué juntar los dos símbolos menos frecuentes da el mejor código posible? Allá se aceptó. Aquí se demuestra.
Este curso responde tres preguntas: cómo se diseña un algoritmo para un problema nuevo, cómo se demuestra que siempre da la respuesta correcta, y cómo se reconoce un problema para el que quizá no exista ningún algoritmo rápido. Esta semana empezamos por la segunda, porque las otras dos la necesitan.
En la primera parte de este capítulo veremos las dos herramientas que usaremos todo el semestre: la invariante de ciclo para un ciclo y la inducción para una función recursiva. Las aplicaremos a dos programas pequeños que ya conocen o casi: la búsqueda binaria y la potencia rápida. En la segunda parte las usaremos con un algoritmo que no conocen y cuya correctitud no es nada obvia: Gale-Shapley, que reparte dos grupos de personas con preferencias de manera que nadie tenga motivos para romper el reparto.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Cómo funciona este curso, Problema, instancia y algoritmo, Por qué las pruebas no alcanzan y El problema del matching estable. Con eso llegan sabiendo qué es un algoritmo correcto y qué problema resuelve Gale-Shapley.
En clase: Sesión A, de Invariante de ciclo a Cómo se escribe una demostración aquí. Sesión B, de El problema del matching estable a Quién propone importa.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, Implementación: O(n²) con una tabla de rangos, Variante con cupos, El código de la semana y
make testy El laboratorio. Para ampliar, Para qué sirve en el mundo real y las lecturas de apoyo del recuadro siguiente.
Lectura. Apuntes de esta semana, que son el texto del curso. Como apoyo: Erickson, secs. 0.5 (Describing Algorithms), 0.6 (Analyzing Algorithms) y 4.5 (Stable Matching). CLRS, 4.ª edición, capítulos Getting Started y Matchings in Bipartite Graphs.
Código. Los programas de este capítulo están en
code/week-01. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está encode/week-01/lab, con unMakefileen cada problema.
Cómo funciona este curso
Cada semana tiene dos sesiones de teoría de 2 horas (Sesión A y Sesión B) y una sesión de laboratorio de 2 horas. En teoría se diseña un algoritmo y se demuestra. En el laboratorio se recibe un problema escrito en palabras, se decide qué técnica le sirve y se implementa en C++ hasta que pase el juez del curso, un programa que corre su solución con muchos casos y les dice si está bien.
El curso tiene cuatro partes: Demostrar y dividir, Greedy y grafos, Programación dinámica y Flujo e intratabilidad. Esta semana abre la primera.
Tres cosas conviene saber desde hoy:
- Los apuntes son el texto del curso. No hace falta comprar nada. El libro de Jeff Erickson es gratuito y sirve de apoyo; CLRS es la referencia para quien quiera profundizar.
- Los laboratorios son para practicar. El juez les da la respuesta de inmediato, y sirven para llegar preparados.
- Hay cuatro prácticas y dos exámenes. Las prácticas son individuales, en las semanas 4, 7, 11 y 14, y cada una combina una demostración escrita con un problema en C++. El parcial es en la semana 8 y el final en la 16.
Noten que una práctica pide una demostración y un programa. No son dos materias distintas. Una demostración sin programa no le sirve a nadie, y un programa sin demostración es una apuesta. Esa relación es el tema de hoy.
Problema, instancia y algoritmo
Tres palabras que hay que separar desde el inicio.
Un problema dice qué entradas son válidas y qué salida le corresponde a cada una. Por ejemplo, el problema de ordenar: la entrada es un arreglo de enteros, y la salida es el mismo arreglo con sus elementos de menor a mayor.
Una instancia es una entrada concreta de un problema. El arreglo 5, 2, 9 es una instancia de ordenar. Un problema tiene, en general, infinitas instancias.
Un algoritmo para un problema es un procedimiento paso a paso que recibe cualquier instancia y produce su salida. La palabra clave es cualquier. Un programa que solo funciona con el arreglo 5, 2, 9 no resuelve el problema de ordenar.
Con esas palabras podemos decir qué significa estar bien:
Definición. Un algoritmo es correcto si, para toda instancia válida, termina y devuelve una salida que el problema acepta. La propiedad de estar bien se llama correctitud (correctness).
La definición tiene dos partes, y las dos se demuestran por separado: que termina y que lo que devuelve está bien. También tiene un cuantificador incómodo: para toda instancia. Ahí está la dificultad.
Por qué las pruebas no alcanzan
Las pruebas son indispensables, y en este curso correrán miles. Pero una prueba revisa una instancia, y un problema tiene infinitas. Este programa calcula el máximo de un arreglo:
int maximum_wrong(const std::vector<int>& a) {
    int best = 0;
    for (int value : a) {
        if (value > best) {
            best = value;
        }
    }
    return best;
}
tests_vs_proof.cpp lo prueba con 1000 arreglos al azar, de hasta 100 valores entre 1 y 1 000 000,
comparando contra std::max_element. Después le pasa un arreglo más:
$ build/tests_vs_proof
pruebas al azar con valores positivos: 1000 de 1000 correctas
con {-5, -2, -9}: devuelve 0, y el máximo es -2
Mil pruebas de mil, y el programa está mal. Ninguna de esas pruebas tenía la oportunidad de encontrar el error, porque todas sacaban valores del mismo lugar. Podríamos haber hecho un millón. El problema no es la cantidad.
Idea clave. Una prueba puede mostrar un error, pero no su ausencia. Un solo contraejemplo (counterexample) refuta un algoritmo. Ninguna cantidad de ejemplos lo demuestra.
Eso no significa que las pruebas sobren. Hay errores que una demostración no atrapa: la demostración habla del pseudocódigo, y el programa puede tener un índice mal escrito o un overflow. Y hay errores que una prueba no atrapa, como este. Por eso aquí hacemos las dos cosas: la demostración dice que el algoritmo está bien, y las pruebas dicen que lo escribimos bien.
En la práctica. La prueba más útil para un algoritmo es comparar contra una solución lenta pero evidente, con miles de entradas pequeñas al azar. Se llama prueba de estrés. Si el programa falla, casi siempre falla con una entrada de menos de diez elementos, que se puede seguir a mano. Pero noten que el generador de la prueba de arriba jamás habría encontrado el bug: una prueba de estrés es tan buena como las entradas que genera.
Invariante de ciclo
Un ciclo puede dar millones de vueltas, y no podemos razonar sobre cada una por separado. Lo que hacemos es buscar una afirmación que sea cierta en todas las vueltas.
Definición. Una invariante de ciclo (loop invariant) es una condición sobre las variables del programa que se cumple cada vez que el ciclo va a evaluar su condición. Para demostrar algo con ella hay que probar tres cosas:
- Inicio. Se cumple antes de la primera vuelta.
- Conservación. Si se cumple antes de una vuelta y la condición del ciclo es verdadera, se cumple después de esa vuelta.
- Salida. Si se cumple y la condición del ciclo es falsa, entonces el resultado es correcto.
Si les suena a inducción, es porque es inducción. El inicio es el caso base, la conservación es el paso inductivo, y lo que se induce es el número de vueltas. El tercer paso es lo que se agrega: una invariante solo sirve si, al salir, dice lo que queríamos demostrar.
Un primer ejemplo, casi demasiado simple, para ver la forma. Queremos sumar un arreglo:
algoritmo suma(a, n)
    s ← 0
    i ← 0
    mientras i < n hacer
        s ← s + a[i]
        i ← i + 1
    fin mientras
    devolver s
fin algoritmo
Afirmación. suma devuelve a[0] + a[1] + … + a[n − 1]. Técnica: invariante de ciclo, con esta
invariante:
0 ≤ i ≤ n, y s = a[0] + … + a[i − 1].
Inicio. Con i = 0, la suma de la derecha no tiene términos, así que vale 0, y s = 0. Además, 0 ≤ 0 ≤ n.
Conservación. Supongamos que vale antes de una vuelta, con i < n. El cuerpo le suma a[i] a s, así que s pasa a ser a[0] + … + a[i]. Después i aumenta en 1, y por lo tanto s = a[0] + … + a[(i nuevo) − 1]. Y como i < n, el nuevo i sigue siendo a lo sumo n.
Salida. El ciclo termina cuando i ≥ n. Con 0 ≤ i ≤ n, eso obliga a i = n. Reemplazando en la invariante, s = a[0] + … + a[n − 1], que es lo que afirmamos.
Terminación. La cantidad n − i es un entero, nunca es negativa por la invariante, y baja en 1 en cada vuelta. No puede bajar para siempre, así que el ciclo termina.
Ese es el esquema entero. Lo que cambia de un algoritmo a otro es lo difícil de encontrar la invariante: casi siempre se encuentra mirando qué se necesita al salir y preguntándose qué parte de eso ya está lista a mitad de camino.
Búsqueda binaria
La vieron en Estructuras de Datos. Se escribe fácil y se escribe mal fácil, así que es un buen caso para aplicar la técnica en serio. Vamos a fijar con precisión qué calcula.
Problema. Entrada: un arreglo a de n enteros, ordenado de menor a mayor (a[0] ≤ a[1] ≤ … ≤ a[n − 1]), con n ≥ 0, y un entero x. Salida: el primer índice i tal que a[i] ≥ x, o n si no hay ninguno.
Es lo que calcula std::lower_bound. Es más útil que “¿está x?”: también sirve para contar cuántos
elementos son menores que x, y para saber dónde insertarlo sin desordenar. Y responde “¿está x?” de paso:
x está en el arreglo si y solo si el resultado r cumple r < n y a[r] = x.
Trabajamos con un rango semiabierto [lo, hi): incluye a lo y no incluye a hi. Es la misma forma de los
iteradores de C++, donde end() apunta justo después del último elemento. Tiene dos ventajas: la cantidad
de elementos del rango es exactamente hi − lo, y el rango vacío se escribe sin trucos, con lo = hi.
algoritmo primero_mayor_o_igual(a, n, x)
    lo ← 0
    hi ← n
    mientras lo < hi hacer
        mid ← lo + (hi - lo) div 2
        si a[mid] < x entonces
            lo ← mid + 1
        sino
            hi ← mid
        fin si
    fin mientras
    devolver lo
fin algoritmo
La invariante
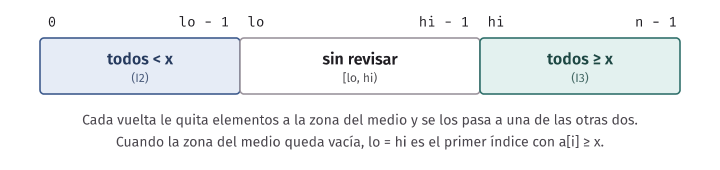
Imaginen el arreglo partido en tres zonas. A la izquierda de lo, lo que ya sabemos que es menor que x. Desde hi en adelante, lo que ya sabemos que es mayor o igual que x. En el medio, [lo, hi), lo que todavía no sabemos:
Invariante.
(I1) 0 ≤ lo ≤ hi ≤ n. (I2) Para todo i con 0 ≤ i < lo, a[i] < x. (I3) Para todo i con hi ≤ i < n, a[i] ≥ x.
Afirmación. Si a está ordenado, primero_mayor_o_igual termina y devuelve el primer índice i con a[i]
≥ x, o n si no hay. Técnica: invariante de ciclo, y una cantidad que baja para la terminación.
Inicio. Con lo = 0 y hi = n vale (I1), porque n ≥ 0. En (I2) no hay ningún i con 0 ≤ i < 0, y en (I3) no hay ningún i con n ≤ i < n. Las dos se cumplen porque no hay nada que revisar.
Conservación. Supongamos que la invariante vale antes de una vuelta, y que lo < hi. Sea d = (hi − lo) div 2. Como hi − lo ≥ 1, tenemos 0 ≤ d < hi − lo, así que mid = lo + d cumple lo ≤ mid < hi. En particular, a[mid] existe. Hay dos casos.
- Caso a[mid] < x. Como a está ordenado, para todo i ≤ mid se tiene a[i] ≤ a[mid] < x. Entonces (I2) vale con el nuevo lo = mid + 1. El valor de hi no cambió, así que (I3) sigue igual. Y (I1) se conserva, porque mid < hi implica mid + 1 ≤ hi.
- Caso a[mid] ≥ x. Como a está ordenado, para todo i ≥ mid se tiene a[i] ≥ a[mid] ≥ x. Entonces (I3) vale con el nuevo hi = mid. El valor de lo no cambió, así que (I2) sigue igual. Y (I1) se conserva, porque lo ≤ mid.
Salida. El ciclo termina cuando lo ≥ hi. Con (I1), eso obliga a lo = hi. Llamemos r a ese valor. Entonces (I2) dice que a[i] < x para todo i < r, y (I3) dice que a[i] ≥ x para todo i ≥ r. Hay dos posibilidades: si r < n, r es el primer índice con a[i] ≥ x, y si r = n, no hay ninguno. En los dos casos, r es lo que pide el problema.
Terminación. La cantidad hi − lo es un entero, y (I1) dice que no es negativa. En el primer caso pasa a hi − mid − 1, que es menor que hi − lo porque mid ≥ lo. En el segundo pasa a mid − lo, que es menor que hi − lo porque mid < hi. Baja estrictamente en cada vuelta, así que no puede haber infinitas vueltas. ∎
Noten dónde se usó cada cosa. El orden del arreglo se usó en los dos casos de la conservación: sin él, mirar un elemento no dice nada de los demás. La desigualdad lo ≤ mid < hi se usó en todo: que el índice exista, que (I1) se conserve, y que el rango baje. De paso, el costo: si el rango tiene s elementos, el siguiente tiene a lo sumo s/2 (⌊s/2⌋ en el segundo caso y ⌈s/2⌉ − 1 en el primero). Por lo tanto, para n ≥ 1 el ciclo da a lo sumo ⌊log n⌋ + 1 vueltas, que es O(log n).
Vuelta por vuelta
El archivo search.h tiene la búsqueda en C++, igual al pseudocódigo:
inline int first_at_least(const std::vector<int>& a, int x) {
    int lo = 0;
    int hi = static_cast<int>(a.size());
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] < x) {
            lo = mid + 1;
        } else {
            hi = mid;
        }
    }
    return lo;
}
Al lado tiene first_at_least_checked, la misma búsqueda con la invariante entera escrita en assert,
que se comprueba en cada vuelta. No es para producción, porque cada comprobación recorre el arreglo. Es
para ver que lo que demostramos es lo que corre. El programa trace_search la usa en el arreglo 3, 7, 7,
12, 15, 20, 28, 31, que tiene n = 8 y un elemento repetido:
$ build/trace_search
x = 7 (lo hi mid a[mid])
0 8 4 15
0 4 2 7
0 2 1 7
0 1 0 3
resultado: 1
x = 16 (lo hi mid a[mid])
0 8 4 15
5 8 6 28
5 6 5 20
resultado: 5
x = 40 (lo hi mid a[mid])
0 8 4 15
5 8 6 28
7 8 7 31
resultado: 8
x = 1 (lo hi mid a[mid])
0 8 4 15
0 4 2 7
0 2 1 7
0 1 0 3
resultado: 0
Sigamos x = 7, que tiene la trampa de los repetidos:
| Vuelta | lo | hi | mid | a[mid] | Comparación | Qué se aprende |
|---|---|---|---|---|---|---|
| 1 | 0 | 8 | 4 | 15 | 15 ≥ 7 | hi ← 4: de la posición 4 en adelante todos son ≥ 7 |
| 2 | 0 | 4 | 2 | 7 | 7 ≥ 7 | hi ← 2: de la 2 en adelante todos son ≥ 7 |
| 3 | 0 | 2 | 1 | 7 | 7 ≥ 7 | hi ← 1: de la 1 en adelante todos son ≥ 7 |
| 4 | 0 | 1 | 0 | 3 | 3 < 7 | lo ← 1: hasta la 0, todos son < 7 |
| Salida | 1 | 1 | r = 1: el primer 7 |
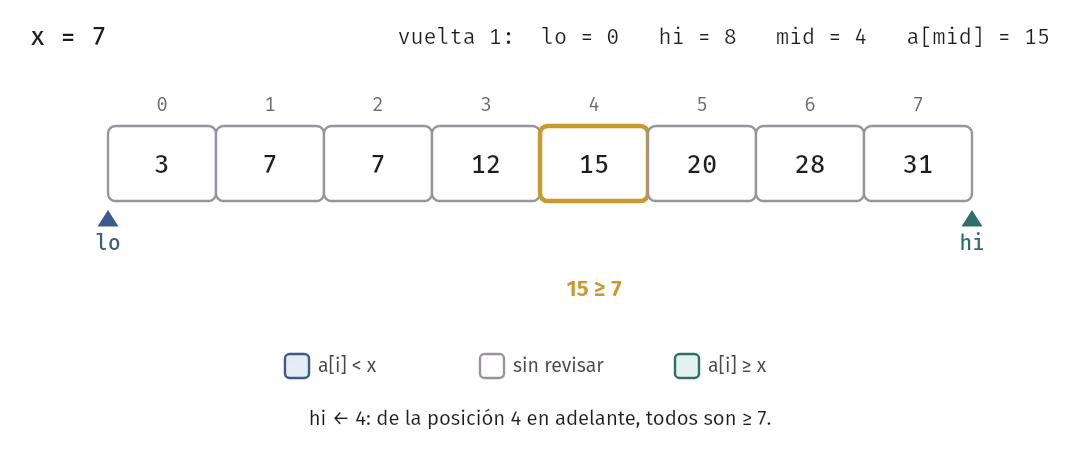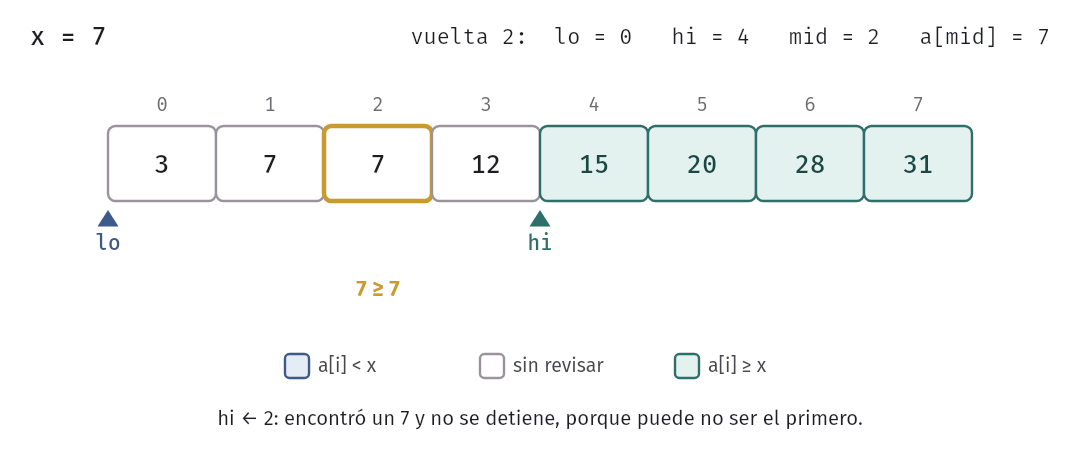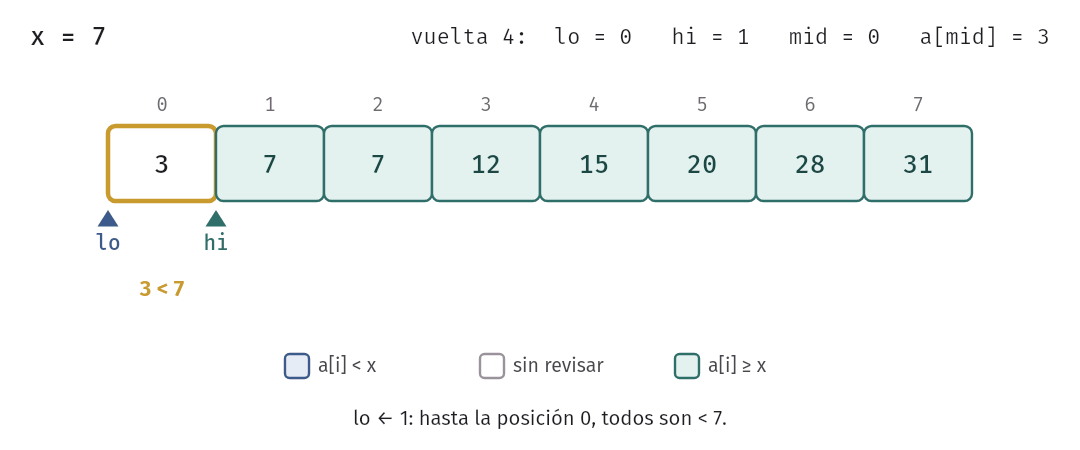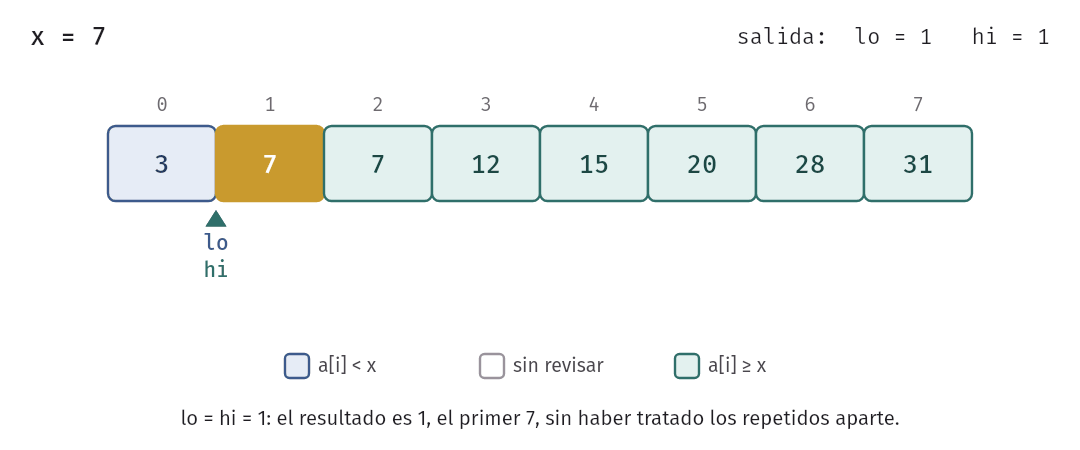
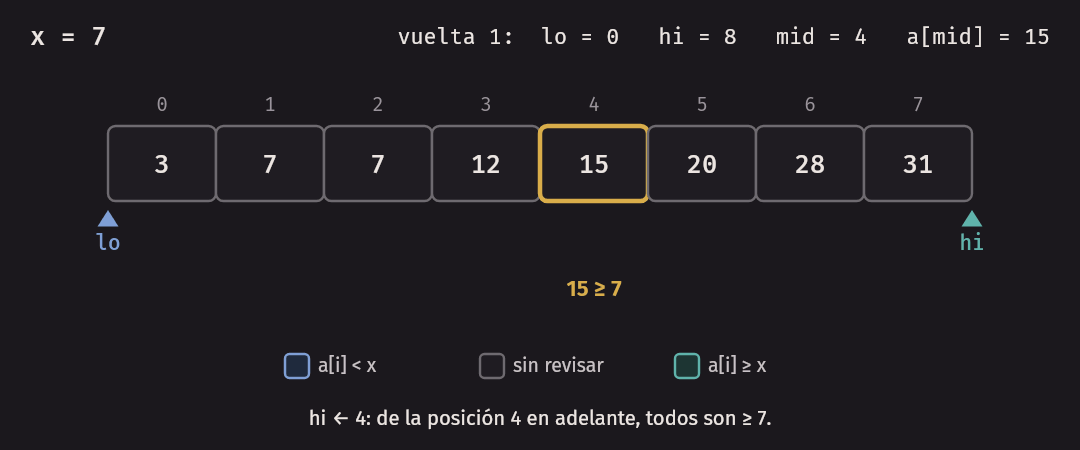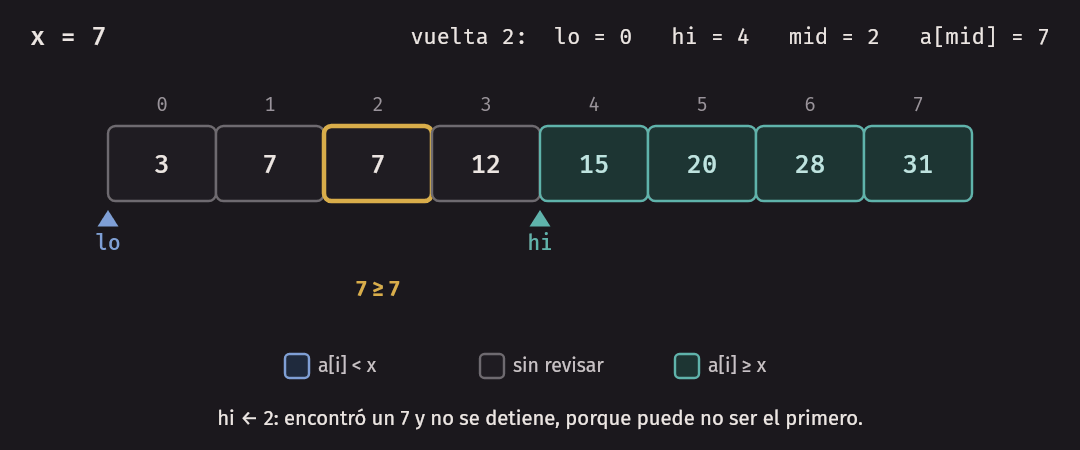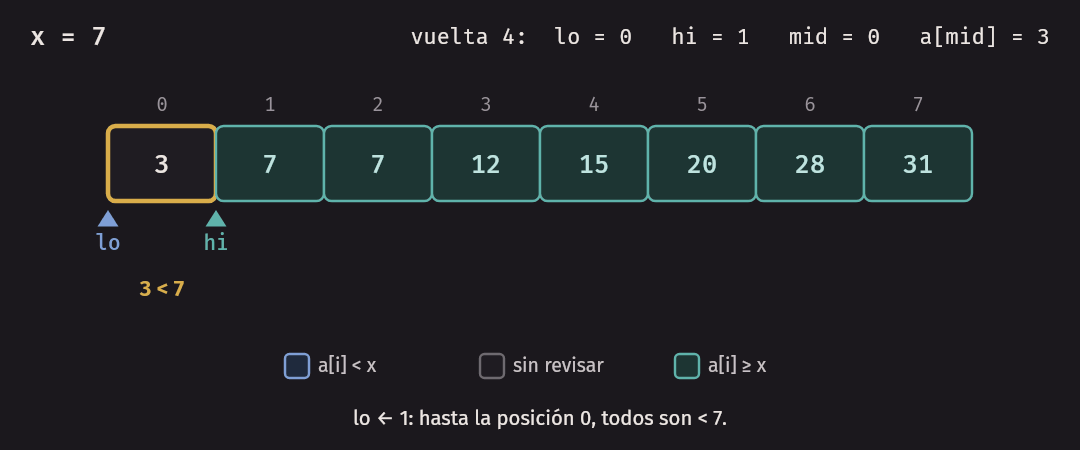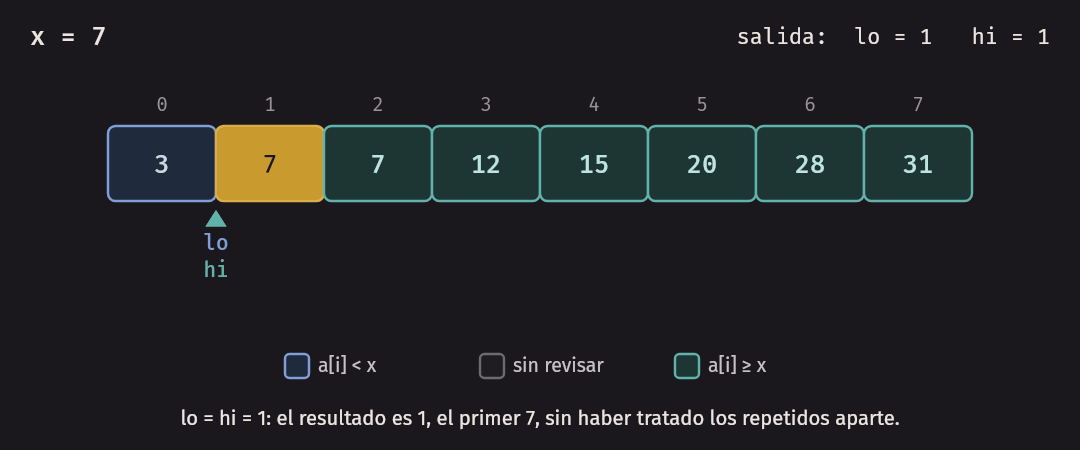
Miren las vueltas 2 y 3: encontró un 7 y no se detuvo. Un 7 en la posición 2 no dice que sea el primero. La invariante no habla de haber encontrado x, solo de qué hay a cada lado, y por eso es que sí llega al primero.
Los otros tres valores cubren los demás casos: x = 16 no está en el arreglo, y el resultado 5 es donde habría que insertarlo. Con x = 40, mayor que todos, el resultado es n = 8. Con x = 1, menor que todos, es 0. La demostración cubre todos esos casos a la vez, sin tratarlos aparte, y eso es lo que da el rango semiabierto.
En C++. Se escribe
lo + (hi - lo) / 2y no(lo + hi) / 2, porque la suma puede pasarse del rango deinten un arreglo enorme, y eso es comportamiento indefinido. Lo vieron en Estructuras de Datos. Fíjense en que la demostración no lo detecta: en el pseudocódigo, los enteros no hacen overflow. Ese es un ejemplo de “lo demostramos bien, y hay que escribirlo bien”.
test_examples.cpp compara first_at_least y su versión comprobada contra std::lower_bound en arreglos
de 0 a 40 elementos, con repetidos, y con valores de x fuera de rango por los dos lados. Esas pruebas no
demuestran nada, pero dirían si copiamos mal la demostración.
Una invariante que no alcanza
Este es el error más común al escribir demostraciones con invariantes, y por eso lo vemos con un ejemplo. Supongan que alguien propone esta invariante para la búsqueda:
0 ≤ lo ≤ hi ≤ n, y a[i] < x para todo i < lo.
Es (I1) e (I2), sin (I3). Es cierta: se cumple al inicio, y se conserva. Pero al salir solo dice que todo lo que está a la izquierda de lo es menor que x. No dice nada de la derecha. ¿Cómo saber si eso es un problema real o un detalle de redacción? Busquemos un programa que cumpla esa invariante y que esté mal:
inline int search_weak_invariant(const std::vector<int>& a, int x) {
    int lo = 0;
    int hi = static_cast<int>(a.size());
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] < x) {
            lo = mid + 1;
        } else {
            hi = lo;
        }
    }
    return lo;
}
Solo cambió hi = mid por hi = lo. Este programa conserva la invariante débil, porque nunca toca lo sin
razón, y además termina. Y da mal:
$ build/bad_searches
buscar 10 en {2, 4, 6, 8, 10}
  correcta: 4
  invariante débil: 3
buscar 9 en {2, 4}
  correcta: 2
  con lo = mid: -1 (cortada a las 1000 vueltas)
En el primer ejemplo devolvió 3, y a[3] = 8 no es mayor o igual que 10. La invariante débil seguía siendo cierta: 2, 4 y 6 son menores que 10. Simplemente no bastaba.
Error común. Escribir una invariante que es verdadera, pero que no alcanza para concluir el resultado al salir del ciclo. “lo ≤ hi” es verdadera en casi cualquier búsqueda, y no demuestra nada. La prueba de fuego es el tercer paso: escriban qué dice la invariante cuando la condición del ciclo es falsa y comprueben que eso es exactamente el resultado. Si les queda un hueco, a la invariante le falta algo.
Otro ejemplo: para el máximo de un arreglo, “best es uno de los elementos de a” es cierto en todas las
vueltas, y no dice que sea el mayor. maximum_wrong, por su parte, falla en el primer paso de cualquier
invariante razonable: best = 0 no tiene por qué ser un elemento del arreglo. Escribir la invariante que
sí funciona es el ejercicio 1.
Cuando la cantidad no baja
La segunda parte de la salida de bad_searches muestra otro error, y ese no es de resultado sino de
terminación. Si en el primer caso se escribe lo = mid en vez de lo = mid + 1, la invariante sigue
siendo cierta, porque a[i] < x para todo i ≤ mid implica lo mismo para i < mid. Y aun así:
| Vuelta | lo | hi | mid | a[mid] | Qué pasa |
|---|---|---|---|---|---|
| 1 | 0 | 2 | 1 | 4 | 4 < 9, y lo ← 1 |
| 2 | 1 | 2 | 1 | 4 | 4 < 9, y lo ← 1: nada cambió |
| 3 | 1 | 2 | 1 | 4 | igual, para siempre |
Cuando hi − lo = 1, mid = lo, y lo = mid no mueve nada. El programa de ejemplo se corta a las 1000
vueltas y devuelve −1 para poder mostrarlo. Un programa de verdad se queda colgado, y el juez lo marcaría
TLE. La demostración de terminación habría detectado esto: en ese caso, hi − lo no baja.
Inducción: potencia rápida
Para una función recursiva, el equivalente de la invariante es la inducción sobre el tamaño de la entrada. Se supone que las llamadas recursivas ya hacen lo que dice su contrato (contract), y se demuestra que la llamada actual también. Esto no es un acto de fe: es lo que permite la inducción, siempre que las llamadas recursivas sean sobre entradas estrictamente más pequeñas.
Problema. Dados enteros b ≥ 0, e ≥ 0 y m ≥ 1, calcular bᵉ mod m.
La forma obvia hace e multiplicaciones. Con e = 10⁹ son mil millones. La idea rápida es que b¹³ = (b⁶)² · b, y que b⁶ = (b³)²: cada paso reduce el exponente a la mitad.
algoritmo potencia(b, e, m)
    si e = 0 entonces
        devolver 1 mod m
    fin si
    mitad ← potencia(b, e div 2, m)
    resultado ← (mitad * mitad) mod m
    si e mod 2 = 1 entonces
        resultado ← (resultado * b) mod m
    fin si
    devolver resultado
fin algoritmo
Afirmación. Para todo e ≥ 0, potencia(b, e, m) termina y devuelve bᵉ mod m. Técnica: inducción
fuerte sobre e.
Caso base, e = 0. La función devuelve 1 mod m, y b⁰ mod m = 1 mod m. Hace falta escribir 1 mod m y no
1 por el caso m = 1, donde todo número da 0.
Paso inductivo, e ≥ 1. Supongamos que la afirmación vale para todo exponente menor que e. Sea k = e div 2.
Como e ≥ 1, k < e, y por lo tanto la llamada recursiva termina y devuelve mitad = bᵏ mod m. Entonces
mitad · mitad ≡ b²ᵏ módulo m, y hay dos casos:
- Si e es par, e = 2k, y
resultado= b²ᵏ mod m = bᵉ mod m. - Si e es impar, e = 2k + 1, y al multiplicar por b queda
resultado= b²ᵏ⁺¹ mod m = bᵉ mod m.
En los dos casos se usa que el resto de un producto solo depende de los restos de sus factores. ∎
Fíjense en que la terminación vino incluida: la inducción sobre e funciona porque k < e. La misma cantidad
entera que baja. Si la llamada recursiva fuera potencia(b, e, m), la “demostración” no se podría
escribir, porque no se puede suponer lo que se quiere demostrar para el mismo e.
El costo. Contemos multiplicaciones. Las llamadas con exponente mayor que 0 son e, e div 2, e div 4, …
hasta 1, y son ⌊log e⌋ + 1. Cada una hace un cuadrado, y además un producto si su exponente es impar. Los
exponentes impares corresponden exactamente a los bits en 1 de e. Por lo tanto, para e ≥ 1, el total es
exactamente ⌊log e⌋ + 1 + (bits en 1 de e), que es a lo sumo 2(⌊log e⌋ + 1). Eso es O(log e).
test_examples.cpp comprueba esa igualdad exacta para todo e hasta 5000.
inline long long power_mod(long long b, long long e, long long m, long long* multiplications = nullptr) {
    if (e == 0) {
        return 1 % m;
    }
    long long half = power_mod(b, e / 2, m, multiplications);
    long long result = half * half % m;
    if (multiplications) (*multiplications)++;
    if (e % 2 == 1) {
        result = result * (b % m) % m;
        if (multiplications) (*multiplications)++;
    }
    return result;
}
$ build/trace_power
e 3^e mod 1000 productos
0 1 0
1 3 2
3 27 4
6 729 5
13 323 7
2^1000000000 mod 1000000007 = 140625001 con 43 productosSigan la columna e de abajo hacia arriba: para calcular 3¹³ se pide 3⁶, que pide 3³, que pide 3¹, que pide 3⁰. Y los valores vuelven así:
| e | k = e div 2 | mitad |
mitad² mod 1000 |
¿e impar? | resultado |
|---|---|---|---|---|---|
| 0 | 1 | ||||
| 1 | 0 | 1 | 1 | sí | 3 |
| 3 | 1 | 3 | 9 | sí | 27 |
| 6 | 3 | 27 | 729 | no | 729 |
| 13 | 6 | 729 | 441 | sí | 441 · 3 mod 1000 = 323 |
En efecto, 3¹³ = 1 594 323. Y con e = 10⁹, en vez de mil millones de productos hay 43: ⌊log 10⁹⌋ = 29, más 1, más los 13 bits en 1 de 10⁹.
En C++. Un resto puede valer hasta m − 1. Si m llega a 10⁹ + 7, el producto de dos restos pasa de 10¹⁸, que no cabe en
intpero sí enlong long. La función pide m ≤ 2³¹: cada factor es menor que 2³¹, así que el producto es menor que 2⁶², ylong longllega hasta 2⁶³ − 1. Hagan siempre esa cuenta. También por eso se escribeb % m: b podría ser mayor que m.
Error común. Escribir
potencia(b, e div 2, m) * potencia(b, e div 2, m). Es correcto, y la demostración de arriba casi no cambia. Pero ya no son ⌊log e⌋ + 1 llamadas, sino que el número se duplica en cada nivel, y el total vuelve a ser proporcional a e. Correcto y eficiente son dos demostraciones distintas. La próxima semana veremos cómo sacar esa cuenta con una recurrencia.
Terminación
Ya la usamos tres veces. Vale la pena decir la regla en general.
Regla. Para demostrar que un proceso termina, se busca una cantidad entera que (a) nunca sea negativa y (b) baje estrictamente en cada paso. Como no hay una sucesión infinita de enteros no negativos estrictamente decreciente, el proceso se detiene. Si además la cantidad empieza en N, hay a lo sumo N pasos: la regla da también una cota del costo.
| Algoritmo | Cantidad que baja | Por qué baja | Pasos |
|---|---|---|---|
suma |
n − i | i aumenta en 1 | n |
| Búsqueda binaria | hi − lo | al menos se reduce a la mitad | O(log n) |
| Potencia rápida | e | e div 2 < e, si e ≥ 1 | O(log e) |
Hay dos maneras frecuentes de equivocarse. Una es elegir una cantidad que baja pero que puede ser
negativa, como una variable que resta siempre, sin una razón para detenerse en cero. La otra es que la
cantidad solo baje “casi siempre”, como pasó con lo = mid: bajaba en todas las vueltas menos en la del
final, y eso bastó para que no terminara.
Hay procesos donde la cantidad no es nada obvia. En Gale-Shapley no se ve a simple vista en el código, y la encontraremos en un momento.
Cómo se escribe una demostración aquí
La fórmula es siempre la misma, y es la que se les pedirá en las prácticas:
- Qué se afirma. Una oración precisa, con sus condiciones. “El algoritmo funciona” no es una afirmación.
- Con qué técnica. Invariante, inducción, contradicción. Quien lee sabe así qué esperar.
- Los pasos, cortos y en prosa, cubriendo todos los casos. Cada paso dice qué hecho usa. Si hay dos casos, se escriben los dos.
- Dónde se usan las condiciones. Si una hipótesis no se usó, algo falta, o la hipótesis sobra. En la búsqueda binaria, que el arreglo esté ordenado es lo que hace funcionar los dos casos.
Una tabla con la corrida de un ejemplo ayuda a entender, pero no reemplaza al argumento: es una instancia, y ya vimos lo que vale una instancia.
Hasta aquí la Sesión A. Ahora aplicamos todo esto a un algoritmo donde no se ve a simple vista por qué funciona.
El problema del matching estable
Imaginen que una facultad tiene n estudiantes que van a hacer su tesis y n profesores que van a asesorar, cada uno a un solo tesista. Cada tesista ordena a todos los asesores por preferencia, y cada asesor ordena a todos los tesistas. Todas las listas son completas y estrictas: nadie deja a nadie fuera, y no hay empates. Hay que repartirlos en parejas.
¿Qué hace que un reparto sea malo? Supongan que al tesista t le tocó el asesor a, y al tesista t’ le tocó el asesor a’. Si t prefiere a a’ antes que a a, y además a’ prefiere a t antes que a t’, esos dos tienen un motivo para ignorar el reparto y arreglarse entre ellos. Con eso el reparto se cae, aunque sea el resultado de un sistema oficial.
Definiciones.
- Un matching (o emparejamiento) es un conjunto de parejas tesista-asesor en el que nadie aparece dos veces. Es perfecto si incluye a todos.
- Dado un matching perfecto M, un par inestable es un tesista t y un asesor a que no forman pareja en M y tales que t prefiere a a antes que a su pareja en M, y a prefiere a t antes que a su pareja en M.
- Un matching perfecto es estable si no tiene pares inestables. Ese es el problema del matching estable (stable matching).
Noten el “y”. Si solo uno de los dos prefiere cambiar, no pasa nada, porque el otro no acepta. Un matching estable no significa que todos estén contentos: puede haber alguien con su última opción. Significa que nadie tiene con quién irse.
No es evidente que siempre exista uno. En problemas parecidos no existe: en el problema de repartir compañeros de cuarto, donde todos pueden emparejarse con todos, hay instancias sin ningún reparto estable (ejercicio 10). Aquí, el hecho de que haya dos lados es lo que lo salva, y lo vamos a demostrar construyéndolo.
Usaremos este ejemplo con cuatro tesistas, t0 a t3, y cuatro asesores, a0 a a3:
| Tesista | Lista, de más a menos preferido | Asesor | Lista, de más a menos preferido | |
|---|---|---|---|---|
| t0 | a1, a0, a2, a3 | a0 | t0, t3, t2, t1 | |
| t1 | a1, a2, a0, a3 | a1 | t1, t0, t2, t3 | |
| t2 | a0, a1, a3, a2 | a2 | t0, t1, t2, t3 | |
| t3 | a0, a3, a2, a1 | a3 | t3, t2, t0, t1 |
En el código, tesistas y asesores son enteros de 0 a n − 1, y las listas son un
std::vector<std::vector<int>>, en instances.h. Esa será siempre la forma de representarlo: un mismo
tipo Preferences para los dos lados.
Dos ideas que parecen razonables, y que fallan
Antes de ver el algoritmo correcto, probemos dos ideas parecidas. Es el mismo ejercicio de siempre: ver un contraejemplo enseña dónde está lo difícil.
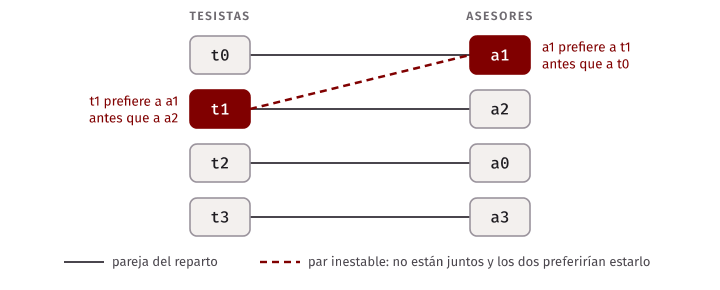
Idea 1: la primera oferta manda. Cada tesista, en orden, se queda con el asesor libre que más le gusta. El asesor acepta a quien llegue primero y no cambia nunca. Corre en tiempo razonable y da un matching perfecto. Pero sobre nuestro ejemplo:
$ build/first_offer
primera oferta: t0-a1 t1-a2 t2-a0 t3-a3
par inestable: t1 y a1
t1 quería a a1 en primer lugar, pero t0 llegó antes y a1 quedó ocupado. Lo malo es que a1 también prefiere a t1 antes que a t0. Los dos se prefieren y no están juntos. El par inestable existe porque a1 aceptó sin saber qué ofertas vendrían después.
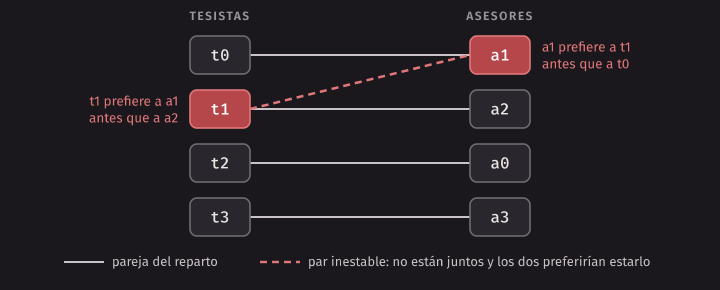
Idea 2: arreglar lo que esté mal. Se parte de cualquier matching perfecto. Mientras haya un par
inestable, se junta a esas dos personas, y sus dos ex parejas quedan juntas entre sí. Parece que cada paso
mejora las cosas. Probémoslo con otra instancia, tomando en cada paso el primer par inestable, en el orden
de los tesistas y de sus listas (en repair_loop.cpp están las listas). Cada línea muestra el asesor que
le toca a t0, t1, t2 y t3:
$ build/repair_loop
a0 a1 a2 a3 par inestable: t1 y a3
a0 a3 a2 a1 par inestable: t2 y a0
a2 a3 a0 a1 par inestable: t3 y a0
a2 a3 a1 a0 par inestable: t0 y a1
a1 a3 a2 a0 par inestable: t2 y a3
a1 a2 a3 a0 par inestable: t3 y a2
a1 a0 a3 a2 par inestable: t1 y a1
a0 a1 a3 a2 par inestable: t2 y a0
a3 a1 a0 a2 par inestable: t0 y a2
a2 a1 a0 a3 par inestable: t1 y a3
volvimos a: a2 a3 a0 a1
matchings estables de esta instancia: 3
Después de diez arreglos, volvimos a un matching que ya habíamos visto, el de la tercera línea. Como la regla es determinista, de ahí en adelante se repite para siempre. Y eso que esta instancia tiene tres matchings estables. Cada arreglo mejora a dos personas y puede empeorar a las otras dos, y no conocemos ninguna cantidad que baje. Esta instancia es un contraejemplo para esta regla de elegir el par; no dice nada de otras reglas.
Las dos ideas fallan por razones opuestas: la primera decide demasiado pronto y no se retracta nunca, y la segunda se retracta sin ningún control. El algoritmo correcto hace algo intermedio: un lado solo avanza, y el otro solo mejora.
Gale-Shapley
David Gale y Lloyd Shapley publicaron este algoritmo en 1962. La idea es posponer el sí definitivo: los tesistas proponen y los asesores no se comprometen de verdad hasta el final.
- Un tesista libre le propone al asesor que más le gusta entre los que todavía no le ha propuesto.
- Un asesor libre acepta, por ahora.
- Un asesor ocupado compara: se queda con el que prefiere de los dos, y el otro vuelve a estar libre.
algoritmo gale_shapley(pref_t, pref_a, n)
    para t desde 0 hasta n - 1 hacer
        siguiente[t] ← 0
    fin para
    para a desde 0 hasta n - 1 hacer
        pareja[a] ← -1
    fin para
    libres ← todos los tesistas
    mientras libres no esté vacío hacer
        t ← sacar un tesista cualquiera de libres
        a ← pref_t[t][siguiente[t]]
        siguiente[t] ← siguiente[t] + 1
        si pareja[a] = -1 entonces
            pareja[a] ← t
        sino si a prefiere a t antes que a pareja[a] entonces
            agregar pareja[a] a libres
            pareja[a] ← t
        sino
            agregar t a libres
        fin si
    fin mientras
    devolver pareja
fin algoritmo
siguiente[t] es la posición en la lista de t del próximo asesor al que le va a proponer. pareja[a] es
el tesista que tiene a por ahora, o −1 si no tiene ninguno. Se dice “un tesista cualquiera” a propósito:
la demostración no usará el orden, y más adelante veremos que el resultado no depende de él.
Vuelta por vuelta
Con nuestro ejemplo, sacando de libres en orden de pila, con t0 arriba:
$ build/trace_gale_shapley
1: t0 propone a a1, que estaba libre: acepta
2: t1 propone a a1, que cambia a t0 por t1
3: t0 propone a a0, que estaba libre: acepta
4: t2 propone a a0, que se queda con t0
5: t2 propone a a1, que se queda con t1
6: t2 propone a a3, que estaba libre: acepta
7: t3 propone a a0, que se queda con t0
8: t3 propone a a3, que cambia a t2 por t3
9: t2 propone a a2, que estaba libre: acepta
resultado: t0-a0 t1-a1 t2-a2 t3-a3
propuestas: 9
pares inestables: ninguno
Y el estado en cada paso:
| Paso | Propone | A quién | a0 tiene | a1 tiene | a2 tiene | a3 tiene | Libres al terminar el paso |
|---|---|---|---|---|---|---|---|
| Inicio | t0, t1, t2, t3 | ||||||
| 1 | t0 | a1 | t0 | t1, t2, t3 | |||
| 2 | t1 | a1 | t1 | t0, t2, t3 | |||
| 3 | t0 | a0 | t0 | t1 | t2, t3 | ||
| 4 | t2 | a0 | t0 | t1 | t2, t3 | ||
| 5 | t2 | a1 | t0 | t1 | t2, t3 | ||
| 6 | t2 | a3 | t0 | t1 | t2 | t3 | |
| 7 | t3 | a0 | t0 | t1 | t2 | t3 | |
| 8 | t3 | a3 | t0 | t1 | t3 | t2 | |
| 9 | t2 | a2 | t0 | t1 | t2 | t3 | ninguno |
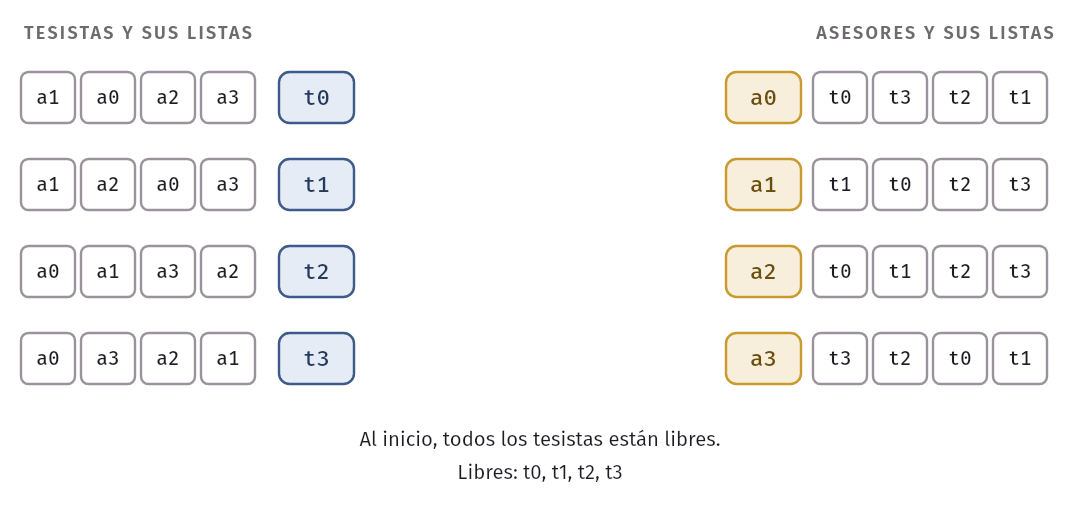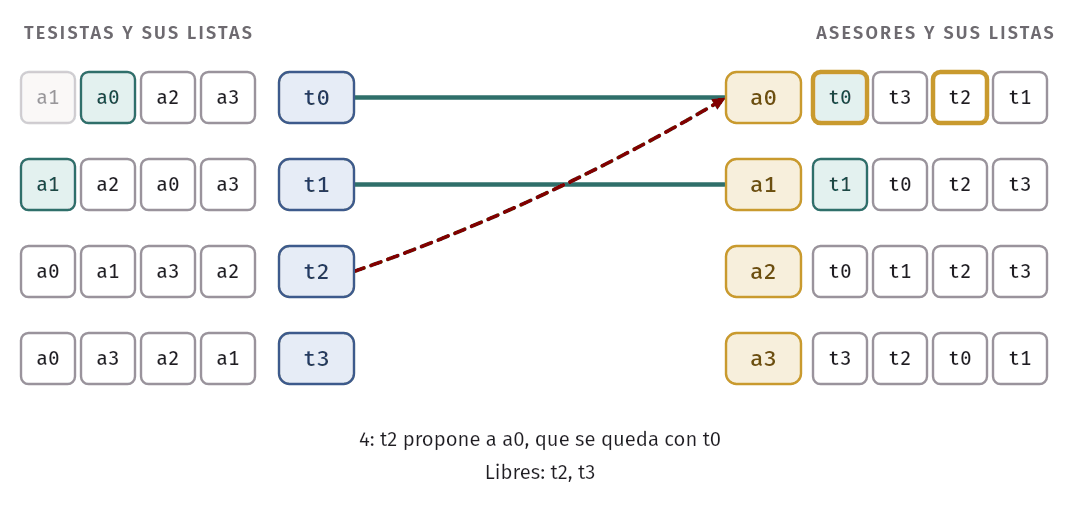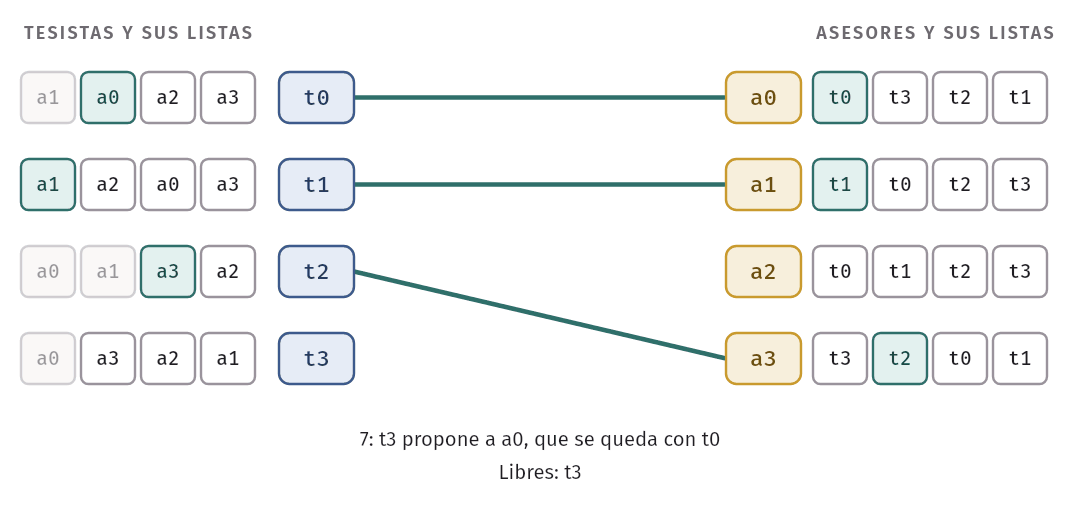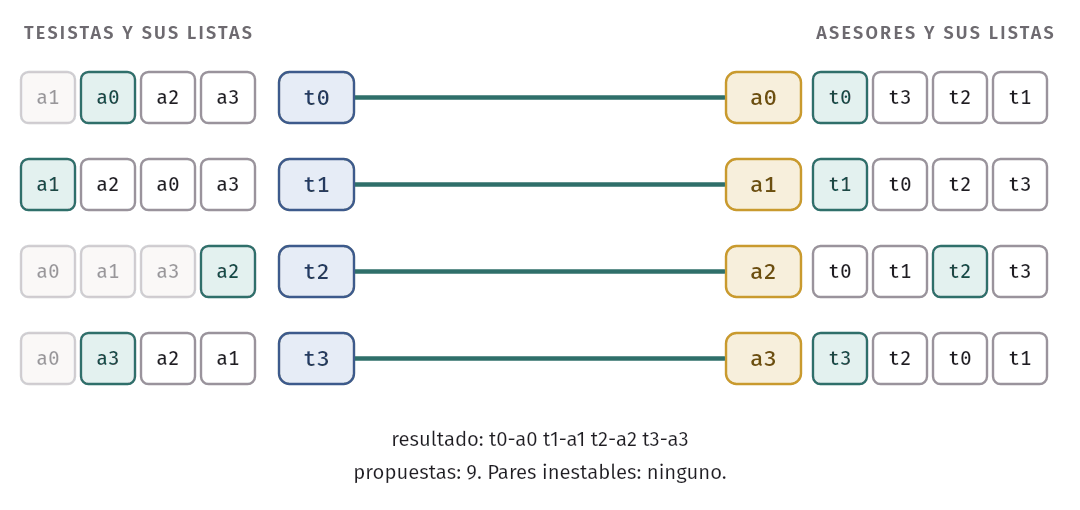
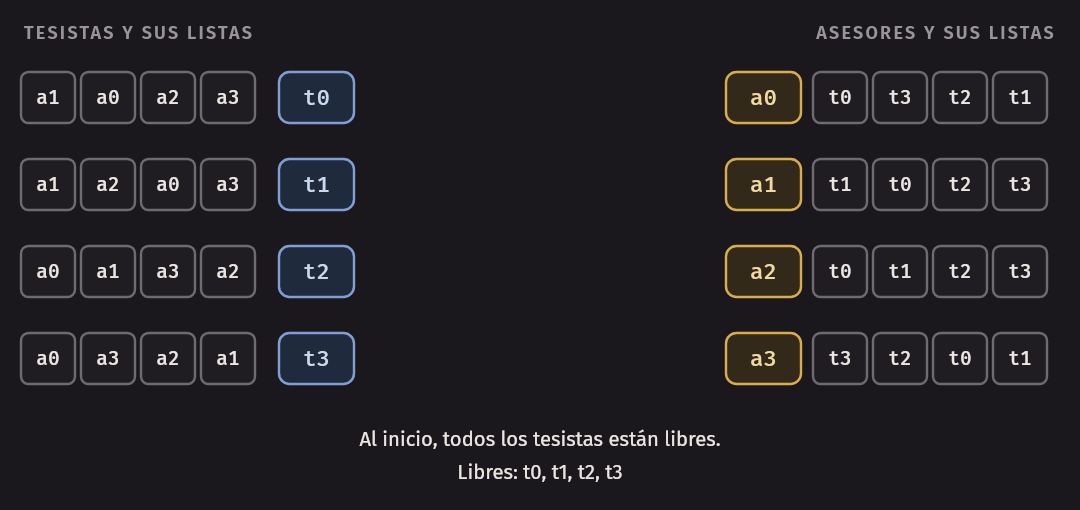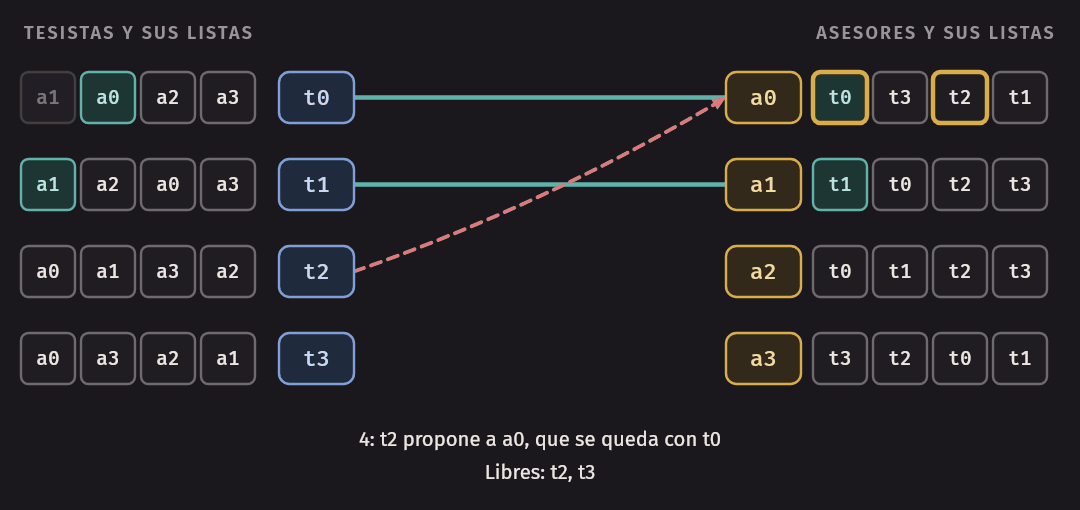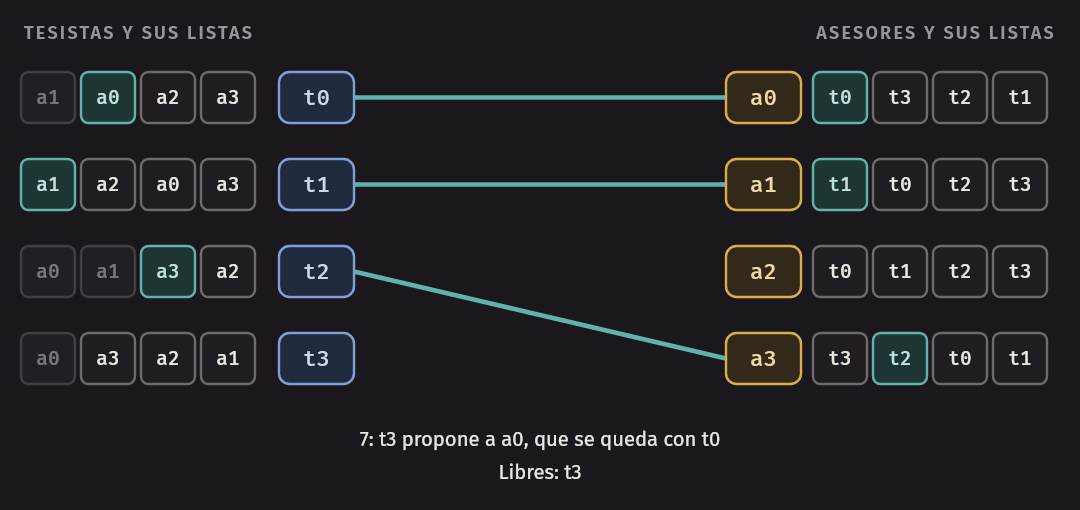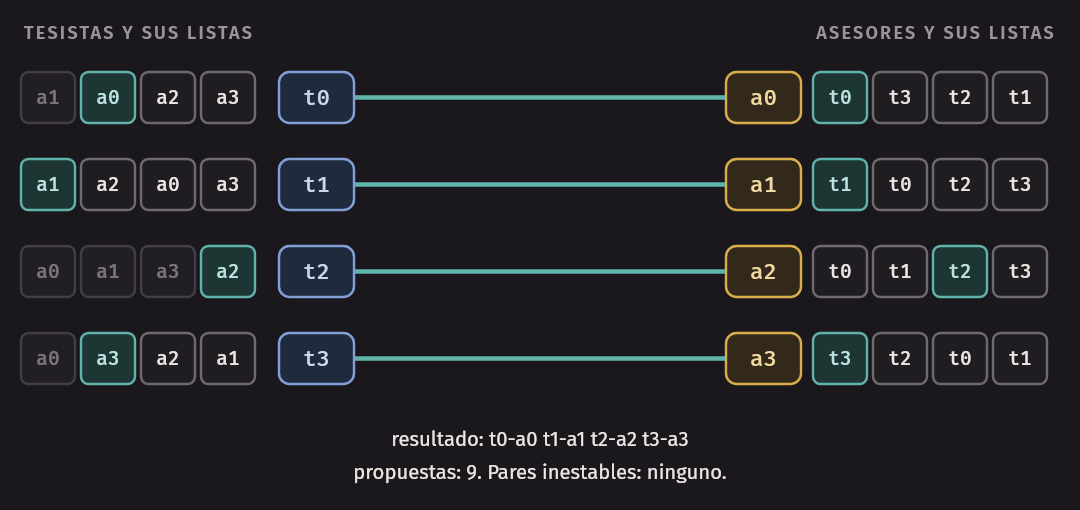
Miren cómo se mueve cada lado. Cada columna de un asesor solo cambia para mejor: a1 cambió a t0 por t1 en el paso 2, y a3 cambió a t2 por t3 en el paso 8. Cada tesista, en cambio, solo va bajando por su lista: t2 terminó con el último de la suya, a2.
¿Es estable? t2 quería a a0, a1 y a3 antes que a a2, pero cada uno de ellos prefiere a quien tiene. t0
quería a a1, que tiene a su primera opción. t3 quería a a0, que también tiene a su primera opción. Y t1 ya
tiene a su primera opción, a a1. La salida del programa lo confirma, porque find_unstable_pair revisa
todos los pares. Pero esta es solo una instancia. Vamos a demostrarlo para todas.
Las dos observaciones que sostienen todo
Las dos se leen directamente del pseudocódigo. Las demostraciones que siguen no usan nada más.
Lema 1 (los asesores solo mejoran). Una vez que un asesor recibe su primera propuesta, tiene pareja hasta el final, y cada cambio de pareja es a alguien que prefiere.
Demostración. Miren qué líneas tocan pareja[a]. Si es −1, pasa a ser t. Si no es −1, solo cambia en la
rama donde a prefiere a t antes que a su pareja actual. Ninguna línea la vuelve a poner en −1. ∎
Lema 2 (los tesistas solo bajan). Cada tesista propone en el orden de su lista, a cada asesor como máximo una vez.
Demostración. Las propuestas de t usan pref_t[t][siguiente[t]], y siguiente[t] aumenta en 1 con cada
una y nunca baja. Las posiciones son distintas, y la lista no repite asesores. ∎
Una cosa más que se conserva en todo el proceso: pareja es siempre un matching (quizá incompleto), y
todo tesista está en libres o es la pareja de exactamente un asesor. Se ve al revisar las tres ramas: en
cada una, quien sale de una pareja vuelve a libres, y quien entra salió de libres.
Un tesista libre siempre tiene a quién proponer
El pseudocódigo lee pref_t[t][siguiente[t]]. ¿Y si siguiente[t] ya llegó a n? Hay que descartar eso
antes de seguir, porque si no, ni siquiera sabemos que cada línea tiene sentido.
Lema 3. Si un tesista t está libre, entonces siguiente[t] < n: todavía no le ha propuesto a todos.
Demostración, por contradicción. Supongamos que t está libre y que ya les propuso a los n asesores. Por
el Lema 1, los n asesores tienen pareja, porque todos recibieron una propuesta. Como pareja es un
matching, esas parejas son n tesistas distintos. Ninguno de ellos es t, porque t está libre. Pero solo hay
n − 1 tesistas aparte de t. Contradicción. ∎
Aquí se usan dos hipótesis del problema: que los dos grupos tienen el mismo tamaño y que las listas son completas. Sin ellas, el lema es falso, y un tesista puede quedarse sin pareja. Lo retomaremos con la variante con cupos.
Termina
Teorema 1. Gale-Shapley termina después de a lo sumo n² propuestas.
Técnica: una cantidad entera que baja. Tomemos
Φ = suma, sobre todos los tesistas t, de (n −
siguiente[t]).
Es la cantidad de propuestas que todavía pueden hacerse. Empieza en n². Por el Lema 3, cada vez que se lee
pref_t[t][siguiente[t]], siguiente[t] es menor que n, así que Φ nunca es negativa. Cada vuelta del
ciclo hace exactamente una propuesta, y aumenta en 1 un solo siguiente[t]. Por lo tanto Φ baja
exactamente en 1 en cada vuelta, y hay a lo sumo n² vueltas. ∎
Esa es la cantidad oculta que anunciamos. Observen que no es el número de tesistas libres, que nunca sube, pero a veces se queda igual: en el paso 2 del ejemplo hay una propuesta y la cantidad de libres no baja. La medida que importa son las propuestas no hechas. Cada persona propone a cada opción como máximo una vez, y son n personas con n opciones.
Error común. Pensar que n² propuestas es lo que siempre ocurre. Es solo una cota. En la práctica puede haber muchas menos, y en la tabla de la sección de implementación verán cuántas. Y tampoco es exacta en el peor caso: el ejercicio 7 pide demostrar que no pasan de n² − n + 1.
Da un matching perfecto
Teorema 2. Al terminar, pareja es un matching perfecto.
Demostración. El ciclo termina cuando libres está vacío, así que todos los tesistas tienen pareja.
pareja es un matching, así que son n tesistas con n asesores distintos, y por lo tanto están todos. ∎
Es estable
Teorema 3. El matching que devuelve Gale-Shapley no tiene pares inestables.
Técnica: contradicción. Llamemos M al resultado. Supongamos que hay un par inestable: t y a no están juntos en M, t prefiere a a antes que a su pareja en M, y a prefiere a t antes que a su pareja en M.
Paso 1: t le propuso a a. Por el Lema 2, t propone en el orden de su lista. Su pareja final en M está en esa lista después de a, y t le propuso a ella. Por lo tanto ya le había propuesto a a.
Paso 2: a dejó a t en algún momento. t y a no están juntos al final, así que en algún momento a no se quedó con t. Hay dos maneras, y las dos dicen lo mismo:
- a rechazó a t en el momento de la propuesta, porque ya tenía a alguien que prefería.
- a aceptó a t, y más tarde lo cambió por alguien que prefería.
En los dos casos, en ese momento a tenía o pasó a tener una pareja que prefiere antes que a t.
Paso 3: de ahí en adelante, a solo mejora. Por el Lema 1, la pareja final de a en M es esa misma persona o alguien que a prefiere aún más. En cualquier caso, a prefiere a su pareja en M antes que a t.
Eso contradice que a prefiere a t antes que a su pareja en M. ∎
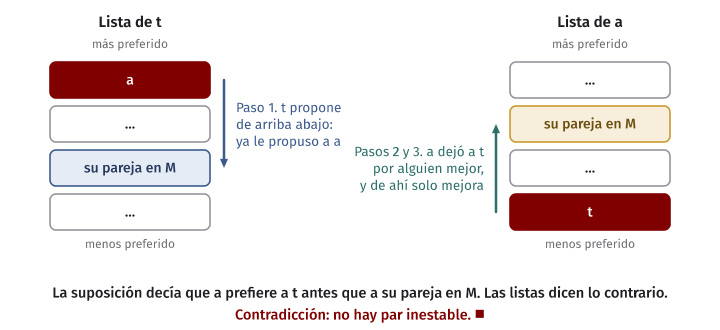
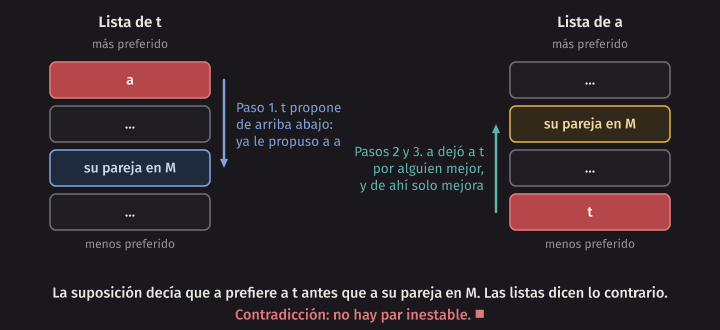
Los tres teoremas juntos responden la pregunta de antes: siempre existe un matching estable, y lo sabemos porque hay un algoritmo que lo construye. Fíjense en que la demostración usó cada lema solo para lo que decía. Y noten dónde está el truco: los tesistas solo empeoran y los asesores solo mejoran, y esas dos direcciones se encuentran en la contradicción.
Idea clave. La diferencia entre la Idea 1 y Gale-Shapley es un solo detalle: poder cambiar de pareja. Sin él, el paso 3 de la demostración es falso, porque el asesor no mejora. Por eso a este algoritmo también se le llama de aceptación diferida (deferred acceptance).
Quién propone importa
Un problema puede tener varios matchings estables. El más pequeño que muestra eso es este, en
instances.h: dos tesistas y dos asesores que no coinciden en nada.
| Tesista | Lista | Asesor | Lista | |
|---|---|---|---|---|
| t0 | a0, a1 | a0 | t1, t0 | |
| t1 | a1, a0 | a1 | t0, t1 |
Hay dos repartos posibles y los dos son estables. En {t0-a0, t1-a1}, los dos tesistas tienen su primera opción, y nadie de ese lado quiere irse. En {t0-a1, t1-a0}, los dos asesores tienen su primera opción. ¿Cuál devuelve el algoritmo?
$ build/who_proposes
instancia cruzada
  estable: t0-a0 t1-a1
  estable: t0-a1 t1-a0
  proponen los tesistas: t0-a0 t1-a1
  proponen los asesores: t0-a1 t1-a0
ejemplo de cuatro
  estable: t0-a0 t1-a1 t2-a2 t3-a3
  proponen los tesistas: t0-a0 t1-a1 t2-a2 t3-a3
  proponen los asesores: t0-a0 t1-a1 t2-a2 t3-a3
Depende de quién propone, y gana el que propone. Eso no es casualidad en este ejemplo: es un teorema. Y el ejemplo de cuatro muestra el otro extremo: tiene un solo matching estable, y por eso da lo mismo.
Definición. Decimos que un asesor a es viable para un tesista t si existe algún matching estable en el que t y a forman pareja. El mejor viable de t es el asesor viable que t prefiere sobre todos los demás viables.
Noten lo fuerte que suena lo siguiente. No es obvio que todos puedan recibir su mejor viable a la vez: dos tesistas podrían tener el mismo mejor viable.
Teorema 4. En el matching que devuelve Gale-Shapley, cada tesista queda con su mejor viable. En
particular, el resultado no depende del orden en que se saca a los tesistas de libres.
Técnica: contradicción, mirando el primer momento en que algo sale mal. Vamos a demostrar que ningún tesista es rechazado nunca por un asesor viable para él. Aquí “rechazado” incluye las dos maneras del Teorema 3: al proponer, o más tarde al ser cambiado.
Supongamos que no es así. Consideremos, entre todos los rechazos de un tesista por un asesor viable en la corrida, el primero en el tiempo: el tesista t es rechazado por a, y a es viable para t. El rechazo ocurre porque a tiene, o acaba de recibir, a un tesista t’ que prefiere antes que a t.
Paso 1: un matching estable con t y a. Como a es viable para t, hay un matching estable S en el que t y a forman pareja. Sea a’ la pareja de t’ en S. Como en S la pareja de a es t, y t’ ≠ t, se tiene a’ ≠ a.
Paso 2: t’ prefiere a a antes que a a’. En este momento, t’ ya le propuso a a. Por el Lema 2, si t’ prefiriera a a’ antes que a a, ya le habría propuesto a a’ antes, y como en este momento está con a o proponiéndole, a’ lo habría rechazado. Pero a’ es viable para t’, porque están juntos en el matching estable S, y este sería un rechazo por un asesor viable anterior al que estamos considerando. Eso contradice que este es el primero. Como las listas son estrictas y a ≠ a’, t’ prefiere a a antes que a a’.
Paso 3: S no es estable. En S, t’ está con a’ y a está con t. Acabamos de ver que t’ prefiere a a antes que a su pareja a’. Y a prefiere a t’ antes que a su pareja t, porque por eso lo rechazó. Entonces (t’, a) es un par inestable de S. Eso contradice que S es estable.
Por lo tanto, ningún tesista es rechazado por un asesor viable. Falta concluir. Sea M el resultado, y sea a* la pareja de t en M. Por el Lema 2, t le propuso a todos los que prefiere antes que a a*, y todos ellos lo rechazaron, así que ninguno es viable. Y a* sí es viable, porque M es estable (Teorema 3). Entonces a* es el mejor viable de t.
Esto describe el resultado sin mencionar ningún orden: la pareja de cada t es su mejor viable, y esa definición habla solo de las listas. Por lo tanto, el resultado es siempre el mismo, sea cual sea el orden. ∎
También sale un corolario inmediato: como t propone exactamente a los asesores de su lista hasta llegar a su pareja final, el número de propuestas tampoco depende del orden. Es la suma, sobre todos los tesistas, de la posición de su pareja en su lista, contando desde 1. En el ejemplo: 2 + 1 + 4 + 2 = 9.
El otro lado paga la cuenta:
Teorema 5. En el matching que devuelve Gale-Shapley, cada asesor queda con el peor tesista para el cual es viable.
Técnica: contradicción. Sea M el resultado y sea (t, a) una pareja de M. Supongamos que hay un matching estable S donde a está con un t’ que a prefiere menos que a t. Sea a’ la pareja de t en S. Como en S a está con t’ ≠ t, se tiene a’ ≠ a. Por el Teorema 4, a es el mejor viable de t, y a’ es viable para t porque están juntos en S. Entonces t prefiere a a antes que a a’. Y a prefiere a t antes que a t’. Por lo tanto, (t, a) es un par inestable de S, lo que contradice que S es estable. ∎
Idea clave. Entre todos los resultados estables, Gale-Shapley da el mejor posible para todos los que proponen a la vez, y el peor posible para todos los que reciben. El reparto es estable en los dos casos, pero no es neutral. Elegir quién propone es una decisión de diseño, con ganadores y perdedores.
test_examples.cpp no se fía de nuestra palabra: para n de 1 a 6, con 400 instancias al azar de cada
tamaño, enumera todos los matchings posibles, y comprueba que el resultado es estable, que ningún
tesista tiene algo mejor en otro matching estable, que ningún asesor tiene algo peor, que el resultado es
el mismo con un orden al azar, y que el número de propuestas no pasa de n² − n + 1. Eso no reemplaza a las
demostraciones. Es lo que nos dice que las escribimos sobre el algoritmo correcto.
Implementación: O(n²) con una tabla de rangos
El algoritmo hace a lo sumo n² propuestas. Si cada propuesta costara O(1), el total sería O(n²). Es lo mejor a lo que se puede aspirar en este formato, porque la entrada misma tiene 2n² números. Casi todo cuesta O(1) sin hacer nada especial:
- Sacar un tesista libre: una pila, con
std::vector. O(1). - El siguiente de su lista:
pref_t[t][siguiente[t]]. O(1). - Saber quién tiene a a:
pareja[a]. O(1).
Solo queda una línea: “a prefiere a t antes que a pareja[a]”. La lista de a tiene a los tesistas en orden. Para saber cuál de dos aparece primero, la primera idea es recorrerla:
inline Matching gale_shapley_scan(const Preferences& proposer_prefs, const Preferences& receiver_prefs,
                                  long long& steps) {
    auto prefers = [&](int r, int a, int b) {
        for (int candidate : receiver_prefs[r]) {
            steps++;
            if (candidate == a) return true;
            if (candidate == b) return false;
        }
        return false;
    };
    return propose_until_stable(proposer_prefs, prefers, [](int, int, int, bool) {});
}
Ese recorrido cuesta O(n). Con n² propuestas, el total es O(n³). Se arregla preparando de antemano la pregunta inversa: dada una persona, ¿en qué posición de la lista está? Es una tabla de rangos: rango[a][t] es la posición de t en la lista de a. Se llena en una pasada por cada lista:
inline std::vector<std::vector<int>> rank_table(const Preferences& prefs) {
    int n = static_cast<int>(prefs.size());
    std::vector<std::vector<int>> rank(n, std::vector<int>(n));
    for (int r = 0; r < n; r++) {
        for (int position = 0; position < n; position++) {
            rank[r][prefs[r][position]] = position;
        }
    }
    return rank;
}
Con esto, construir la tabla cuesta O(n²) una sola vez, y comparar es mirar dos números: O(1). Por ejemplo, la lista de a0 es t0, t3, t2, t1, y su fila en la tabla es:
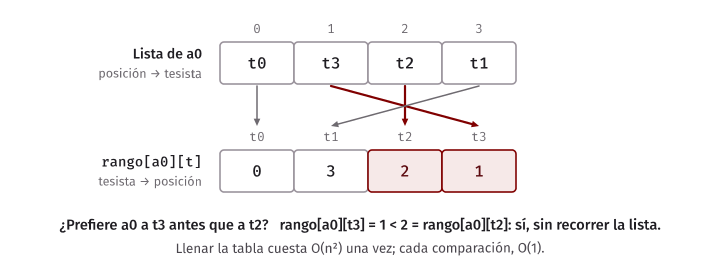
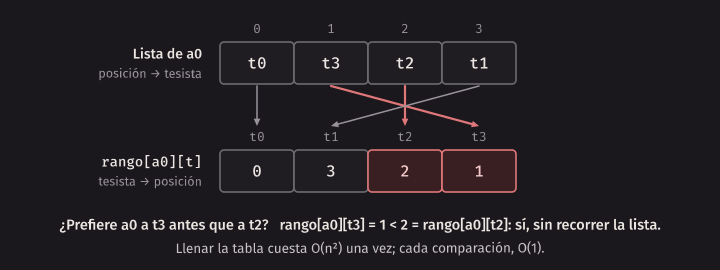
El ciclo principal es el del pseudocódigo. Se llama propose_until_stable porque se comparte entre las
dos versiones. Recibe la comparación como parámetro, y también una función que se llama después de cada
propuesta, que usa trace_gale_shapley:
template <typename Prefers, typename OnProposal>
Matching propose_until_stable(const Preferences& proposer_prefs, Prefers prefers, OnProposal on_proposal) {
    int n = static_cast<int>(proposer_prefs.size());
    std::vector<int> next_choice(n, 0);
    std::vector<int> holder(n, -1);  // holder[r]: a quién tiene r por ahora, o -1
    std::vector<int> free_proposers;
    for (int p = n - 1; p >= 0; p--) {
        free_proposers.push_back(p);
    }
    long long proposals = 0;
    while (!free_proposers.empty()) {
        int p = free_proposers.back();
        free_proposers.pop_back();
        int r = proposer_prefs[p][next_choice[p]];
        next_choice[p]++;
        proposals++;
        int held = holder[r];
        if (held == -1) {
            holder[r] = p;
        } else if (prefers(r, p, held)) {
            holder[r] = p;
            free_proposers.push_back(held);
        } else {
            free_proposers.push_back(p);
        }
        on_proposal(p, r, held, holder[r] == p);
    }
    Matching result;
    result.partner.assign(n, -1);
    for (int r = 0; r < n; r++) {
        result.partner[holder[r]] = r;
    }
    result.proposals = proposals;
    return result;
}
Y la versión con tabla es una llamada, con la comparación en O(1):
inline Matching gale_shapley(const Preferences& proposer_prefs, const Preferences& receiver_prefs) {
    std::vector<std::vector<int>> rank = rank_table(receiver_prefs);
    return propose_until_stable(
        proposer_prefs,
        [&](int r, int a, int b) { return rank[r][a] < rank[r][b]; },
        [](int, int, int, bool) {});
}
En el código, los dos lados se llaman proposer y receiver y no tesista y asesor, porque la misma
función sirve con cualquiera de los dos lados proponiendo: who_proposes.cpp la llama con los argumentos
intercambiados.
Medir el error
Error común. Comparar preferencias recorriendo una lista. El programa da las mismas respuestas, pasa todos los casos pequeños, y convierte el algoritmo en O(n³).
¿De verdad se nota? Para medirlo hay que tener cuidado, porque la cota O(n³) habla del peor caso, y una
instancia al azar no se le parece. Primero contemos, porque contar no depende de la máquina. rank_counts
corre la versión con recorrido sobre dos familias, y cuenta las propuestas y las casillas de lista que
miró. En la familia adversa, todos los proponentes tienen la misma lista, y todos los receptores
prefieren al último que llega. En la familia al azar, todas las listas son permutaciones al azar:
$ build/rank_counts
instancia      n  propuestas  casillas
adversa       250      31375       5177125
adversa       500     125250      41541750
adversa      1000     500500     332833500
adversa      2000    2001000    2664667000
al azar       250       1392         64948
al azar       500       3523        310004
al azar      1000       9150       1391767
al azar      2000      15845       5086685
Miren las dos familias por separado.
En la adversa, las propuestas son exactamente n(n + 1)/2, y las casillas se multiplican por algo cercano a 8 cada vez que n se duplica: 2 664 667 000 / 332 833 500 ≈ 8,0. Es lo que hace un costo cúbico. Son unas n³/3 casillas. Es decir, en esta familia, que la versión con recorrido sea cúbica no es solo una cota: ocurre.
En las instancias al azar, en cambio, hay muy pocas propuestas: con n = 2000, unas 16 mil de los 4 millones posibles. Y las casillas son 5 millones, más de 500 veces menos que en la adversa. Un programa con recorrido, probado solo con instancias al azar, parecería bien. Es la misma lección de la primera sección: las pruebas al azar pueden no acercarse jamás al caso difícil. Por eso, los casos grandes del juez se construyen a propósito.
Ahora el reloj, con make bench. Compila con -O2 y sin sanitizers, y usa la familia adversa. La tabla
da la mediana de varias corridas (5 con tabla, 3 con recorrido), tomando solo el cálculo de Gale-Shapley y
no la creación de las listas. Los tiempos dependen de la máquina y de lo que esté corriendo a la vez.
Estos son de una corrida dentro del contenedor del curso:
$ build/rank_bench
    n   tabla (s)  razón  ns/propuesta   lista (s)  razón  ns/casilla  lista/tabla
  500      0.0031      -          25.0      0.0283      -        0.68            9
 1000      0.0152    4.9          30.4      0.2336    8.3        0.70           15
 2000      0.1014    6.7          50.7      1.2885    5.5        0.48           13
 4000      0.4745    4.7          59.3     11.3885    8.8        0.53           24
Las razones de una fila a la otra saltan porque la máquina estaba ocupada con otros procesos: una sola razón no dice mucho, y conviene mirar el salto completo. De n = 500 a n = 4000, n se multiplica por 8.
Con recorrido, el tiempo se multiplica por unas 400 (11,39 / 0,0283). Un costo cúbico predice 8³ =
512, y estamos en ese orden. La columna ns/casilla se mantiene en menos de un nanosegundo: el tiempo
sigue a las casillas, que sí crecen como n³.
Con tabla, el tiempo se multiplica por unas 150 (0,4745 / 0,0031), y no por las 64 que predice n². El
conteo de propuestas sí se multiplicó casi exactamente por 64 (8 002 000 / 125 250 ≈ 63,9). Lo que creció
es lo que cuesta cada propuesta: ns/propuesta pasa de 25 a 59. Una causa probable es la memoria: con n =
4000 la tabla ocupa unos 64 MB, y cada propuesta salta a la fila de otro receptor, mientras que un
recorrido lee casillas seguidas. Esta medición no lo comprueba: el reloj no ve fallos de cache. Lo que sí
se puede decir es que O(n²) cuenta operaciones, y no dice cuánto cuesta cada una.
Con n = 4000, la versión con recorrido tardó unas 24 veces más. En esta corrida la columna lista/tabla
pasó de 9 a 24, sin subir en cada fila, porque la máquina estaba cargada. Con un recorrido, el costo por
comparación crece con el tamaño de la lista, y por eso los casos grandes del laboratorio no pasan.
Idea clave. La tabla de rangos cambia memoria por tiempo: gasta O(n²) enteros adicionales, una sola vez, para no recorrer nunca. Es la misma idea de toda estructura de datos: preparar los datos de acuerdo con la pregunta que se va a hacer muchas veces.
Variante con cupos
Hasta ahora, un asesor con un tesista. En el problema real, una carrera tiene muchas vacantes, y hay muchos más postulantes que carreras. Ya en su artículo de 1962, Gale y Shapley hablaban de admisión a universidades.
El problema. Hay A postulantes y C carreras, y cada carrera c tiene v[c] vacantes. Cada postulante ordena todas las carreras, y cada carrera ordena a todos los postulantes. Una asignación le da a cada postulante una carrera o ninguna, sin pasarse de las vacantes. Quedarse sin carrera es lo peor para cualquiera. Un postulante p y una carrera c forman un par inestable si p no está en c, p preferiría estar en c antes que como está, y además c tiene una vacante libre o prefiere a p antes que a alguno de sus admitidos.
Hay una diferencia importante con el caso uno a uno: la asignación no tiene por qué incluir a todos, porque las vacantes pueden no alcanzar. Y una carrera puede quedar con vacantes libres si los postulantes no alcanzan. Ya no se pide un matching perfecto.
El algoritmo es el mismo con dos cambios:
algoritmo gale_shapley_con_cupos(pref_p, pref_c, v, A, C)
    para p desde 0 hasta A - 1 hacer
        siguiente[p] ← 0
    fin para
    para c desde 0 hasta C - 1 hacer
        admitidos[c] ← vacío
    fin para
    libres ← todos los postulantes
    mientras libres no esté vacío hacer
        p ← sacar un postulante cualquiera de libres
        si siguiente[p] < C entonces
            c ← pref_p[p][siguiente[p]]
            siguiente[p] ← siguiente[p] + 1
            agregar p a admitidos[c]
            si c tiene más de v[c] admitidos entonces
                q ← el admitido de c que c prefiere menos
                sacar q de admitidos[c]
                agregar q a libres
            fin si
        fin si
    fin mientras
    devolver admitidos
fin algoritmo
Lo primero: un postulante puede quedarse sin opciones, y entonces simplemente sale de libres. Lo
segundo: la carrera compara al que llega contra el peor de sus admitidos. Esto cubre también v[c] = 0:
la carrera admite y saca en el mismo paso.
Teorema 6. El algoritmo con cupos termina después de a lo sumo A · C propuestas, y su resultado es una asignación estable.
Demostración de terminación. Cada vuelta hace una de dos cosas. Si siguiente[p] < C, hace una
propuesta, y como siguiente[p] solo aumenta, hay a lo sumo A · C de estas vueltas. Si siguiente[p] =
C, saca a p de libres, y p no vuelve nunca, porque solo se agrega a libres a quien estaba admitido y p
no lo está. Hay a lo sumo A de estas vueltas.
Demostración de que es asignación. Después de cada vuelta, ninguna carrera tiene más de v[c] admitidos, y cada postulante está en a lo sumo una carrera.
Observación (las carreras solo mejoran). Desde que una carrera se llena, sigue llena para siempre, y el peor de sus admitidos solo mejora. La razón: solo se saca a alguien cuando hay v[c] + 1 admitidos, así que siempre quedan v[c], y al sacar al peor de v[c] + 1, el peor que queda es igual o mejor que el anterior. También: una carrera que rechaza a alguien está llena, y todos sus admitidos en ese momento le gustan más que el rechazado.
Demostración de estabilidad, por contradicción. Supongamos que p y c forman un par inestable al final. p prefiere c antes que como está, ya sea con otra carrera que le gusta menos o sin carrera. En cualquiera de los dos casos, p ya le propuso a c, porque propone en orden y llegó más abajo o agotó la lista. Como p no está en c, c lo sacó en algún momento. En ese momento, c estaba llena, y todos sus admitidos le gustaban más que p. Por la observación, sigue llena hasta el final, y todos sus admitidos finales le gustan más que p. Entonces c no tiene vacante libre, y no prefiere a p antes que a ningún admitido. Contradicción. ∎
El Teorema 4 también se traslada, con el mismo argumento del “primer rechazo”: cada postulante recibe la mejor carrera que puede recibir en alguna asignación estable, y el resultado no depende del orden (ejercicio 9). Y tiene un corolario práctico: si los postulantes proponen, la asignación es la mejor para ellos; si proponen las carreras, es la mejor para las carreras. El laboratorio les pide calcular la primera, y pensar qué cambia con la segunda.
¿Cuánto cuesta? Con una tabla de rangos por carrera, comparar es O(1). Pero ahora hay que responder muchas veces “¿quién es el peor de los admitidos de c?”, y recorrer a los admitidos sería el mismo error de antes. Ya conocen una estructura para responder eso y para reemplazarlo: una cola de prioridad por carrera, donde cada operación cuesta O(log A). El total es O(A · C · log A) en el peor caso, y la lectura y la tabla son O(A · C).
Error común. Reparar solo el recorrido de la lista y no el de los admitidos, o al revés. Las dos preguntas (“¿quién de estos dos?” y “¿quién es el peor?”) aparecen en cada propuesta rechazada, y cualquiera de las dos, hecha con un recorrido, basta para que el caso grande no pase.
Para qué sirve en el mundo real
Dos usos, sin entrar en más detalles que los que podemos afirmar con seguridad.
- Médicos residentes. En Estados Unidos, el programa nacional de asignación de residencias médicas (National Resident Matching Program) asigna a los médicos recién egresados a hospitales con un algoritmo de esta familia, en el que proponen los postulantes. El problema real tiene complicaciones que no vimos: por ejemplo, las parejas de médicos que quieren quedar en la misma ciudad. Con esas parejas, puede no existir ningún matching estable, y el sistema real no es Gale-Shapley sin cambios.
- Escuelas. Algunos sistemas escolares públicos, como los de Nueva York y Boston, rediseñaron su asignación de estudiantes a colegios usando aceptación diferida, con la participación de economistas que trabajan en estos temas. Las escuelas tienen cupos, igual que nuestra variante.
Por el trabajo en esta línea, Alvin Roth y Lloyd Shapley recibieron el premio Nobel de Economía de 2012.
En la práctica. Un algoritmo así no se elige solo por su costo. Se elige porque tiene una propiedad demostrada: que el resultado es estable, y quién es el favorecido. Cuando la decisión afecta a miles de personas, poder decir por qué nadie tiene un reclamo vale más que correr en un segundo. Hay otra propiedad importante, que no demostramos aquí: a quien propone no le conviene mentir sobre sus preferencias.
El código de la semana y make test
| Archivo | Qué contiene |
|---|---|
search.h |
La búsqueda binaria, su versión con la invariante en assert, y las dos versiones equivocadas |
power.h |
La potencia rápida, con su contador de productos |
matching.h |
Gale-Shapley con tabla y con recorrido, buscar pares inestables, enumerar los matchings estables, las ideas que fallan |
instances.h |
Las instancias de este capítulo, y las dos familias que se midieron |
tests_vs_proof.cpp |
El máximo equivocado que pasa 1000 pruebas |
trace_search.cpp, bad_searches.cpp, trace_power.cpp |
Las corridas de la Sesión A |
trace_gale_shapley.cpp, first_offer.cpp, repair_loop.cpp, who_proposes.cpp |
Las corridas de la Sesión B |
rank_counts.cpp, rank_bench.cpp |
Conteos y medición, tabla de rangos contra recorrido |
test_examples.cpp |
Las pruebas de lo que afirman estos apuntes |
test_notes.py |
Vuelve a correr los comandos de los apuntes y compara las salidas |
make compila; make test lo comprueba. Los ejemplos se compilan con
-Wall -Wextra -std=c++20 -g -fsanitize=address,undefined, así que una lectura fuera de un arreglo
también haría fallar la prueba. rank_counts y rank_bench usan -O2 y no llevan sanitizers.
make bench corre la medición aparte, porque los tiempos no se comparan contra nada.
$ build/test_examples
test_examples: todo correcto
test_examples.cpp no es una demostración, y conviene decirlo otra vez. Lo que hace es comprobar lo
demostrado contra lo escrito: con enumeración completa hasta n = 6, si alguna afirmación de este capítulo
fuera falsa o estuviera mal programada, casi seguro aparecería.
El laboratorio
El laboratorio tiene dos partes, en code/week-01/lab/. Esta es la primera vez que usan el juez, así que
se detalla cómo funciona.
El juez
Cada problema vive en su propia carpeta, con un enunciado README.md, un archivo solution.cpp y una
carpeta casos/:
make            # compila
make test       # corre el juez con todos los casos
El juez corre su programa con la entrada de cada caso y compara la salida, palabra por palabra, con la esperada. Espacios y saltos de línea de más no importan. Imprime una línea por caso:
| Veredicto | Qué significa | Qué revisar |
|---|---|---|
AC |
Respuesta correcta | Nada |
WA |
Respuesta incorrecta | Copiar el caso y correrlo a mano: ./build/solution < casos/03.in |
TLE |
Se pasó del límite de tiempo | Calcular el costo de su algoritmo con el tamaño de ese caso |
RE |
El programa terminó con error | Compilar con sanitizers para ver dónde |
Un programa de laboratorio lee de la entrada estándar y escribe en la salida estándar, sin mensajes como
“Ingrese un número”, porque el juez los tomaría como parte de la respuesta. Algunas entradas son enormes:
casos/gen_NN.cpp genera esa entrada, siempre igual, en vez de guardarla en un archivo.
Calentamiento: lab/warmup
Primero abran el entorno y corran env/check.sh: todas las líneas deben decir ok. Después, en
lab/warmup hay un programa ya escrito para un problema simple, y tiene un bug. Su trabajo es correr el
juez, leer el veredicto y corregirlo:
$ make test
01           AC     0.00 s
02           WA     0.00 s  palabra 2: esperaba 1, salió 0
03           WA     0.00 s  palabra 2: esperaba 5, salió 4
04           AC     0.00 s
05           WA     0.00 s  palabra 1: esperaba 3, salió 2
06           WA     0.02 s  palabra 32401: esperaba 200000, salió 199999
2/6 casos correctos
Miren lo que dice cada línea: qué caso falló y qué palabra de la salida es distinta. El caso 01 es el ejemplo del enunciado, y pasa. Esto no es raro: un programa puede dar bien el ejemplo y estar mal.
El problema: lab/admissions
Con postulantes que ordenan carreras y carreras con vacantes que ordenan postulantes, hay que calcular la asignación estable que más favorece a los postulantes. Lean primero el enunciado, y escríbanlo con pseudocódigo antes de abrir el editor. Luego:
- Háganlo funcionar con los casos pequeños. Comprueben a mano el ejemplo del enunciado.
- Háganlo pasar en todos los casos, incluidos los grandes. Sus entradas tienen millones de números, y ahí
un recorrido por cada comparación no alcanza. Si les da
TLE, calculen cuántas operaciones hace su programa con ese tamaño. - Respondan la pregunta del final del enunciado: ¿quién gana y quién pierde cuando proponen las carreras? Es una pregunta para responder con una demostración o con una ejecución, no con una opinión.
Resumen
- Un problema define entradas válidas y salidas aceptadas. Una instancia es una entrada concreta. Un algoritmo es correcto si termina y da una salida aceptada en toda instancia.
- Una prueba puede mostrar un error, pero no su ausencia. La demostración dice que el algoritmo está bien, y las pruebas dicen que lo escribimos bien.
- Una invariante de ciclo se demuestra en tres pasos: inicio, conservación y salida. Debe alcanzar para concluir el resultado al salir: una invariante verdadera pero débil no demuestra nada.
- La búsqueda binaria con rango semiabierto [lo, hi) tiene esta invariante: todo a la izquierda de lo es menor que x, y todo desde hi en adelante es mayor o igual. Al salir, lo = hi es el primer índice con a[i] ≥ x.
- Una función recursiva se demuestra por inducción sobre el tamaño de su entrada. La potencia rápida hace O(log e) productos.
- La terminación se demuestra con una cantidad entera que nunca es negativa y baja en cada paso. Debe bajar en todos los pasos.
- Un matching estable es un matching perfecto sin pares inestables. Un par inestable son dos personas que se prefieren antes que a sus parejas.
- Gale-Shapley: un lado propone en el orden de su lista, y el otro se queda con la mejor oferta hasta ahora. Hace a lo sumo n² propuestas, porque cada persona propone a cada opción como máximo una vez.
- Su resultado es perfecto y estable, por dos hechos: los que reciben solo mejoran, y los que proponen solo bajan.
- Cada uno de los que propone queda con su mejor pareja viable, y cada uno de los que recibe con su peor pareja viable. El resultado no depende del orden. Quién propone importa.
- Con una tabla de rangos, comparar preferencias es O(1) y el total es O(n²). Recorriendo la lista, el total sube a O(n³), lo que se ve en la medición adversa y no en instancias al azar.
- La variante con cupos no da un matching perfecto, y necesita saber quién es el peor admitido de cada carrera. Su demostración de estabilidad es igual, porque desde que una carrera se llena, sigue llena y solo mejora.
Ejercicios
- Escriban la invariante de un ciclo que calcula el máximo de un arreglo no vacío, empezando con
best= a[0]. Demuestren los tres pasos y la terminación. ¿En qué paso falla la misma demostración paramaximum_wrong? - ¿Por qué pasar 1000 pruebas no demuestra que un algoritmo es correcto? Cambien el generador de
tests_vs_proof.cpppara que encuentre el bug sin agregar el arreglo a mano. ¿Qué tuvieron que saber sobre el bug para hacerlo? - Escriban, con rango semiabierto, una búsqueda binaria que devuelva el primer índice con a[i] > x.
Escriban su invariante, demuestren los tres pasos y la terminación. Úsenla junto con
first_at_leastpara contar en O(log n) cuántas veces aparece x en un arreglo ordenado. - Esta versión de la búsqueda usa el rango cerrado [lo, hi]: empieza con hi = n − 1, cicla con
mientras lo ≤ hi, y actualiza con lo ← mid + 1 o hi ← mid − 1. Escriban su invariante, y digan en qué valores queda el rango al salir. ¿Qué pasa si n = 0 y los índices no tienen signo? - El algoritmo de Euclides es mcd(x, y) = x si y = 0, y mcd(x, y) = mcd(y, x mod y) si no. Demuestren por
inducción que devuelve el máximo común divisor de x e y, para x, y ≥ 0 sin ser los dos cero. ¿Qué
cantidad baja en cada llamada? Luego escriban una potencia rápida iterativa, con la invariante
resultado · baseᵉ ≡ b elevado a e₀ (mod m), donde e₀ es el exponente inicial. Pruébenla contrapower_mod. - Sigan a mano Gale-Shapley en la instancia t0: a0, a1, a2; t1: a0, a2, a1; t2: a1, a0, a2; a0: t2, t0,
t1; a1: t0, t2, t1; a2: t0, t1, t2. Hagan la tabla de propuestas. Luego hagan proponer a los asesores.
¿Dan lo mismo? Compruébenlo agregando la instancia a
who_proposes.cpp. - Expliquen en dos líneas por qué Gale-Shapley hace a lo sumo n² propuestas. Después demuestren algo más
fino: hace a lo sumo n² − n + 1. Ayuda: el algoritmo termina en cuanto todos los asesores recibieron
alguna propuesta. ¿Cuántas recibe el último asesor que recibe su primera propuesta?
test_examples.cppya comprueba esta cota en instancias al azar. ¿Por qué eso no la demuestra? - Demuestren, sin mirar los apuntes, que al terminar Gale-Shapley no queda ningún par inestable. Después repitan la demostración de que el resultado es perfecto. ¿Qué parte de cada una deja de valer si un asesor puede cambiar de pareja por alguien que prefiere menos? ¿Y si los dos grupos tienen distinto tamaño?
- Adapten el Teorema 4 a la variante con cupos: el “primer rechazo” ocurre cuando c está llena con v[c] admitidos que prefiere antes que p, y hay una asignación estable S con p en c. Muestren que alguno de esos admitidos, llamémosle q, no está en c en S, y que q y c forman un par inestable de S.
- En el problema de los compañeros de cuarto, 4 personas se reparten en dos cuartos dobles, y cada una ordena a las otras tres. Encuentren listas para las que ningún reparto es estable. Ayuda: tres de las personas se prefieren en ciclo, y la cuarta es la última opción de todas. ¿Qué paso de nuestras demostraciones no tiene sentido aquí?
- Programa. Cambien la pila de
free_proposerspor una cola (std::queue), y corran las dos versiones sobrerank_counts. ¿Cambia el resultado? ¿Cambia el número de propuestas? ¿Cambia el número de casillas? Expliquen con los teoremas de este capítulo lo que no cambia, y con el orden de las comparaciones lo que sí. - Programa. Escriban una función que reciba un matching y unas listas, y responda si es estable, en
O(n²).
find_unstable_pairlo hace con la tabla de rangos: ¿qué costo tendría sin ella? Y corranbuild/rank_benchtres veces en su propia máquina. ¿Se mantiene la razón de la columnalista? Si no, digan qué más pudo influir.