Apuntes · Capítulo 2Demostrar y dividir
Recurrencias y mergesort
Recurrencias y mergesort
La semana pasada demostramos algoritmos: un ciclo con una invariante, una función recursiva con inducción y Gale-Shapley con un argumento por contradicción. En todos esos casos la pregunta principal era si el algoritmo da la respuesta correcta. Hoy agregamos la segunda pregunta de todo análisis, ahora para funciones recursivas: ¿cuánto cuesta?
Con un ciclo, el costo se lee casi directo: se cuentan las vueltas. Con una función que se llama a sí misma, el costo de una llamada depende del costo de otras llamadas, y lo que se escribe naturalmente es una ecuación donde la incógnita aparece a los dos lados. Esa ecuación es una recurrencia (recurrence). En Estructuras de Datos ya vieron la idea con el árbol de llamadas de mergesort: log n niveles con n de trabajo cada uno. Aquí la volvemos un método que sirve para cualquier algoritmo de este tipo, con un teorema que resuelve los casos comunes, y con una manera de darse cuenta cuándo ese teorema no aplica.
En la segunda parte del capítulo volvemos a mergesort, que ya conocen, pero ahora para demostrarlo. Y lo extendemos: con unas pocas líneas más, la misma mezcla cuenta cuántos pares de un arreglo están en el orden contrario, sin mirarlos uno por uno. Ese número mide cuánto se parecen dos rankings, y es el problema del laboratorio.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, El patrón de divide y vencerás, Del código a la recurrencia e Inversiones. Con eso llegan sabiendo escribir la recurrencia de un programa y qué se cuenta en la Sesión B.
En clase: Sesión A, de Del código a la recurrencia a El costo de copiar. Sesión B, Mergesort, ahora demostrado, Inversiones y Contar inversiones con divide y vencerás.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, secs. 1.6 (The Pattern) y 1.7 (Recursion Trees); CLRS, capítulo Divide-and-Conquer, 4.ª edición. Sesión B: Erickson, sec. 1.4 (Mergesort); CLRS, capítulo Getting Started, 4.ª edición. Son apoyo: este capítulo se puede estudiar solo.
Código. Los programas de este capítulo están en
code/week-02. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Las mediciones se corren conmake bench, compiladas con-O2y sin sanitizers.
En todo el capítulo, log es logaritmo en base 2 salvo que se diga otra cosa.
El patrón de divide y vencerás
Divide y vencerás (divide and conquer) es una forma de diseñar algoritmos con tres pasos:
- Dividir. Partir la entrada en subproblemas del mismo tipo, más pequeños.
- Resolver. Resolver cada subproblema con una llamada recursiva. Si la entrada es muy pequeña, se resuelve directamente: ese es el caso base.
- Combinar. Armar la respuesta de la entrada completa con las respuestas de las partes.
Mergesort es el ejemplo clásico. Dividir no cuesta casi nada, porque solo se calcula la mitad. Combinar es la mezcla, y ahí está todo el trabajo. Búsqueda binaria también tiene esta forma, con un solo subproblema y sin nada que combinar. Quicksort, que verán de nuevo en la semana 4, hace lo contrario de mergesort: el trabajo está al dividir y combinar es gratis.
La correctitud de un algoritmo así casi siempre se demuestra con inducción sobre el tamaño, como en la semana pasada: se supone que las llamadas recursivas resuelven bien sus partes, y se demuestra que el paso de combinar arma bien el todo. Lo que falta es calcular el costo.
Del código a la recurrencia
Una recurrencia da el costo de un algoritmo en función de su costo en entradas más pequeñas. La mayoría de los algoritmos de divide y vencerás dan una recurrencia de esta forma:
T(n) = a · T(n/b) + f(n)Cada símbolo se lee directamente en el código:
| Símbolo | Qué significa | Dónde se ve |
|---|---|---|
| a | Cuántas llamadas recursivas hace una ejecución | Se cuentan las llamadas que de verdad ocurren |
| n/b | De qué tamaño es cada subproblema | El argumento de la llamada |
| f(n) | Todo el trabajo fuera de las llamadas | Ciclos, copias, dividir y combinar |
| T(1) | El costo del caso base | Una constante, salvo que se diga otra cosa |
Veamos tres funciones que no hacen nada útil. Solo suman 1 por cada unidad de trabajo. Están en from_code.h, y las
pruebas comprueban que el conteo coincide con la recurrencia:
void two_calls_linear(int n, long long& work) {
    if (n <= 1) {
        work++;
        return;
    }
    for (int i = 0; i < n; i++) {
        work++;
    }
    two_calls_linear(n / 2, work);
    two_calls_linear(n / 2, work);
}
Dos llamadas de tamaño n/2 y un ciclo de n vueltas: T(n) = 2 T(n/2) + n. Que el ciclo esté antes o después de las llamadas no cambia nada. Tampoco importa que sean líneas separadas o un ciclo: la segunda función de ese archivo hace
for (int call = 0; call < 3; call++) {
    three_calls_linear(n / 2, work);
}
y su recurrencia es T(n) = 3 T(n/2) + n, porque a cuenta llamadas, no líneas de código. La tercera tiene ocho llamadas y un ciclo doble: T(n) = 8 T(n/2) + n².
Dos ejemplos que ya conocen:
algoritmo buscar(a, ini, fin, x)
    si ini = fin entonces
        devolver -1
    fin si
    medio ← ini + (fin - ini) div 2
    si a[medio] = x entonces
        devolver medio
    sino si x < a[medio] entonces
        devolver buscar(a, ini, medio, x)
    sino
        devolver buscar(a, medio + 1, fin, x)
    fin si
fin algoritmo
Hay dos llamadas escritas, pero una sola se ejecuta en cada vuelta: a = 1. El tamaño baja a lo sumo a la mitad y lo demás es constante, así que T(n) ≤ T(n/2) + 1. Contar líneas en vez de ejecuciones daría a = 2, y una respuesta equivocada: Θ(n) en vez de Θ(log n).
En mergesort las dos llamadas sí se ejecutan, y la mezcla recorre todo el rango: T(n) = 2 T(n/2) + Θ(n).
Error común. Olvidar que f(n) es todo lo que se hace fuera de las llamadas. Eso incluye lo que no se ve en una línea: un
std::vectorpasado por valor, unsubstr, unstd::vectornuevo en cada llamada. Más adelante le dedicamos una sección, porque cambia la respuesta.
Pisos y techos
Si n es impar, n/2 no es un entero. La recurrencia real de mergesort es:
T(n) = T(⌊n/2⌋) + T(⌈n/2⌉) + n, T(1) = 1Lo habitual es escribir T(n/2) y resolverla solo cuando n es una potencia de 2, donde todas las divisiones son exactas. ¿Se pierde algo? En las recurrencias de este curso, no, y en este caso se puede demostrar en pocas líneas.
Afirmación. Si para n = 2ᵏ se tiene T(n) = n log n + n, entonces T(n) = Θ(n log n) para todo n. Técnica: T es creciente, así que cualquier n queda encerrado entre dos potencias de 2.
Primero, T no baja: T(n) ≤ T(n + 1). Se demuestra por inducción fuerte, porque ⌊n/2⌋ y ⌈n/2⌉ no bajan al pasar de n a n + 1, y el término n sí sube. Ahora tomemos k = ⌊log n⌋, de modo que 2ᵏ ≤ n < 2ᵏ⁺¹. Entonces:
- Cota inferior. T(n) ≥ T(2ᵏ) = (k + 1) · 2ᵏ. Como k + 1 > log n y 2ᵏ > n/2, resulta T(n) ≥ (n/2) log n.
- Cota superior. T(n) ≤ T(2ᵏ⁺¹) = (k + 2) · 2ᵏ⁺¹. Como k ≤ log n y 2ᵏ⁺¹ ≤ 2n, resulta T(n) ≤ 2n (log n + 2).
Las dos cotas son Θ(n log n). Lo mismo vale, con más trabajo, para los pisos y techos del teorema maestro. Ese detalle técnico está en CLRS, y aquí lo usamos sin demostrar.
Idea clave. Resuelvan la recurrencia en las potencias de b, que es donde sale limpia. Los pisos y los techos no cambian la Θ en ninguna recurrencia de este curso.
El árbol de recursión
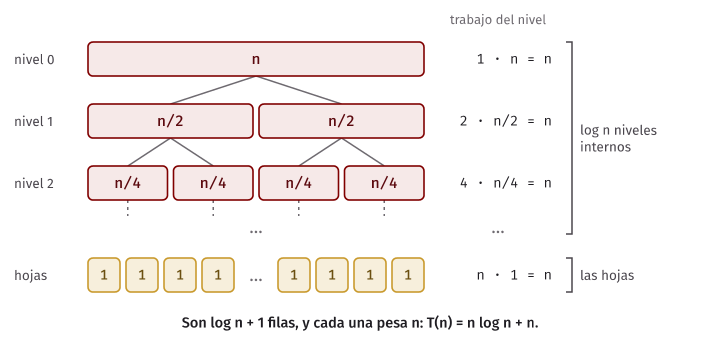
Un árbol de recursión (recursion tree) dibuja las llamadas de un algoritmo. Cada nodo es una llamada, y dentro se anota solo el trabajo de esa llamada, sin contar a sus hijas. Sumar todo el árbol da T(n). Conviene sumar por niveles.
Este es el árbol de T(n) = 2 T(n/2) + n:
En general, con T(n) = a T(n/b) + f(n) y n = bᵏ:
- El nivel i tiene aⁱ nodos, cada uno con un subproblema de tamaño n/bⁱ.
- Por lo tanto, el nivel i hace aⁱ · f(n/bⁱ) de trabajo.
- Hay k = log_b n niveles internos, i = 0, …, k − 1, y abajo las hojas.
- El número de hojas es aᵏ = a^(log_b n) = n^(log_b a). La última igualdad se comprueba tomando log_b a los dos lados: los dos dan (log_b a)(log_b n).
Sumando, se obtiene una fórmula exacta que vale para toda recurrencia de este tipo cuando n es una potencia de b:
T(n) = Σ (de i = 0 a k - 1) aⁱ · f(n/bⁱ) + n^(log_b a) · T(1)Todo lo que sigue es estudiar esa suma. El exponente log_b a aparece tanto que le damos un nombre: en este capítulo c = log_b a. Es la velocidad a la que crece el número de hojas.
Quién manda
Este programa imprime el trabajo de cada nivel para n = 16, con T(1) = 1:
$ build/recursion_tree
8 T(n/2) + n^2, n = 16
  nivel 0   256.00
  nivel 1   512.00
  nivel 2  1024.00
  nivel 3  2048.00
  hojas    4096.00
  total    7936.00

2 T(n/2) + n, n = 16
  nivel 0    16.00
  nivel 1    16.00
  nivel 2    16.00
  nivel 3    16.00
  hojas      16.00
  total      80.00

2 T(n/2) + n^2, n = 16
  nivel 0   256.00
  nivel 1   128.00
  nivel 2    64.00
  nivel 3    32.00
  hojas      16.00
  total     496.00

2 T(n/2) + n log n, n = 16
  nivel 0    64.00
  nivel 1    48.00
  nivel 2    32.00
  nivel 3    16.00
  hojas      16.00
  total     176.00

2 T(n/2) + n / log n, n = 16
  nivel 0     4.00
  nivel 1     5.33
  nivel 2     8.00
  nivel 3    16.00
  hojas      16.00
  total      49.33
Miren las tres primeras:
- 8 T(n/2) + n²: el trabajo se duplica en cada nivel. Es una serie geométrica que crece, y una serie así está dominada por su último término. Pesan más las hojas, y el total es del orden de las hojas: 8^(log n) = n³.
- 2 T(n/2) + n: todos los niveles pesan lo mismo. El total es lo que pesa un nivel, n, por el número de niveles, log n + 1. Da Θ(n log n).
- 2 T(n/2) + n²: el trabajo se reduce a la mitad en cada nivel. Es una serie geométrica que decrece, dominada por su primer término. Pesa más la raíz, y el total es del orden de la raíz: Θ(n²).
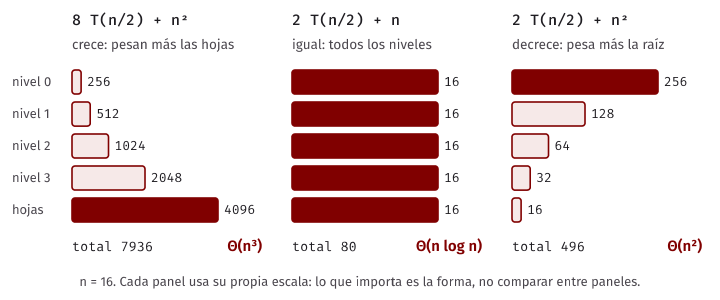
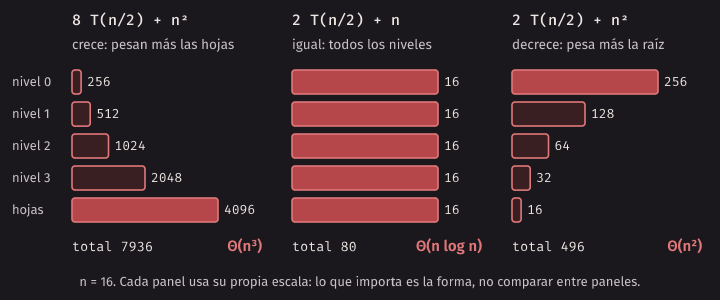
Estas son exactamente sus sumas, que las pruebas comprueban para n = 2ᵏ:
| Recurrencia, con T(1) = 1 | Forma cerrada | Θ |
|---|---|---|
| T(n) = 8 T(n/2) + n² | 2n³ − n² | n³ |
| T(n) = 3 T(n/2) + n | 3 · n^(log 3) − 2n | n^1,585 |
| T(n) = 2 T(n/2) + n | n log n + n | n log n |
| T(n) = T(n/2) + 1 | log n + 1 | log n |
| T(n) = 2 T(n/2) + n² | 2n² − n | n² |
Veamos cómo sale una. En T(n) = 8 T(n/2) + n², el nivel i pesa 8ⁱ (n/2ⁱ)² = n² · 2ⁱ. Los niveles i = 0, …, k − 1 suman n² (2ᵏ − 1) = n³ − n², y las hojas suman 8ᵏ = n³. El total es 2n³ − n².
Idea clave. Una recurrencia es una competencia entre dos fuerzas. El número de subproblemas se multiplica por a en cada nivel, y el trabajo de cada uno baja porque el tamaño se divide por b. Si gana a, mandan las hojas. Si gana la reducción, manda la raíz. Si empatan, cada nivel aporta lo mismo y aparece un factor log n.
Error común. Decir “son log n niveles, así que es n log n” sin mirar cuánto trabajo hay en cada nivel. Esa cuenta solo sirve si todos los niveles pesan lo mismo. En 8 T(n/2) + n² también hay log n niveles, y el costo es n³. Y el nivel de arriba pesa n², no n³: mirar solo la raíz también falla.
El teorema maestro
El teorema maestro (master theorem) convierte esa competencia en una regla. Hay varias versiones. Esta es la básica, de tres casos, y es la que usaremos.
Teorema. Sean a ≥ 1 y b > 1 constantes, f(n) ≥ 0 y T(n) = a T(n/b) + f(n), con T(n) = Θ(1) para n pequeño. Sea c = log_b a. Entonces:
- Pesan más las hojas. Si f(n) = O(n^(c−ε)) para alguna constante ε > 0, entonces T(n) = Θ(n^c).
- Todos los niveles por igual. Si f(n) = Θ(n^c), entonces T(n) = Θ(n^c · log n).
- Pesa más la raíz. Si f(n) = Ω(n^(c+ε)) para alguna constante ε > 0, y además existe una constante d < 1 tal que a · f(n/b) ≤ d · f(n) para todo n suficientemente grande, entonces T(n) = Θ(f(n)).
Esa última desigualdad se llama condición de regularidad (regularity condition). Dice que el nivel 1 pesa menos que el nivel 0, por un factor fijo. Más abajo vemos para qué está.
Lean con cuidado el caso 1 y el caso 3: f no tiene que ser solamente más chica o más grande que n^c. Tiene que serlo por un factor polinomial n^ε. Esa diferencia es la que deja afuera los dos ejemplos de la próxima sección.
Cómo se usa
Tres pasos: identificar a, b y f; calcular c = log_b a; comparar f con n^c. Practiquemos:
| Recurrencia | a, b | c | f(n) contra n^c | Caso | Solución |
|---|---|---|---|---|---|
| T(n) = 8 T(n/2) + n² | 8, 2 | 3 | n² = O(n^(3−1)) | 1 | Θ(n³) |
| T(n) = 3 T(n/2) + n | 3, 2 | 1,585 | n = O(n^(1,585−0,5)) | 1 | Θ(n^1,585) |
| T(n) = 2 T(n/2) + n | 2, 2 | 1 | n = Θ(n¹) | 2 | Θ(n log n) |
| T(n) = T(n/2) + 1 | 1, 2 | 0 | 1 = Θ(n⁰) | 2 | Θ(log n) |
| T(n) = 2 T(n/2) + n² | 2, 2 | 1 | n² = Ω(n^(1+1)) | 3 | Θ(n²) |
| T(n) = 2 T(n/4) + n | 2, 4 | 0,5 | n = Ω(n^(0,5+0,5)) | 3 | Θ(n) |
En los dos casos 3 hay que comprobar la regularidad. Para 2 T(n/2) + n²: 2 (n/2)² = n²/2, con d = 1/2. Para 2 T(n/4) + n: 2 (n/4) = n/2, también con d = 1/2.
El cuarto ejemplo merece una mirada. Con a = 1 no hay ramificación: el árbol es una cadena de log n nodos, cada uno con trabajo constante. Parece raro que entre en el caso 2, pero c = 0 y n⁰ = 1, así que f sí es Θ(n^c).
La regularidad
Cuando f es un polinomio, la condición de regularidad se cumple sola. Si f(n) = nᵖ con p > c, entonces
a · f(n/b) = a · nᵖ / bᵖ = (a / bᵖ) · f(n)y a/bᵖ < 1, porque p > log_b a equivale a bᵖ > a. Vale d = a/bᵖ. También se cumple para otras funciones suaves. Por ejemplo, para T(n) = 2 T(n/2) + n² log n: 2 (n/2)² log(n/2) ≤ (1/2) n² log n.
Entonces, ¿para qué sirve? Porque Ω es solo una cota por abajo, y permite una f que salta. Tomemos T(n) = 2 T(n/2) + f(n), en potencias de 2, con
f(2ᵏ) = 8ᵏ   si k es impar    (es decir, n³)
f(2ᵏ) = 4ᵏ   si k es par      (es decir, n²)
Se tiene f(n) ≥ n² para todo n, así que f(n) = Ω(n^(1+1)) y lo primero del caso 3 se cumple. Pero si k es par, el nivel 1 pesa 2 · f(n/2) = 2 (n/2)³ = n³/4, que es mucho más que la raíz, n². Entonces T(n) ≥ n³/4 mientras f(n) = n²: T(n) no es Θ(f(n)). La conclusión del caso 3 es falsa en esta recurrencia, y lo que falla es justo la regularidad: el nivel 1 no pesa menos que el nivel 0. Sin esa condición, el teorema sería falso.
Demostración, para potencias de b
Afirmación. Los tres casos del teorema, cuando n = bᵏ. Técnica: se acota la suma de los niveles del árbol en cada caso, comparándola con una serie geométrica. Partimos de la fórmula exacta:
T(n) = Σ (de i = 0 a k - 1) aⁱ · f(n/bⁱ) + Θ(n^c)Usaremos varias veces que a = b^c, de donde aⁱ / (bⁱ)^c = 1. Como las cotas O, Θ y Ω de f valen desde cierto n₀, los finitos valores de f con argumento menor se absorben agrandando la constante en las cotas superiores. Tengan en cuenta que estamos suponiendo T(1) > 0.
Caso 1. Existe una constante C con f(m) ≤ C · m^(c−ε) para todo m ≥ 1. Entonces el nivel i cumple:
aⁱ · f(n/bⁱ) ≤ C · aⁱ · n^(c−ε) / b^(i(c−ε)) = C · n^(c−ε) · (b^ε)ⁱEsto usa aⁱ / b^(ic) = 1, y queda b^(iε). La suma de los niveles es una serie geométrica de razón b^ε > 1, que está dominada por su último término:
Σ (de i = 0 a k - 1) (b^ε)ⁱ = (b^(εk) - 1) / (b^ε - 1) ≤ n^ε / (b^ε - 1)porque b^(εk) = (bᵏ)^ε = n^ε. Los niveles suman, entonces, O(n^(c−ε) · n^ε) = O(n^c). Las hojas también son Θ(n^c), y ellas solas ya dan la cota inferior. Por lo tanto, T(n) = Θ(n^c).
Caso 2. Hay constantes con C₁ m^c ≤ f(m) ≤ C₂ m^c para m ≥ n₀. Un nivel con n/bⁱ ≥ n₀ pesa:
aⁱ · f(n/bⁱ) = Θ(aⁱ · n^c / b^(ic)) = Θ(n^c)Hay k = log_b n niveles. Salvo un número constante cerca de las hojas, todos cumplen n/bⁱ ≥ n₀ y pesan Θ(n^c). Los que quedan pesan O(n^c), igual que las hojas. Por lo tanto, T(n) = Θ(n^c · log n).
Caso 3. Aplicando la regularidad i veces se obtiene aⁱ f(n/bⁱ) ≤ dⁱ f(n), mientras n/bⁱ⁻¹ sea al menos el n₀ desde el cual vale la condición. Partimos el árbol en dos pedazos:
- Los niveles de arriba, que cumplen esa desigualdad, suman a lo sumo f(n) · (1 + d + d² + …) = f(n) / (1 − d) = O(f(n)).
- Lo que queda abajo son subárboles con entrada menor que una constante, que cuestan O(1) cada uno. Hay a lo sumo O(aᵏ) = O(n^c) de ellos, y n^c = O(f(n)), porque f(n) = Ω(n^(c+ε)).
Por lo tanto, T(n) = O(f(n)). La raíz sola pesa f(n), lo que da T(n) = Ω(f(n)). ∎
Si n no es una potencia de b, se aplica lo mismo con pisos y techos, como vimos para mergesort. CLRS tiene los detalles.
Idea clave. No hace falta memorizar el teorema como tres fórmulas. Los tres casos son las tres formas de una serie: crece, se mantiene o decrece. Si se olvidan del enunciado, dibujen el árbol y sumen.
Cuándo no aplica
Antes de aplicar el teorema, revisen que la recurrencia tenga su forma. Estas no la tienen:
- Subproblemas de tamaños distintos. T(n) = T(n/5) + T(7n/10) + n aparece la próxima semana.
- Reducción por resta, no por división. T(n) = T(n − 1) + n. Es lo que pasa si mergesort partiera en 1 y n − 1. El árbol es una cadena de n nodos con trabajos n, n − 1, …, 1, y la suma da Θ(n²).
- Un número de llamadas que no es constante. T(n) = n · T(n/2) + 1: a depende de n.
- a < 1. No tiene sentido como cantidad de llamadas.
- Una f que depende de algo más que del tamaño del subproblema. Lo veremos con las copias.
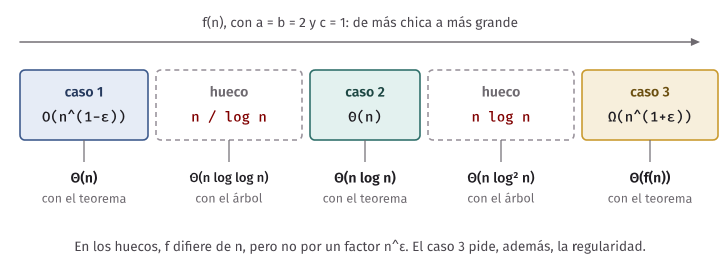
Y hay un caso más sutil: recurrencias que tienen justo la forma pedida, pero cuya f no cae en ninguno de los tres casos. Los tres no cubren todo, porque hay funciones entre un caso y otro. Veamos las dos más conocidas, ambas con a = b = 2, es decir, c = 1.
T(n) = 2 T(n/2) + n log n
¿Qué caso le toca? Comparemos f(n) = n log n con n^c = n:
- No es el caso 1: f es mayor que n.
- No es el caso 2: f(n)/n = log n crece sin límite, así que f no es Θ(n).
- No es el caso 3: f tendría que ser Ω(n^(1+ε)) para algún ε > 0. Pero f(n)/n^(1+ε) = log n / n^ε tiende a 0, para cualquier ε > 0. Cualquier potencia de n, por pequeña que sea, le gana a log n.
Es mayor que n, pero no por un factor polinomial: cae en el hueco entre los casos 2 y 3. El teorema de tres casos no dice nada.
El árbol, en cambio, no tiene ningún problema. Con n = 2ᵏ, el nivel i tiene 2ⁱ nodos de tamaño n/2ⁱ:
2ⁱ · (n/2ⁱ) · log(n/2ⁱ) = n · (k - i)La salida de arriba lo muestra con n = 16: 64, 48, 32, 16, es decir, 16 por 4, 3, 2, 1. Los niveles bajan, pero muy lento, porque no bajan por un factor fijo. Sumando:
T(n) = n · (k + (k - 1) + … + 1) + n = n · k(k + 1)/2 + n = Θ(n log² n)Comprobemos con n = 16: 16 · 4 · 5/2 + 16 = 176, que es lo que dio el programa.
Existe una versión más general del teorema que sí cubre este ejemplo. En la de CLRS, 4.ª edición, el caso 2 se amplía a f(n) = Θ(n^c · logᵐ n) con m ≥ 0, y da T(n) = Θ(n^c · logᵐ⁺¹ n). Con m = 1 sale Θ(n log² n), lo mismo que el árbol. Nosotros nos quedamos con la versión de tres casos, porque el árbol resuelve este caso y cualquier otro.
T(n) = 2 T(n/2) + n / log n
Ahora f(n) = n / log n, que es un poco menor que n. En n = 1 no está definida, porque log 1 = 0, así que la recurrencia solo vale para n ≥ 2, con T(1) = 1.
- No es el caso 1: f tendría que ser O(n^(1−ε)). Pero f(n) / n^(1−ε) = n^ε / log n crece sin límite.
- No es el caso 2: f(n)/n = 1 / log n tiende a 0, así que f no es Θ(n).
- No es el caso 3: f es menor que n.
Y queda fuera incluso de la versión de CLRS, que pide m ≥ 0, porque aquí sería m = −1. Hay teoremas todavía más generales, como el de Akra-Bazzi, que sí la cubren. Lo importante es que el árbol vuelve a resolverla sin ninguna maquinaria. El nivel i pesa:
2ⁱ · (n/2ⁱ) / log(n/2ⁱ) = n / (k - i)Con n = 16: 4,00; 5,33; 8,00; 16,00. Ahora los niveles suben hacia las hojas, otra vez sin un factor fijo. Sumando desde i = 0 hasta k − 1:
T(n) = n · (1/k + 1/(k - 1) + … + 1/1) + n = n · Hₖ + ndonde Hₖ = 1 + 1/2 + … + 1/k es el número armónico. Falta saber cuánto vale. Agrupemos los términos: del 1/2 al 1/3 hay dos términos, cada uno a lo sumo 1/2; del 1/4 al 1/7 hay cuatro, cada uno a lo sumo 1/4. Cada grupo suma a lo sumo 1, y hay alrededor de log k grupos, así que Hₖ = O(log k). Con grupos del tipo 1/3 + 1/4, donde cada término es al menos 1/4, cada grupo suma al menos 1/2, y Hₖ = Ω(log k). Por lo tanto, Hₖ = Θ(log k). Como k = log n:
T(n) = n · Θ(log k) + n = Θ(n log log n)Con n = 16: 16 · (1 + 1/2 + 1/3 + 1/4) + 16 = 49,33, otra vez lo que dio el programa.
Comprobar con números
recurrences.cpp calcula T(n) con la recurrencia y lo divide por la solución que dice la teoría. Si la solución es
correcta, la razón
tiene que acercarse a una constante. No corre ningún algoritmo: es aritmética con long double, y por eso puede
llegar a n = 2¹⁰²⁴.
$ build/recurrences
log n  8T+n^2   3T+n     T+1      2T+n     2T+nlogn  2T+n/logn
       /n^3     /n^1,585 /log n   /nlogn   /nlog^2n  /nloglogn
4      1.938    2.605    1.250    1.250    0.688     1.542
8      1.996    2.922    1.125    1.125    0.578     1.239
16     2.000    2.997    1.062    1.062    0.535     1.095
32     2.000    3.000    1.031    1.031    0.517     1.012
64     2.000    3.000    1.016    1.016    0.508     0.957
128    2.000    3.000    1.008    1.008    0.504     0.919
256    2.000    3.000    1.004    1.004    0.502     0.891
512    2.000    3.000    1.002    1.002    0.501     0.869
1024   2.000    3.000    1.001    1.001    0.500     0.851
Las cinco primeras columnas se acercan a los coeficientes que dicen las formas cerradas: 2, 3, 1, 1 y 1/2. La última baja muy despacio. Según la fórmula, es (Hₖ + 1) / log k, cuyo límite es ln 2 ≈ 0,693, y a n = 2¹⁰²⁴ todavía no ha llegado.
Error común. Tomar una tabla como esta como demostración. Con la última columna, alguien podría concluir que la razón no se estabiliza, o que tiende a 0. La tabla sirve para detectar un error y para ganar confianza. La demostración es el árbol, con la suma de arriba.
Comprobar una solución por inducción
Una vez que se tiene una solución candidata, salida del árbol o de una intuición, se puede comprobar con inducción. El método se llama sustitución: se supone que la cota vale para los tamaños menores, se sustituye en la recurrencia y se concluye para n. Aquí hay un cuidado que no aparecía en la semana pasada.
Una “demostración” equivocada. Afirmemos que T(n) = 2 T(n/2) + n es O(n), es decir, que T(n) ≤ cn. Por inducción:
T(n) = 2 T(n/2) + n ≤ 2 · c(n/2) + n = cn + n = (c + 1) n = O(n) ← ¡falso!Cada paso de álgebra está bien, y la conclusión es falsa: ya sabemos que T(n) = Θ(n log n). El error está en la última igualdad. Lo que había que demostrar era T(n) ≤ cn, con la misma constante c que se usó en la hipótesis. Lo que salió es T(n) ≤ cn + n, y eso no implica T(n) ≤ cn. Decir “(c + 1) n es O(n)” esconde que la constante crece en cada nivel de la inducción: c, c + 1, c + 2, …, y tras log n niveles ya no es una constante. De hecho, ese es el factor log n que faltaba.
Idea clave. Dentro de una inducción no se puede escribir O(n). Se escribe una cota con una constante explícita, y se demuestra exactamente esa cota.
La demostración correcta. Afirmación: si T(1) = 1 y T(n) = 2 T(n/2) + n, entonces T(n) ≤ 2 n log n para toda potencia de 2 con n ≥ 2. Técnica: inducción sobre las potencias de 2, con la constante c = 2 fija desde el comienzo.
- Base, n = 2. T(2) = 2 · 1 + 2 = 4, y 2 · 2 · log 2 = 4. Se cumple.
- Paso, n ≥ 4. Suponemos que vale para n/2, que es al menos 2. Entonces:
T(n) = 2 T(n/2) + n
     ≤ 2 · 2 (n/2) log(n/2) + n       hipótesis, con n/2 ≥ 2
     = 2 n (log n - 1) + n
     = 2 n log n - n
     ≤ 2 n log n                      porque n > 0
La cota es exactamente la misma, y sobró un término −n para absorber el trabajo de la combinación. Noten dos detalles. La base no puede ser n = 1, porque la cota diría T(1) ≤ 0. Y por eso el paso empieza en n = 4: así la hipótesis se usa desde n/2 = 2.
A veces hay que demostrar algo más fuerte. T(n) = 2 T(n/2) + 1, con T(1) = 1, sí es O(n). Pero al intentar T(n) ≤ cn:
T(n) ≤ 2 · c(n/2) + 1 = cn + 1Se pasa por 1, por más grande que elijamos c. No es que la afirmación sea falsa: es que la hipótesis es demasiado débil. Si restamos un término de menor orden, la inducción pasa. Afirmación: T(n) ≤ 2n − 1. La base es T(1) = 1 = 2 − 1. Y el paso:
T(n) = 2 T(n/2) + 1 ≤ 2 (2 · n/2 - 1) + 1 = 2n - 2 + 1 = 2n - 1Parece extraño que una cota más estricta sea más fácil de demostrar, pero tiene sentido: la hipótesis también es más fuerte. De hecho, T(n) = 2n − 1 exactamente.
El costo de copiar
Vamos ahora con un error muy frecuente en C++, porque ahí f(n) se esconde en la firma de la función. Pasar un
std::vector por valor
hace una copia completa: es una llamada al constructor de copia, que copia cada elemento.
Tomemos búsqueda binaria recursiva, y escribámosla de tres maneras. copy_cost.h las tiene, con un tipo de elemento
que cuenta sus
copias, porque contar copias da un número exacto, y medir el tiempo, no:
// 1. El arreglo completo por valor, con índices.
int search_whole_copy(std::vector<Counted> a, std::size_t lo, std::size_t hi, int target, int& calls);

// 2. Copia solo la mitad que sigue y llama con ese arreglo nuevo.
bool search_half_copy(const std::vector<Counted>& a, int target, int& calls);

// 3. Por referencia, con índices.
int search_by_reference(const std::vector<Counted>& a, std::size_t lo, std::size_t hi, int target, int& calls);
Las tres buscan lo mismo y dan la misma respuesta. Su costo no se parece. La tabla es del peor caso, un valor menor que todos, que siempre sigue por la izquierda:
$ build/copy_count
búsqueda binaria
n        llamadas  entero por valor  solo la mitad  por referencia
1024     12        12288             1023           0
2048     13        26624             2047           0
4096     14        57344             4095           0
8192     15        122880            8191           0

mergesort con el auxiliar por valor
n        llamadas  copias
1024     2047      2096128
2048     4095      8386560
4096     8191      33550336
Veamos cada una:
Por referencia. Cada llamada hace trabajo constante: T(n) = T(n/2) + 1 = Θ(log n).
Solo la mitad. Cada llamada copia un arreglo del tamaño de su subproblema: T(n) = T(n/2) + n. Es el caso 3, con d = 1/2 en la regularidad, y da Θ(n). Con n = 1024 fueron 512 + 256 + … + 1 = 1023 copias, como dice la tabla. Empeora de log n a n: se pierde justo lo que hacía útil la búsqueda binaria, que es no tocar la mayoría de los elementos.
El arreglo completo por valor. Aquí está lo sutil. No es T(n) = T(n/2) + n, porque el arreglo que se copia no se achica: en la llamada del final, cuando el rango tiene un elemento, se siguen copiando los n elementos. La f de cada llamada no depende del tamaño de su subproblema, sino del n original. Si llamamos m = hi − lo:
S(m) = S(m/2) + n, con n fijoEste n es una constante para la recurrencia en m, y no se puede aplicar el teorema como si fuera f(m) = m. Hay log n + 2 llamadas, cada una con n copias:
S(n) = n · (log n + 2) = Θ(n log n)Con n = 1024 son 12 · 1024 = 12288, justo lo que dio el programa. Es peor que una búsqueda lineal, que cuesta Θ(n).
Error común. Pasar un
std::vectorpor valor en una función recursiva e ignorar el costo de copiar. La recurrencia que están imaginando no es la que corre: hay que sumar la copia a f, y preguntarse de qué tamaño es lo que se copia.
Lo mismo pasa con mergesort. Este es el error típico, en copy_cost.h: el arreglo auxiliar se recibe por valor.
template <typename T>
void sort_range_buffer_by_value(std::vector<T>& a, std::vector<T> buffer, std::size_t lo, std::size_t hi);
Parece una diferencia de un carácter, un & que falta, y el programa ordena bien. Pero un árbol binario con n hojas
y dos hijos en cada nodo interno
tiene n − 1 nodos internos, así que hay 2n − 1 llamadas. Cada una copia n elementos. El total es (2n − 1) · n =
Θ(n²) copias. Las pruebas comprueban esa cuenta exacta para
varios n; con n = 1024, por ejemplo, 2047 · 1024 = 2096128. Mergesort deja de ser Θ(n log n).
Esta medición compara las dos versiones. Es una corrida en nuestra máquina, con -O2, en el menor de 3 tiempos: los
tiempos dependen de la máquina, y mientras se tomaron había otros
procesos corriendo.
$ build/copy_bench
n       referencia ms  razón  por valor ms  razón
2000             0.06                 0.68
4000             0.18   3.01          3.35   4.96
8000             0.45   2.47         21.98   6.55
16000            0.99   2.19        138.28   6.29
32000            2.20   2.22        833.45   6.03
Con 32000 elementos, una versión tarda unos 2 ms y la otra más de 800. Fíjense además en lo que no cuadra. Las copias se multiplican por 4 al duplicar n, y aquí el tiempo se multiplica por unas 6. El conteo es exacto, pero una copia no siempre cuesta lo mismo: cada una hace una reserva de memoria y mueve un bloque más grande, que puede dejar de caber en la cache. Es una explicación plausible, y esta medición no la comprueba. Lo que sí podemos afirmar es que la razón no se parece en nada al 2,2 de la versión correcta.
Una aclaración para no exagerar. Copiar en cada llamada no siempre cambia la respuesta. Si mergesort crea dos
std::vector nuevos, cada uno con su mitad, cada llamada copia un
tamaño proporcional a su subproblema. Eso solo se suma a la f que ya era Θ(n): T(n) = 2 T(n/2) + Θ(n) sigue dando
Θ(n log n), con una constante peor. Por eso hay que preguntarse de qué tamaño es la copia, y no solo si hay copia.
En C++. Para no copiar, pasen
const std::vector<int>&si solo van a leer, ystd::vector<int>&si van a modificar.std::span<const int>, de C++20, representa un pedazo de un arreglo sin copiarlo: recortarlo cuesta O(1), y no hay que arrastrar índices. El peligro de todas estas opciones es que el arreglo original tiene que seguir vivo. Y cuidado conauto:auto half = a;también copia.
Mergesort, ahora demostrado
Ya conocen mergesort, de Estructuras de Datos. Allá lo implementaron y explicaron su costo con el árbol de llamadas.
Aquí vamos a demostrar que es correcto. Este es el
pseudocódigo, con rangos semiabiertos: [ini, fin) incluye a ini y no incluye a fin.
algoritmo mezclar(a, aux, ini, medio, fin)
    i ← ini
    j ← medio
    para k desde ini hasta fin - 1 hacer
        si j = fin o (i < medio y a[i] ≤ a[j]) entonces
            aux[k] ← a[i]
            i ← i + 1
        sino
            aux[k] ← a[j]
            j ← j + 1
        fin si
    fin para
    para k desde ini hasta fin - 1 hacer
        a[k] ← aux[k]
    fin para
fin algoritmo

algoritmo ordenar(a, aux, ini, fin)
    si fin - ini ≤ 1 entonces
        devolver
    fin si
    medio ← ini + (fin - ini) div 2
    ordenar(a, aux, ini, medio)
    ordenar(a, aux, medio, fin)
    mezclar(a, aux, ini, medio, fin)
fin algoritmo
La condición del si se evalúa de izquierda a derecha, y se detiene en cuanto se conoce el resultado. Así, a[j]
no se lee cuando j = fin, ni a[i] cuando i = medio.
En C++, merge_sort.h es casi una traducción línea por línea. El arreglo auxiliar se crea una sola vez y se pasa
por referencia, por lo que acabamos de ver:
template <typename T>
void merge_ranges(std::vector<T>& a, std::vector<T>& buffer, std::size_t lo, std::size_t mid, std::size_t hi) {
    std::size_t i = lo;
    std::size_t j = mid;
    for (std::size_t k = lo; k < hi; k++) {
        // Con <=, en un empate pasa primero el de la izquierda: eso hace estable el orden.
        if (j == hi || (i < mid && a[i] <= a[j])) {
            buffer[k] = a[i];
            i++;
        } else {
            buffer[k] = a[j];
            j++;
        }
    }
    for (std::size_t k = lo; k < hi; k++) {
        a[k] = buffer[k];
    }
}

template <typename T>
void sort_range(std::vector<T>& a, std::vector<T>& buffer, std::size_t lo, std::size_t hi) {
    if (hi - lo <= 1) {
        return;
    }
    std::size_t mid = lo + (hi - lo) / 2;
    sort_range(a, buffer, lo, mid);
    sort_range(a, buffer, mid, hi);
    merge_ranges(a, buffer, lo, mid, hi);
}

template <typename T>
void merge_sort(std::vector<T>& a) {
    std::vector<T> buffer(a.size());
    sort_range(a, buffer, 0, a.size());
}
Sigámoslo con el arreglo 5, 2, 6, 1, 4, 3. El programa imprime cada mezcla en el orden en que ocurre:
$ build/merge_sort_demo
mezclar [1,2) y [2,3): 2 | 6 -> 2 6
mezclar [0,1) y [1,3): 5 | 2 6 -> 2 5 6
mezclar [4,5) y [5,6): 4 | 3 -> 3 4
mezclar [3,4) y [4,6): 1 | 3 4 -> 1 3 4
mezclar [0,3) y [3,6): 2 5 6 | 1 3 4 -> 1 2 3 4 5 6
Con n = 3, la mitad izquierda tiene ⌊3/2⌋ = 1 elemento y la derecha 2. Los rangos de un solo elemento son el caso base, y no generan ninguna mezcla.
La invariante de la mezcla
Sigamos ahora la última mezcla, vuelta por vuelta. Este programa imprime los valores de k, i y j antes de cada
vuelta, con a = 2 5 6 1 3 4, ini = 0, medio = 3 y fin = 6:
$ build/merge_trace
k  i  j  pasa  de         quedan a la izquierda
0  0  3  1     derecha    3
1  0  4  2     izquierda  -
2  1  4  3     derecha    2
3  1  5  4     derecha    2
4  1  6  5     izquierda  -
5  2  6  6     izquierda  -
Por ahora ignoren la última columna. La usaremos para contar. Lo que hay que ver es qué se mantiene en cada fila: lo
que ya pasó a aux son los más chicos, y están ordenados.
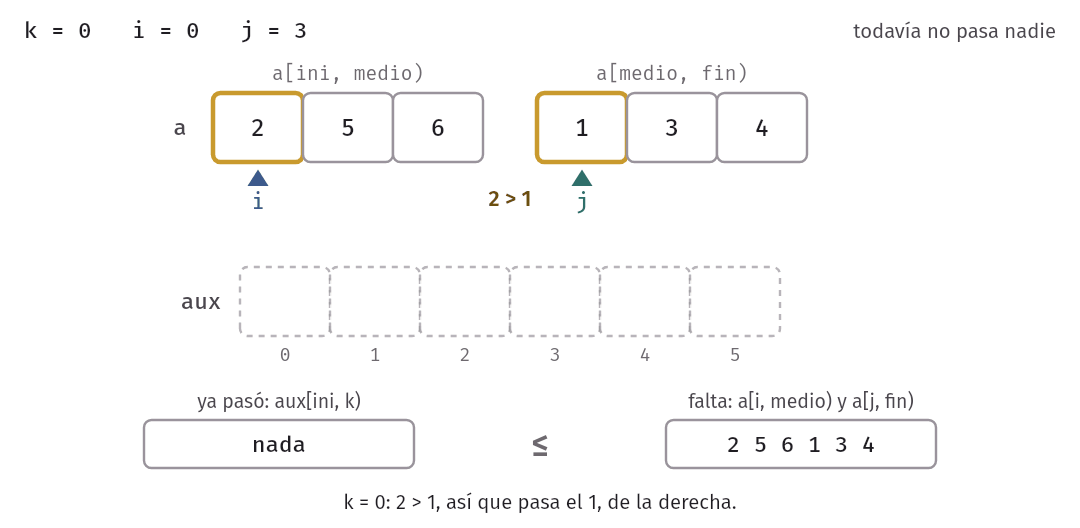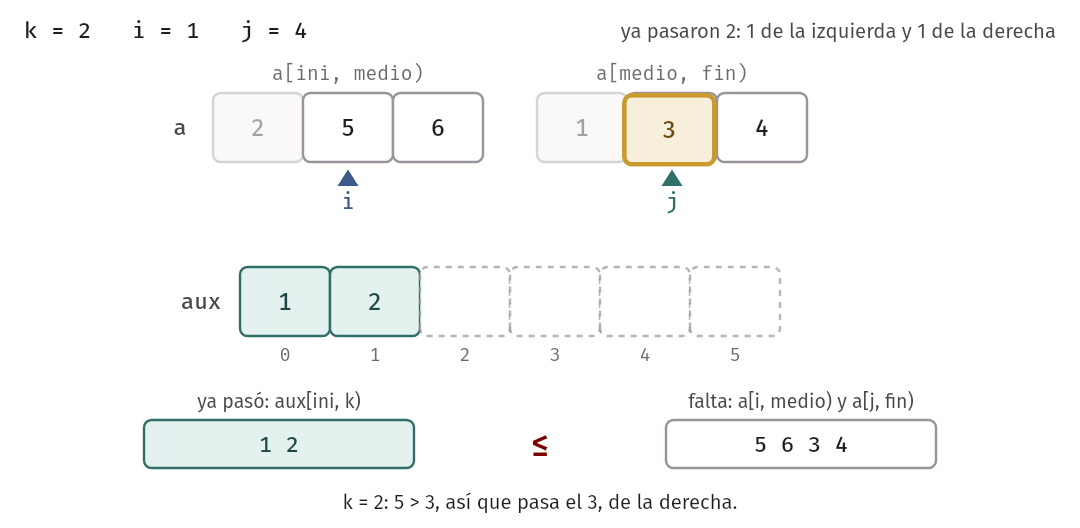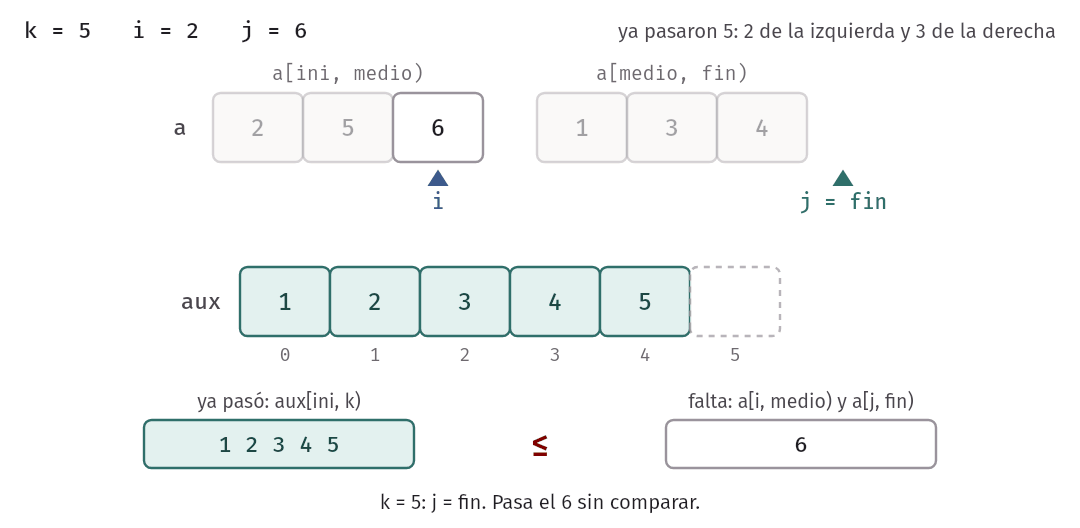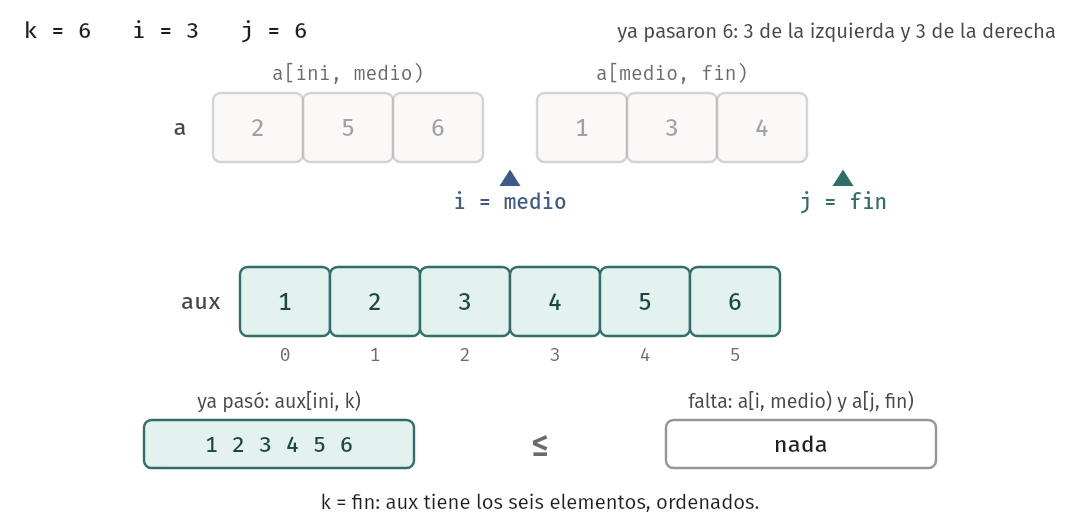
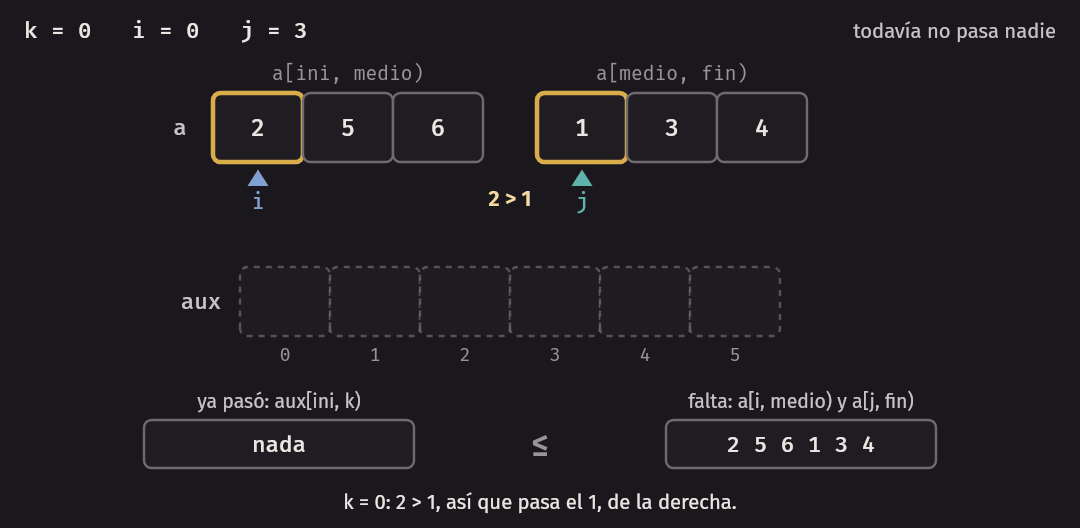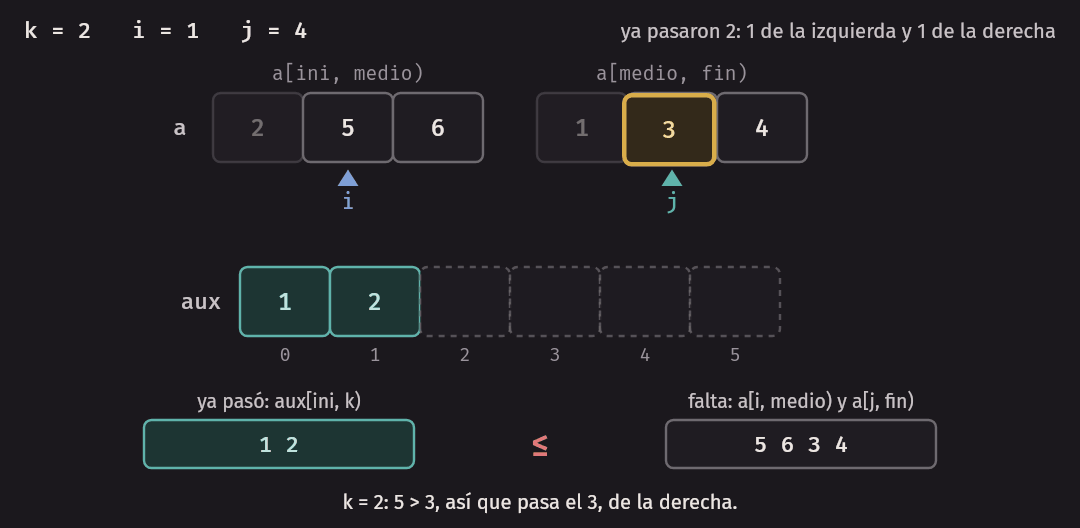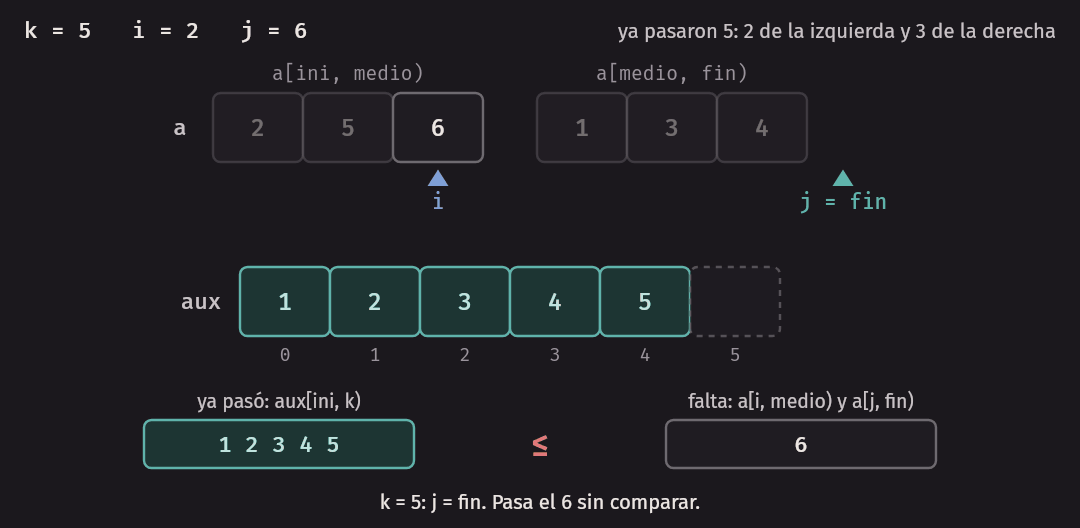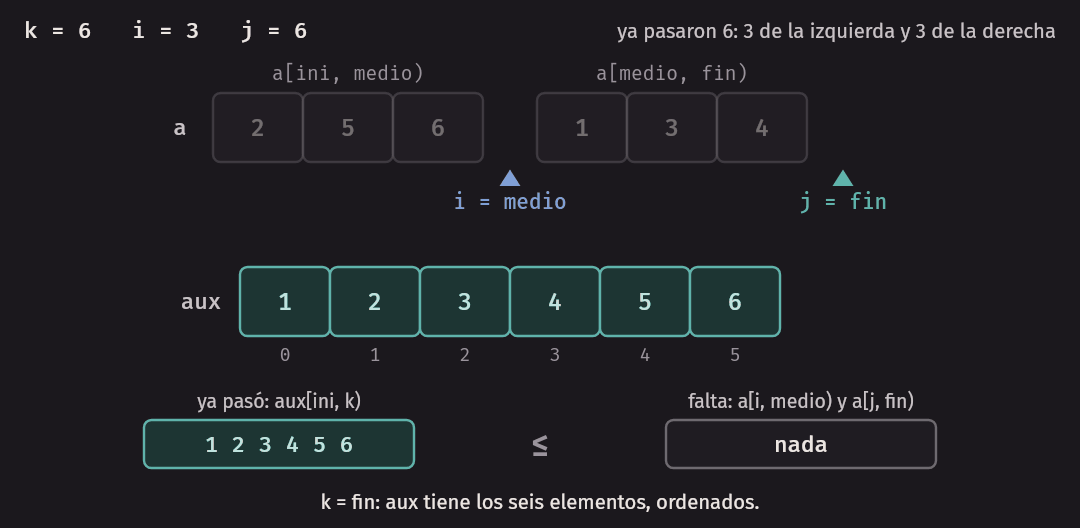
Afirmación. Si a[ini, medio) y a[medio, fin) están ordenados, al terminar el primer ciclo aux[ini, fin)
contiene los mismos elementos que a[ini, fin), ordenados. Técnica: invariante de ciclo.
Invariante. Antes de cada vuelta del primer ciclo, con el valor actual de k:
- Ya se copiaron exactamente a[ini, i) y a[medio, j), así que (i − ini) + (j − medio) = k − ini.
- aux[ini, k) contiene esos mismos elementos, ordenados.
- Todo elemento de aux[ini, k) es menor o igual que todo elemento que falta copiar, es decir, que los de a[i, medio) y a[j, fin).
Inicio. Con k = ini, i = ini, j = medio, no se ha copiado nada: las tres condiciones valen, porque hablan de conjuntos vacíos.
Conservación. Como k < fin, por (1) falta copiar al menos un elemento. Hay dos ramas.
El si se cumple. Primero, a[i] existe. Si fue porque i < medio, es inmediato. Si fue porque j = fin, entonces
toda la derecha ya se copió, y como falta copiar algo, i < medio. Ahora mostremos que a[i] es
menor o igual que todo lo que falta. En la izquierda, porque a[i, medio) está ordenado y a[i] es el primero. En la
derecha: si j = fin, no queda nadie; si no, el si se cumplió porque a[i] ≤ a[j], y a[j] es el menor de
a[j, fin), porque ese tramo está ordenado. Al copiarlo y avanzar i y k:
- (1) sigue valiendo: a[i] pasó de lo que faltaba a lo copiado.
- (2) sigue valiendo: por (3), a[i] es mayor o igual que todo lo que ya estaba en
aux, así que el prefijo sigue ordenado. - (3) sigue valiendo: los viejos ya cumplían, porque lo que falta ahora es un subconjunto de lo que faltaba. Y el nuevo, a[i], acabamos de mostrar que es menor o igual que todo lo que falta.
El si no se cumple. Entonces j < fin, porque j = fin es falso, así que a[j] existe. Además, i = medio o a[i] >
a[j]. En el primer caso no queda nadie a la izquierda. En el segundo, a[j] < a[i] ≤ todo a[i, medio). Y a[j] es el
primero
de la derecha ordenada, así que a[j] también es menor o igual que todo lo que falta. El resto es igual que en la
otra rama.
Salida. El ciclo termina con k = fin. Por (1), se copiaron fin − ini elementos, es decir, todos. Por (2),
aux[ini, fin) tiene exactamente los elementos de a[ini, fin), ordenados. El segundo ciclo los devuelve a a. ∎
Noten que la condición (3) es la que hace funcionar el argumento: sin ella, (2) no se conservaría. Es lo que
advertimos la semana pasada: una invariante que no alcanza no se puede demostrar, o no da el resultado. Las pruebas,
en test_merge_invariant, comprueban las tres condiciones en cada vuelta, con
arreglos al azar y con repetidos.
La mezcla hace una cantidad de trabajo de Θ(fin − ini): dos ciclos, de fin − ini vueltas cada uno, con trabajo constante por vuelta.
Idea clave. La mezcla funciona porque el más chico de lo que falta siempre está al frente de una de las dos mitades. Para encontrarlo basta una comparación.
Estabilidad
Un ordenamiento es estable si los elementos iguales conservan el orden que tenían. Esto importa cuando se ordena por una clave y hay más datos: ordenar por nota una lista ya ordenada por apellido, por ejemplo.
Mergesort es estable gracias a un solo detalle: el ≤ de la mezcla. Dos elementos iguales de la misma mitad
conservan su orden, por inducción. Si están en mitades distintas, en un empate pasa primero el de la izquierda, que
era el que estaba antes. Con < en lugar de ≤
el algoritmo seguiría ordenando, pero dejaría de ser estable. La prueba test_stability lo comprueba con pares
(clave, posición original).
Inducción sobre n
Afirmación. ordenar(a, aux, ini, fin) termina, deja ordenado a[ini, fin) con los mismos elementos que tenía, y
no toca el resto de a. Técnica: inducción fuerte sobre n = fin − ini.
Base, n ≤ 1. No hace nada. Un rango de 0 o 1 elementos ya está ordenado.
Paso, n ≥ 2. Con medio = ini + ⌊n/2⌋, las mitades tienen ⌊n/2⌋ y ⌈n/2⌉ elementos. Las dos son menores que n,
justamente porque n ≥ 2. Las dos son también al menos 1. Por hipótesis, las dos llamadas terminan y dejan ordenada
cada mitad, sin tocar nada más. En particular, la
segunda llamada no desordena lo que hizo la primera. Entonces, se cumple lo que mezclar necesita, y por la
afirmación anterior, a[ini, fin) queda ordenado con los mismos elementos. ∎
Error común. Usar n ≤ 0 como único caso base, o calcular
mediode modo que un rango de 2 no se reduzca. Con n = 1, ⌊1/2⌋ = 0, y la segunda llamada recibiría el mismo rango: una recursión infinita. La demostración lo muestra por sí sola, porque en el paso se usó que las mitades son menores que n.
En la práctica. En C++ no escriban su propio mergesort para ordenar.
std::stable_sortda un orden estable. En libstdc++, la biblioteca deg++, es una mezcla que ordena los pedazos chicos por inserción. Lo escribimos aquí para demostrarlo, y porque enseguida lo vamos a extender a algo que la biblioteca no hace.
Cuánto cuesta
La recurrencia es T(n) = T(⌊n/2⌋) + T(⌈n/2⌉) + Θ(n), que por el caso 2 del teorema y por lo que vimos de los pisos da Θ(n log n).
Podemos ser más precisos si contamos solo las comparaciones entre elementos. Una mezcla de n elementos hace a lo sumo n − 1 comparaciones, porque cada comparación saca un elemento, y el último sale sin comparar. Entonces, en el peor caso:
C(1) = 0, C(n) = C(⌊n/2⌋) + C(⌈n/2⌉) + n - 1Para n = 2ᵏ, C(n) = n log n − n + 1. Se comprueba por inducción con la cota exacta: C(1) = 0 = 1 · 0 − 1 + 1, y
C(n) = 2 C(n/2) + n - 1
     = 2 ((n/2)(k - 1) - n/2 + 1) + n - 1
     = n(k - 1) - n + 2 + n - 1
     = n k - n + 1
Para n en general, la forma cerrada es n⌈log n⌉ − 2^⌈log n⌉ + 1. Queda como ejercicio, y test_comparisons la
comprueba para todo n hasta 2000.
Este programa cuenta comparaciones con varias entradas. La columna peor usa una entrada construida al revés de la
mezcla, repartiendo los elementos de forma alternada, para obligar a n − 1 comparaciones en cada mezcla:
$ build/comparisons
n        ordenado  invertido al azar  peor      fórmula
16       32        32        48       49        49
17       33        37        50       54        54
1000     4932      5044      8710     8977      8977
1024     5120      5120      8935     9217      9217
65536    524288    524288    965653   983041    983041
1000000  9884992   10066432  18673910 18951425  18951425
Con un arreglo ya ordenado, cada mezcla termina cuando se acaba la izquierda: unas (n/2) log n comparaciones. Es la mitad, pero sigue siendo Θ(n log n). Noten que en mergesort el mejor caso y el peor difieren solo en la constante. En cualquier entrada, cada mezcla de n elementos hace al menos ⌊n/2⌋ comparaciones. Al azar se queda muy cerca del peor caso.
¿Y el tiempo? Al duplicar n, la recurrencia predice que el tiempo se multiplica por 2(k + 1)/k, para n = 2ᵏ. Es un poco más que 2.
$ build/merge_bench
n         tiempo ms  razón  predice 2(k+1)/k
131072         10.3
262144         21.7   2.11     2.12
524288         48.2   2.22     2.11
1048576        98.2   2.04     2.11
2097152       204.6   2.08     2.10
4194304       425.8   2.08     2.10
8388608       893.3   2.10     2.09
Es una corrida con -O2, el menor de 3 tiempos, en una máquina compartida con otros procesos. Los tiempos dependen
de la máquina, y las razones oscilan: con números tan cercanos, una tabla como esta es compatible con n log n, pero
no la distingue de otras funciones parecidas. Lo que la sostiene es la demostración.
Inversiones
Cambiamos de pregunta. Una inversión (inversion) de un arreglo a es un par de posiciones (i, j) con i < j y a[i]
a[j]. Es decir, un par de elementos en el orden contrario al que tendrían ordenados.
$ build/inversions
3 1 4 2: 3 inversiones: (3,1) (3,2) (4,2)
1 2 3 4: 0 inversiones:
4 3 2 1: 6 inversiones: (4,3) (4,2) (4,1) (3,2) (3,1) (2,1)
El programa escribe los valores de cada par, no sus posiciones, porque así se lee mejor. La continuación de esta salida aparece más abajo.
Si no hay repetidos, el número de inversiones va de 0 a n(n−1)/2:
- Mínimo: 0. Cero inversiones significa que ningún par está al revés. Eso es lo mismo que estar ordenado: un arreglo no ordenado tiene dos vecinos al revés.
- Máximo: n(n−1)/2. Es la cantidad total de pares, así que no puede haber más. Se alcanza con el arreglo estrictamente decreciente, donde todos los pares están invertidos. Además es el único con todos los elementos distintos que lo alcanza, porque si todos los pares están invertidos, en particular lo están los vecinos.
Con n = 4 son 6, como en la tercera línea. Y esto tiene una consecuencia inmediata para C++. Con n = 65 536, el
máximo es 2 147 450 880, que todavía cabe en int. Con n = 65 537 es 2 147 516 416, que ya no cabe. El límite de
int es 2 147 483 647.
Error común. Guardar el conteo en un
int. Con n = 10⁵, un arreglo al revés da casi 5 · 10⁹ inversiones. Sumar más allá del límite deintes comportamiento indefinido: con sanitizers, el programa se detiene con un aviso. Sin ellos, como compila el juez, lo habitual es que no falle, y dé un número equivocado, a veces negativo y a veces positivo y creíble. Usenlong long, que alcanza de sobra: con estos tamaños, n(n−1)/2 está muy lejos de 2⁶³.
Qué miden
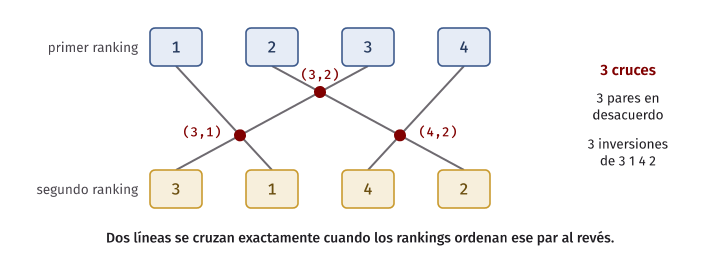
Las inversiones miden cuánto se parecen dos rankings. Supongamos que dos personas ordenan las mismas n películas, de la que más les gustó a la que menos. Un par de películas está en desacuerdo si una persona pone a X antes que Y y la otra pone a Y antes que X. La cantidad de pares en desacuerdo es una medida natural de distancia: 0 si los rankings son iguales, y n(n−1)/2 si uno es el otro al revés. En estadística se conoce como la distancia de Kendall tau.
El caso sencillo es cuando el primer ranking es 1, 2, …, n. El segundo ranking, escrito como arreglo, tiene entonces exactamente tantas inversiones como pares en desacuerdo. Por ejemplo, 3, 1, 4, 2 frente a 1, 2, 3, 4 está en desacuerdo en 3 pares. Cómo llevar a esta forma dos rankings cualesquiera es el primer paso del laboratorio.
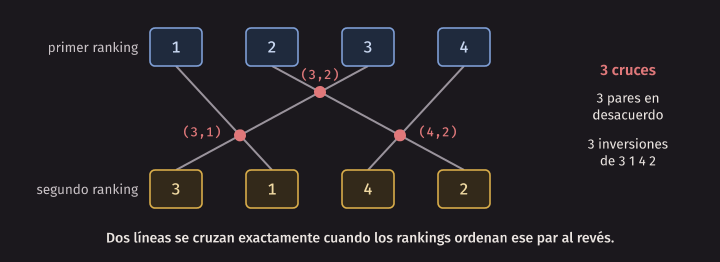
También miden cuánto trabajo hace falta para ordenar con pasos pequeños.
Afirmación. Con elementos distintos, el mínimo de intercambios de elementos vecinos necesarios para ordenar un arreglo es igual a su número de inversiones. Técnica: una cota por cada lado.
Tomemos dos vecinos y cambiémoslos de lugar. Cualquier otro par de elementos conserva su orden relativo, porque ninguno de los dos pasa por encima del otro. Solo cambia ese par: si estaba invertido deja de estarlo, y si no, pasa a estarlo. Entonces cada intercambio cambia las inversiones en exactamente 1.
- Se necesitan al menos esos. Hay que llegar a 0 inversiones, y cada intercambio baja a lo sumo 1.
- Alcanzan. Mientras el arreglo no esté ordenado, hay dos vecinos al revés. Intercambiarlos baja 1 las inversiones. Tras tantos pasos como inversiones había, quedan 0, y el arreglo está ordenado. ∎
Esto es lo que hacen ordenamiento por inserción y burbuja, y explica por qué cuestan Θ(n²) en el peor caso: un
arreglo puede tener Θ(n²) inversiones, y ellos las quitan de una en una. También explica por qué inserción es rápida
con un arreglo casi ordenado. test_adjacent_swaps lo comprueba.
Fuerza bruta
Lo primero que se le ocurre a cualquiera es revisar todos los pares:
algoritmo inversiones_fuerza_bruta(a, n)
    cuenta ← 0
    para i desde 0 hasta n - 1 hacer
        para j desde i + 1 hasta n - 1 hacer
            si a[i] > a[j] entonces
                cuenta ← cuenta + 1
            fin si
        fin para
    fin para
    devolver cuenta
fin algoritmo
Es correcto, porque revisa cada par una vez. Y siempre hace n(n−1)/2 comparaciones: Θ(n²), sin importar la entrada.
$ build/brute_bench
n       inversiones  tiempo ms  razón
10000   24961152          17.7
20000   99565270          71.5   4.04
40000   402372200        282.0   3.95
80000   1605128162      1128.9   4.00
160000  6407002153      4525.7   4.01
Con -O2 y el menor de 3 tiempos, en una máquina compartida. Las razones son las de Θ(n²). Noten también que la
última fila ya no cabe en int, aun siendo un arreglo al azar: con datos al azar, el número esperado de inversiones
es la mitad del máximo. A este ritmo, n = 10⁶ tomaría unos 3 minutos, mientras que mergesort ordena un millón en una
décima de segundo. ¿Se puede contar en el tiempo de ordenar?
Da la impresión de que no: hay Θ(n²) pares, y la respuesta puede ser Θ(n²). Pero no hace falta visitar las inversiones una por una. Basta contarlas, y se pueden contar muchas de un solo golpe.
Contar inversiones con divide y vencerás
Dividir: dentro de cada mitad y entre las dos
Partimos el arreglo en dos mitades. Cada inversión (i, j) cae en exactamente uno de tres grupos, según dónde estén i y j:
- las dos posiciones en la izquierda;
- las dos posiciones en la derecha;
- i en la izquierda y j en la derecha: las llamamos inversiones cruzadas.
inversiones(a) = inversiones(izquierda) + inversiones(derecha) + cruzadas(izquierda, derecha)Los dos primeros grupos son subproblemas del mismo tipo: se resuelven con recursión. Este programa lo muestra en cada nodo del árbol de 5, 2, 6, 1, 4, 3, contando por fuerza bruta, como comprobación:
[0,6)  izquierda 1  derecha 1  cruzadas 7  total 9
[0,3)  izquierda 0  derecha 0  cruzadas 1  total 1
[1,3)  izquierda 0  derecha 0  cruzadas 0  total 0
[3,6)  izquierda 0  derecha 1  cruzadas 0  total 1
[4,6)  izquierda 0  derecha 0  cruzadas 1  total 1
La raíz: 1 + 1 + 7 = 9. La pregunta que queda es cuánto cuesta el tercer grupo. Si contamos las cruzadas revisando pares, hay (n/2)² = n²/4 pares, y T(n) = 2 T(n/2) + Θ(n²) = Θ(n²): no se ganó nada. Tenemos que hacerlo en Θ(n), porque entonces la recurrencia sería la de mergesort.
La observación clave es que las inversiones cruzadas no cambian si se ordena cada mitad. Una cruzada solo depende de qué valor está en cada lado, no de dónde está dentro de su lado: todo elemento de la izquierda está antes que todo elemento de la derecha, de cualquier forma. Entonces podemos suponer que las dos mitades están ordenadas. Y mergesort las deja justo así.
Contar durante la mezcla
Volvamos a la mezcla de 2 5 6 con 1 3 4. Ya vimos la salida de merge_trace. Veámosla de nuevo, agregando a mano
una columna con la suma de la última columna:
| k | i | j | pasa | de | quedan a la izquierda | suma |
|---|---|---|---|---|---|---|
| 0 | 0 | 3 | 1 | derecha | 3 (2, 5, 6) | 3 |
| 1 | 0 | 4 | 2 | izquierda | − | 3 |
| 2 | 1 | 4 | 3 | derecha | 2 (5, 6) | 5 |
| 3 | 1 | 5 | 4 | derecha | 2 (5, 6) | 7 |
| 4 | 1 | 6 | 5 | izquierda | − | 7 |
| 5 | 2 | 6 | 6 | izquierda | − | 7 |
La suma final es 7, y son justamente las 7 cruzadas que contó la fuerza bruta en la raíz. No es casualidad. Cuando el 1 pasa antes que todos los demás, es porque es menor que todos los que quedan a la izquierda. Esos 3 elementos están antes que el 1 en el arreglo y son mayores: son 3 inversiones cruzadas, y se cuentan de una vez, sin mirarlas una por una.
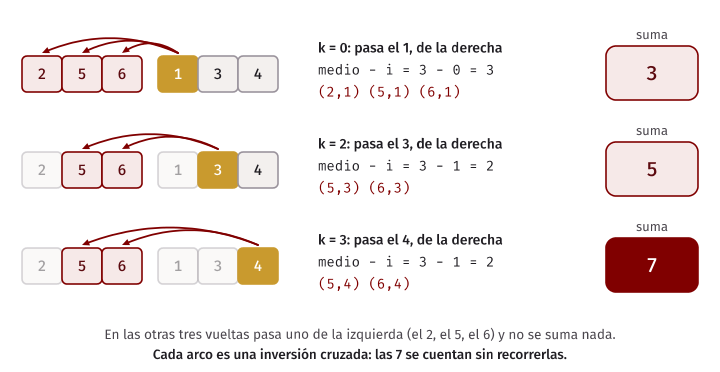
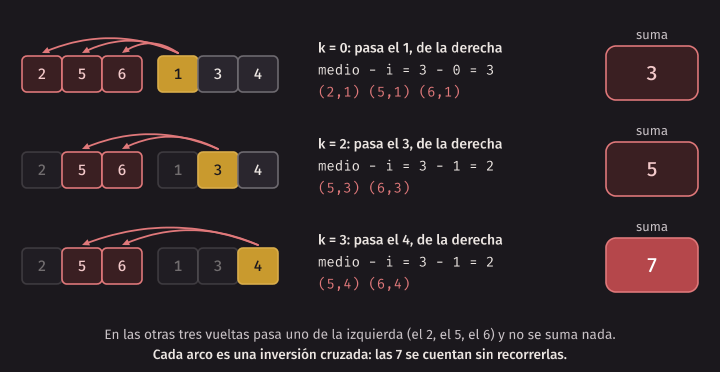
Lema. En una mezcla con ambas mitades ordenadas, cuando un elemento y = a[j] de la derecha pasa a aux, los
elementos de la izquierda mayores que y son exactamente los de a[i, medio), y son medio − i. Técnica: dos
inclusiones, a partir de la invariante de la mezcla.
Todos los de a[i, medio) son mayores que y. Si i = medio, no hay ninguno y no hay nada que probar. Si i < medio, y
pasó porque el si falló, y como j ≠ fin, tiene que haber sido porque a[i] > a[j] = y. Como la izquierda está
ordenada, todo a[i, medio) es mayor o igual que a[i], y por lo tanto mayor que y.
Ninguno de los ya copiados es mayor que y. Los elementos de a[ini, i) ya están en aux. La condición (3) de la
invariante dice que son menores o iguales que todo lo que falta copiar, y justo antes de esta vuelta y faltaba
copiar. ∎
Consecuencia. Si sumamos medio − i cada vez que pasa un elemento de la derecha, obtenemos exactamente las
inversiones cruzadas. Cada inversión cruzada (x, y) tiene un único y, y se cuenta una sola vez: en la vuelta en que
y pasa, porque un elemento pasa a aux una sola vez. Y los pares (x, y) con x ≤ y no se cuentan, por el lema.
Idea clave. Cuando un elemento de la derecha pasa primero, salta a todos los que quedan a la izquierda. Por eso una sola vuelta del ciclo puede contar muchas inversiones de un golpe.
El algoritmo
La función devuelve el número de inversiones de a[ini, fin) y, además, deja ese rango ordenado. Esto último es lo que permite la mezcla del nivel de arriba.
algoritmo contar_inversiones(a, aux, ini, fin)
    si fin - ini ≤ 1 entonces
        devolver 0
    fin si
    medio ← ini + (fin - ini) div 2
    cuenta ← contar_inversiones(a, aux, ini, medio)
    cuenta ← cuenta + contar_inversiones(a, aux, medio, fin)
    i ← ini
    j ← medio
    para k desde ini hasta fin - 1 hacer
        si j = fin o (i < medio y a[i] ≤ a[j]) entonces
            aux[k] ← a[i]
            i ← i + 1
        sino
            aux[k] ← a[j]
            j ← j + 1
            cuenta ← cuenta + (medio - i)
        fin si
    fin para
    para k desde ini hasta fin - 1 hacer
        a[k] ← aux[k]
    fin para
    devolver cuenta
fin algoritmo
Afirmación. contar_inversiones(a, aux, ini, fin) devuelve el número de inversiones que tenía a[ini, fin), y
deja ese rango ordenado. Técnica: inducción fuerte sobre n = fin − ini.
Base, n ≤ 1. No hay pares: devuelve 0, y el rango ya está ordenado.
Paso, n ≥ 2. Las dos mitades tienen menos de n elementos. Por hipótesis, las dos llamadas devuelven las inversiones de cada mitad y las dejan ordenadas. La mezcla es la misma de mergesort, así que el rango queda ordenado. Por el lema, lo que se suma durante la mezcla son las inversiones cruzadas de las mitades ya ordenadas, y esas son las mismas que antes de ordenarlas. Por lo tanto, la suma es el total: dentro de la izquierda, dentro de la derecha y cruzadas. ∎
Costo. Sumar medio − i cuesta O(1) por vuelta, así que la combinación sigue siendo Θ(n). La recurrencia es la de mergesort:
T(n) = 2 T(n/2) + Θ(n) = Θ(n log n)Es decir, se pueden contar hasta Θ(n²) inversiones en Θ(n log n), porque nunca se enumeran.
La medición de esta versión es parte del laboratorio. La cuenta no se muestra aquí en C++: pasarla del pseudocódigo es parte de su trabajo.
Los errores de esta sección
Error común. Contar 1 en lugar de todos los que quedan en la mitad izquierda. En el ejemplo de arriba, tres elementos pasaron desde la derecha, y contar 1 por cada uno da 3 en vez de 7. Y fíjense que en un caso chico la respuesta puede salir bien de casualidad: con 2 | 1, hay una sola inversión, y contar 1 acierta. Comprueben con varios elementos a la izquierda.
Error común. Sumar medio − i en la rama equivocada, o sumar i − ini: los que ya pasaron no son mayores, son los que faltan. Es una confusión fácil cuando se piensa en “los de la izquierda” sin distinguir.
Error común. Usar
<en la mezcla en vez de≤. Con 1, 1 no hay ninguna inversión, porque un par invertido exige a[i] > a[j]. Pero con<, el 1 de la derecha pasa primero con un elemento a la izquierda, y se cuenta 1. El lema dependía de que en un empate pase primero el de la izquierda. Si el problema no tiene repetidos, no se nota, y por eso este error sobrevive hasta que un caso lo encuentra.
Error común. Olvidar copiar de vuelta el arreglo auxiliar a
a. El conteo de ese nivel saldría bien, pero el nivel de arriba recibiría mitades desordenadas, y el lema ya no aplicaría. Esta es la razón por la que la función tiene que ordenar además de contar.
Comparando con la fuerza bruta
Una forma de comprobar que un programa como este es correcto, además de la demostración, es correrlo contra la fuerza bruta en miles de arreglos chicos al azar. En un arreglo chico, la fuerza bruta es “obviamente correcta”, y un desacuerdo señala el error en un caso que se puede leer. Esa técnica sirve para cualquier algoritmo rápido cuando existe uno lento y confiable. Es la que usarán en el laboratorio.
El código de la semana
| Archivo | Qué contiene |
|---|---|
merge_sort.h, merge_sort_demo.cpp |
Mergesort, y el programa que imprime cada mezcla |
merge_trace.cpp |
Una mezcla, vuelta por vuelta |
comparison_count.h, comparisons.cpp |
Comparaciones de mergesort, la recurrencia del peor caso y una entrada que la alcanza |
recurrences.h, recursion_tree.cpp, recurrences.cpp |
Trabajo por nivel, y T(n) contra la solución teórica |
from_code.h |
Las funciones de “del código a la recurrencia” |
copy_cost.h, copy_count.cpp |
Búsqueda binaria y mergesort que copian de más, con copias contadas |
inversions_brute.h, inversions.cpp |
Inversiones por fuerza bruta, y su reparto en cada nodo del árbol |
merge_bench.cpp, copy_bench.cpp, brute_bench.cpp |
Mediciones, con -O2 y sin sanitizers |
test_examples.cpp |
Las pruebas de este capítulo |
lab/compare_rankings/ |
El problema del laboratorio |
make test compila todos los ejemplos con -g -fsanitize=address,undefined, y corre test_examples:
$ make test
build/test_examples
todas las pruebas pasaron
Las pruebas comprueban con assert lo que afirma este capítulo: que merge_sort coincide con std::sort en
arreglos al azar, las tres condiciones de la invariante de la mezcla en cada vuelta, la estabilidad, las formas
cerradas de las recurrencias, los conteos exactos de copias, la fórmula de las comparaciones, el máximo de
inversiones sobre todas las permutaciones hasta n = 8, el reparto en izquierda, derecha y cruzadas, los intercambios
de vecinos, y el lema de la mezcla: cada vez que pasa un elemento de la derecha, se compara medio − i con el número
de elementos mayores de la izquierda, contados uno por uno. Las mediciones no se comprueban, porque dependen de la
máquina.
El laboratorio
El problema está en lab/compare_rankings/, con su enunciado en README.md. Tiene cuatro pasos:
- Reducir el problema de dos rankings a contar inversiones en un solo arreglo.
- Escribir primero la versión Θ(n²), y comprobar que el juez la acepta en los casos pequeños y da TLE en el grande.
- Escribir la versión con mergesort y pasar todos los casos.
- Medir con n y 2n, y comparar las razones con lo que predice la recurrencia.
El caso grande se genera con un programa y no está guardado: make test lo crea. Lean los límites y calculen antes
de escribir: ¿cuánto vale la respuesta más grande posible?
Resumen
- Una recurrencia da el costo de un algoritmo recursivo. En T(n) = a T(n/b) + f(n), a cuenta las llamadas que de verdad se ejecutan, n/b es su tamaño y f(n) es todo lo demás, incluidas las copias.
- En un árbol de recursión, el nivel i pesa aⁱ f(n/bⁱ) y hay n^(log_b a) hojas. Sumar por niveles funciona siempre que se pueda hacer la suma.
- El teorema maestro de tres casos compara f con n^c, c = log_b a: si f es polinomialmente menor, mandan las hojas, Θ(n^c); si son del mismo orden, todos los niveles, Θ(n^c log n); si es polinomialmente mayor y cumple la regularidad, manda la raíz, Θ(f(n)).
- T(n) = 2 T(n/2) + n log n cae en el hueco entre los casos: el árbol da Θ(n log² n), y una versión más general del teorema, como la de CLRS, también la cubre. T(n) = 2 T(n/2) + n / log n queda fuera incluso de esa, y el árbol da Θ(n log log n).
- Una comprobación por inducción debe demostrar la cota exacta con la misma constante: T(n) ≤ cn no se sigue de T(n) ≤ cn + n. A veces hay que demostrar una afirmación más fuerte, restando un término de menor orden.
- Copiar cuenta: un
std::vectorentero por valor da Θ(n log n) en búsqueda binaria y Θ(n²) en mergesort. Copiar solo el subproblema da T(n/2) + n = Θ(n) en la búsqueda. - La invariante de la mezcla:
aux[ini, k)tiene, ordenado, lo ya copiado, y nada de eso es mayor que lo que falta. La correctitud de mergesort sale con inducción fuerte sobre n. - Mergesort cuesta Θ(n log n) en cualquier entrada, y en el peor caso hace exactamente n log n − n + 1 comparaciones
si n es potencia de 2. El
≤lo hace estable. - Una inversión es un par en el orden contrario. Hay entre 0 y n(n−1)/2, y por eso el conteo necesita
long long. Miden cuánto se parecen dos rankings, y son el mínimo de intercambios de vecinos para ordenar. - Se cuentan en Θ(n log n) durante la mezcla: cuando un elemento de la derecha pasa primero, salta a los medio − i que quedan a la izquierda.
Ejercicios
- Resuelvan con el teorema maestro, indicando a, b, c y el caso, o digan por qué no aplica: a) T(n) = 4 T(n/2) + n. b) T(n) = 4 T(n/2) + n². c) T(n) = 4 T(n/2) + n³. d) T(n) = 2 T(n/4) + √n. e) T(n) = 9 T(n/3) + n log n. f) T(n) = T(n/2) + T(n/3) + n. g) T(n) = 2 T(n − 1) + 1.
- Dibujen el árbol de recursión de T(n) = 3 T(n/3) + n log n, con el trabajo de cada nivel, y encuentren su solución. ¿Qué caso del teorema de tres casos aplica?
- Para T(n) = 2 T(n/2) + n / log² n, usen el árbol para mostrar que T(n) = Θ(n). Ayuda: la serie 1 + 1/4 + 1/9 + … converge. Comparen con n / log n: ¿por qué un cambio tan pequeño en f cambia la respuesta?
- Comprueben por inducción, con constantes explícitas, que T(n) = 3 T(n/2) + n, con T(1) = 1, cumple T(n) ≤ 3 n^(log 3) − 2n para n potencia de 2. Luego intenten demostrar T(n) ≤ c n^(log 3), sin el término −2n, y muestren dónde se traba.
- Encuentren el error en esta afirmación, y señalen la línea exacta: “T(n) = T(n/2) + n es O(1), porque suponiendo T(n/2) ≤ c queda T(n) ≤ c + n = O(1)…” Además, ¿cuál es la solución verdadera?
- Un programa pasa un
std::stringpor valor en una función recursiva que recibe el índice de la posición actual y avanza de uno en uno hasta el final. ¿Cuál es el costo con una cadena de largo n? ¿Y si se pasa porconst&? Escríbanlo y cuenten las copias con la idea deCounted. - Demuestren que, en la mezcla de
merge_sort.h, con una entrada donde todos los elementos de la izquierda son menores que los de la derecha, el número de comparaciones es exactamente el tamaño de la izquierda. Deduzcan el número de comparaciones de mergesort en un arreglo ya ordenado con n = 2ᵏ. - Demuestren por inducción fuerte que C(n) = C(⌊n/2⌋) + C(⌈n/2⌉) + n − 1, con C(1) = 0, tiene como solución C(n) =
n⌈log n⌉ − 2^⌈log n⌉ + 1. Pueden comprobar su cuenta con
worst_case_formula. - Hallen, a mano, las inversiones de 4, 1, 3, 2, 5 con el algoritmo de este capítulo. Escriban el árbol de llamadas
y, en cada mezcla, la tabla con k, i, j y la suma. Comprueben el total con
count_inversions_brute. - Después de hacer el laboratorio: demuestren que la reducción que usaron es correcta, es decir, que las inversiones de su arreglo son exactamente los pares en desacuerdo de los dos rankings. Ayuda: escriban qué significa un par (i, j) de su arreglo en términos de los dos rankings.
- Mezclar k arreglos ordenados, de m elementos cada uno. a) Una idea es mezclar el primero con el segundo, el
resultado con el tercero, y así. ¿Cuánto cuesta? b) Con divide y vencerás, mezclando por parejas en un árbol,
escriban la recurrencia en k y resuélvanla. c) Programen las dos con
merge_rangesostd::merge, y cuenten las copias. - Una inversión significativa es un par i < j con a[i] > 2 · a[j]. Diseñen un algoritmo en Θ(n log n) que las
cuente. Ayuda: el conteo ya no se puede hacer en la misma vuelta que la mezcla, porque el orden de mezcla no
coincide con el de esta condición, pero sí se puede hacer un recorrido lineal aparte con las dos mitades ya
ordenadas. Demuestren por qué ese recorrido es lineal, prográmenlo y compruébenlo contra la fuerza bruta.
Calculen si el producto cabe en
intsi a[i] llega a 2 · 10⁹.