Apuntes · Capítulo 9Programación dinámica
Más programación dinámica
Más programación dinámica
Hace dos semanas armamos un método: definir el subproblema en una frase, escribir la recurrencia, elegir un orden y reconstruir. Lo aplicamos a problemas en que la tabla se llena sola, fila por fila, de izquierda a derecha. En los intervalos con pesos, en la mochila, en la LCS y en la distancia de edición, el orden nunca fue una decisión.
Esta semana el orden pasa a ser parte del problema. Vamos a ver tres formas nuevas de subproblema. La primera es sobre un grafo sin ciclos, donde el orden sale de lo que vieron en la semana 6. La segunda es sobre un rango i..j de una secuencia, donde el orden que uno escribe sin pensar lee casillas que todavía no se han llenado. La tercera es sobre un árbol, donde cada nodo espera a sus hijos, y la recursión natural puede agotar la pila.
Hay una idea que une todo: los subproblemas y sus dependencias forman un DAG. Con esa imagen, elegir un orden de cálculo deja de ser un truco: es elegir un orden topológico. Empezamos por ahí.
La primera sesión cubre ese DAG, el camino más largo, la subsecuencia creciente más larga, la multiplicación de una cadena de matrices y los árboles binarios de búsqueda óptimos. La segunda trabaja sobre árboles: conjunto independiente de peso máximo, cobertura de vértices mínima, cómo reconstruir y cómo evitar la recursión profunda.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Los subproblemas forman un DAG, Un árbol tiene un orden natural y, de Camino más largo en un DAG, Un greedy, y qué pasa con los nodos que no se alcanzan.
En clase: Sesión A, de Camino más largo en un DAG a Árboles binarios de búsqueda óptimos. Sesión B, de Conjunto independiente de peso máximo en un árbol a Evitar la recursión profunda.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El código de la semana. Para ampliar, la mejora a O(n log n) de Subsecuencia creciente más larga y las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, secs. 3.6 (Longest Increasing Subsequence), 3.9 (Optimal Binary Search Trees) y 6.4 (Memoization and Dynamic Programming). CLRS, capítulo Dynamic Programming, 4.ª edición. Sesión B: Erickson, sec. 3.10 (Dynamic Programming on Trees). Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-09. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los problemas de laboratorio están enlab/company_meetingylab/company_meeting_list, y cada uno tiene su propiomake test.
Los subproblemas forman un DAG
Tomemos cualquier programación dinámica y dibujemos un nodo por cada subproblema. Pongamos una arista A → B cuando la recurrencia de B lee a A, es decir, cuando hace falta A para calcular B. Ese es el grafo de subproblemas (subproblem graph). En este capítulo las flechas siempre van así, de lo que se lee a lo que lo lee.
Este es el de Fibonacci con n = 5, la primera parte de la salida de dag_demo:
$ build/dag_demo
Fibonacci, n = 5: quién lee a quién
  F(1) -> F(2)   F(0) -> F(2)
  F(2) -> F(3)   F(1) -> F(3)
  F(3) -> F(4)   F(2) -> F(4)
  F(4) -> F(5)   F(3) -> F(5)
  6 nodos, 8 aristas
F(1) --> F(2) --> F(3) --> F(4) --> F(5) cada uno lee al anterior
F(0) --> F(2)
F(1) --> F(3)
F(2) --> F(4)
F(3) --> F(5) y al de dos antesEn la distancia de edición de la semana 7, el nodo (i, j) lee tres casillas: (i − 1, j), (i, j − 1) e (i − 1, j − 1). Es una cuadrícula con flechas hacia la derecha, hacia abajo y en diagonal:
(0,0) --> (0,1) --> (0,2)
  | \       | \       |
  v  v      v  v      v
(1,0) --> (1,1) --> (1,2)
  | \       | \       |
  v  v      v  v      v
(2,0) --> (2,1) --> (2,2)
Tres cosas que ya conocíamos se leen ahora en este grafo.
- Tiene que ser un DAG. Un ciclo diría que A hace falta para calcular A. Una recurrencia con un ciclo de dependencias no define nada, y ningún programa la puede calcular en orden.
- Un orden de cálculo válido es un orden topológico. Es la definición de la semana 6: toda arista A → B va de un nodo a otro posterior, o sea, lo que se lee se calcula antes. Llenar una tabla por filas es elegir un orden topológico de la cuadrícula. Hay muchos otros, y todos sirven.
- La memoización es un DFS que parte del nodo de la respuesta y sigue las flechas al revés. Solo visita los subproblemas de los que depende la respuesta, y cada uno una vez, porque la tabla de memoización hace el papel del arreglo de visitados.
También sale la cuenta del costo que venimos usando. Si leer una casilla cuesta O(1), llenar todo cuesta
O(V + E) en ese grafo: un poco por cada casilla y un poco por cada lectura. En la distancia de edición, con cadenas
de largos n y m, hay (n + 1)(m + 1) nodos y 3nm + n + m aristas, y por eso cuesta Θ(nm). Con casa y cosas, n = 4 y
m = 5: 30 nodos y 69 aristas. Las pruebas comprueban esa fórmula con cadenas al azar.
Camino o combinación
Ahora la pregunta interesante: ¿qué forma tiene una solución dentro de ese DAG? Depende de cuántos subproblemas usa cada decisión.
Cuando cada opción lee un solo subproblema, la solución es un camino. En la distancia de edición,
D(i, j) es el mínimo entre tres opciones, y cada opción es el costo de una operación más una sola casilla. Si a cada
arista le ponemos ese costo como peso, D(n, m) es el peso del camino más barato de (0, 0) a (n, m). Lo mismo con la
mochila: K(i, c) elige entre K(i − 1, c), con peso 0, y K(i − 1, c − w), con peso v. Lo mejor es un camino de peso
máximo, desde alguna casilla de la fila 0. La salida de dag_demo sigue así, usando un solo programa, el camino más largo que veremos enseguida, con los
pesos del grafo. En la distancia de edición los pesos son los costos con signo menos:
Distancia de edición, casa -> cosas: 30 nodos, 69 aristas
  distancia, como camino en ese DAG: 2
  el camino, en casillas (i, j): (0,0) (1,1) (2,2) (3,3) (4,4) (4,5)

Mochila de la semana 7, capacidad 9, como camino más largo: 13
Son los mismos 2 y 13 de la semana 7. El camino se lee como un alineamiento: la diagonal (0,0) → (1,1) empareja las dos
c, la diagonal siguiente cambia a por o, las dos siguientes emparejan s y a, y el último paso inserta la s
final. Costo 2.
Cuando una opción combina varios subproblemas, la solución no es un camino. Veremos en esta semana que multiplicar matrices parte un rango en dos, y la opción suma las dos partes. En un árbol, un nodo suma lo de todos sus hijos. Lo que queda dibujado dentro del DAG es un árbol de subproblemas. Fibonacci tampoco es un camino: no es una decisión entre dos casillas, sino la suma de las dos.
Idea clave. Todo problema de programación dinámica tiene un DAG de subproblemas, y un orden de cálculo es un orden topológico de ese DAG. Pero no todo se reduce a un camino en él. Es un camino solo cuando cada decisión depende de un único subproblema, como en la subsecuencia creciente más larga, en la distancia de edición o en el camino más largo. En intervalos y árboles se combinan varios.
Camino más largo en un DAG
Tenemos un DAG con pesos en las aristas, que pueden ser negativos, y un nodo origen s. Queremos, para cada nodo v, el mayor peso total de un camino de s a v. Piensen en tareas con duraciones y dependencias: el camino más largo hasta una tarea dice cuándo puede empezar, como mínimo, si todo lo anterior va en paralelo.
Un greedy, y qué pasa con los nodos que no se alcanzan
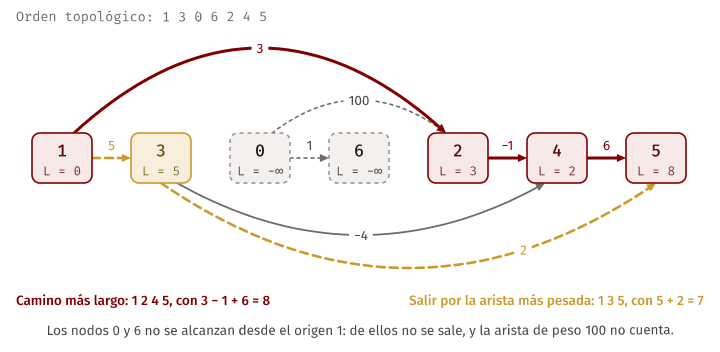
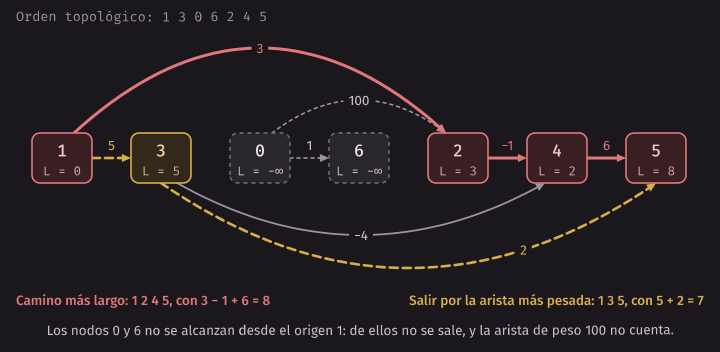
Antes de nada, una idea simple: salir de cada nodo por la arista más pesada. El ejemplo de dag_demo tiene 7 nodos, y
el origen es el nodo 1:
DAG: 0->2(100) 0->6(1) 1->2(3) 1->3(5) 2->4(-1) 3->4(-4) 3->5(2) 4->5(6)
Origen: 1
Orden topológico: 1 3 0 6 2 4 5

nodo   L(v)  pred  todos en 0
   0   -inf     -           0
   1      0    -1           0
   2      3     1         100
   3      5     1           5
   4      2     2          99
   5      8     4         105
   6   -inf     -           1

Camino más largo de 1 a 5: 1 2 4 5, largo 8
Salir por la arista más pesada: 1 3 5, largo 7
Las últimas dos líneas muestran que el greedy falla. Sale hacia el 3 porque esa arista pesa 5, y se pierde el camino por el 2, que pasa por una arista negativa y aun así gana. Como en la semana 7, una arista buena al principio puede cerrar una opción mejor más adelante.
La última columna de la tabla es otro error, y lo vemos en un momento.
Subproblema y recurrencia
Subproblema. L(v) es el mayor peso de un camino de s a v, y es −∞ si no hay ningún camino de s a v. Hay una respuesta para cada v.
Miremos la última arista del camino. Viene de algún nodo u que tiene una arista hacia v:
L(s) = 0
L(v) = máx { L(u) + w(u, v) : u → v es una arista y u se alcanza desde s }    si v ≠ s
L(v) = -∞                                                                     si no hay tal u
Es un máximo entre opciones, y cada opción lee una sola casilla. El grafo de subproblemas de este problema es el propio grafo de entrada.
Teorema. En un DAG, para todo nodo v, el valor que da la recurrencia es el mayor peso de un camino de s a v, y es −∞ exactamente si v no se alcanza desde s.
Técnica. Inducción sobre un orden topológico, que es el orden en que se calcula. Sea OPT(v) lo que dice la frase. Toda arista u → v tiene a u antes que v, así que podemos suponer que la recurrencia ya da OPT(u) para todos los u que lee.
Un hecho previo: en un DAG ningún recorrido repite un nodo, porque si lo repitiera habría un ciclo. Así que todo recorrido que siga las aristas ya es un camino.
Caso v = s. El único camino de s a s es el vacío, con peso 0, porque otro sería un ciclo. Además, ninguna arista u → s viene de un nodo u alcanzable desde s, otra vez porque habría un ciclo. Entonces L(s) = 0 es correcto.
Caso v ≠ s sin caminos desde s. Si algún u con arista u → v fuera alcanzable, v también lo sería. Entonces no hay tal u, y el valor es −∞.
Caso v ≠ s con algún camino desde s. Vamos con las dos direcciones.
(≤) Tomemos un camino de peso máximo de s a v. Como v ≠ s, tiene una última arista u → v. Lo que queda antes es un camino de s a u, de peso a lo sumo OPT(u). Así que el camino pesa a lo sumo OPT(u) + w(u, v), que es una de las opciones de la recurrencia.
(≥) Cada opción se puede conseguir. Si u se alcanza desde s, un camino de peso OPT(u) seguido de la arista u → v es un recorrido de s a v, y por el hecho previo es un camino. Pesa OPT(u) + w(u, v). ∎
Fíjense en lo que la demostración no usa: el signo de los pesos. Con Dijkstra el signo era la clave, porque fijar un nodo suponía que un camino no mejora al alargarse. Aquí, en un DAG, cuando se llega a v ya se revisó todo lo que entra a v. Por eso los pesos negativos no molestan. El camino más corto en un DAG se calcula igual, cambiando máximo por mínimo, o cambiándole el signo a los pesos. Eso último es lo que hicimos con la distancia de edición.
El algoritmo
algoritmo camino_mas_largo(grafo, n, s)
    alcanzado ← arreglo de n valores falso
    L ← arreglo de n ceros
    pred ← arreglo de n valores -1
    alcanzado[s] ← verdadero
    orden ← orden_topologico(grafo, n)
    para t desde 0 hasta n - 1 hacer
        u ← orden[t]
        si alcanzado[u] entonces
            para cada arco (u, v, w) de la lista de u hacer
                si no alcanzado[v] o L[u] + w > L[v] entonces
                    alcanzado[v] ← verdadero
                    L[v] ← L[u] + w
                    pred[v] ← u
                fin si
            fin para
        fin si
    fin para
    devolver L, alcanzado, pred
fin algoritmo
La recurrencia mira las aristas que entran a v, y el programa empuja por las que salen de u. Es lo mismo: cuando el ciclo llega a un nodo, ya pasaron todos los que tienen una arista hacia él, porque el orden es topológico. En ese momento, L[v] ya es el máximo de la recurrencia, y no va a cambiar.
El costo es O(V + E): el orden topológico por DFS cuesta eso, y luego cada arista se mira una vez.
Para recuperar el camino, se sigue pred hacia atrás desde el destino. Si pred[v] = u, se tiene L[v] = L[u] + w(u, v),
así que el recorrido suma exactamente L[v].
Observen en la tabla de arriba que el orden topológico empieza 1 3 0 6 2 4 5, con el nodo 0 después del origen. Es
válido, porque no hay aristas entre el 3 y el 0 en ningún sentido. El programa pasa por el 0 y no hace nada, porque el
0 no está alcanzado.
No alcanzar un nodo no es lo mismo que valer cero
El nodo 0 no se alcanza desde el origen 1, y tiene una arista de peso 100 hacia el nodo 2. Si se inicializa todo en 0 y
se relaja desde todos los nodos, el programa responde otra cosa. Es la columna todos en 0 de la salida: dice 105 para
el nodo 5, mientras lo correcto es 8. Lo que calculó es el camino más largo desde cualquier nodo, que es un problema
válido pero distinto.
Error común. Usar un número como
-1o0para decir “no se alcanza”, o sumarle a un “menos infinito”. Con 0, un nodo sin alcanzar se trata como si fuera otro origen. ConLLONG_MINy un peso negativo, la suma se pasa del rango del tipo: es overflow, y además es comportamiento indefinido. La solución delongest_pathses un arreglo aparte que dice si el nodo se alcanzó, y no salir nunca de un nodo sin alcanzar.
En la práctica. Sin la condición de DAG, este problema cambia por completo. Si hay un ciclo de peso positivo, un recorrido se puede alargar sin límite, y si se piden caminos sin nodos repetidos, ya no queda un orden en que calcular: L(u) lee a L(v), y L(v) lee a L(u). Sin DAG, el camino más largo es un problema difícil, y volverá en la semana 14.
Subsecuencia creciente más larga
Dado un arreglo a de n enteros, queremos una subsecuencia creciente más larga (longest increasing subsequence, LIS). Subsecuencia es lo de la semana 7: se borran elementos y los demás conservan su orden. Creciente significa aquí estrictamente creciente: a[p₁] < a[p₂] < ⋯ < a[pₖ], con p₁ < p₂ < ⋯ < pₖ. Más abajo vemos qué cambia si se permiten iguales.
La salida de lis_demo empieza con un arreglo que usamos en toda la sección:
$ build/lis_demo
Arreglo: 3 1 4 1 5 9 2 6
Primero, un greedy: recorrer el arreglo y tomar todo lo que sea mayor que lo último que se tomó. Esta es otra parte de la salida:
Tomar todo lo que sea mayor que lo último tomado
  5 1 2 3: greedy 1, óptimo 3
  1 7 2 3 4: greedy 2, óptimo 4
En 5 1 2 3, el greedy toma el 5 y ya nada le sirve. Podría parecer que basta empezar por un número pequeño, pero en
1 7 2 3 4 empieza bien, toma el 7 y queda otra vez bloqueado. Un elemento grande tomado temprano cierra el camino.
Paso 1: un subproblema que sabe dónde termina
La primera idea es copiar la semana 7: “lo mejor con los primeros i elementos”. Para agregar a[i] necesitamos saber en qué valor termina esa subsecuencia, y la frase no lo dice. Es el error de la mochila sin capacidad: al subproblema le falta información. Aquí la solución es decir dónde termina.
Subproblema. E(i) es el largo de la subsecuencia creciente más larga que termina justo en la posición i. La respuesta es el máximo de E(i) para todo i, no E(n − 1), porque la mejor no tiene por qué terminar en el último elemento.
Paso 2: la recurrencia
Miremos el elemento anterior al último:
E(i) = 1 + máx { E(j) : j < i y a[j] < a[i] }
E(i) = 1                                        si no hay tal j
Teorema. E(i) dada por la recurrencia es el largo que dice la frase, para todo i.
Técnica. Inducción sobre i. Sea OPT(i) el largo de la más larga que termina justo en i, y supongamos que la recurrencia da OPT(j) para todo j < i.
(≤) Tomemos una subsecuencia creciente z que termina en i. Si tiene largo 1, ya está. Si no, su penúltimo elemento está en una posición j < i, con a[j] < a[i]. Quitándole el último queda una subsecuencia creciente que termina justo en j, de largo a lo sumo OPT(j). Así que |z| ≤ OPT(j) + 1, que es una de las opciones.
(≥) Si j < i y a[j] < a[i], a una subsecuencia que termina justo en j, de largo OPT(j), se le puede agregar a[i]: va después en posición y es mayor que su último valor. Sigue siendo creciente. Por lo tanto, OPT(i) ≥ OPT(j) + 1. El largo 1 siempre se puede conseguir con a[i] solo. ∎
El grafo de subproblemas tiene una arista j → i por cada j < i con a[j] < a[i]. Cada opción lee una sola casilla. Por
eso es un camino más largo en ese DAG. Las pruebas lo comprueban: con un origen que da a todos los nodos y aristas de
peso 1, longest_paths da siempre el mismo número.
Paso 3: orden y costo
E(i) solo lee índices menores, así que se llena de izquierda a derecha.
algoritmo lis_cuadratico(a, n)
    E ← arreglo de n unos
    pred ← arreglo de n valores -1
    para i desde 0 hasta n - 1 hacer
        para j desde 0 hasta i - 1 hacer
            si a[j] < a[i] y E[j] + 1 > E[i] entonces
                E[i] ← E[j] + 1
                pred[i] ← j
            fin si
        fin para
    fin para
    devolver E, pred
fin algoritmo
Son n(n − 1)/2 comparaciones: Θ(n²).
La tabla cuadrática
   i:  0  1  2  3  4  5  6  7
a[i]:  3  1  4  1  5  9  2  6
E[i]:  1  1  2  1  3  4  2  4
pred: -1 -1  0 -1  2  4  1  4
Largo: 4
Con pred, desde la primera casilla con ese largo: 3 4 5 9
Paso 4: reconstruir
pred[i] guarda de dónde vino el mejor valor. Se empieza en una posición con E máximo y se camina hacia atrás. Desde la
posición 5, que tiene el 9: pred[5] = 4, que tiene el 5; pred[4] = 2, que tiene el 4; pred[2] = 0, que tiene el 3. Al
revés: 3 4 5 9. La otra posición con E = 4, la 7, da 3 4 5 6. Hay más de una respuesta.
Mejorar a O(n log n): el arreglo de finales
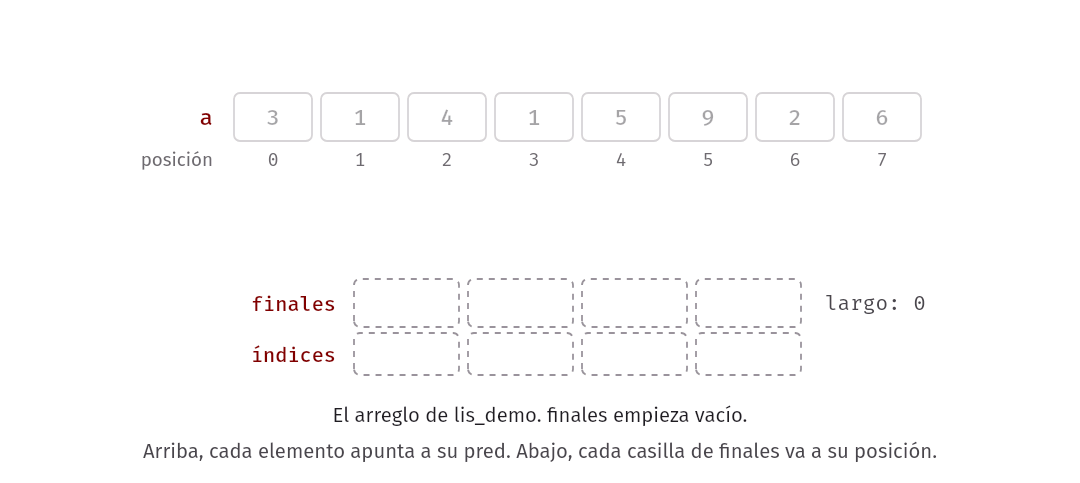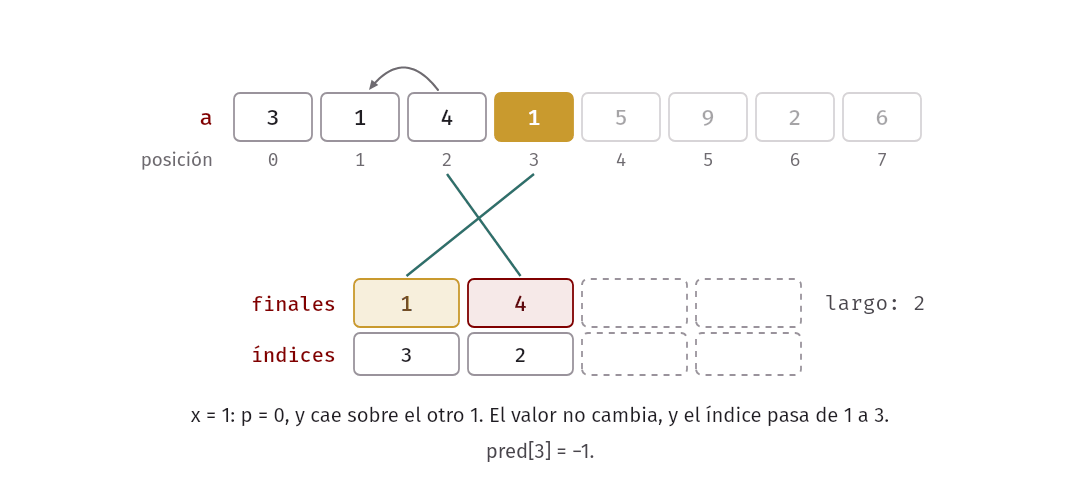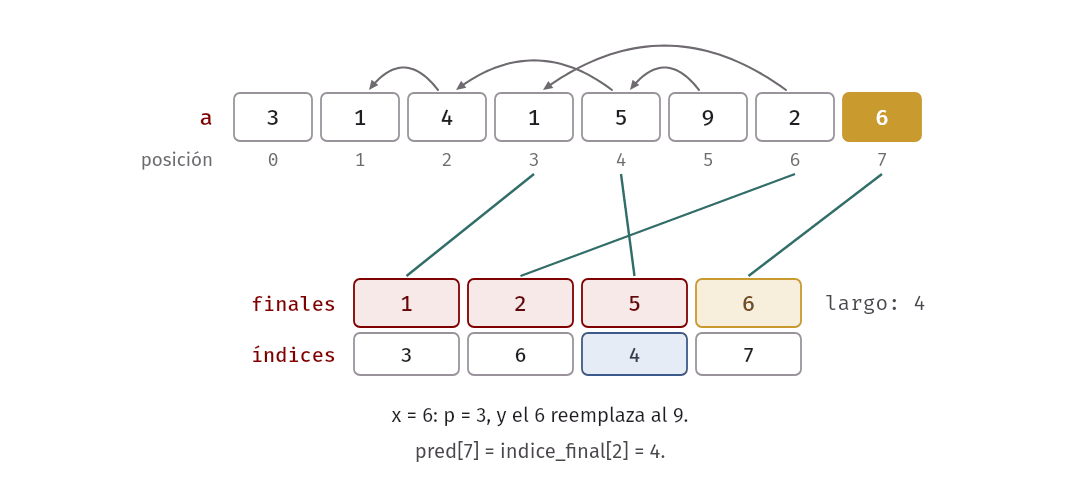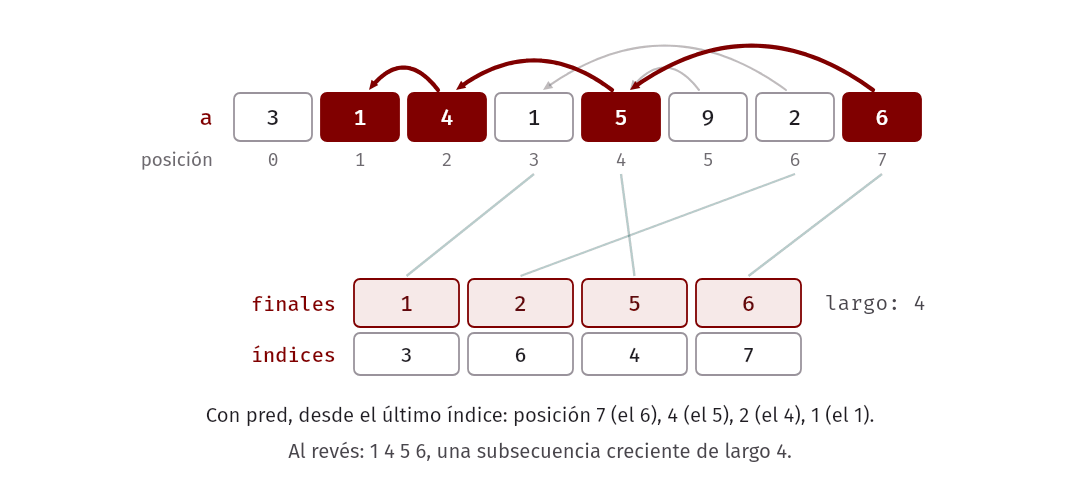
Con n = 10⁶, Θ(n²) es demasiado. Para mejorarlo, miremos qué información de la tabla se usa de verdad. Al procesar a[i] preguntamos: ¿cuál es la subsecuencia más larga que puedo extender con a[i]? Entre dos subsecuencias del mismo largo, solo importa la que termina en el valor más pequeño, porque esa se puede extender con todo lo que se pueda extender la otra. Entonces, por cada largo, basta recordar un número.
Definición. Para el prefijo a[0..i), finales[k] es el menor último valor posible de una subsecuencia creciente de largo k + 1 dentro del prefijo. Está definido para k desde 0 hasta el largo de la LIS del prefijo, menos 1.
Un hecho que sale directo de la definición: finales es estrictamente creciente. Tomemos la subsecuencia de largo k + 2 que termina en finales[k + 1]. Su penúltimo elemento es menor que finales[k + 1], y es el último de una subsecuencia de largo k + 1. Por lo tanto finales[k] ≤ penúltimo < finales[k + 1].
Como es un arreglo ordenado, se puede usar búsqueda binaria.
algoritmo lis_rapido(a, n)
    finales ← lista vacía
    para i desde 0 hasta n - 1 hacer
        p ← primera posición de finales con finales[p] ≥ a[i], o su largo si no hay
        si p = largo de finales entonces
            agregar a[i] al final de finales
        sino
            finales[p] ← a[i]
        fin si
    fin para
    devolver largo de finales
fin algoritmo
Afirmación. Después de procesar a[i], el arreglo cumple la definición para el prefijo a[0..i + 1). Por lo tanto, al terminar, su largo es el de la LIS de todo el arreglo.
Técnica. Un invariante de ciclo. Antes de la primera vuelta el prefijo está vacío y el arreglo también.
Supongamos que vale para a[0..i), y llamemos x = a[i] y p a la posición que halla la búsqueda. Las subsecuencias nuevas son las que terminan en x, porque las demás ya estaban. Primero veamos de qué largos existen. Una de largo ℓ + 1, con ℓ ≥ 1, es una de largo ℓ del prefijo cuyo último valor es menor que x, más x. Esa existe si y solo si la casilla finales[ℓ − 1] existe y es menor que x, es decir, si ℓ − 1 < p, porque p es la primera posición con finales[p] ≥ x y el arreglo está ordenado. Junto con la de largo 1, x solo, las nuevas tienen exactamente los largos de 1 a p + 1.
Ahora veamos cada casilla k, es decir, el largo k + 1:
- k < p. Aquí finales[k] < x. Hay subsecuencias nuevas de ese largo, pero terminan en x, que es mayor. El mínimo no cambia, y el algoritmo no toca esa casilla.
- k = p. Hay una subsecuencia nueva de largo p + 1, que termina en x. Si p ya era una posición del arreglo, el mínimo anterior era finales[p] ≥ x, así que el mínimo nuevo es x. Si p era el largo del arreglo, ese largo no existía, y ahora existe con último valor x. En los dos casos, finales[p] pasa a ser x, que es lo que hace el algoritmo.
- k > p. No hay subsecuencias nuevas de ese largo, porque los largos llegan hasta p + 1. No cambia, y el algoritmo no la toca.
Así que la definición vale para a[0..i + 1). ∎
Cada vuelta es una búsqueda binaria, y el costo es O(n log n).
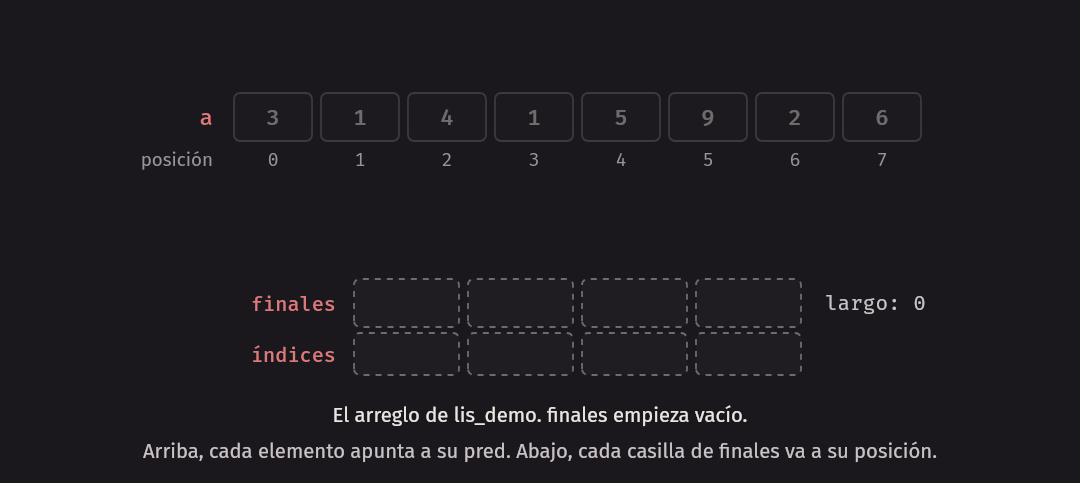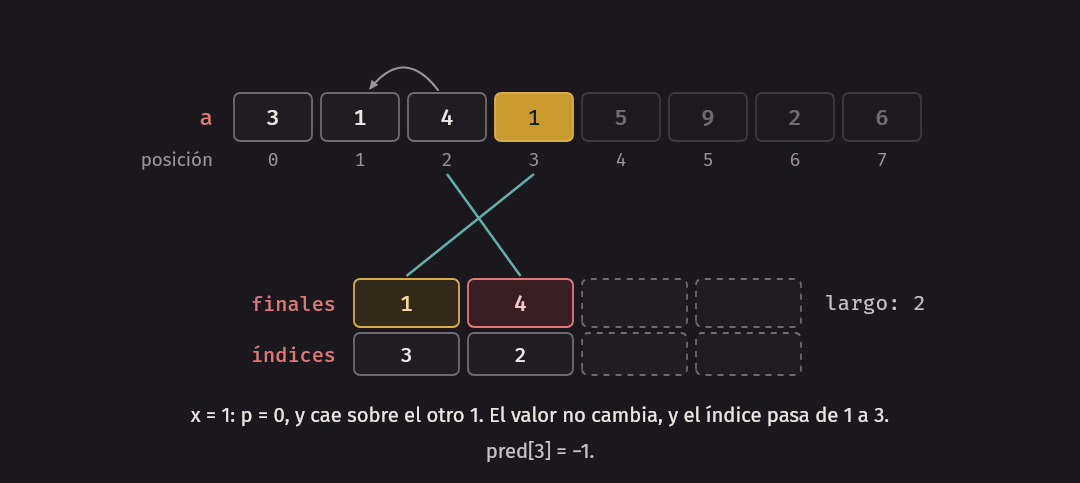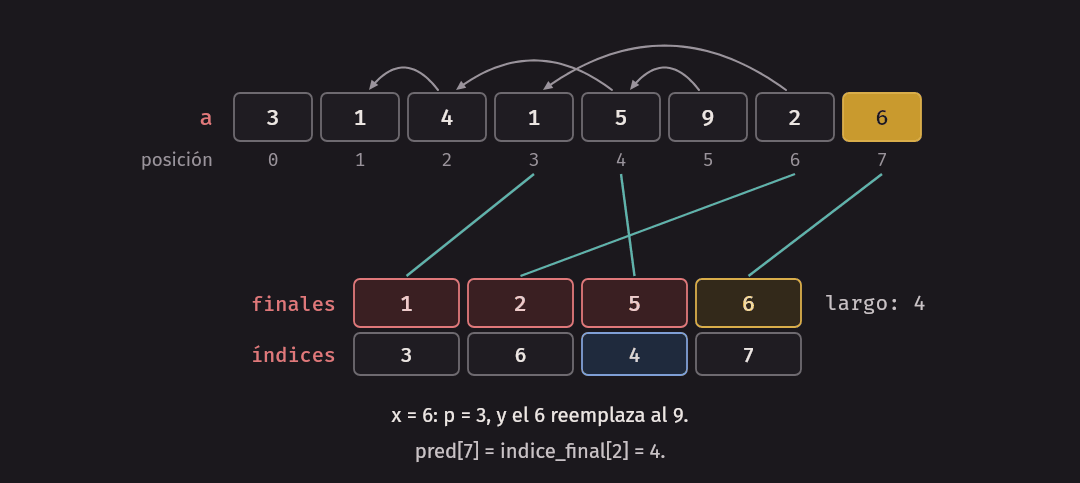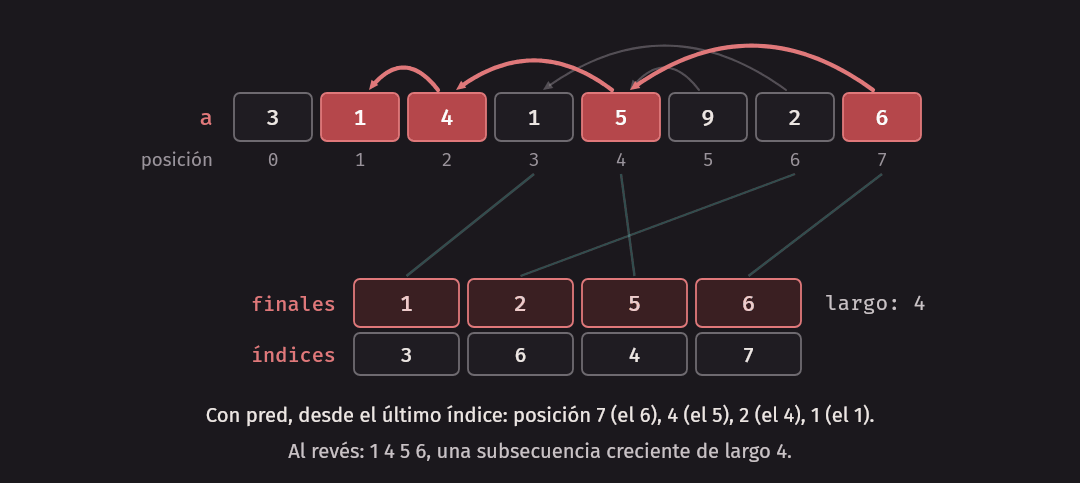
Este es el recorrido. Las dos últimas columnas sirven para reconstruir, y las vemos enseguida:
El arreglo de finales, con lower_bound
 i  x  posición  finales después        índices    pred[i]
 0  3         0  3                      0            -1
 1  1         0  1                      1            -1
 2  4         1  1 4                    1 2           1
 3  1         0  1 4                    3 2          -1
 4  5         2  1 4 5                  3 2 4         2
 5  9         3  1 4 5 9                3 2 4 5       4
 6  2         1  1 2 5 9                3 6 4 5       3
 7  6         3  1 2 5 6                3 6 4 7       4
Largo: 4
Reconstruida: 1 4 5 6
Veamos la fila i = 3. El segundo 1 cae en la posición 0, donde ya hay un 1: no cambia nada en los valores. Si se buscara el primer mayor, caería en la posición 1, reemplazaría al 4 y daría una subsecuencia 1 1, que no es creciente. Y en la fila i = 6, el 2 reemplaza al 4: la mejor subsecuencia de largo 2 ahora termina en 2 (1 2), y eso le sirve a cualquier valor que venga, más que terminar en 4.
En C++.
std::lower_boundda el primer elemento mayor o igual, que es la búsqueda de arriba.std::upper_boundda el primer elemento mayor. En la semana 7, por los intervalos semiabiertos, correspondíaupper_bound. Aquí, por ser estrictamente creciente, correspondelower_bound:inline std::size_t lis_length_tails(const std::vector<int>& a) { std::vector<int> tails; for (int x : a) { const auto it = std::lower_bound(tails.begin(), tails.end(), x); if (it == tails.end()) { tails.push_back(x); } else { *it = x; } } return tails.size(); }
Error común. Cambiar una búsqueda por la otra, o no decidir qué se pide. Con
upper_bound, el programa resuelve otro problema: la subsecuencia más larga que no decrece. No falla ni da señales:lower_bound y upper_bound 2 2 2: con lower_bound 1, con upper_bound 3 1 3 3 5: con lower_bound 3, con upper_bound 4Los dos son correctos, cada uno para su problema. Las pruebas comparan cada uno con su propia fuerza bruta.
El arreglo de finales no es una subsecuencia
Es tentador imprimir el arreglo al terminar y decir que esa es la respuesta. Esta es otra parte de lis_demo:
Los finales no son una subsecuencia
  arreglo: 2 5 3 7 1
  finales: 1 3 7
  reconstruida: 2 3 7
El largo, 3, es correcto. Pero en el arreglo el 1 está después del 3 y del 7, así que 1 3 7 no es una subsecuencia.
Cada casilla habla de una subsecuencia distinta: el 1 es el final de la de largo 1, el 3 es el final de 2 3, y el 7 es
el final de 2 3 7. No hay ninguna promesa de que juntas formen una.
Idea clave. finales[k] es un dato sobre todas las subsecuencias de largo k + 1, y no un pedazo de una sola. Lo único que el arreglo de finales entrega directamente es el largo.
Reconstruir
Para reconstruir hace falta guardar índices en lugar de valores: indice_final[k] es la posición en a del valor finales[k]. Cuando a[i] entra en la posición p, se anota de quién extiende: pred[i] ← indice_final[p − 1]. Ese es exactamente el último elemento de la mejor subsecuencia de largo p en ese momento.
algoritmo lis_con_lista(a, n)
    finales ← lista vacía
    indice_final ← lista vacía
    pred ← arreglo de n valores -1
    para i desde 0 hasta n - 1 hacer
        p ← primera posición de finales con finales[p] ≥ a[i], o su largo si no hay
        si p > 0 entonces
            pred[i] ← indice_final[p - 1]
        fin si
        si p = largo de finales entonces
            agregar a[i] al final de finales
            agregar i al final de indice_final
        sino
            finales[p] ← a[i]
            indice_final[p] ← i
        fin si
    fin para
    recorrer pred desde el último de indice_final, y devolver la lista al revés
fin algoritmo
Afirmación. Si a[i] entra en la posición p, la cadena i, pred[i], pred[pred[i]], … tiene p + 1 elementos, con posiciones decrecientes y valores decrecientes.
Técnica. Inducción sobre i. Si p = 0, pred[i] = −1, y la cadena tiene 1 elemento. Si p > 0, sea j = pred[i] = indice_final[p − 1]. Se tiene j < i, porque entró antes, y a[j] = finales[p − 1] < a[i], por ser p la primera posición con finales[p] ≥ a[i]. Además, a[j] entró en la posición p − 1, porque cada índice solo se escribe en la casilla en que entra. Por hipótesis, la cadena desde j tiene p elementos, así que la de i tiene p + 1. ∎
Al terminar, el último de indice_final entró en la última posición, así que su cadena tiene el largo de la LIS. En la
tabla: el 6 de la posición 7 tiene pred 4 (el 5), que tiene pred 2 (el 4), que tiene pred 1 (el 1). Da 1 4 5 6, aunque
la columna de índices al final dice 3 6 4 7, que no es lo mismo. Las pruebas comprueban la reconstrucción en 3000
arreglos al azar, y comprueban el invariante de tails contra su definición, casilla por casilla.
Midiendo
lis_bench compara las dos versiones, con valores al azar. Se compila con -O2 y se toma el menor de 3 intentos. Es
una corrida en el contenedor del curso, con la máquina compartida, y los tiempos dependen de la máquina.
$ make bench
build/lis_bench
Subsecuencia creciente más larga, valores al azar, menor de 3 intentos
        n   largo   tabla ms   finales ms
    10000     196      203.7          0.4
    20000     270      837.9          0.8
    40000     384     3309.8          2.1
    80000     544    11331.4          4.8
  1000000    1983          -         47.5
  2000000    2819          -        109.1
  4000000    3983          -        217.6
Al duplicar n, la tabla cuesta cerca de 4 veces más en las dos primeras duplicaciones, y 3,4 veces en la tercera. No investigamos esa última diferencia, y una sola corrida en una máquina compartida no alcanza para explicarla. Lo que sí es claro es la distancia: con 80 000 elementos, una tarda más de 11 segundos, y la otra menos de 5 milisegundos.
Intervalos: multiplicar una cadena de matrices
Hasta ahora, el subproblema era un prefijo o un nodo. Ahora va a ser un rango i..j.
Para multiplicar una matriz de p × q por una de q × r, el método usual hace p·q·r multiplicaciones de números. El producto de matrices es asociativo: (AB)C y A(BC) dan el mismo resultado. Pero no cuestan lo mismo. Tenemos n matrices A₀, A₁, …, Aₙ₋₁, donde la matriz Aᵢ mide d[i] × d[i + 1]. Por eso bastan n + 1 números. Queremos decidir en qué orden multiplicar para hacer el mínimo de multiplicaciones de números.
Este es el ejemplo más pequeño, con matrices de 10 × 30, 30 × 5 y 5 × 60. Es la salida de chain_demo:
$ build/chain_demo
Matrices: 10x30, 30x5, 5x60
  i\j       0       1       2
    0       0    1500    4500
    1       .       0    9000
    2       .       .       0
Mínimo: 4500, con ((A0 A1) A2)
  (A0 A1) A2: 4500
  A0 (A1 A2): 27000
Si se multiplica primero A₀A₁, cuesta 10·30·5 = 1500 y queda una matriz de 10 × 5. Luego, 10·5·60 = 3000. En total, 4500. En el otro orden, A₁A₂ cuesta 30·5·60 = 9000 y queda una de 30 × 60. Luego, 10·30·60 = 18 000. En total, 27 000. Es seis veces más, para el mismo resultado.
¿Cuántas formas hay? Tantas como árboles binarios: con n matrices, el número de Catalan C(n − 1). Con 20 matrices son 1 767 263 190. Las pruebas cuentan las parentizaciones hasta n = 9 y comprueban que coinciden con esa fórmula. Probarlas todas no es una opción.
Un greedy que falla
¿Por qué no hacer siempre primero la multiplicación vecina más barata?
Primero la multiplicación más barata
  matrices: 4x1, 1x3, 3x5
  greedy: 72, óptimo por fuerza bruta: 35
A₀A₁ cuesta 4·1·3 = 12, y A₁A₂ cuesta 1·3·5 = 15. El greedy toma la de 12, y queda una de 4 × 3 que multiplicar por una de 3 × 5: 60 más. Total, 72. Si se hace primero la de 15, queda una de 1 × 5, y lo que falta cuesta 4·1·5 = 20. Total, 35. El problema es que lo barato de ahora deja dimensiones grandes para después. El número 1 de en medio es lo valioso: la multiplicación que lo elimina debería ser la última.
Paso 1: el subproblema
Pensemos en la última multiplicación que se hace. Parte la cadena en dos: todo lo de la izquierda ya está multiplicado, y todo lo de la derecha, también. Esos dos pedazos son contiguos, y son más cortos.
Subproblema. M(i, j) es el mínimo de multiplicaciones de números para calcular el producto Aᵢ ⋯ Aⱼ, para i ≤ j, con las dos puntas incluidas. La respuesta es M(0, n − 1).
Paso 2: la recurrencia
Si la última multiplicación separa a Aₖ de Aₖ₊₁, con i ≤ k < j, la izquierda queda de d[i] × d[k + 1], y la derecha, de d[k + 1] × d[j + 1]:
M(i, i) = 0
M(i, j) = mín { M(i, k) + M(k + 1, j) + d[i]·d[k + 1]·d[j + 1] : i ≤ k < j }     para i < j
Aquí cada opción lee dos casillas, y las suma. No es un camino en el DAG, sino un árbol. Pero sigue siendo un DAG, y la demostración es la misma.
Teorema. M(i, j) dada por la recurrencia es el mínimo de multiplicaciones de números para calcular Aᵢ ⋯ Aⱼ.
Técnica. Inducción sobre el largo j − i + 1. Sea OPT(i, j) lo que dice la frase.
Caso base. Con una sola matriz, no hay nada que multiplicar: cuesta 0.
Paso. Sea i < j, y supongamos que vale para todos los rangos más cortos. Fijémonos en que el costo de multiplicar dos resultados solo depende de sus dimensiones, y estas no dependen de cómo se calcularon: un producto de Aᵢ a Aₖ siempre mide d[i] × d[k + 1].
(≥) Tomemos cualquier forma de calcular Aᵢ ⋯ Aⱼ, y sea k el punto donde se parte en su última multiplicación. Lo anterior calcula por separado Aᵢ ⋯ Aₖ y Aₖ₊₁ ⋯ Aⱼ, sin mezclarlos. Esas dos partes cuestan al menos OPT(i, k) y OPT(k + 1, j), y la última cuesta d[i]·d[k + 1]·d[j + 1]. Así que esa forma cuesta al menos la opción k de la recurrencia. Como eso vale para cualquier forma, OPT(i, j) es al menos el mínimo de la recurrencia.
(≤) Para cada k, se puede calcular cada parte con su mejor forma y multiplicar al final. Esa forma cuesta exactamente la opción k. Entonces OPT(i, j) no es mayor que ninguna de las opciones. ∎
Como estamos minimizando, las direcciones están invertidas respecto de los ejemplos de maximización: ver la receta de la semana 7.
Paso 3: el orden
Calcular M(i, j) lee las casillas M(i, k) y M(k + 1, j). Todas esas son rangos más cortos. Por eso se llena por largo creciente: primero todos los rangos de largo 1, después los de largo 2, y así.
algoritmo cadena_de_matrices(d, n)
    M ← matriz de n por n, toda en cero
    corte ← matriz de n por n
    para largo desde 2 hasta n hacer
        para i desde 0 hasta n - largo hacer
            j ← i + largo - 1
            M[i][j] ← ∞
            para k desde i hasta j - 1 hacer
                costo ← M[i][k] + M[k + 1][j] + d[i]·d[k + 1]·d[j + 1]
                si costo < M[i][j] entonces
                    M[i][j] ← costo
                    corte[i][j] ← k
                fin si
            fin para
        fin para
    fin para
    devolver M[0][n - 1], corte
fin algoritmo
Este es un ejemplo con cuatro matrices:
Matrices: 10x20, 20x5, 5x30, 30x2
  i\j       0       1       2       3
    0       0    1000    2500     900
    1       .       0    3000     500
    2       .       .       0     300
    3       .       .       .       0
Mínimo: 900, con (A0 (A1 (A2 A3)))
Por fuerza bruta: 900
La tabla se llena por diagonales, empezando por la principal, que es el largo 1. Calculemos la esquina, M(0, 3):
| k | M(0, k) | M(k + 1, 3) | d[0]·d[k + 1]·d[4] | Total |
|---|---|---|---|---|
| 0 | 0 | 500 | 10·20·2 = 400 | 900 |
| 1 | 1000 | 300 | 10·5·2 = 100 | 1400 |
| 2 | 2500 | 0 | 10·30·2 = 600 | 3100 |
Gana k = 0. Fíjense en que la última dimensión, 2, es muy pequeña: conviene arrastrar ese 2 desde la derecha.
Reconstruir. La tabla corte dice dónde partir. Se empieza en corte[0][n − 1], y se sigue por los dos lados:
algoritmo parentizar(corte, i, j)
    si i = j entonces
        devolver "A" seguido de i
    fin si
    k ← corte[i][j]
    devolver "(" + parentizar(corte, i, k) + " " + parentizar(corte, k + 1, j) + ")"
fin algoritmo
Como una casilla lee dos, la reconstrucción no es un camino hacia atrás: es una recursión que abre dos ramas.
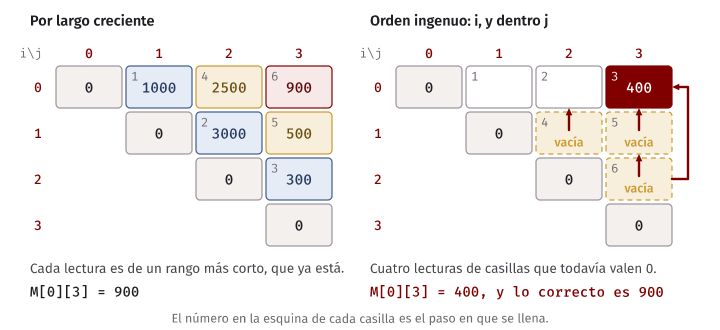
Por qué el orden i, j ingenuo lee casillas sin llenar
Lo primero que uno escribe es esto: i de menor a mayor, y dentro j de menor a mayor. Es el orden de todas las tablas
de la semana 7. Corramos ese orden, en una tabla en ceros, llevando la cuenta de cada lectura de una casilla que todavía
no se ha llenado:
Orden ingenuo: i de menor a mayor, j de menor a mayor, con la tabla en ceros
  10x30, 30x5, 5x60
    M[0][2] lee M[1][2], vacía
    lecturas vacías: 1, respuesta: 4500, correcta: 4500
  10x20, 20x5, 5x30, 30x2
    M[0][2] lee M[1][2], vacía
    M[0][3] lee M[1][3], vacía
    M[0][3] lee M[2][3], vacía
    M[1][3] lee M[2][3], vacía
    lecturas vacías: 4, respuesta: 400, correcta: 900
Con i = 0, para calcular M[0][2] hace falta M[1][2], que tiene i = 1 y se va a llenar después. El programa la lee igual: vale 0. No se cae, no hay advertencia y no hay nada fuera del arreglo.
En el primer ejemplo sale 4500 por suerte. La lectura vacía entra en la opción k = 0, que da 18 000 con el cero, y aun así pierde contra k = 1, que no lee nada vacío. En el segundo ejemplo da 400, menos de la mitad de lo correcto. En M[0][3], la opción k = 0 lee M[1][3] como 0, y queda en 0 + 0 + 400. Esa opción cuenta gratis el producto A₁A₂A₃, que en realidad cuesta 500.
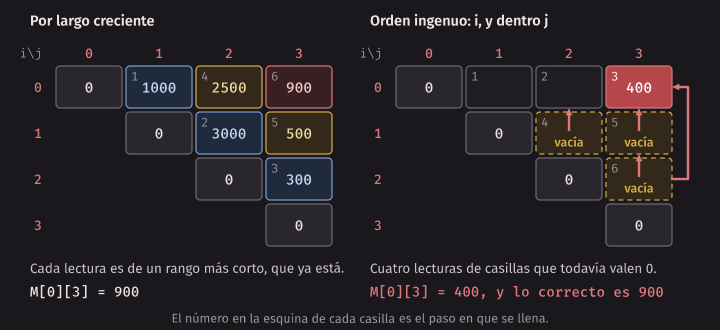
Error común. Usar un orden de cálculo que lee una casilla antes de llenarla. Es de los errores más traicioneros, porque el programa da un número razonable, y a veces hasta correcto en el primer ejemplo que prueban. Antes de escribir los ciclos, hagan esta pregunta: para calcular esta casilla, ¿cuáles lee, y ya están? Si no pueden responderla, dibujen el DAG de una instancia pequeña.
¿Hay que llenar por largo, entonces? No necesariamente. Lo que hace falta es un orden topológico del DAG, y hay
varios. El de largo creciente es el más fácil de justificar: todo lo que se lee es más corto. Otro que sirve es i de
mayor a menor y j de menor a mayor. La casilla (i, j) lee (i, k), con la misma i y una j menor, que ya se llenó
en esta fila, y (k + 1, j), con una i mayor, que es una fila anterior. La misma salida lo confirma:
Otro orden válido, i de mayor a menor y j de menor a mayor: 900Y la memoización no necesita elegir nada, porque la recursión descubre el orden sola. A cambio, paga las llamadas y la pila.
Costo
Hay Θ(n²) casillas, y cada una prueba hasta n valores de k. La cuenta exacta de combinaciones (i, k, j) es (n³ − n)/6, y las pruebas la comprueban para n de 1 a 30. Con n = 10 son 165:
Con n = 10 matrices, combinaciones (i, k, j) probadas: 165El costo es Θ(n³) en tiempo y Θ(n²) en memoria. Esta es la medición, en el contenedor del curso, con -O2,
menor de 3 intentos, con la máquina compartida. Los tiempos dependen de la máquina.
build/chain_bench
Cadena de matrices, dimensiones al azar entre 1 y 50, menor de 3 intentos
    n   combinaciones        ms
  200         1333300       2.0
  400        10666600      14.3   x7.0
  800        85333200     126.7   x8.9
 1600       682666400    1153.4   x9.1
Al duplicar n, las combinaciones se multiplican casi exactamente por 8. El tiempo se multiplica por algo entre 7 y 9,1. Con estas cuatro corridas no podemos decir más que eso. El costo de cada casilla depende también de la memoria y de la carga de la máquina, y aquí no lo medimos por separado.
En C++. Las dimensiones caben en un
int, pero sus productos no: tres dimensiones de 2000 ya dan 8 × 10⁹. Todo va enlong long.
Árboles binarios de búsqueda óptimos
La misma estructura aparece con otra historia. Tenemos n claves ordenadas, k₀ < k₁ < ⋯ < kₙ₋₁, que no van a cambiar, y sabemos con qué frecuencia se busca cada una: f₀, f₁, …, fₙ₋₁, con fᵢ ≥ 0. En Estructuras de Datos armaron árboles balanceados para que el peor caso sea logarítmico. Pero si sabemos que una clave se busca casi siempre, conviene que esté cerca de la raíz, aunque el árbol quede desbalanceado.
Definición del costo. La profundidad de un nodo es la cantidad de nodos del camino desde la raíz hasta él, así que la raíz tiene profundidad 1. Es la cantidad de nodos que se visitan al buscarlo. El costo de un árbol es
costo(T) = Σ fᵢ · profundidad(kᵢ)Solo contamos búsquedas exitosas: todas las búsquedas son de claves que están. Si también se quiere contar búsquedas de claves que no están, se agregan frecuencias para los huecos entre claves. Es la versión que plantea CLRS, y la idea es la misma. Aquí no la vemos.
Queremos un árbol binario de búsqueda con esas claves y con el mínimo costo: un árbol binario de búsqueda óptimo (optimal binary search tree).
Los greedy que fallan
Hay dos ideas naturales: poner la clave más frecuente en la raíz, y lo mismo en cada lado, o hacer un árbol balanceado.
Esta es la salida de bst_demo, con cuatro claves:
$ build/bst_demo
Claves y frecuencias: A=2 B=1 C=3 D=4
  C[i][j], rango [i, j)
  i\j    0    1    2    3    4
    0    0    2    4   10   18
    1    .    0    1    5   13
    2    .    .    0    3   10
    3    .    .    .    0    4
    4    .    .    .    .    0
  raíz[i][j]
  i\j    1    2    3    4
    0    A    A    C    C
    1    .    B    C    C
    2    .    .    C    D
    3    .    .    .    D
  árbol: C(A(- B) D)
  profundidades: A=2 B=3 C=1 D=2
  costo con la definición: 18
  por fuerza bruta: 18
  la más frecuente a la raíz: 20
  balanceado: 19
Las dos ideas fallan: dan 20 y 19 cuando se puede tener 18. Poner D en la raíz manda a las tres claves restantes un nivel más abajo, y juntas pesan más que D. El árbol balanceado ignora las frecuencias. Aquí pone a A debajo de B, aunque A se busca el doble que B.
También fallaría Huffman. Se parece a primera vista: frecuencias, y un árbol con profundidades. Pero en Huffman los símbolos pueden quedar en cualquier orden, y aquí no: un árbol de búsqueda tiene que respetar el orden de las claves. Por eso no se pueden juntar sin más los dos menos frecuentes, y hay que probar raíces.
Subproblema y recurrencia
En un árbol binario de búsqueda, un subárbol siempre contiene un rango contiguo de claves: las que caen entre dos ancestros. Si la raíz es kᵣ, a la izquierda van exactamente las claves menores que kᵣ, y a la derecha, las mayores. Aquí un rango puede estar vacío, porque un lado puede no tener nada. Por eso conviene usar rangos semiabiertos, como en la semana 4.
Subproblema. C(i, j) es el mínimo costo de un árbol binario de búsqueda con las claves kᵢ, …, kⱼ₋₁, es decir, el rango [i, j). La respuesta es C(0, n).
Sea F(i, j) = fᵢ + ⋯ + fⱼ₋₁, la suma de las frecuencias del rango.
C(i, i) = 0
C(i, j) = F(i, j) + mín { C(i, r) + C(r + 1, j) : i ≤ r < j }     para i < j
¿De dónde sale el F(i, j)? Esa es la pregunta importante.
Lema. Sea T un árbol con claves del rango [i, j), con raíz kᵣ, subárbol izquierdo L y subárbol derecho R. Entonces
costo(T) = costo(L) + costo(R) + F(i, j).
Técnica. Contar la contribución de cada clave. Cada clave de L tiene en T una profundidad igual a su profundidad en L más 1, porque ahora hay un nodo más encima. Así que contribuye fₓ·(profundidad en L) + fₓ. Lo mismo con las claves de R. La raíz contribuye fᵣ·1. Sumando: las primeras partes dan costo(L) y costo(R), y las segundas partes, junto con la raíz, dan fₓ una vez por cada clave del rango, es decir, F(i, j). ∎
Dicho de otra forma: colgar un árbol de una raíz le suma un nivel a todo lo que hay debajo, y cada nivel cuesta una vez la frecuencia. No importa qué raíz se elija: F(i, j) es el mismo. Lo único que cambia es qué dos subárboles quedan.
Teorema. C(i, j) dada por la recurrencia es el mínimo costo de un árbol con las claves del rango [i, j).
Técnica. Inducción sobre el largo j − i, usando el lema. Sea OPT(i, j) lo que dice la frase.
Caso base. El árbol vacío cuesta 0.
Paso. Sea i < j, y supongamos que vale para los rangos más cortos.
(≥) Tomemos cualquier árbol T con esas claves, con raíz kᵣ. Su lado izquierdo es un árbol de búsqueda con el rango [i, r), y su lado derecho, con [r + 1, j). Por el lema, su costo es costo(L) + costo(R) + F(i, j), que es al menos OPT(i, r) + OPT(r + 1, j) + F(i, j). Así que es al menos el valor de la recurrencia.
(≤) Para cada r, se arma un árbol con raíz kᵣ y con los mejores árboles de los dos rangos. Es un árbol de búsqueda válido, porque todo lo de la izquierda es menor que kᵣ y todo lo de la derecha, mayor. Por el lema, cuesta exactamente esa opción. ∎
Orden, costo y ejemplo
Es la misma forma de la cadena de matrices: cada casilla lee rangos más cortos, y se llena por largo creciente.
algoritmo abb_optimo(f, n)
    suma ← arreglo de n + 1 ceros
    para i desde 0 hasta n - 1 hacer
        suma[i + 1] ← suma[i] + f[i]
    fin para
    C ← matriz de (n + 1) por (n + 1), toda en cero
    raiz ← matriz de (n + 1) por (n + 1)
    para largo desde 1 hasta n hacer
        para i desde 0 hasta n - largo hacer
            j ← i + largo
            mejor ← ∞
            para r desde i hasta j - 1 hacer
                si C[i][r] + C[r + 1][j] < mejor entonces
                    mejor ← C[i][r] + C[r + 1][j]
                    raiz[i][j] ← r
                fin si
            fin para
            C[i][j] ← mejor + suma[j] - suma[i]
        fin para
    fin para
    devolver C[0][n], raiz
fin algoritmo
Con sumas acumuladas, F(i, j) = suma[j] − suma[i] cuesta O(1). Son Θ(n²) casillas, y cada una prueba hasta n raíces: Θ(n³) en tiempo y Θ(n²) en memoria. Existe una mejora a O(n²), de Knuth, que se apoya en una propiedad de las raíces óptimas. No la vemos.
Calculemos la casilla C(0, 4), de la salida de arriba. F(0, 4) = 2 + 1 + 3 + 4 = 10.
| r | Raíz | C(0, r) | C(r + 1, 4) | Suma |
|---|---|---|---|---|
| 0 | A | 0 | 13 | 13 |
| 1 | B | 2 | 10 | 12 |
| 2 | C | 4 | 4 | 8 |
| 3 | D | 10 | 0 | 10 |
El mínimo es 8, con raíz C, así que C(0, 4) = 8 + 10 = 18. Para reconstruir, se siguen las raíces: raiz[0][4] es C, a la
izquierda queda el rango [0, 2), con raíz A, y a su derecha, el rango [1, 2), con B. A la derecha de C, el rango [3, 4),
con D. Así sale el árbol C(A(- B) D) de la salida, donde el - es un lado vacío:
![A la izquierda, el árbol: C en la raíz, con frecuencia 3 y rango [0, 4), de costo 18. Su hijo izquierdo es A, con frecuencia 2 y rango [0, 2), de costo 4, cuyo lado izquierdo está vacío. El hijo derecho de A es B, con frecuencia 1 y rango [1, 2), de costo 1. El hijo derecho de C es D, con frecuencia 4 y rango 3, 4), de costo 4. A la derecha, la tabla C[i][j] con filas 0: 0 2 4 10 18; 1: 0 1 5 13; 2: 0 3 10; 3: 0 4; 4: 0, con esos cuatro rangos marcados. Al pie, 2·2 + 1·3 + 3·1 + 4·2 = 18, y C(0, 4) = F(0, 4) + C(0, 2) + C(3, 4) = 10 + 4 + 4 = 18
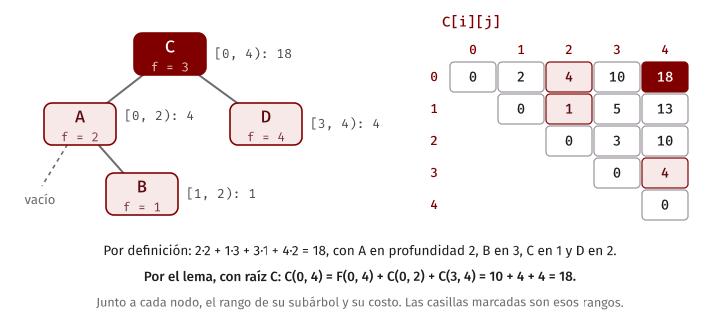
Su costo, con la definición: 2·2 + 1·3 + 3·1 + 4·2 = 18. Las pruebas comparan la tabla con una fuerza bruta, que genera todos los árboles posibles y mide con la definición, sin usar el lema.
Error común. Olvidar F(i, j), o sumar solo la frecuencia de la raíz. Sin F(i, j), todo da 0. Con solo fᵣ, cada clave se cuenta una sola vez, como si todas estuvieran a la misma profundidad. El lema es la razón por la que se suma el rango completo.
En la práctica. Este árbol es estático: se calcula una vez, para claves y frecuencias que se conocen de antemano. Si las claves cambian o las frecuencias no se conocen, lo razonable sigue siendo un árbol balanceado de Estructuras de Datos, que garantiza el peor caso. El interés de esta sección es, sobre todo, el patrón de la recurrencia.
Un árbol tiene un orden natural
Con esto termina la Sesión A. En la Sesión B, la entrada misma es un árbol.
Un árbol con raíz tiene un orden natural para hacer programación dinámica: primero los hijos. El subárbol de un nodo v, que escribimos T(v), es v y todos sus descendientes. Los subárboles de los hijos de v no comparten nodos, y no hay aristas entre ellos: la única forma de pasar de uno a otro es a través de v. Esa propiedad es la que va a hacer que todo funcione, y la que se pierde en un grafo con ciclos.
El grafo de subproblemas, aquí, es el propio árbol con las flechas de hijo a padre. Un nodo combina a todos sus hijos, así que la solución no es un camino en ese DAG.
Conjunto independiente de peso máximo en un árbol
Un conjunto independiente (independent set) es un conjunto de nodos entre los cuales no hay ninguna arista. Cada nodo tiene un valor, que es un entero y puede ser negativo. Queremos el conjunto independiente con la mayor suma de valores. El conjunto vacío cuenta, y vale 0.
Piensen en una empresa: nadie quiere ir a una reunión con su jefe directo, y cada persona aporta algo.
Ideas parecidas que fallan
Hay dos greedy que suenan bien. Uno: un árbol es bipartito, así que se toman los niveles pares o los impares, lo que sume
más. Eso siempre es un conjunto independiente. El otro: tomar primero el de mayor valor, y seguir mientras no choque con
un vecino ya elegido. Este es un árbol de ejemplo, y lo que da cada idea, en tree_demo:
$ build/tree_demo
Árbol: padre -> hijos
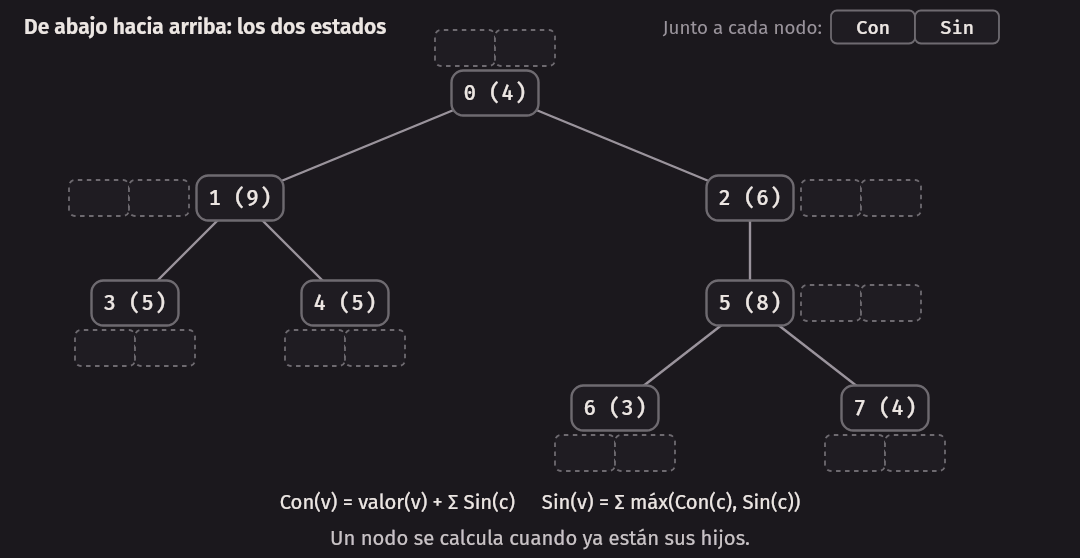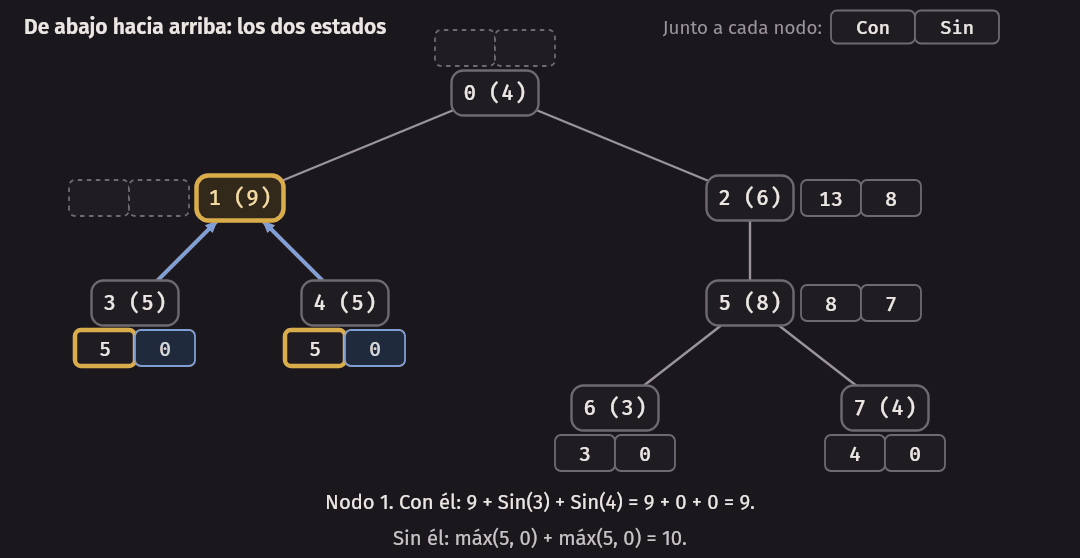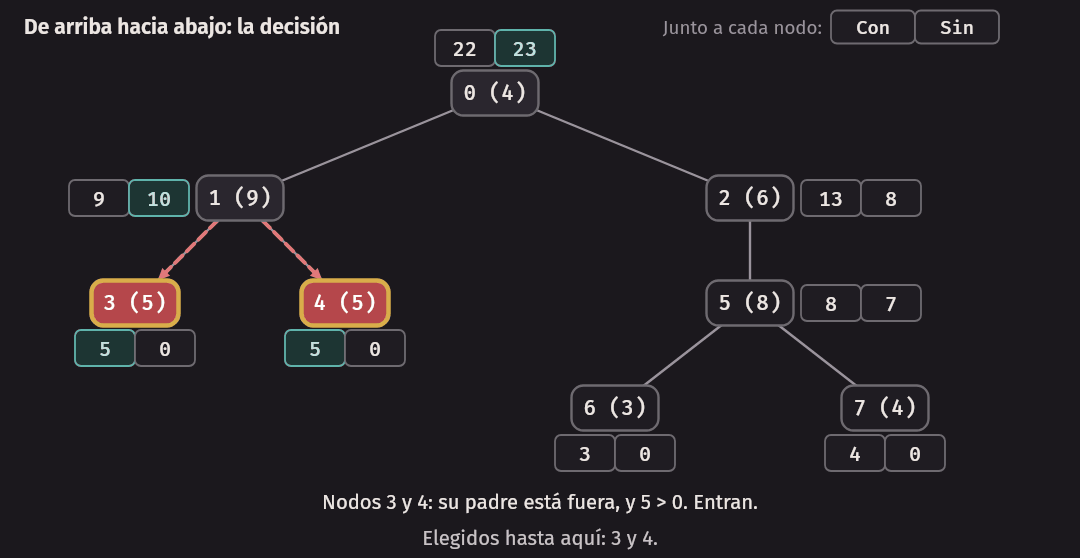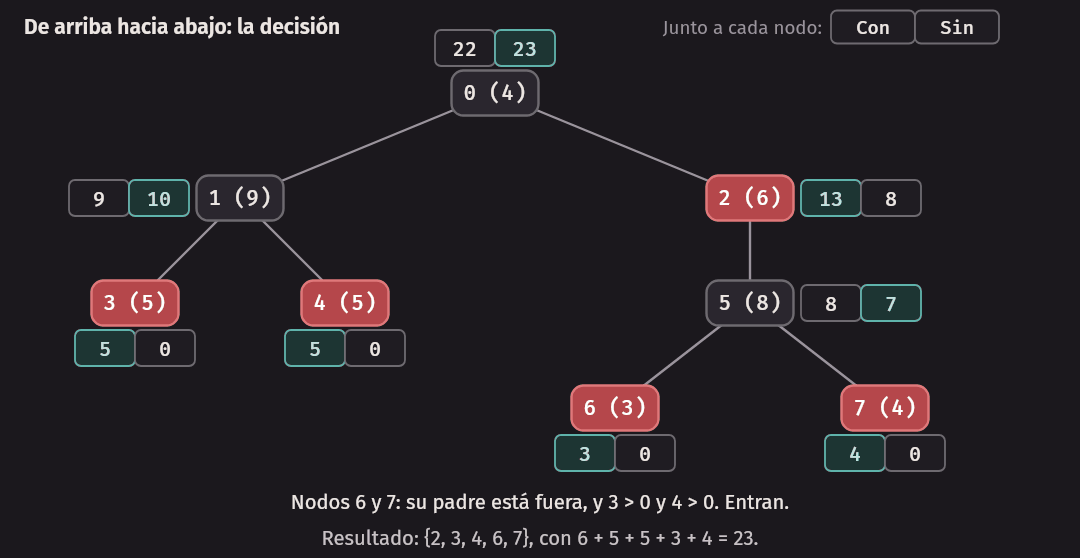
  0 (valor 4) -> 1 2
  1 (valor 9) -> 3 4
  2 (valor 6) -> 5
  3 (valor 5) ->
  4 (valor 5) ->
  5 (valor 8) -> 6 7
  6 (valor 3) ->
  7 (valor 4) ->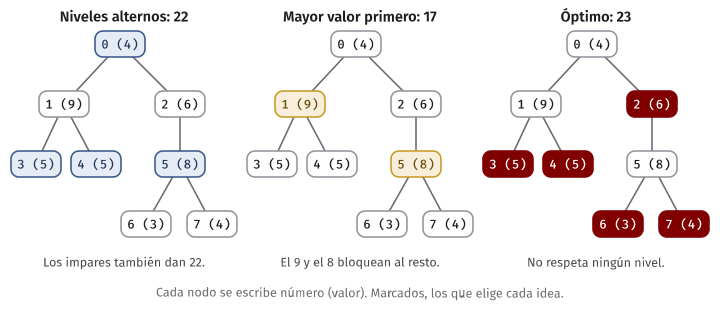
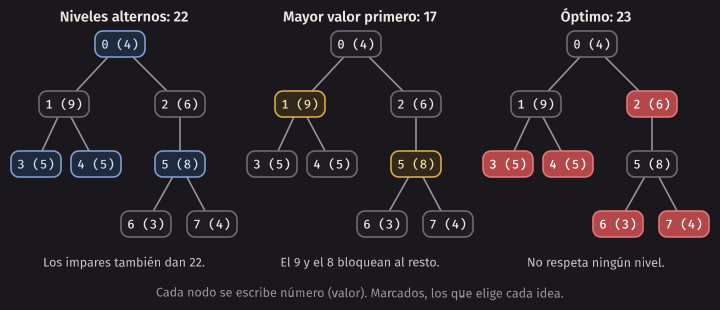
El árbol de arriba:
  fuerza bruta:              23
  dos estados:               23
  niveles alternos:          22
  mayor valor primero:       17
  sin elegir obliga a hijos: 22

La cadena 10, 1, 1, 10:
  fuerza bruta:              20
  dos estados:               20
  niveles alternos:          11
  mayor valor primero:       20
  sin elegir obliga a hijos: 11

Un jefe de valor 5 con tres personas de valor 2:
  fuerza bruta:              6
  dos estados:               6
  niveles alternos:          6
  mayor valor primero:       5
  sin elegir obliga a hijos: 6
Los niveles alternos fallan en la cadena: lo mejor es tomar las dos puntas, que tienen distinta paridad, y ninguna regla
por niveles lo permite. El mayor valor primero falla con el jefe: toma el 5 y bloquea a los tres de 2, que juntos suman 6.
En el primer árbol fallan las dos. El óptimo, 23, no respeta ningún nivel: elige al nodo 2, que está en el nivel 1, a los
nodos 3 y 4, en el nivel 2, y a los nodos 6 y 7, en el nivel 3. La línea sin elegir obliga a hijos es un error que
vamos a discutir enseguida.
Dos estados por nodo
Para decidir sobre v necesitamos saber qué pasa con sus hijos, y lo que pasa con un hijo depende de si v se eligió. Otra vez, al subproblema le falta información si solo dice “lo mejor en T(v)”. El padre tiene que poder preguntar: ¿qué es lo mejor, sabiendo si el hijo está dentro o no? Por eso hay dos estados por nodo.
Subproblema. Con(v) es la mayor suma de un conjunto independiente de T(v) que contiene a v. Sin(v) es la mayor suma de un conjunto independiente de T(v) que no contiene a v. La respuesta es máx(Con(raíz), Sin(raíz)).
Con(v) = valor(v) + Σ Sin(c)               para cada hijo c de v
Sin(v) = Σ máx(Con(c), Sin(c))             para cada hijo c de v
En una hoja, las sumas son vacías: Con(v) = valor(v) y Sin(v) = 0.
Lean las dos fórmulas con calma. Si v está dentro, cada hijo tiene que quedar fuera. Si v no está, el hijo queda libre: se elige lo mejor para él, y eso puede ser estar o no estar.
Error común. Olvidar que un nodo sin elegir deja libres a sus hijos. Es escribir Sin(v) = Σ Con(c), como si no elegir a un padre obligara a elegir a sus hijos. Esa recurrencia alterna los niveles a la fuerza a lo largo de cada camino. En la cadena 10, 1, 1, 10 da 11: si se toma el 10 de arriba, el siguiente queda fuera, el siguiente está obligado a entrar, y el último tiene que quedar fuera. Es la línea
sin elegir obliga a hijosde la salida, y da 11 en lugar de 20.
Teorema. Para todo nodo v, Con(v) y Sin(v) dadas por la recurrencia son los valores que dice la frase.
Técnica. Inducción sobre el orden de los hijos primero, es decir, sobre la altura de v. Para eso, un lema que describe las soluciones.
Lema. Sean c₁, …, cₘ los hijos de v. Un conjunto X ⊆ T(v) es independiente si y solo si se cumplen estas dos cosas: cada parte X ∩ T(cₜ) es independiente, y si v está en X, ningún cₜ está en X.
Demostración del lema. Las aristas de T(v) son de dos clases: las que están dentro de algún T(cₜ) y las que unen a v con un hijo. No hay más, porque no hay aristas entre subárboles de hermanos. La independencia pide que ninguna arista tenga sus dos puntas en X. La primera clase da la primera condición, y la segunda clase da la segunda. ∎
Demostración del teorema. Supongamos que vale para todos los hijos de v. Para una hoja no hay hijos, y los dos conjuntos posibles son {v} y el vacío.
Para Con(v): por el lema, un conjunto independiente de T(v) que contiene a v es exactamente v más, en cada T(cₜ), un conjunto independiente que no contiene a cₜ. Las elecciones en distintos hijos no se estorban, porque el lema no pone ninguna condición entre ellas. Y la suma total es el valor de v más la suma de las partes. Para maximizar una suma de partes que se eligen por separado, basta maximizar cada una. Cada una da Sin(cₜ), por hipótesis. Eso es la fórmula.
Para Sin(v): por el lema, es exactamente, en cada T(cₜ), un conjunto independiente cualquiera. Lo mejor de cada parte es máx(Con(cₜ), Sin(cₜ)), por hipótesis, porque un conjunto de T(cₜ) o contiene a cₜ o no lo contiene. ∎
Observen que la demostración no usa el signo de los valores. Los valores negativos no necesitan ningún código aparte. Como Sin de una hoja vale 0 y solo se suman máximos, Sin(v) ≥ 0 siempre. La respuesta, por lo tanto, nunca es negativa. La salida lo confirma, en un árbol con todos negativos:
Todos negativos:
  fuerza bruta:              0
  dos estados:               0
  niveles alternos:          -3
  mayor valor primero:       0
  sin elegir obliga a hijos: -3
  elegidos: {}
Si el problema exigiera elegir al menos a alguien, ya sería otra pregunta, y habría que resolverla aparte.
Calcular y seguir el ejemplo
algoritmo llenar_estados(hijos, valor, v, Con, Sin)
    Con[v] ← valor[v]
    Sin[v] ← 0
    para cada hijo c de v hacer
        llenar_estados(hijos, valor, c, Con, Sin)
        Con[v] ← Con[v] + Sin[c]
        Sin[v] ← Sin[v] + máx(Con[c], Sin[c])
    fin para
fin algoritmo
Cada nodo se visita una vez, y cada arista se mira una vez: Θ(n). Compárenlo con los 2ⁿ subconjuntos.
En C++, sobre las listas de hijos de un árbol chico:
struct RootedTree {
    std::vector<std::vector<int>> children;
    int root;
    std::vector<long long> value;
};

struct TwoStates {
    std::vector<long long> with_node;     // lo mejor en el subárbol de v, con v dentro
    std::vector<long long> without_node;  // lo mejor en el subárbol de v, con v fuera
};

// Primero los hijos. Un nodo elegido obliga a sus hijos a quedar fuera; uno sin elegir los deja libres.
inline void fill_states(const RootedTree& tree, int v, TwoStates& s) {
    s.with_node[v] = tree.value[v];
    s.without_node[v] = 0;
    for (int c : tree.children[v]) {
        fill_states(tree, c, s);
        s.with_node[v] += s.without_node[c];
        s.without_node[v] += std::max(s.with_node[c], s.without_node[c]);
    }
}
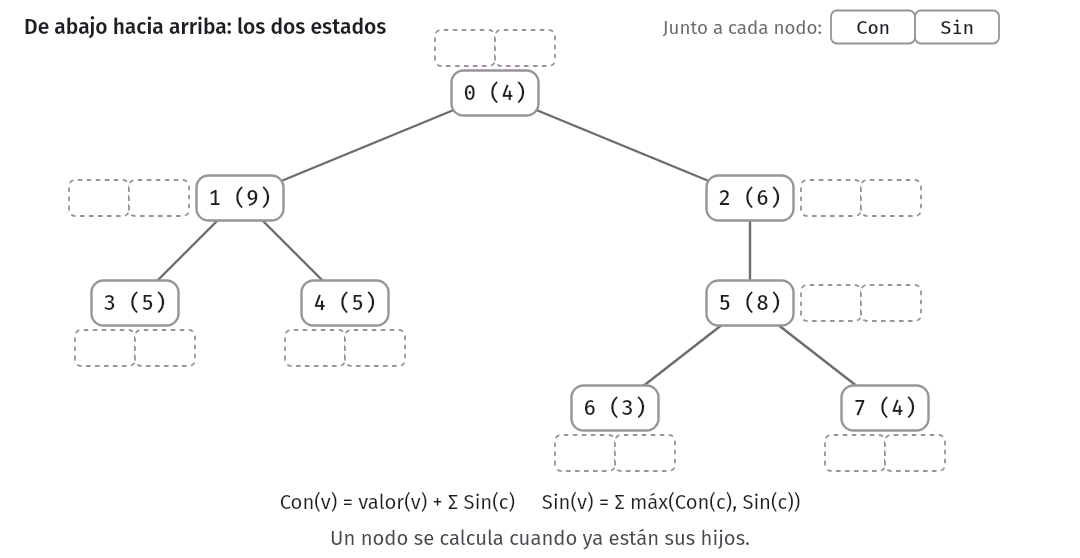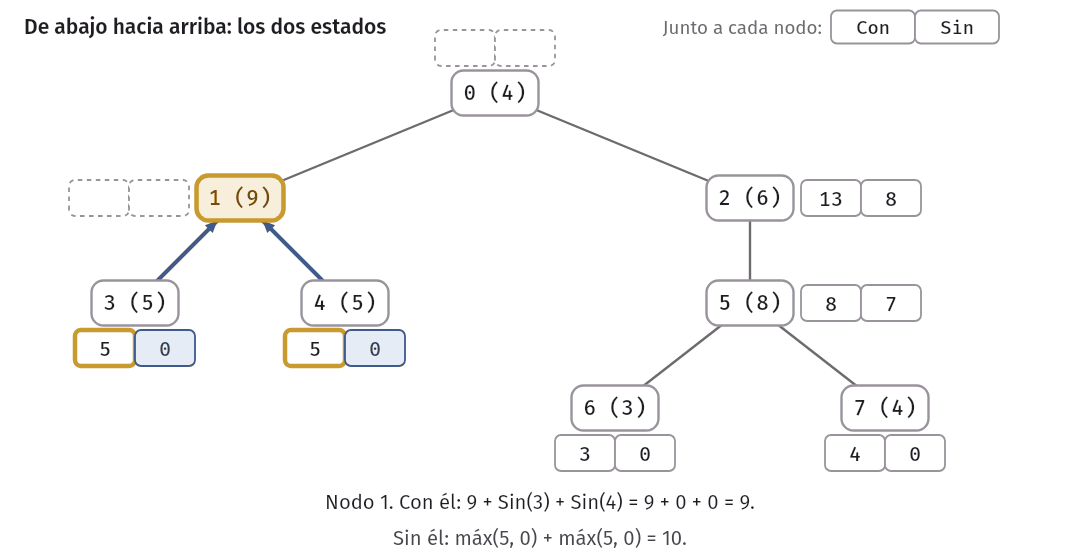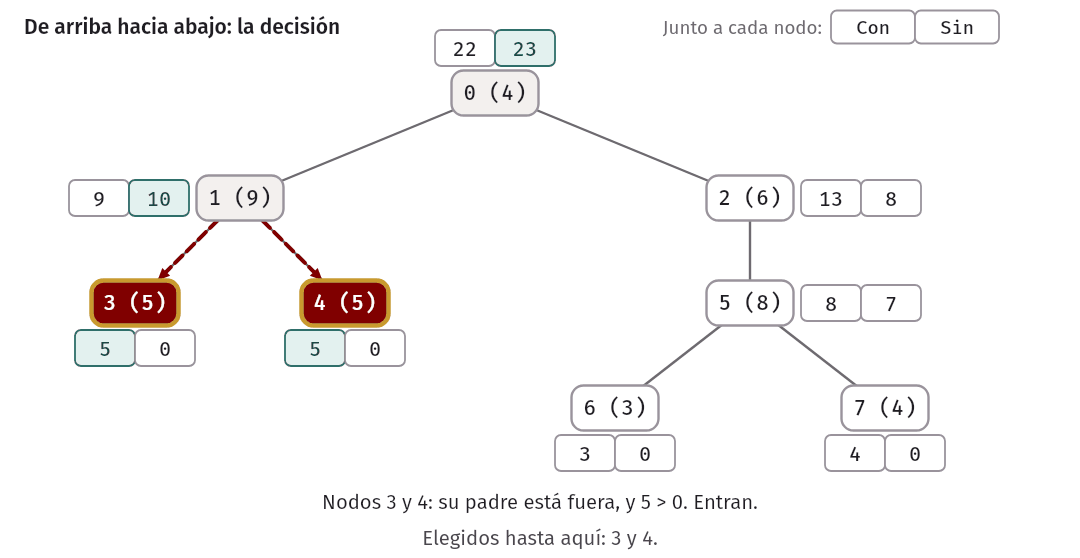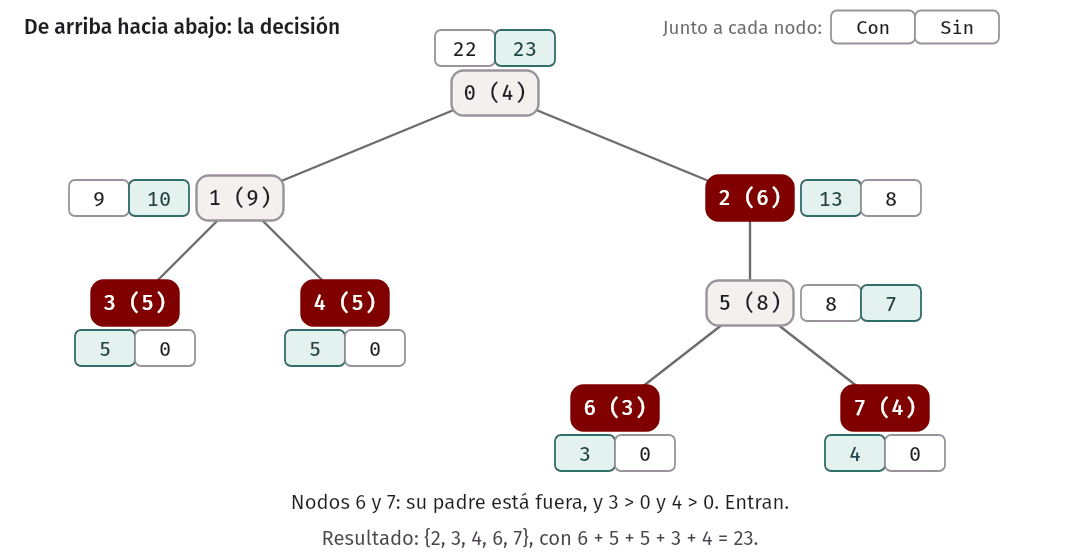
Esta es la tabla del árbol de ejemplo, de abajo hacia arriba:
nodo  valor   con  sin
   7      4     4    0
   6      3     3    0
   5      8     8    7
   4      5     5    0
   3      5     5    0
   2      6    13    8
   1      9     9   10
   0      4    22   23
Mejor valor: 23, con {2, 3, 4, 6, 7}
Veamos tres filas:
- Nodo 5. Con él: 8 + Sin(6) + Sin(7) = 8. Sin él: máx(3, 0) + máx(4, 0) = 7. Por poco, conviene elegirlo.
- Nodo 2. Con él: 6 + Sin(5) = 6 + 7 = 13. Aquí está lo interesante: elegir al 2 obliga a dejar fuera al 5, pero a cambio quedan libres el 6 y el 7. Sin él: máx(8, 7) = 8.
- Nodo 0. Con él: 4 + Sin(1) + Sin(2) = 4 + 10 + 8 = 22. Sin él: máx(9, 10) + máx(13, 8) = 10 + 13 = 23. Gana no elegir a la raíz.
Reconstruir: de arriba hacia abajo
La tabla da el valor 23. ¿Quiénes son? Los estados se calcularon de abajo hacia arriba, pero la decisión de un nodo depende de su padre. Por eso, la reconstrucción va de arriba hacia abajo.
algoritmo elegir(hijos, Con, Sin, v, padre_elegido, elegidos)
    elegido ← falso
    si no padre_elegido y Con[v] > Sin[v] entonces
        elegido ← verdadero
        agregar v a elegidos
    fin si
    para cada hijo c de v hacer
        elegir(hijos, Con, Sin, c, elegido, elegidos)
    fin para
fin algoritmo
Se llama con la raíz, y con padre_elegido en falso.
Afirmación. La parte de elegidos dentro de T(v) es un conjunto independiente, y suma Sin(v) si el padre de v fue
elegido, y máx(Con(v), Sin(v)) si no.
Técnica. Inducción sobre la altura de v. Si el padre fue elegido, v no entra, y los hijos se llaman con
padre_elegido en falso. Por hipótesis, cada uno aporta máx(Con(c), Sin(c)), y la suma es Sin(v). Si el padre no fue
elegido y Con(v) > Sin(v), v entra, y cada hijo se llama con padre_elegido en verdadero. Cada uno aporta Sin(c), y la
suma con valor(v) es Con(v), que es el máximo. Si Con(v) ≤ Sin(v), v no entra, y es igual al primer caso, que da Sin(v), y
ese es el máximo. En ningún caso hay un nodo elegido con su padre elegido, porque el padre elegido se lo impide. ∎
En un empate, esta versión prefiere no elegir, y podría preferir lo contrario: los dos dan el óptimo.
En el ejemplo: la raíz 0 tiene Con = 22 ≤ Sin = 23, y queda fuera. El nodo 1 tiene 9 ≤ 10, y queda fuera. Los nodos 3 y 4 tienen 5 > 0, y entran. El nodo 2 tiene 13 > 8, y entra. El nodo 5 tiene padre elegido, y queda fuera, aunque 8 > 7. Los nodos 6 y 7 tienen padre sin elegir, y entran. El resultado es {2, 3, 4, 6, 7}, con suma 23.
Error común. Decidir cada nodo por separado, mirando solo su fila de la tabla. El nodo 5 tiene Con = 8 > Sin = 7, y el nodo 2 tiene 13 > 8, pero son vecinos. Esta línea de
tree_demomuestra lo que se obtiene:Cada nodo por separado, sin mirar al padre: {2, 3, 4, 5, 6, 7}No es un conjunto independiente: tiene las aristas 2-5, 5-6 y 5-7. Lo que dice cada fila es condicional, “lo mejor si mi padre me deja libre”.
Cobertura de vértices mínima en un árbol
Una cobertura de vértices (vertex cover) es un conjunto de nodos que toca a todas las aristas: toda arista tiene al menos una punta en el conjunto. Con pesos en los nodos, queremos la cobertura de peso mínimo. Piensen en poner cámaras en las esquinas de una red de calles, de forma que cada calle tenga una cámara en alguna punta.
Es el mismo patrón, con dos estados. Si v no está, cada hijo tiene que estar, para cubrir la arista entre ellos. Si v está, cada hijo queda libre:
Dentro(v) = peso(v) + Σ mín(Dentro(c), Fuera(c))     para cada hijo c de v
Fuera(v)  = Σ Dentro(c)                              para cada hijo c de v
La respuesta es mín(Dentro(raíz), Fuera(raíz)). La demostración es la del conjunto independiente, cambiando la condición sobre cada arista v-c. Observen que aquí sí es correcto obligar a los hijos: es lo que en el conjunto independiente era el error, y aquí es la definición del problema.
Pero hay un atajo, y vale en cualquier grafo, no solo en un árbol.
Lema del complemento. En cualquier grafo, X es un conjunto independiente si y solo si el resto de los nodos, V ∖ X, es una cobertura de vértices.
Técnica. Traducir las definiciones arista por arista. X es independiente si ninguna arista tiene sus dos puntas en X. Eso es lo mismo que decir que toda arista tiene al menos una punta fuera de X, es decir, en V ∖ X. Y eso es lo que pide una cobertura. ∎
Por eso, con W la suma de todos los pesos, el peso de V ∖ X es W − peso(X). Ir de X a V ∖ X es una correspondencia uno a uno entre conjuntos independientes y coberturas. Hacer máximo a uno es hacer mínimo al otro:
cobertura mínima = W − conjunto independiente máximo
Vale con pesos, también negativos, porque la cuenta no usa el signo. Sin pesos, si todos pesan 1, es la conocida relación: la cobertura mínima tiene n − α nodos, donde α es el tamaño del conjunto independiente máximo. La salida lo comprueba en el árbol de ejemplo, de tres formas:
Cobertura de peso mínimo del primer árbol
  con su propia recurrencia:         21
  fuerza bruta:                      21
  total 44 menos conjunto independiente: 21
Las pruebas lo comparan en 4000 árboles al azar, la mitad con valores negativos.
Idea clave. El lema del complemento vale en todo grafo, pero solo traduce un problema en el otro: no hace fácil a ninguno. Lo que hace fácil al árbol es la recurrencia. Ambos son difíciles en un grafo general, y por qué lo son es tema de la semana 13.
Por qué no sirve en un grafo con ciclos
¿Por qué no aplicar la misma recurrencia en cualquier grafo? Porque un grafo con ciclos no tiene “hijos”. Se podría elegir una raíz, correr un BFS y usar el árbol que resulta. Eso sale mal:
Un triángulo con valores 5, 5, 5, usando el árbol de BFS desde 0
  el programa de árboles dice: 10, con {1, 2}
  pero 1 y 2 son vecinos en el triángulo, y lo mejor de verdad es 5
El árbol de BFS desde 0 tiene las aristas 0-1 y 0-2, y pierde la arista 1-2. El programa elige a los dos hijos, que en el árbol no se tocan.
¿Dónde se rompe la demostración? En el lema: “no hay aristas entre subárboles de hermanos”. En un árbol, una vez que se decide qué pasa con v, los subárboles de los hijos no tienen nada que ver entre sí, y se pueden optimizar por separado. Con una arista adicional, lo que se decide en un subárbol limita lo que se puede hacer en otro. Con un solo bit por nodo ya no alcanza, y agregar la información que falta significa recordar las decisiones en toda la frontera entre las partes. En el peor caso, eso son demasiados estados.
Evitar la recursión profunda
fill_states tiene un problema que no aparece en los ejemplos chicos. Un árbol no tiene por qué ser bajo. Una cadena de n
nodos tiene profundidad n, y cada nivel de la recursión ocupa un marco de llamada. Es lo que vimos en la semana 6, y
deep_chain lo muestra con una cadena: primero recorre la cadena sin recursión, contando cuántos nodos hay bajo la
raíz, y después llama a la versión recursiva del conjunto independiente. Se compila con -O2, como en el juez, y el límite de la pila es el del contenedor,
de 8192 KB:
$ make deep
bash -c 'build/deep_chain 100000; echo "código de salida: $?"' 2>&1
orden inverso de BFS, nodos bajo la raíz: 100000
recursión, conjunto independiente: 50000
código de salida: 0
bash -c 'build/deep_chain 1000000; echo "código de salida: $?"' 2>&1
orden inverso de BFS, nodos bajo la raíz: 1000000
bash: line 1: 10307 Segmentation fault      build/deep_chain 1000000
código de salida: 139
El 10307 es el número del proceso y cambia en cada corrida. Con un millón de nodos, la recursión produce un stack overflow:
la pila se agota y el programa muere sin un mensaje útil, y el juez lo reporta como RE. La línea anterior, sin
recursión, terminó sin problema, con la misma cadena.
En la semana 6 la salida fue escribir una pila explícita. Aquí hay algo más simple, porque lo único que necesitamos es un orden en que los hijos vayan antes que su padre. Un BFS da justo lo contrario: un nodo entra a la cola cuando se procesa su padre, así que el padre sale antes que todos sus hijos. Si se recorre ese orden al revés, cada nodo llega con sus hijos ya resueltos.
algoritmo conjunto_independiente_iterativo(hijos, valor, n, raiz)
    orden ← lista con raiz
    padre ← arreglo de n valores -1
    t ← 0
    mientras t < largo de orden hacer
        v ← orden[t]
        para cada hijo c de v hacer
            padre[c] ← v
            agregar c al final de orden
        fin para
        t ← t + 1
    fin mientras
    Con ← copia de valor
    Sin ← arreglo de n ceros
    t ← n - 1
    mientras t ≥ 1 hacer
        v ← orden[t]
        Con[padre[v]] ← Con[padre[v]] + Sin[v]
        Sin[padre[v]] ← Sin[padre[v]] + máx(Con[v], Sin[v])
        t ← t - 1
    fin mientras
    devolver máx(Con[raiz], Sin[raiz])
fin algoritmo
Cada nodo, al ser procesado, ya recibió lo de todos sus hijos, y le entrega lo suyo a su padre. Es la misma suma de la
recurrencia, hecha en otro orden. Hasta el mismo arreglo sirve de cola. La reconstrucción también se puede hacer sin
recursión: se recorre orden hacia adelante, porque ahí el padre va antes.
Esto es el orden topológico del DAG de subproblemas, otra vez. En C++, este es ese orden en el cálculo más simple que
hay sobre un árbol, cuántos nodos tiene cada subárbol. Es lo que usa deep_chain:
inline std::vector<int> subtree_sizes_bfs_order(const std::vector<std::vector<int>>& children, int root) {
    std::vector<int> parent(children.size(), -1);
    std::vector<int> order = {root};
    for (std::size_t t = 0; t < order.size(); t++) {
        for (int c : children[order[t]]) {
            parent[c] = order[t];
            order.push_back(c);
        }
    }
    std::vector<int> size(children.size(), 1);
    for (std::size_t t = order.size(); t-- > 1;) {
        size[parent[order[t]]] += size[order[t]];
    }
    return size;
}
Error común. Procesar los nodos por su número, de mayor a menor, como si los hijos siempre tuvieran números mayores que su padre. Muchas veces funciona en los ejemplos, porque quien los escribe a mano numera de arriba hacia abajo. Los números no dicen nada sobre la jerarquía. Lo que da el orden es la estructura del árbol, y eso lo calcula un BFS.
En C++. Hagan la cuenta del
long longtambién aquí: un millón de nodos con valores de hasta 10⁹ suman hasta 10¹⁵, y unintllega a poco más de 2 × 10⁹. Con 3 nodos de valor 10⁹ ya hay overflow.
El código de la semana
En code/week-09:
| Archivo | Qué contiene |
|---|---|
dag_dp.h |
topological_order, longest_paths, path_to, longest_from_anywhere, heaviest_arc_walk, y los grafos de subproblemas de la distancia de edición y de la mochila |
lis.h |
lis_quadratic, lis_length_tails, non_decreasing_length_tails, final_tails, lis_indices, el greedy y la fuerza bruta |
interval_dp.h |
matrix_chain, matrix_chain_i_descending, matrix_chain_naive_order, parenthesize, optimal_bst, los greedy y las fuerzas brutas |
tree_dp.h |
fill_states, independent_set_nodes, min_cover_value, subtree_sizes_bfs_order, los errores comentados, los greedy y las fuerzas brutas |
dag_demo.cpp |
Los grafos de subproblemas, y el camino más largo |
lis_demo.cpp |
La tabla, el arreglo de finales y los errores |
chain_demo.cpp |
La cadena de matrices, y el orden ingenuo |
bst_demo.cpp |
El árbol binario de búsqueda óptimo |
tree_demo.cpp |
Conjunto independiente, cobertura y el triángulo |
deep_chain.cpp |
Recursión profunda contra orden inverso de BFS. Se corre con make deep |
lis_bench.cpp, chain_bench.cpp |
Las mediciones. Se corren con make bench |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. Las mediciones y deep_chain van con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
Todas las pruebas de la semana 9 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- El camino más largo coincide con una enumeración de todos los caminos en 3000 DAG al azar, con pesos negativos y nodos sin alcanzar. El camino reconstruido suma lo que dice la tabla.
- La distancia de edición y la mochila, vistas como caminos en su DAG, dan lo mismo que sus tablas. Los nodos y aristas del DAG de la distancia de edición cumplen la fórmula.
- La LIS: tabla, arreglo de finales y camino más largo coinciden con la fuerza bruta. La reconstrucción es creciente y
tiene el largo correcto. El invariante del arreglo de finales se comprueba después de cada elemento. Con
upper_bound, se obtiene la más larga que no decrece. - La cadena de matrices: la pregunta de repaso da 4500. Tabla y otro orden válido coinciden con una fuerza bruta que arma cada parentización. Con tres matrices o más, el orden ingenuo siempre lee casillas vacías, y nunca da más que lo correcto, porque las casillas en cero solo pueden bajar el mínimo.
- El árbol de búsqueda óptimo coincide con todos los árboles posibles, medidos con la definición.
- El conjunto independiente y la cobertura coinciden con la fuerza bruta en 4000 árboles al azar. La reconstrucción es independiente y suma el óptimo. El complemento se cumple. Los tamaños por orden inverso de BFS coinciden con un recorrido desde cada nodo, y funcionan en una cadena de 200 000 nodos.
Los problemas de laboratorio
El laboratorio es la empresa que venimos mencionando. El problema de lab/company_meeting pide el mayor valor de una
reunión, y el de lab/company_meeting_list, que es una extensión, pide también quiénes asisten, y trae un verificador,
porque puede haber varias listas óptimas. Entren a cada carpeta y corran make test. Empiecen por lo siguiente:
- Escriban primero una fuerza bruta para empresas pequeñas, y úsenla para comparar. Esto les va a ahorrar tiempo.
- Lean bien cómo viene la entrada. No se parece a las listas de hijos de estos apuntes, y hay que construir lo que necesiten.
- Revisen los límites antes de elegir tipos y antes de usar recursión.
Resumen
- Grafo de subproblemas: un nodo por subproblema, y una arista A → B si B lee a A. Es un DAG, y un orden de cálculo es un orden topológico. La memoización es un DFS por las flechas al revés. El costo es O(V + E) de ese grafo.
- Camino o combinación: la solución es un camino en el DAG solo si cada decisión depende de un subproblema, como en la distancia de edición, la mochila, la LIS y el camino más largo. En intervalos y árboles se combinan varios.
- Camino más largo en un DAG: L(v) = máx(L(u) + w(u, v)), en orden topológico. O(V + E). Los pesos negativos no molestan. Un nodo sin alcanzar es −∞, no 0, y de él no se sale. Sin DAG, es difícil: semana 14.
- LIS: E(i) termina justo en i, y la respuesta es el máximo de todos. Θ(n²). Con el arreglo de finales, O(n log n):
finales[k] es el menor último valor de una subsecuencia de largo k + 1. Ese arreglo está ordenado, y no es una
subsecuencia.
lower_boundpara estrictamente creciente, yupper_boundpara que no decrezca. Se reconstruye guardando índices y predecesores. - Cadena de matrices: M(i, j) sobre un rango. La última multiplicación parte en k. Θ(n³) en tiempo y Θ(n²) en memoria. 10 × 30, 30 × 5 y 5 × 60 cuestan 4500 con (A₀A₁)A₂, y 27 000 con A₀(A₁A₂).
- El orden: el orden i, j ingenuo lee casillas sin llenar, y puede dar un número razonable y equivocado. Sirve por largo creciente, y también i de mayor a menor. Pregunten siempre qué casillas lee cada casilla.
- Árbol binario de búsqueda óptimo: el costo es Σ f·profundidad, con la raíz en profundidad 1. C(i, j) = F(i, j) + mín(C(i, r) + C(r + 1, j)). F(i, j) se suma porque colgar un subárbol de una raíz baja un nivel a todo lo que tiene. Θ(n³).
- Árboles: primero los hijos. Los subárboles de los hijos no tienen aristas entre ellos, y por eso se optimizan por separado. Dos estados: Con(v) = valor(v) + Σ Sin(c), Sin(v) = Σ máx(Con(c), Sin(c)). Θ(n). Un nodo sin elegir deja libres a sus hijos. Los valores negativos no piden código aparte.
- Reconstruir en un árbol: de arriba hacia abajo, recordando qué se decidió en el padre. Decidir cada nodo por separado da nodos vecinos.
- Cobertura de vértices: el mismo patrón. En cualquier grafo, el complemento de un conjunto independiente es una cobertura, y cobertura mínima = W − conjunto independiente máximo. Los dos son difíciles en un grafo general: semana 13.
- Recursión profunda: en una cadena larga se produce un stack overflow. El orden inverso de un BFS pone a los hijos antes que al padre, y no usa la pila. Los números de los nodos no dan ningún orden.
Ejercicios
- El DAG, a mano. Dibujen el DAG de subproblemas de Fibonacci con n = 6 y el de la distancia de edición entre
abyba. Para el segundo, marquen el camino que corresponde a la distancia. ¿Qué parte del dibujo cambia si las letras cambian, y qué parte no? - Cadena de matrices, a mano. Calculen la mejor forma de multiplicar matrices de 5 × 4, 4 × 6, 6 × 2 y 2 × 7. Llenen la
tabla por largo. Comprueben con
matrix_chain. - El otro orden. Demuestren que, en la tabla de la cadena de matrices, recorrer
jde menor a mayor y, dentro,idejhacia abajo también es un orden válido. Escriban ese programa y compárenlo conmatrix_chainen instancias al azar. - Camino más corto en un DAG. Modifiquen
longest_pathspara calcular caminos mínimos en un DAG con pesos negativos. Luego den un grafo con un ciclo donde el programa no tenga sentido, y expliquen qué línea de la demostración se rompe. - Contar caminos. Escriban una programación dinámica que cuente cuántos caminos hay de s a t en un DAG. Prueben en
qué casos el número no cabe en
long long. ¿Cuál es la frase del subproblema? ¿Es de “camino” o de “combinación”? Luego demuestren que el número de caminos de F(1) a F(n), en el DAG de Fibonacci, es F(n). - La que no decrece. Demuestren que
non_decreasing_length_tails, conupper_bound, es correcto. Adapten la invariante: ¿qué significa ahora finales[k], y en qué línea de la demostración se usaba que era estrictamente creciente? - Otra reducción a LIS. Dadas dos permutaciones de los números de 0 a n − 1, reduzcan el cálculo de la LCS entre ellas a una LIS. ¿Cuál es el costo? Comparen con la tabla de la semana 7. ¿Por qué esto no se aplica a dos cadenas cualesquiera, con letras repetidas?
- Árbol de búsqueda con huecos. Extiendan
optimal_bstpara contar búsquedas fallidas: un arreglo g de n + 1 frecuencias, una por cada hueco entre claves, que suman g·(profundidad del nodo donde falla la búsqueda). Definan bien esa profundidad. Escriban la recurrencia y demuéstrenla. - Un solo estado. Demuestren que, si se elimina el segundo estado y se escribe B(v) = máx(valor(v) + Σ B(nieto), Σ B(c)), donde la primera suma es sobre los hijos de los hijos de v, también se obtiene el conjunto independiente máximo. ¿Cuántas veces se lee cada nodo? ¿Cambia el costo?
- Cobertura directa. Demuestren la recurrencia de Dentro(v) y Fuera(v) sin usar el lema del complemento. Escriban
la reconstrucción de arriba hacia abajo, y comprueben con
min_cover_brute. - Conjunto dominante en un árbol. Un conjunto dominante es un conjunto de nodos tal que cada nodo está en él o tiene un vecino en él. Encuentren uno de tamaño mínimo en un árbol. Con dos estados no alcanza: ¿qué le falta al subproblema? Definan tres estados, escriban la recurrencia, demuéstrenla y comparen con fuerza bruta.
- Un bosque y otro orden. Adapten el algoritmo iterativo a un bosque con varias raíces. Luego demuestren que el orden inverso de un recorrido DFS por preorden, con pila explícita, también pone a los hijos antes que al padre.