Apuntes · Capítulo 7Programación dinámica
Programación dinámica
Programación dinámica
Las últimas tres semanas tomamos decisiones sin volver atrás. Elegimos la clase que termina antes, unimos los dos símbolos menos frecuentes, fijamos el nodo más cercano, agregamos la arista más barata que cruza un corte. Cada vez hubo que demostrar que esa decisión local no estropea nada, y cada vez encontramos reglas parecidas que sí lo estropean.
Esta semana abre otra parte del curso, y empieza con un caso en que ninguna regla funciona. En la semana 4 dejamos pendiente una variante del problema de las clases: si cada clase tiene un valor y se busca el máximo valor total, la que termina antes ya no sirve. Tampoco la de mayor valor. Lo que nos falta es poder decir “no sé si esta clase va o no va, así que voy a calcular las dos posibilidades”. Eso, hecho sin cuidado, cuesta un tiempo exponencial. Hecho con cuidado, es la programación dinámica (dynamic programming).
La idea es corta: una recursión que prueba todas las opciones suele repetir muchas veces las mismas preguntas. Si hay pocas preguntas distintas, se responde cada una una sola vez y se guarda la respuesta. Lo difícil no es programarla. Lo difícil es decidir qué pregunta hacer.
La primera sesión desarrolla el método y lo aplica a los intervalos con pesos y a la mochila. Allí aparece un costo raro, O(nW), que parece polinomial y no lo es. La segunda sesión lo aplica a dos cadenas: la subsecuencia común más larga y la distancia de edición, que son lo que hay detrás de comparar dos versiones de un archivo.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Fibonacci otra vez: los subproblemas se repiten, El método, en cuatro pasos y Subsecuencia y subcadena. Con eso llegan con el método de cuatro pasos que se usa en las dos sesiones.
En clase: Sesión A, de Intervalos con pesos a Ahorrar memoria: una sola fila. Sesión B, Subsecuencia común más larga, Distancia de edición y Demostrar programación dinámica: inducción sobre el orden de la tabla.
Después de clase: Greedy o programación dinámica, el Resumen y los Ejercicios, para repasar, y los resúmenes de las semanas 4 a 6 para la Práctica 2. Opcional: El código de la semana y su problema. Para ampliar, Comparar versiones: dónde se usa y las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, secs. 3.1 a 3.4 (hasta The Pattern: Smart Recursion), 3.5 (Warning: Greed is Stupid) y 3.8 (Subset Sum). CLRS, capítulo Dynamic Programming, 4.ª edición. Sesión B: Erickson, sec. 3.7 (Edit Distance). CLRS, capítulo Dynamic Programming, 4.ª edición. Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-07. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El problema opcional de laboratorio está enlab/small_diffy tiene su propiomake test.
Fibonacci otra vez: los subproblemas se repiten
En Introducción a la Programación vieron dos cosas que aquí se juntan. El backtracking prueba todas las opciones de una decisión, una por una, con recursión. La memoización guarda el resultado de una función para no volver a calcularlo. Allá la mostraron con Fibonacci, y volvemos a él por una sola razón: es el ejemplo más pequeño en que se ve qué está pasando.
F(0) = 0, F(1) = 1, y F(n) = F(n − 1) + F(n − 2) para n ≥ 2. La recursión directa es la definición copiada:
algoritmo fib(n)
    si n < 2 entonces
        devolver n
    fin si
    devolver fib(n - 1) + fib(n - 2)
fin algoritmo
Es correcta, y es lentísima. Este es el árbol de llamadas de fib(5), a la izquierda. A la derecha, lo que queda si se guarda cada respuesta:
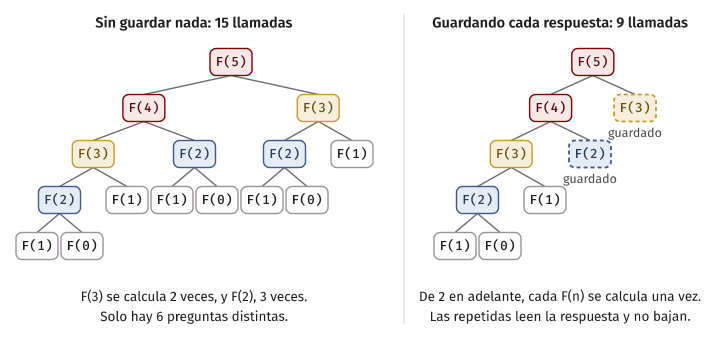
F(3) se calcula dos veces, y F(2) tres veces. El programa fib_calls lo cuenta para n más grandes:
$ build/fib_calls
 n          F(n)   sin memoizar   memoizando
 5             5             15            9
10            55            177           19
20          6765          21891           39
30        832040        2692537           59
40     102334155      331160281           79

fib(10): cuántas veces se calcula cada subproblema
  F(0): 34
  F(1): 55
  F(2): 34
  F(3): 21
  F(4): 13
  F(5): 8
  F(6): 5
  F(7): 3
  F(8): 2
  F(9): 1
  F(10): 1
Sin memoizar, fib(n) hace 2·F(n + 1) − 1 llamadas, y F(n) crece como una potencia de 1,618. Pero fíjense en la segunda parte de la salida. fib(10) hace 177 llamadas y solo hay 11 preguntas distintas: F(0), F(1), …, F(10). Todo lo demás es repetir. El tiempo exponencial no viene de que el problema sea difícil, viene de olvidar lo que ya se calculó.
Con memoización cada pregunta distinta se calcula una vez. Las demás llamadas se responden mirando la tabla:
algoritmo fib_memo(n, memo)
    si n < 2 entonces
        devolver n
    fin si
    si memo[n] no tiene valor entonces
        memo[n] ← fib_memo(n - 1, memo) + fib_memo(n - 2, memo)
    fin si
    devolver memo[n]
fin algoritmo
Son 2n − 1 llamadas: cada n de 2 en adelante se calcula una vez y hace dos llamadas, y la raíz es una llamada más. Con n = 5 son las 9 del árbol de la derecha en la figura de arriba.
De la memoización a la tabla
La memoización deja que la recursión decida en qué orden se calculan las cosas. Pero F(n) solo necesita valores con índice menor. Entonces se puede llenar la tabla directamente de menor a mayor, sin recursión:
algoritmo fib_tabla(n)
    tabla ← arreglo de n + 2 ceros
    tabla[1] ← 1
    para k desde 2 hasta n hacer
        tabla[k] ← tabla[k - 1] + tabla[k - 2]
    fin para
    devolver tabla[n]
fin algoritmo
Este programa hace la misma cuenta que fib_memo, sin la pila de llamadas y sin la pregunta de si la casilla ya tiene
valor. Y al escribirlo se nota algo más: cada casilla solo lee las dos anteriores, así que bastan dos variables.
Estas son las últimas líneas de la salida de fib_calls:
F(90) con tabla:         2880067194370816120
F(90) con dos variables: 2880067194370816120
F(90) no se habría podido calcular con la primera versión. Por la fórmula, serían más de 9 × 10¹⁸ llamadas. Y F(90) ya
está cerca del límite de un long long: el último valor que cabe es F(92).
Programación dinámica es esto: una recursión que repite subproblemas, en la que se guardan las respuestas. Se llama de arriba hacia abajo (top-down) cuando se escribe como recursión con memoización, y de abajo hacia arriba (bottom-up) cuando se llena una tabla en un orden elegido. Las dos hacen el mismo trabajo en lo esencial.
Una aclaración sobre el nombre. “Tabla” y “llenar” son el resultado, no la idea. Si alguien les da una tabla sin decir qué significa cada casilla, no les ha dado una programación dinámica, les ha dado un acertijo. Por eso la tabla es el tercer paso del método, y no el primero.
Idea clave. La programación dinámica funciona cuando hay pocas preguntas distintas y muchas repeticiones. El costo es, a grandes rasgos, cuántas preguntas distintas hay por cuánto cuesta responder cada una usando las respuestas de las otras.
El método, en cuatro pasos
Durante todo este capítulo seguimos estos pasos, siempre en este orden:
- Definir el subproblema, en una frase. Es una oración en español que dice qué significa cada casilla, y qué casilla contiene la respuesta al problema original. Si esa frase no se puede escribir, todavía no hay algoritmo. Un subproblema es una versión más pequeña del problema, descrita con unos pocos parámetros.
- Escribir la recurrencia. Expresa cada subproblema con subproblemas más pequeños, pensando en una sola decisión: ¿qué pasa con el último elemento? Incluye los casos base.
- Elegir un orden. Toda casilla que la recurrencia lee tiene que estar calculada antes. Con esto ya se puede escribir el programa, y calcular su costo.
- Reconstruir la solución. La tabla da el mejor valor. Muchas veces queremos además cuál es la solución, y eso se obtiene recorriendo la tabla hacia atrás.
Además, cada vez demostramos la recurrencia. Una recurrencia es una afirmación: dice que una definición en palabras coincide con una fórmula. No basta que “tenga sentido”. La demostración va por inducción, en el mismo orden en que se llena la tabla, y al final del capítulo la escribimos como receta.
Detrás de la recurrencia hay una propiedad que tiene nombre: subestructura óptima (optimal substructure). Una solución óptima se compone de soluciones óptimas de sus subproblemas. No la vamos a suponer. Va a salir de cada demostración.
Intervalos con pesos
Un instituto tiene un aula y una lista de clases, cada una con un intervalo semiabierto [s, f), con s < f, y un valor v > 0, por ejemplo lo que paga. Se quiere el máximo valor total con clases que no se crucen. Es el problema de la semana 4, con un dato más.
Por qué el greedy deja de servir
Antes de diseñar nada, probemos las ideas que ya tenemos. El programa weighted_demo compara dos reglas con la fuerza
bruta, que prueba los 2ⁿ subconjuntos.
$ build/weighted_demo
Una clase valiosa en medio:
  clases: [0,2)v1 [1,6)v10 [5,7)v1
  óptimo por fuerza bruta: 10
  termina antes (semana 4): 2
  mayor valor primero:      10
  tabla:                    10

Una clase larga que estorba:
  clases: [0,10)v5 [0,3)v4 [3,6)v4 [6,10)v4
  óptimo por fuerza bruta: 12
  termina antes (semana 4): 12
  mayor valor primero:      5
  tabla:                    12

El ejemplo del recorrido:
  clases: [0,3)v2 [1,5)v4 [3,7)v4 [4,9)v6 [7,10)v2 [8,11)v3
  óptimo por fuerza bruta: 9
  termina antes (semana 4): 8
  mayor valor primero:      8
  tabla:                    9
“Termina antes” ignora el valor, y en el primer bloque toma 2 cuando se podía tomar 10. La distancia puede ser tan grande como se quiera: basta subir el 10. “Mayor valor primero” falla en el segundo bloque, donde una clase larga de valor 5 tapa a tres clases de valor 4. En el tercer bloque fallan las dos en la misma instancia.
¿Dónde se rompe la demostración de la semana 4? En el intercambio. Allá cambiábamos la clase xⱼ de una solución óptima por la clase gⱼ del greedy, y la solución seguía teniendo las mismas clases. Aquí la solución tiene el mismo número de clases, pero puede valer menos: gⱼ puede ser una clase barata y xⱼ una muy cara. Esa línea era lo único que necesitábamos, y deja de valer.
Paso 1: el subproblema
Ordenemos las clases por hora de fin: c[0], c[1], …, c[n − 1], con f(c[0]) ≤ f(c[1]) ≤ ⋯. Los empates pueden quedar en cualquier orden.
Subproblema. T[j] es el máximo valor total que se puede obtener usando solo las primeras j clases del orden, es decir, c[0], …, c[j − 1]. La respuesta al problema es T[n].
Fíjense en lo que esa frase no dice. No pide que se use la clase j-ésima, y no menciona qué clases se eligieron. Vamos a ver que no hace falta.
Paso 2: la recurrencia
Miremos la última clase disponible, c[j − 1]. Puede estar o no en la solución.
- Si no está, lo mejor es T[j − 1].
- Si está, vale v(c[j − 1]), y el resto de las clases tiene que ser compatible con ella.
¿Qué clases, entre las primeras j − 1, son compatibles con c[j − 1]? Aquí es donde sirve haberlas ordenado por fin.
Definición. p(j) es la cantidad de clases del orden cuya hora de fin es menor o igual que el inicio de c[j − 1].
Lema. Las clases compatibles con c[j − 1] que están entre las primeras j − 1 son exactamente c[0], …, c[p(j) − 1]. Además, p(j) ≤ j − 1.
Técnica. Aplicar las definiciones, cubriendo los dos órdenes en que dos intervalos pueden no cruzarse.
Llamemos c a c[j − 1], y sea x una clase con índice menor que j − 1. Por el orden, f(x) ≤ f(c). Dos intervalos semiabiertos son compatibles si uno termina a más tardar cuando empieza el otro, así que hay dos casos. Primero, f(c) ≤ s(x). Esto es imposible: juntando las desigualdades, f(c) ≤ s(x) < f(x) ≤ f(c). Segundo, f(x) ≤ s(c). Por lo tanto x es compatible con c si y solo si f(x) ≤ s(c).
Las clases con f ≤ s(c) forman un prefijo del orden, porque las clases están ordenadas por fin: si una cumple, cumplen todas las anteriores. Ese prefijo tiene p(j) clases, por definición.
Falta ver que el prefijo no llega hasta c. Toda clase con índice j − 1 o mayor tiene f ≥ f(c) > s(c), así que no se cuenta. Por eso p(j) ≤ j − 1. ∎
Eso da la recurrencia:
T[0] = 0
T[j] = máx( T[j - 1],  v(c[j - 1]) + T[p(j)] )     para j ≥ 1
Teorema. Para todo j de 0 a n, T[j], calculado con esa recurrencia, es el máximo valor con las primeras j clases.
Técnica. Inducción sobre j, que es el orden en que se llena la tabla. Sea OPT(j) el valor que dice la frase del subproblema. Vamos a mostrar que OPT(j) cumple la recurrencia, en las dos direcciones.
Caso base. Con 0 clases, la única solución es la vacía, y vale 0.
Paso. Supongamos que T[i] = OPT(i) para todo i < j, y llamemos c a c[j − 1].
(≤) Tomemos una solución óptima S de las primeras j clases. Si c no está en S, entonces S usa solo las primeras j − 1, y vale a lo sumo OPT(j − 1) = T[j − 1]. Si c está en S, todas las demás clases de S son compatibles con c y están antes de c en el orden. Por el lema están entre las primeras p(j), y forman una solución válida de ese prefijo. Entonces S vale a lo sumo v(c) + OPT(p(j)) = v(c) + T[p(j)]. En los dos casos, OPT(j) es menor o igual que el máximo de la recurrencia.
(≥) Las dos opciones se pueden conseguir. Una solución de las primeras j − 1 clases también lo es de las primeras j, así que OPT(j) ≥ T[j − 1]. Y si a una solución óptima de las primeras p(j) clases le agregamos c, sigue siendo válida: por el lema, todas esas clases son compatibles con c. Como p(j) ≤ j − 1, c no estaba entre ellas. Entonces OPT(j) ≥ v(c) + T[p(j)]. ∎
Paso 3: el orden y el costo
T[j] lee T[j − 1] y T[p(j)], con p(j) ≤ j − 1, así que basta llenar la tabla de izquierda a derecha.
algoritmo intervalos_con_pesos(clases, n)
    ordenar clases por hora de fin, de menor a mayor
    para j desde 1 hasta n hacer
        p[j] ← cantidad de clases con fin ≤ clases[j - 1].inicio, con búsqueda binaria
    fin para
    T[0] ← 0
    para j desde 1 hasta n hacer
        T[j] ← máx(T[j - 1], clases[j - 1].valor + T[p[j]])
    fin para
    devolver T[n]
fin algoritmo
La búsqueda binaria es lo que hace eficiente este programa. Como los fines están ordenados, se puede hallar p(j) en O(log n) sobre el arreglo de fines. En total: ordenar cuesta O(n log n), las n búsquedas cuestan O(n log n), y la tabla cuesta Θ(n). El costo es O(n log n). Sin la búsqueda binaria, recorriendo las clases para cada j, sería Θ(n²).
Hay n + 1 subproblemas. Compárenlo con los 2ⁿ subconjuntos que probaba la fuerza bruta.
// p[j]: cuántas clases, en el orden por fin, terminan a más tardar cuando empieza la clase j.
inline std::vector<std::size_t> compatible_prefix(const std::vector<WeightedInterval>& sorted) {
    std::vector<int> finishes;
    for (const WeightedInterval& c : sorted) finishes.push_back(c.finish);
    std::vector<std::size_t> p;
    for (const WeightedInterval& c : sorted) {
        // upper_bound: el primer fin mayor que start. Un fin igual a start sí es compatible.
        const auto it = std::upper_bound(finishes.begin(), finishes.end(), c.start);
        p.push_back(static_cast<std::size_t>(it - finishes.begin()));
    }
    return p;
}

inline std::vector<long long> weighted_table(const std::vector<WeightedInterval>& sorted,
                                             const std::vector<std::size_t>& p) {
    std::vector<long long> best(sorted.size() + 1, 0);
    for (std::size_t j = 1; j <= sorted.size(); j++) {
        best[j] = std::max(best[j - 1], sorted[j - 1].value + best[p[j - 1]]);
    }
    return best;
}
En el código, p[j - 1] es lo que en el texto llamamos p(j). Sumar n valores puede pasarse de int, por eso long long.
En C++.
std::upper_bounddevuelve el primer elemento mayor que el buscado, ystd::lower_boundel primero mayor o igual. Como hay que contar los fines menores o iguales que s, lo que corresponde esupper_bound. Los dos requieren un rango ordenado.
Sigamos el tercer ejemplo de arriba. Ya ordenadas por fin, sus clases, con p y con la tabla, quedan así:
j  clase   valor  p(j)  sin ella  con ella  T[j]
0  -           -     -         -         -     0
1  [0, 3)      2     0         0         2     2
2  [1, 5)      4     0         2         4     4
3  [3, 7)      4     1         4         6     6
4  [4, 9)      6     1         6         8     8
5  [7,10)      2     3         8         8     8
6  [8,11)      3     3         8         9     9
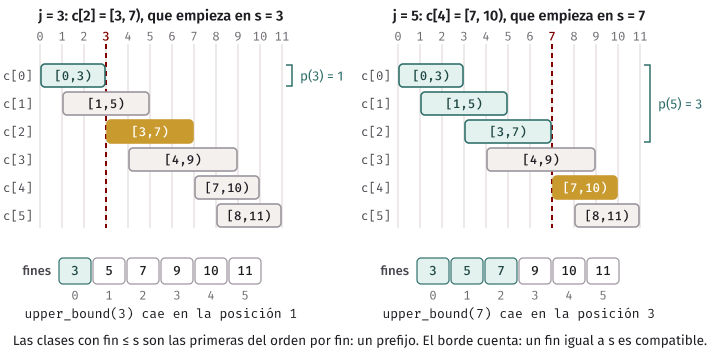
Veamos las filas 3 y 5. La clase [3, 7) empieza en 3, y la única que termina a más tardar en 3 es [0, 3): p(3) = 1. El borde cuenta como compatible, porque los intervalos son semiabiertos. En la fila 5, [7, 10) es compatible con las tres primeras, cuyos fines son 3, 5 y 7. Tomarla da 2 + T[3] = 8, y no tomarla da T[4] = 8. Es un empate.
![Dos paneles con las seis clases en orden de fin, sobre un eje de 0 a 11: c[0] = [0,3), c[1] = [1,5), c[2] = [3,7), c[3] = [4,9), c[4] = [7,10), c[5] = [8,11). En el panel de j = 3, una línea punteada marca s = 3, el inicio de c[2]: solo [0,3) termina a más tardar ahí, y p(3) = 1. En el arreglo de fines 3, 5, 7, 9, 10, 11, upper_bound(3) cae en la posición 1. En el panel de j = 5, la línea marca s = 7, el inicio de c[4]: [0,3), [1,5) y 3,7) terminan a más tardar ahí, y p(5) = 3. upper_bound(7) cae en la posición 3
Error común. Usar
lower_bounden lugar deupper_bound. Es tratar los intervalos como cerrados: una clase que termina a las 3 no se podría combinar con una que empieza a las 3. El programa no falla ni da una señal: da otra respuesta. El final de la salida deweighted_demolo muestra:Si el borde contara como cruce (lower_bound en vez de upper_bound): p: 0 0 0 1 2 3 valor: 8 en vez de 9La línea
assertde las pruebas que lo detecta tiene justo dos clases que se tocan en un borde.
Paso 4: reconstruir
T[n] dice cuánto vale lo mejor, no qué clases son. Pero la tabla guarda lo necesario para averiguarlo. En cada j, T[j] se obtuvo con una de las dos opciones, y mirando los números se sabe con cuál:
algoritmo elegir_clases(clases, p, T, n)
    elegidas ← lista vacía
    j ← n
    mientras j > 0 hacer
        si T[j] = T[j - 1] entonces
            j ← j - 1
        sino
            agregar clases[j - 1] a elegidas
            j ← p[j]
        fin si
    fin mientras
    devolver elegidas
fin algoritmo
Es correcto por lo siguiente. Si T[j] = T[j − 1], hay una solución óptima de las primeras j clases que no usa la última, y basta seguir buscando en T[j − 1]. Si no, la segunda opción de la recurrencia es la que da el máximo, así que T[j] = v(c[j − 1]) + T[p(j)]: se toma la clase y se sigue en p(j). Cada paso baja j en al menos 1, así que el recorrido cuesta O(n).
Hacia atrás:
  T[6] = 9 > T[5] = 8: se toma [8,11), j = p(6) = 3
  T[3] = 6 > T[2] = 4: se toma [3,7), j = p(3) = 1
  T[1] = 2 > T[0] = 0: se toma [0,3), j = p(1) = 0
Elegidas: [0,3) [3,7) [8,11), valor 9
En un empate, como en la fila 5, el recorrido prefiere no tomar la clase. Otra preferencia podría dar otra solución del mismo valor. Fíjense también en que la solución óptima no se parece a nada que haya elegido un greedy: toma [0, 3) y [3, 7), que se tocan justo en el borde, salta [4, 9), que es la de mayor valor, y salta [7, 10).
Las pruebas de test_examples.cpp comparan todo esto con la fuerza bruta en 3000 instancias al azar: el valor de la
tabla, que el p de la búsqueda binaria coincida con la definición, y que las clases reconstruidas sean compatibles y
sumen el óptimo.
Mochila 0/1
Hay n objetos, cada uno con un peso entero w ≥ 1 y un valor v ≥ 0, y una mochila con capacidad entera W. Hay que elegir objetos con peso total a lo sumo W y con el mayor valor total. Cada objeto se toma una vez o ninguna: por eso es 0/1.
Hay muchas situaciones con esta forma: qué proyectos financiar con un presupuesto, qué pedidos meter en un camión, qué archivos copiar en un disco. La estructura es la misma: recursos limitados, cada opción consume y aporta.
Los greedy que fallan
La idea natural es tomar primero lo que más rinde por kilo. Corramos knapsack_demo:
$ build/knapsack_demo
El ejemplo de la tabla:
  capacidad 9, objetos (peso, valor): (2, 3) (3, 4) (4, 5) (5, 8)
  óptimo por fuerza bruta: 13
  mayor valor/peso:        11
  mayor valor:             13
  sin capacidad en el subproblema: 12
  tabla:                   13

Un objeto valioso que no deja sitio:
  capacidad 10, objetos (peso, valor): (6, 30) (5, 20) (5, 20)
  óptimo por fuerza bruta: 40
  mayor valor/peso:        30
  mayor valor:             30
  sin capacidad en el subproblema: 30
  tabla:                   40
En el segundo bloque, el objeto (6, 30) tiene la mejor relación: 5 por unidad de peso, contra 4 de los otros. También tiene el mayor valor. Una vez dentro, quedan 4 unidades libres y no cabe nada. Los otros dos objetos juntos llenan la mochila y valen 40. El problema del greedy es el espacio que desperdicia: esa capacidad sobrante no vale nada.
En el primer bloque, valor/peso elige (5, 8) y (2, 3), con un peso de 7, y da 11. Lo óptimo es (4, 5) y (5, 8), con un peso de 9 y un valor de 13.
Otra vez: elegir una regla razonable no basta. Aquí ninguna regla simple es correcta. Vamos a tener que considerar las dos opciones para cada objeto.
Paso 1: el subproblema, y un intento que falla
La primera idea es copiar los intervalos: “lo mejor con los primeros i objetos”. Para decidir sobre el objeto i − 1, miramos lo mejor con los i − 1 anteriores y vemos si el objeto cabe. Ese es el valor de la línea “sin capacidad en el subproblema” de la salida anterior. En cada paso se guarda un único resultado y se le agrega el objeto si todavía cabe. Da 12 en lugar de 13.
¿Qué pasó? Con los primeros tres objetos, la mejor mochila pesa 9 y vale 12: (2, 3), (3, 4) y (4, 5). Ya no cabe (5, 8). Pero la solución óptima no usa “lo mejor con tres objetos”, sino lo mejor con tres objetos dejando 5 unidades libres. Esa es una pregunta distinta, y tiene otra respuesta: (4, 5), que pesa 4.
Error común. Definir un subproblema que no lleva la información necesaria para decidir. Una señal: al escribir la recurrencia, necesitan saber algo que la casilla no dice, como “cuánta capacidad queda” o “qué clase tomé antes”. La solución no es guardar más cosas dentro de la casilla. Es agregar un parámetro. En los intervalos no hizo falta, porque el orden por fin y p(j) ya resumen todo lo que importa del pasado. En la mochila sí hace falta.
Subproblema. K(i, c) es el máximo valor que se puede obtener usando solo los primeros i objetos, con capacidad c. La respuesta al problema es K(n, W).
Paso 2: la recurrencia
Miremos el último objeto disponible, el de índice i − 1, con peso w y valor v. O no se usa, o se usa, y si se usa, le quita w a la capacidad:
K(0, c) = 0
K(i, c) = K(i - 1, c)                                 si w > c
K(i, c) = máx( K(i - 1, c),  v + K(i - 1, c - w) )    si w ≤ c
Teorema. K(i, c), calculado con esa recurrencia, es el máximo valor de un subconjunto de los primeros i objetos con peso total a lo sumo c.
Técnica. Inducción sobre i, para toda capacidad c de 0 a W. Sea OPT(i, c) el valor que dice la frase.
Caso base. Con 0 objetos, solo se puede tomar el conjunto vacío, que vale 0 y pesa 0 ≤ c.
Paso. Supongamos que la fórmula da OPT(i − 1, c′) para todo c′.
(≤) Tomemos un subconjunto óptimo S de los primeros i objetos, con peso a lo sumo c. Si no usa el objeto i − 1, es un subconjunto de los primeros i − 1, y vale a lo sumo OPT(i − 1, c). Si lo usa, entonces w ≤ c, porque cabe. Quitándolo, queda un subconjunto de los primeros i − 1 con peso a lo sumo c − w, que vale a lo sumo OPT(i − 1, c − w). Así que S vale a lo sumo v + OPT(i − 1, c − w).
(≥) Todo subconjunto de los primeros i − 1 objetos es también un subconjunto de los primeros i, así que OPT(i, c) ≥ OPT(i − 1, c). Si w ≤ c, a un subconjunto de los primeros i − 1 con peso a lo sumo c − w se le puede agregar el objeto i − 1. El objeto no estaba, porque el subconjunto usa solo objetos anteriores, y el total pesa a lo sumo c. Así que OPT(i, c) ≥ v + OPT(i − 1, c − w). ∎
Observen dónde se usa que cada objeto se toma una sola vez: en que el segundo término lee la fila i − 1, no la fila i. Eso es lo que impide tomarlo de nuevo, y vamos a volver a esa línea en un momento.
Paso 3: el orden y el costo
La fila i solo lee la fila i − 1. Se llena fila por fila.
algoritmo mochila(pesos, valores, n, W)
    T ← matriz de (n + 1) por (W + 1), toda en cero
    para i desde 1 hasta n hacer
        para c desde 0 hasta W hacer
            T[i][c] ← T[i - 1][c]
            si pesos[i - 1] ≤ c entonces
                T[i][c] ← máx(T[i][c], valores[i - 1] + T[i - 1][c - pesos[i - 1]])
            fin si
        fin para
    fin para
    devolver T[n][W]
fin algoritmo
Son (n + 1)(W + 1) casillas, y cada una cuesta O(1). El costo es Θ(nW) en tiempo y en memoria, con n, W ≥ 1.
struct Item {
    std::size_t weight;
    long long value;
};

// table[i][c]: el máximo valor con los primeros i objetos y capacidad c.
inline std::vector<std::vector<long long>> knapsack_table(const std::vector<Item>& items, std::size_t capacity) {
    const std::size_t n = items.size();
    std::vector<std::vector<long long>> table(n + 1, std::vector<long long>(capacity + 1, 0));
    for (std::size_t i = 1; i <= n; i++) {
        const Item& item = items[i - 1];
        for (std::size_t c = 0; c <= capacity; c++) {
            table[i][c] = table[i - 1][c];  // sin el objeto
            if (item.weight <= c) {
                table[i][c] = std::max(table[i][c], item.value + table[i - 1][c - item.weight]);
            }
        }
    }
    return table;
}
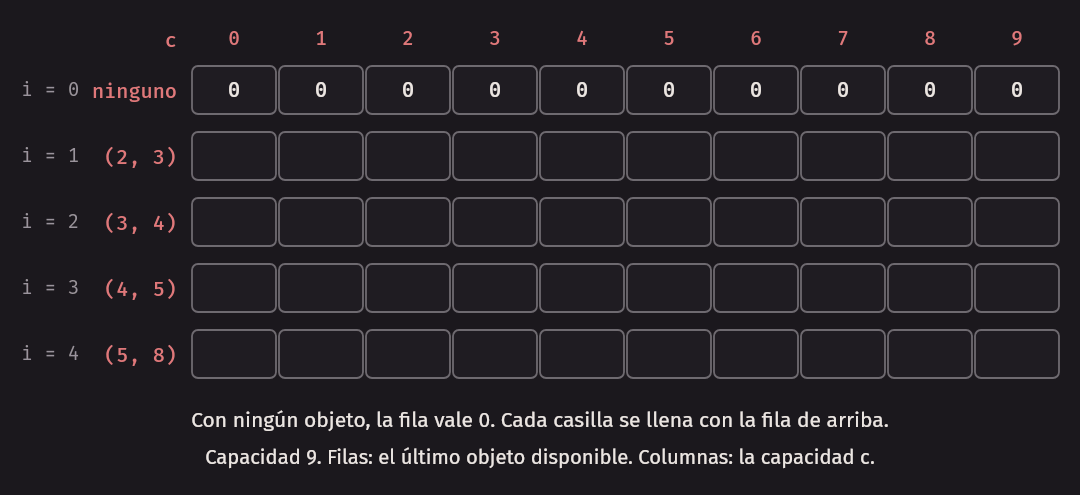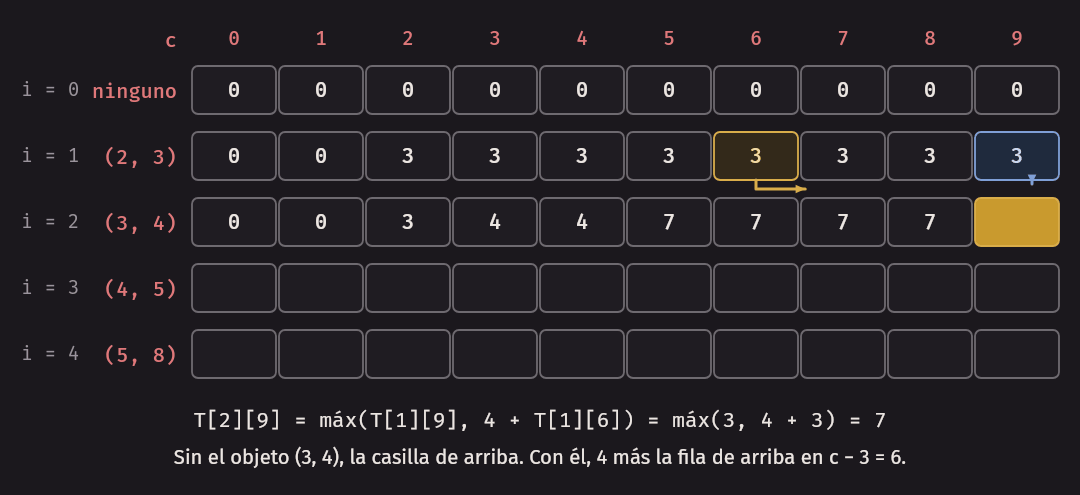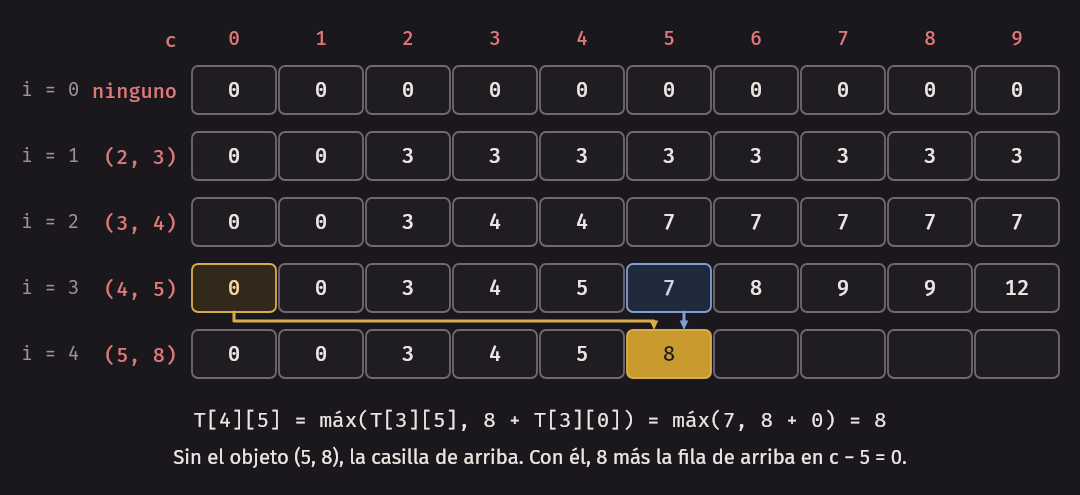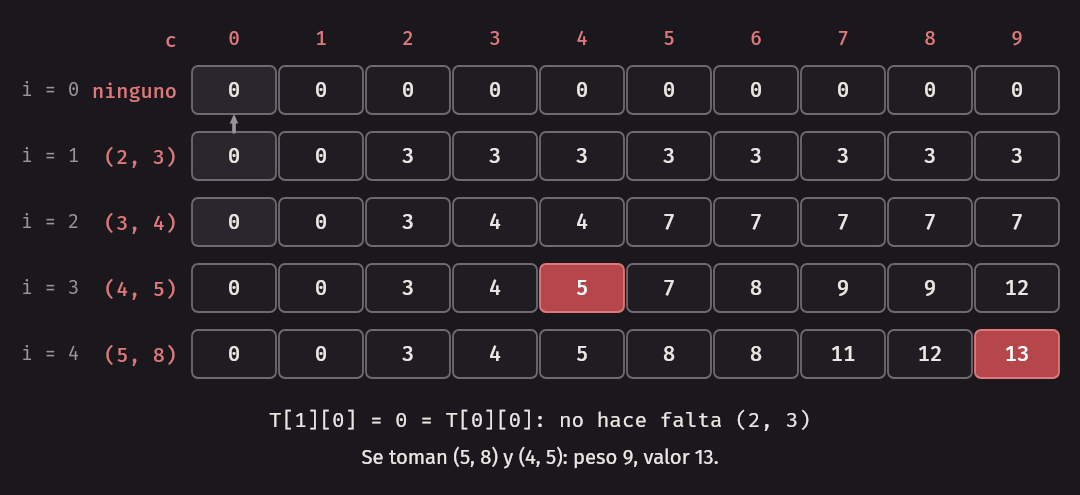
Esta es la tabla del primer ejemplo. Las filas tienen el último objeto disponible, y las columnas la capacidad.
        c:  0  1  2  3  4  5  6  7  8  9
ninguno     0  0  0  0  0  0  0  0  0  0
(2, 3)      0  0  3  3  3  3  3  3  3  3
(3, 4)      0  0  3  4  4  7  7  7  7  7
(4, 5)      0  0  3  4  5  7  8  9  9 12
(5, 8)      0  0  3  4  5  8  8 11 12 13
Veamos la casilla de la última fila con c = 9. Sin el objeto (5, 8), lo mejor es la casilla de arriba, 12. Con él, 8 más lo que había en la fila anterior con c = 9 − 5 = 4, que es 5: da 13. Se queda con 13.
Y en la fila (4, 5), c = 4 vale 5 y c = 9 vale 12. Son dos respuestas distintas para los mismos objetos. Por eso hacía falta la capacidad en el subproblema.
Paso 4: reconstruir
Se empieza en la esquina T[n][W]. Si la casilla es igual a la de arriba, hay una solución óptima sin ese objeto. Si es distinta, el objeto se usó, y se sigue en la fila anterior, con la capacidad que le quedaba.
algoritmo elegir_objetos(pesos, T, n, W)
    elegidos ← lista vacía
    c ← W
    i ← n
    mientras i > 0 hacer
        si T[i][c] ≠ T[i - 1][c] entonces
            agregar i - 1 a elegidos
            c ← c - pesos[i - 1]
        fin si
        i ← i - 1
    fin mientras
    devolver elegidos
fin algoritmo
Hacia atrás:
T[4][9] = 13 != T[3][9] = 12: se toma (5, 8), c = 9 - 5
T[3][4] = 5 != T[2][4] = 4: se toma (4, 5), c = 4 - 4
T[2][0] = 0 = T[1][0]: no hace falta (3, 4)
T[1][0] = 0 = T[0][0]: no hace falta (2, 3)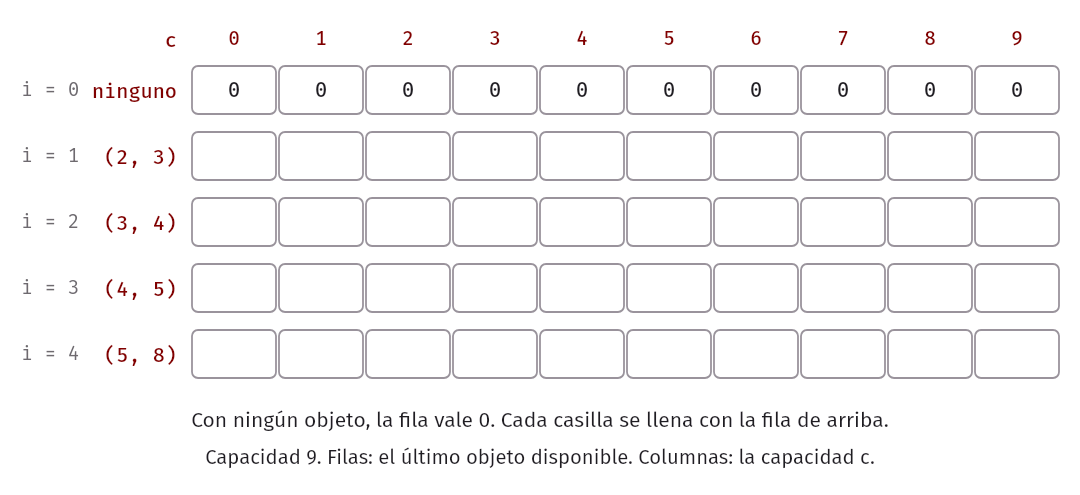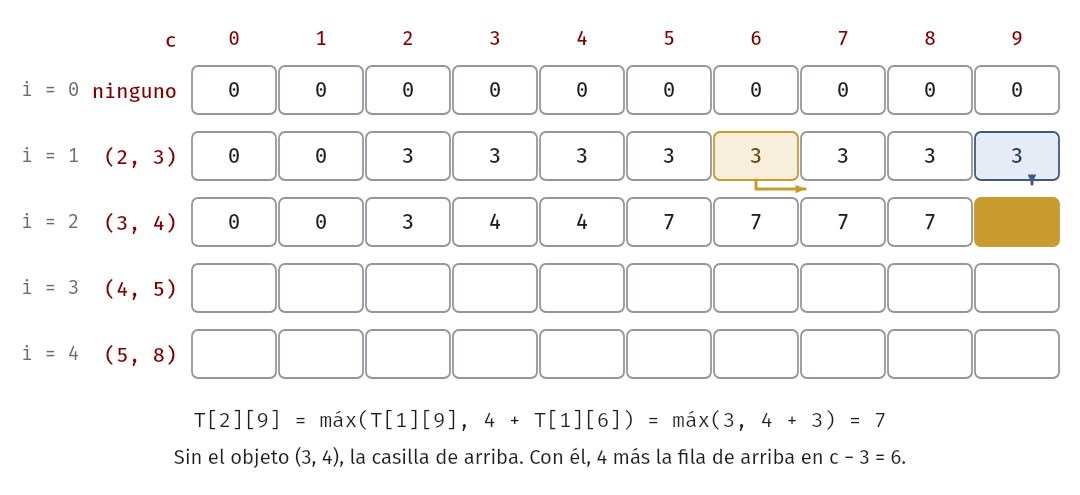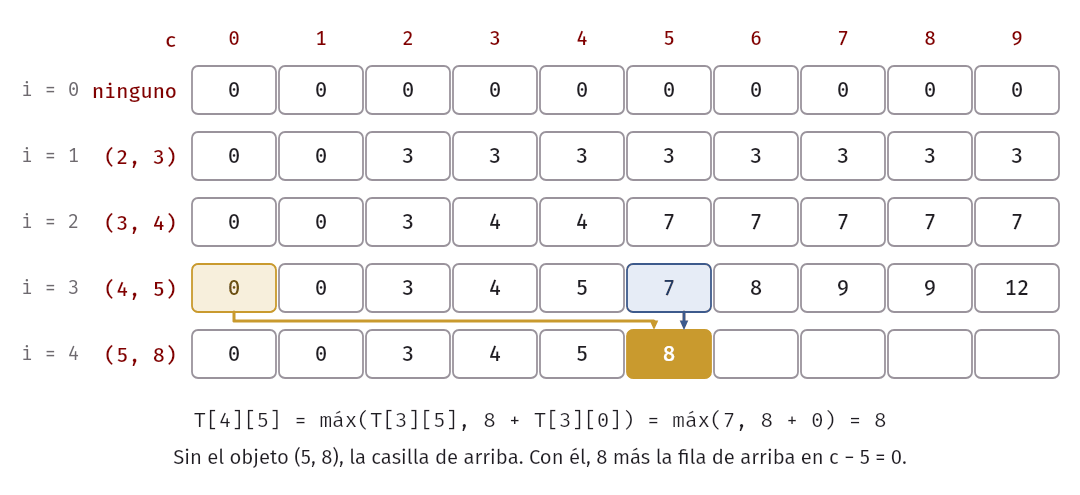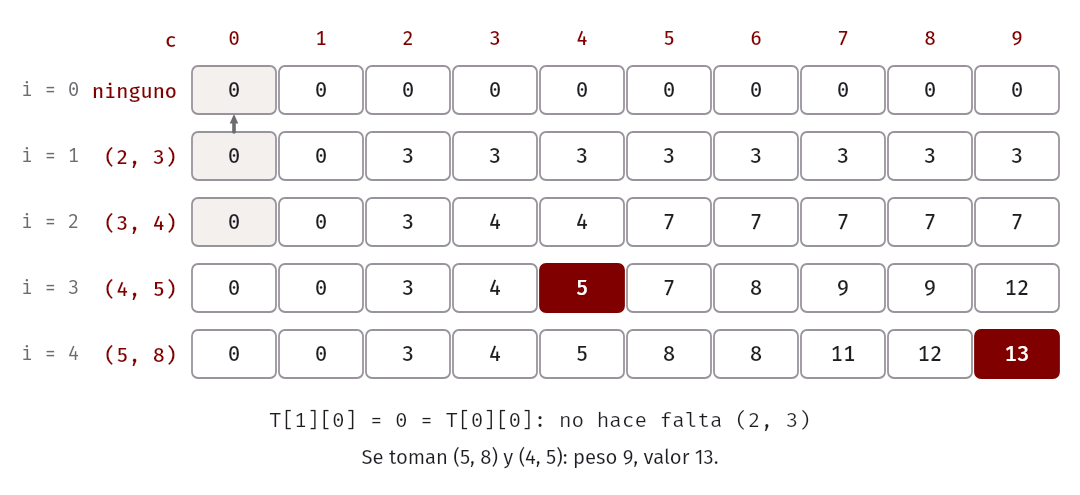
En la práctica. ¿Tabla o memoización? La tabla es más simple y sus ciclos son rápidos, pero llena todas las casillas. La memoización solo calcula los estados a los que la recursión llega, y eso puede ser mucho menos. En este ejemplo fueron 14 estados de 40. La línea que lo muestra es esta:
Con memoización: valor 13, 14 estados calculados de 40 casillas con i >= 1A cambio, cada llamada paga la función y la búsqueda en la tabla de memoización, y la recursión puede llegar a tener n niveles. Son dos formas de hacer lo mismo y, salvo en casos especiales, no cambian el orden de crecimiento del peor caso.
Pseudopolinomial: por qué O(nW) no es polinomial
Un algoritmo es polinomial si su costo está acotado por un polinomio en el tamaño de la entrada, medido en bits. Ese es el sentido preciso, y hasta ahora no hizo falta distinguirlo. Cuando la entrada son n números que caben en una palabra de la máquina, el tamaño es proporcional a n, y da lo mismo hablar de uno que del otro.
En la mochila no da lo mismo. La n cuenta objetos, pero W es un valor. Escribir W en binario toma ⌈log₂(W + 1)⌉ bits. El número 1 000 000 ocupa 20 bits, y con cada bit adicional W puede duplicarse.
Hagamos la cuenta. Tomemos n objetos y W = 2ᵇ − 1, con pesos y valores de a lo sumo b bits. La entrada mide Θ(n·b) bits. El algoritmo llena una tabla de (n + 1)·2ᵇ casillas. Con n fijo, el costo crece como 2ᵇ, mientras la entrada crece como b. Es exponencial en el tamaño de la entrada.
Definición. Un algoritmo es pseudopolinomial (pseudo-polynomial) si su costo está acotado por un polinomio en los valores de los números de la entrada, pero no en la cantidad de bits que los escriben. O(nW) es polinomial en n y en el valor de W. No lo es en n y log W.
Esto no es un detalle teórico. Lo podemos medir. pseudopoly_bench deja fijos los 200 objetos y aumenta W de bit en
bit, usando la versión de una fila que veremos enseguida. Se compila con -O2 y se toma el menor de 3 intentos. Es
una corrida en el contenedor del curso, con la máquina compartida, y los tiempos dependen de la máquina.
$ make bench
build/pseudopoly_bench
n = 200, pesos al azar entre 1 y W/2, menor de 3 intentos
 bits de W           W    casillas n·W          ms
       16       32768         6553600         2.0   (óptimo 15939427)
       17       65536        13107200         4.0   x2.02   (óptimo 19098483)
       18      131072        26214400         8.6   x2.14   (óptimo 19892176)
       19      262144        52428800        17.9   x2.08   (óptimo 16760028)
       20      524288       104857600        37.3   x2.09   (óptimo 19123141)
       21     1048576       209715200        74.3   x1.99   (óptimo 18208025)
       22     2097152       419430400       150.4   x2.02   (óptimo 18623276)
       23     4194304       838860800       302.4   x2.01   (óptimo 20579996)
       24     8388608      1677721600       684.9   x2.26   (óptimo 18984173)
       25    16777216      3355443200      1484.4   x2.17   (óptimo 16422278)
La columna x es el tiempo dividido entre el de la fila anterior. En este rango, cada bit más cuesta cerca del doble,
y la entrada apenas creció: 200 números con un bit más cada uno.
¿Qué pasa si W pasa de 10 bits a 40? W puede multiplicarse por cerca de 2³⁰, unos mil millones de veces, y la tabla también. Si se prolonga la última fila hasta 40 bits, duplicando 15 veces, salen unas 13 horas, y la fila única pesaría más de 4 TB. Es una extrapolación con la cuenta, no una medición. La entrada, mientras tanto, solo pasó de 10 a 40 bits por número.
Dos aclaraciones, para no pasarse al otro extremo:
- Pseudopolinomial no significa inútil. Si W es pequeño, O(nW) es excelente. Con 1000 objetos y W de hasta unos pocos millones, según la tabla de arriba, son segundos. Los pesos que vienen de cantidades reales, como dinero en céntimos, muchas veces cumplen esto. Otras veces no: una capacidad en bytes de un disco grande ya no entra.
- Mejorarlo no es cuestión de un truco. Nadie conoce un algoritmo para la mochila que sea polinomial en n y log W. El motivo es el tema de la última parte del curso. Esto volverá en la semana 14.
Idea clave. Para saber si un costo es polinomial, pregunten por cada letra: ¿cuenta cosas de la entrada, o es el valor de un número de la entrada? Un arreglo de n elementos ocupa al menos n unidades, pero un número W se escribe en log W bits.
Ahorrar memoria: una sola fila
Con 1000 objetos y W = 1 000 000, la tabla completa tiene unas 10⁹ casillas de 8 bytes: 8 GB. Pero cada fila solo lee la anterior. Si solo se quiere el valor, basta guardar una fila, sobrescribiéndola: 8 MB.
Aquí hay una trampa. Con una sola fila, la casilla c tiene que calcularse con la fila anterior en c y en c − w. El orden en que se recorre la capacidad decide si esa casilla c − w todavía es de la fila anterior.
algoritmo mochila_una_fila(pesos, valores, n, W)
    fila ← arreglo de W + 1 ceros
    para i desde 0 hasta n - 1 hacer
        c ← W
        mientras c ≥ pesos[i] hacer
            fila[c] ← máx(fila[c], valores[i] + fila[c - pesos[i]])
            c ← c - 1
        fin mientras
    fin para
    devolver fila[W]
fin algoritmo
Afirmación. Con la capacidad de mayor a menor, al terminar la vuelta del objeto i, fila[c] = K(i + 1, c) para toda capacidad c.
Técnica. Un invariante del ciclo interno. Al empezar la vuelta del objeto i, por inducción, la fila es K(i, ·). Justo antes de escribir la casilla c, las casillas mayores que c ya tienen K(i + 1, ·), y las casillas menores o iguales que c todavía tienen K(i, ·). Como w ≥ 1, la casilla c − w es menor que c y sigue teniendo K(i, c − w). Y fila[c] vale K(i, c). La línea calcula exactamente máx(K(i, c), v + K(i, c − w)) = K(i + 1, c), y el invariante se mantiene al bajar c. Las casillas con c < w no se tocan, y eso es correcto, porque ahí K(i + 1, c) = K(i, c). ∎
Al revés, el programa resuelve otro problema
Si la capacidad se recorre de menor a mayor, el programa compila, no se cae y da un número. Veamos un solo objeto, con peso 2 y valor 3, capacidad 6:
$ build/knapsack_direction
Un solo objeto (peso 2, valor 3), capacidad 6

De mayor a menor:
         c:  0  1  2  3  4  5  6
tras c = 6:  0  0  0  0  0  0  3
tras c = 5:  0  0  0  0  0  3  3
tras c = 4:  0  0  0  0  3  3  3
tras c = 3:  0  0  0  3  3  3  3
tras c = 2:  0  0  3  3  3  3  3

De menor a mayor:
         c:  0  1  2  3  4  5  6
tras c = 2:  0  0  3  0  0  0  0
tras c = 3:  0  0  3  3  0  0  0
tras c = 4:  0  0  3  3  6  0  0
tras c = 5:  0  0  3  3  6  6  0
tras c = 6:  0  0  3  3  6  6  9

Los objetos del ejemplo, capacidad 9
  tabla completa:      13
  fila, mayor a menor: 13
  fila, menor a mayor: 14
  sin límite de copias: 14
De menor a mayor, al llegar a c = 4, la casilla c − 2 = 2 ya vale 3, y ya incluye el objeto. Se lo vuelve a sumar y da 6: el mismo objeto dos veces. Con c = 6 da 9: tres veces.
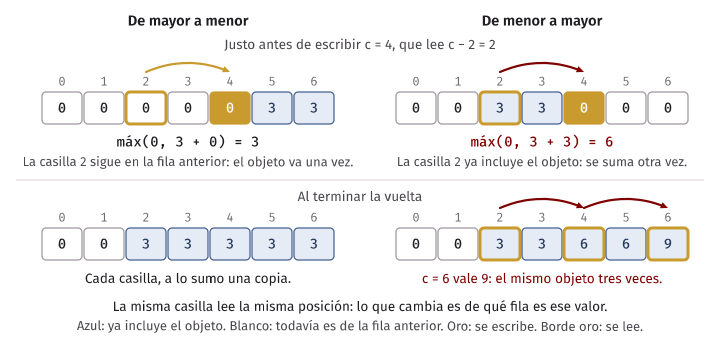
No es un error cualquiera, sino que resuelve exactamente otro problema: la mochila sin límite de copias (unbounded
knapsack), en la que cada objeto se puede tomar cuantas veces se quiera. En esa versión, la recurrencia del último
objeto lee la misma fila: U(i, c) = máx(U(i − 1, c), v + U(i, c − w)). Y eso es lo que calcula el recorrido de menor a
mayor, porque la casilla c − w ya es de la fila i. Las pruebas lo comprueban: en 3000 instancias al azar, esta versión
coincide siempre con una función aparte, unbounded_knapsack, que se calcula con su propia recurrencia.
Por eso este error es peligroso. El resultado es plausible, solo un poco mayor. En el ejemplo sale 14 en vez de 13, y en las instancias en que no conviene repetir objetos sale la respuesta correcta.
En C++. Bajar con un
std::size_ttiene su propia trampa: la condiciónc >= 0es siempre cierta. Una forma segura es comparar y decrementar en la misma condición:inline long long knapsack_one_row(const std::vector<Item>& items, std::size_t capacity) { std::vector<long long> row(capacity + 1, 0); for (const Item& item : items) { for (std::size_t c = capacity + 1; c-- > item.weight;) { row[c] = std::max(row[c], item.value + row[c - item.weight]); } } return row[capacity]; }El cuerpo corre con c desde
capacityhastaitem.weight, ambos incluidos. Si el objeto pesa más que la capacidad, no corre.
Hay un precio. Con una sola fila ya no se puede caminar hacia atrás: las filas anteriores se perdieron. Si hace falta
la solución y no solo el valor, hay que guardar algo más, por ejemplo un bit por casilla que diga si el objeto se usó.
Eso sigue siendo nW bits, pero son 64 veces menos que una tabla de long long.
Subsecuencia y subcadena
Con esto termina la Sesión A. La Sesión B usa el mismo método sobre dos cadenas. Empecemos por una definición en que es muy fácil equivocarse.
Sean dos cadenas. Una subcadena (substring) es un tramo contiguo: en algoritmo, ritmo es una subcadena. Una
subsecuencia (subsequence) se obtiene borrando caracteres, sin cambiar el orden de los que quedan, y sin necesidad
de que estén seguidos: lgrimo es una subsecuencia de algoritmo, y no es una subcadena.
Definición. Una cadena z de largo k es subsecuencia de a si hay posiciones p₁ < p₂ < ⋯ < pₖ de a con a[pₜ] = z[t] para cada t. Una subsecuencia común de a y b es una subsecuencia de las dos. La subsecuencia común más larga (longest common subsequence, LCS) es una de largo máximo.
Puede haber varias subsecuencias comunes más largas. Así que hablamos de una LCS, y del largo de la LCS.
Error común. Confundir subsecuencia con subcadena. La subcadena tiene que ser contigua, y no da lo mismo:
Estas son las últimas líneas de la salida de
lcs_demo:Largo: 7 Hacia atrás, prefiriendo subir: lgritmo Hacia atrás, prefiriendo la izquierda: loritmo Subcadena común más larga: ritmoEntre
algoritmoylogaritmo, el tramo seguido más largo tiene 5 letras, y la subsecuencia común más larga tiene 7. Son problemas distintos, con recurrencias distintas. La de la subcadena mira un tramo que termina justo ahí y se corta: si los caracteres difieren, la casilla vale 0, y la respuesta es el máximo de toda la tabla y no la esquina.
Subsecuencia común más larga
Hay 2ⁿ subsecuencias de una cadena de largo n, así que probarlas todas no es una opción. Sigamos el método.
Paso 1: el subproblema
Vamos a mirar el último carácter de cada cadena, así que el subproblema son dos prefijos. Como en la semana 4, los escribimos semiabiertos: a[0..i) son los i primeros caracteres de a.
Subproblema. L(i, j) es el largo de la subsecuencia común más larga de a[0..i) y b[0..j). La respuesta al problema es L(n, m), con n y m los largos de a y b.
Paso 2: la recurrencia
L(i, 0) = 0
L(0, j) = 0
L(i, j) = L(i - 1, j - 1) + 1                     si a[i - 1] = b[j - 1]
L(i, j) = máx( L(i - 1, j),  L(i, j - 1) )        si a[i - 1] ≠ b[j - 1]
Son dos casos muy distintos. Si los últimos caracteres son iguales, la recurrencia no prueba nada: los empareja sin mirar alternativas. Eso suena como un greedy, y por eso hay que demostrarlo. ¿No podría convenir guardar ese carácter para otra pareja? Si son distintos, dice que uno de los dos sobra. ¿Por qué no pueden servir los dos?
Los dos casos se apoyan en un hecho simple sobre las posiciones de una subsecuencia.
Lema de la última posición. Sea z una subsecuencia común de a[0..i) y b[0..j), de largo k ≥ 1, con sus posiciones p₁ < ⋯ < pₖ en a y q₁ < ⋯ < qₖ en b. Entonces solo el último carácter de z puede usar la posición i − 1 de a o la posición j − 1 de b. Los demás, por ser crecientes las posiciones, están en a[0..i − 1) y b[0..j − 1).
Teorema. L(i, j) dada por la recurrencia es el largo de la subsecuencia común más larga de a[0..i) y b[0..j).
Técnica. Inducción sobre el orden de la tabla: fila por fila, y dentro de cada fila, de izquierda a derecha. Las tres casillas que la recurrencia lee, (i − 1, j − 1), (i − 1, j) e (i, j − 1), van antes de (i, j). Sea OPT(i, j) el largo que dice la frase. Supongamos que la recurrencia da OPT en todas las casillas anteriores.
Casos base. Si un prefijo es vacío, la única subsecuencia común es la vacía. Su largo es 0.
Caso igual: a[i − 1] = b[j − 1] = x.
(≥) Tomemos una subsecuencia común más larga de a[0..i − 1) y b[0..j − 1), y agreguémosle x al final. Sigue siendo subsecuencia de a[0..i), porque la posición i − 1 está después de todas las usadas. Lo mismo en b. Tiene largo OPT(i − 1, j − 1) + 1, así que OPT(i, j) ≥ OPT(i − 1, j − 1) + 1.
(≤) Tomemos una subsecuencia común z de a[0..i) y b[0..j). Si está vacía, no hay nada que probar. Si no, quitémosle el último carácter. Por el lema, lo que queda es subsecuencia común de a[0..i − 1) y b[0..j − 1), así que su largo es a lo sumo OPT(i − 1, j − 1). Por lo tanto, |z| ≤ OPT(i − 1, j − 1) + 1.
Esto responde la duda sobre emparejar sin mirar. Ninguna subsecuencia común puede superar a OPT(i − 1, j − 1) + 1, y emparejar los dos últimos caracteres alcanza exactamente ese valor. No perdemos nada con hacerlo, aunque en alguna solución óptima esos caracteres estén emparejados con otros: siempre hay otra solución óptima, del mismo largo, que los empareja entre sí. No es que sea la única opción, sino que no hay ninguna mejor. Y vale aunque x aparezca muchas veces.
Caso distinto: a[i − 1] ≠ b[j − 1].
(≥) Una subsecuencia común de a[0..i − 1) y b[0..j) también lo es de a[0..i) y b[0..j). Lo mismo si se acorta b. Así que OPT(i, j) ≥ máx(OPT(i − 1, j), OPT(i, j − 1)).
(≤) Tomemos una subsecuencia común z de a[0..i) y b[0..j), con sus posiciones. Si está vacía, no hay nada que probar. Si no, su último carácter usa la posición pₖ en a y qₖ en b. Las dos no pueden ser a la vez i − 1 y j − 1, porque ese carácter sería a la vez a[i − 1] y b[j − 1], y esos son distintos. Entonces pₖ < i − 1 o qₖ < j − 1. Por el lema, en el primer caso z no usa la posición i − 1 de a, y es subsecuencia común de a[0..i − 1) y b[0..j). En el segundo, no usa la posición j − 1 de b. En cualquiera de los dos, |z| es a lo sumo el máximo de la recurrencia. ∎
Paso 3: el orden y el costo
algoritmo lcs(a, n, b, m)
    L ← matriz de (n + 1) por (m + 1), toda en cero
    para i desde 1 hasta n hacer
        para j desde 1 hasta m hacer
            si a[i - 1] = b[j - 1] entonces
                L[i][j] ← L[i - 1][j - 1] + 1
            sino
                L[i][j] ← máx(L[i - 1][j], L[i][j - 1])
            fin si
        fin para
    fin para
    devolver L[n][m]
fin algoritmo
Son (n + 1)(m + 1) casillas, y cada una cuesta O(1). El costo es Θ(nm) en tiempo y memoria, con n, m ≥ 1. Aquí n y m son largos de cadenas que están en la entrada, así que este costo sí es polinomial. Compárenlo con la mochila.
Si solo interesa el largo, bastan dos filas, con el mismo argumento de la sección anterior: cada fila solo lee a la anterior. Aquí hay que guardar dos filas, o una más una variable, porque la casilla lee también su vecina izquierda ya actualizada y su diagonal.
Esta es la tabla de algoritmo y logaritmo, con la que empieza la salida de lcs_demo:
     l o g a r i t m o
   0 0 0 0 0 0 0 0 0 0
a  0 0 0 0 1 1 1 1 1 1
l  0 1 1 1 1 1 1 1 1 1
g  0 1 1 2 2 2 2 2 2 2
o  0 1 2 2 2 2 2 2 2 3
r  0 1 2 2 2 3 3 3 3 3
i  0 1 2 2 2 3 4 4 4 4
t  0 1 2 2 2 3 4 5 5 5
m  0 1 2 2 2 3 4 5 6 6
o  0 1 2 2 2 3 4 5 6 7
La fila 0 y la columna 0 son los prefijos vacíos. Veamos la casilla (3, 3), fila g y columna g: los caracteres
coinciden, y vale la diagonal más uno, 1 + 1 = 2. A su derecha, la casilla (3, 4), fila g y columna a: los
caracteres difieren, y vale el máximo de arriba (1) y de la izquierda (2).
Paso 4: reconstruir
Se camina desde la esquina (n, m). Si los caracteres coinciden, ese carácter va en la respuesta, y se sigue por la diagonal. Si difieren, se va a la casilla vecina con el mayor valor, de arriba o de la izquierda. Los caracteres salen de atrás hacia adelante, así que al final se invierte.
algoritmo reconstruir_lcs(a, n, b, m, L)
    salida ← lista vacía
    i ← n
    j ← m
    mientras i > 0 y j > 0 hacer
        si a[i - 1] = b[j - 1] entonces
            agregar a[i - 1] a salida
            i ← i - 1
            j ← j - 1
        sino si L[i - 1][j] ≥ L[i][j - 1] entonces
            i ← i - 1
        sino
            j ← j - 1
        fin si
    fin mientras
    devolver salida invertida
fin algoritmo
Cada paso va a una casilla que explica el valor de la actual, de acuerdo con la recurrencia, y cada coincidencia suma exactamente una unidad. Por eso la salida tiene largo L(n, m) y es subsecuencia de las dos cadenas. El recorrido cuesta O(n + m).
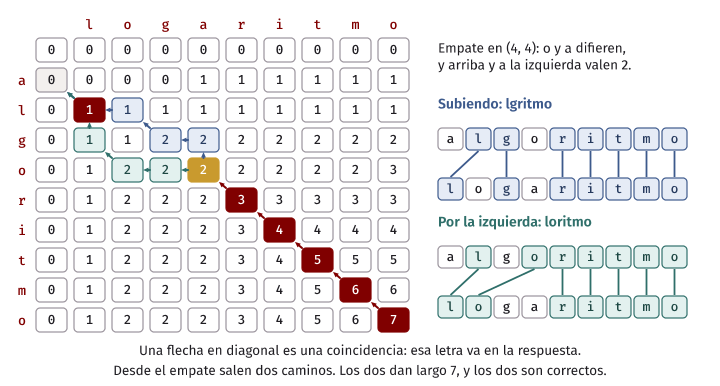
Cuando arriba y a la izquierda valen lo mismo, cualquiera de las dos sirve, y eso da subsecuencias distintas. En
nuestro ejemplo, después de emparejar o, m, t, i y r, se llega a la casilla (4, 4), que tiene o en una
cadena y a en la otra, y vale 2. Arriba hay un 2, y a la izquierda otro 2. Subiendo sale lgritmo, y yendo a la
izquierda sale loritmo. Las dos son correctas. Las pruebas comprueban ambas direcciones con la fuerza bruta en 3000
pares de cadenas al azar.
// lcs[i][j]: el largo de la subsecuencia común más larga de a[0..i) y b[0..j).
inline Table lcs_table(const std::string& a, const std::string& b) {
    Table lcs(a.size() + 1, std::vector<int>(b.size() + 1, 0));
    for (std::size_t i = 1; i <= a.size(); i++) {
        for (std::size_t j = 1; j <= b.size(); j++) {
            if (a[i - 1] == b[j - 1]) {
                lcs[i][j] = lcs[i - 1][j - 1] + 1;
            } else {
                lcs[i][j] = std::max(lcs[i - 1][j], lcs[i][j - 1]);
            }
        }
    }
    return lcs;
}
Error común. Confundir índices de casilla e índices de cadena. La casilla (i, j) habla de los prefijos de largo i y j, y sus últimos caracteres son a[i − 1] y b[j − 1]. Por eso la tabla tiene una fila y una columna más que las cadenas, y por eso todo empieza en 1. Escribir
a[i]en la casilla (i, j) compara los caracteres equivocados, y en la última fila lee una posición que no es parte de la cadena. Con unstd::vector, eso ya es salirse del arreglo.
Distancia de edición
¿Cuántos cambios separan a casa de cosas? Se puede cambiar la a por una o y agregar una s al final: 2
cambios. ¿Se puede con menos?
Definición. Una operación sobre una cadena es una de estas tres, y cada una cuesta 1:
- Insertar un carácter en cualquier posición.
- Borrar un carácter.
- Cambiar un carácter por otro.
La distancia de edición (edit distance) entre a y b es el mínimo de operaciones para convertir a en b. En esta forma con los tres costos iguales a 1 se le suele llamar distancia de Levenshtein.
Esta definición permite cosas raras: insertar un carácter y después borrarlo, o cambiar el mismo carácter tres veces, o pasar por cadenas más largas que las dos. Nada de eso debería ayudar, pero hay que demostrarlo. Para eso conviene otro punto de vista.
Alineamientos
Un alineamiento (alignment) de a y b los escribe en dos filas, una encima de la otra, con huecos, sin cambiar el orden de sus caracteres:
c a s a -
c o s a s
Cada columna tiene un carácter de a arriba, o un hueco, y un carácter de b abajo, o un hueco. Ninguna columna tiene dos huecos. El costo de un alineamiento es la cantidad de columnas en las que las dos filas difieren. Este tiene costo 2.
Lema. La distancia de edición entre a y b es igual al mínimo costo de un alineamiento de a y b.
Técnica. Dos desigualdades. Una se obtiene leyendo un alineamiento como una lista de operaciones, y la otra se obtiene por inducción sobre el número de operaciones.
La distancia es a lo sumo el mínimo costo. Un alineamiento de costo k da k operaciones. Se recorren las columnas de izquierda a derecha. Una columna con dos caracteres distintos es un cambio, una con hueco abajo es un borrado, y una con hueco arriba es una inserción. Las columnas iguales no hacen nada. Al terminar, a se convirtió en b.
El mínimo costo es a lo sumo la distancia. Mostremos que si a se convierte en una cadena s con k operaciones, entonces hay un alineamiento de a y s con costo a lo sumo k. Por inducción sobre k. Con k = 0, s = a, y se alinea cada carácter con sí mismo, a costo 0. Supongamos que vale para k − 1 operaciones, con un alineamiento de a y una cadena s′, y que s sale de s′ con una operación más. Modifiquemos la fila de abajo:
- Si la operación cambia un carácter de s′, cambia en su columna. Esa columna puede pasar de costar 0 a costar 1. Las demás no se mueven.
- Si inserta un carácter, se agrega una columna con hueco arriba y ese carácter abajo. Eso suma 1.
- Si borra un carácter de s′, en su columna queda un hueco abajo. Si arriba había un carácter, la columna cuesta 1 ahora, y antes costaba 0 o 1. Si arriba había un hueco, la columna queda con dos huecos, se elimina, y el costo baja en 1.
En todos los casos, el costo sube a lo sumo 1. Tomando s = b, sale un alineamiento de a y b con costo a lo sumo k. ∎
Esto responde las rarezas: toda secuencia de operaciones, por retorcida que sea, se puede cambiar por un alineamiento que no cuesta más. Y un alineamiento toca cada posición una sola vez. A partir de aquí trabajamos con alineamientos.
Paso 1: el subproblema
Otra vez, dos prefijos.
Subproblema. D(i, j) es la distancia de edición entre a[0..i) y b[0..j). La respuesta al problema es D(n, m).
Paso 2: la recurrencia
Miremos la última columna de un alineamiento de a[0..i) y b[0..j). Solo hay tres formas posibles:
a[i-1]      -        a[i-1]
  -       b[j-1]     b[j-1]
borrar   insertar    cambiar, o conservar si son iguales
Eso da la recurrencia, con sus casos base:
D(i, 0) = i
D(0, j) = j
D(i, j) = mín( D(i - 1, j) + 1,  D(i, j - 1) + 1,  D(i - 1, j - 1) + d )
              donde d = 0 si a[i - 1] = b[j - 1], y d = 1 si no
Teorema. D(i, j) dada por la recurrencia es el mínimo costo de un alineamiento de a[0..i) y b[0..j).
Técnica. Inducción sobre el orden de la tabla, fila por fila y de izquierda a derecha.
Casos base. Si b[0..0) está vacía, todo alineamiento de a[0..i) tiene en cada columna un carácter arriba y un hueco abajo. Hay exactamente uno, con i columnas y costo i. Lo mismo para D(0, j), y con j columnas.
Paso. Sea i, j ≥ 1, y supongamos que la recurrencia es correcta en todas las casillas anteriores. Entre ellas están (i − 1, j), (i, j − 1) e (i − 1, j − 1).
(≥) Tomemos un alineamiento de costo mínimo de a[0..i) y b[0..j). Tiene al menos una columna, porque i ≥ 1. Su última columna es de una de las tres formas. Si se quita, queda un alineamiento de los prefijos acortados según esa forma, y el costo baja en lo que costaba esa columna: 1, 1 o d. El alineamiento que queda cuesta al menos lo que dice su casilla, por la hipótesis. Por lo tanto, el costo mínimo es mayor o igual que uno de los tres términos, y entonces mayor o igual que su mínimo.
(≤) Cada término se puede alcanzar. A un alineamiento óptimo de a[0..i − 1) y b[0..j) se le agrega la columna de a[i − 1] con hueco, y sale un alineamiento de a[0..i) y b[0..j) con costo D(i − 1, j) + 1. Igual con las otras dos formas. Por lo tanto, el costo mínimo es menor o igual que los tres, y entonces menor o igual que su mínimo. ∎
Paso 3: el orden y el costo
La tabla tiene (n + 1) por (m + 1) casillas, y cada casilla lee tres vecinas, arriba, a la izquierda y en diagonal. Fila por fila, las tres están listas. El costo es Θ(nm) en tiempo y en memoria, con n, m ≥ 1.
algoritmo distancia_edicion(a, n, b, m)
    D ← matriz de (n + 1) por (m + 1)
    para i desde 0 hasta n hacer
        D[i][0] ← i
    fin para
    para j desde 0 hasta m hacer
        D[0][j] ← j
    fin para
    para i desde 1 hasta n hacer
        para j desde 1 hasta m hacer
            si a[i - 1] = b[j - 1] entonces
                d ← 0
            sino
                d ← 1
            fin si
            D[i][j] ← mín(D[i - 1][j] + 1, D[i][j - 1] + 1, D[i - 1][j - 1] + d)
        fin para
    fin para
    devolver D[n][m]
fin algoritmo
// dist[i][j]: el mínimo de operaciones para convertir a[0..i) en b[0..j).
inline Table edit_table(const std::string& a, const std::string& b) {
Table dist(a.size() + 1, std::vector<int>(b.size() + 1, 0));
for (std::size_t i = 0; i <= a.size(); i++) dist[i][0] = static_cast<int>(i);
for (std::size_t j = 0; j <= b.size(); j++) dist[0][j] = static_cast<int>(j);
for (std::size_t i = 1; i <= a.size(); i++) {
for (std::size_t j = 1; j <= b.size(); j++) {
const int change = a[i - 1] == b[j - 1] ? 0 : 1;
dist[i][j] = std::min({dist[i - 1][j] + 1, // borrar a[i - 1]
dist[i][j - 1] + 1, // insertar b[j - 1]
dist[i - 1][j - 1] + change}); // conservar o cambiar
}
}
return dist;
}Esta es la tabla de casa y cosas, con la que empieza la salida de edit_demo:
casa -> cosas
     c o s a s
   0 1 2 3 4 5
c  1 0 1 2 3 4
a  2 1 1 2 2 3
s  3 2 2 1 2 2
a  4 3 3 2 1 2
Distancia: 2
Sigamos un par de casillas, para que puedan rehacerla a mano.
| Casilla | Caracteres | Arriba + 1 | Izquierda + 1 | Diagonal + d | Valor |
|---|---|---|---|---|---|
| (1, 1) | c, c |
1 + 1 | 1 + 1 | 0 + 0 | 0 |
| (2, 2) | a, o |
1 + 1 | 1 + 1 | 0 + 1 | 1 |
| (3, 3) | s, s |
2 + 1 | 2 + 1 | 1 + 0 | 1 |
| (4, 4) | a, a |
2 + 1 | 2 + 1 | 1 + 0 | 1 |
| (4, 5) | a, s |
2 + 1 | 1 + 1 | 2 + 1 | 2 |
La fila 0 dice cuánto cuesta construir cada prefijo de cosas desde la nada: j inserciones. La columna 0 dice cuánto
cuesta borrar cada prefijo de casa: i borrados.
Paso 4: reconstruir
Se empieza en la esquina. En cada casilla se busca una de las tres opciones que explique su valor: por cómo se calculó, al menos una lo hace. Esa opción es la última columna de un alineamiento óptimo, y se sigue desde la casilla a la que lleva.
algoritmo reconstruir_edicion(a, n, b, m, D)
    columnas ← lista vacía
    i ← n
    j ← m
    mientras i > 0 o j > 0 hacer
        si i > 0 y j > 0 y a[i - 1] = b[j - 1] y D[i][j] = D[i - 1][j - 1] entonces
            agregar "conservar a[i - 1]" a columnas
            i ← i - 1
            j ← j - 1
        sino si i > 0 y j > 0 y D[i][j] = D[i - 1][j - 1] + 1 entonces
            agregar "cambiar a[i - 1] por b[j - 1]" a columnas
            i ← i - 1
            j ← j - 1
        sino si i > 0 y D[i][j] = D[i - 1][j] + 1 entonces
            agregar "borrar a[i - 1]" a columnas
            i ← i - 1
        sino
            agregar "insertar b[j - 1]" a columnas
            j ← j - 1
        fin si
    fin mientras
    devolver columnas invertida
fin algoritmo
Si hay varias opciones, cualquiera da un alineamiento óptimo. Este orden prefiere la diagonal, y luego borrar. El recorrido hace a lo sumo n + m pasos, y cuesta O(n + m).
Seguimos el recorrido de casa y cosas:
| Casilla | Valor | Qué la explica | Columna | Sigue en |
|---|---|---|---|---|
| (4, 5) | 2 | izquierda + 1 | insertar s |
(4, 4) |
| (4, 4) | 1 | diagonal + 0 | conservar a |
(3, 3) |
| (3, 3) | 1 | diagonal + 0 | conservar s |
(2, 2) |
| (2, 2) | 1 | diagonal + 1 | cambiar a por o |
(1, 1) |
| (1, 1) | 0 | diagonal + 0 | conservar c |
(0, 0) |
Alineamiento:
  casa-
  cosas
   *  *
Operaciones:
  cambiar a por o
  insertar s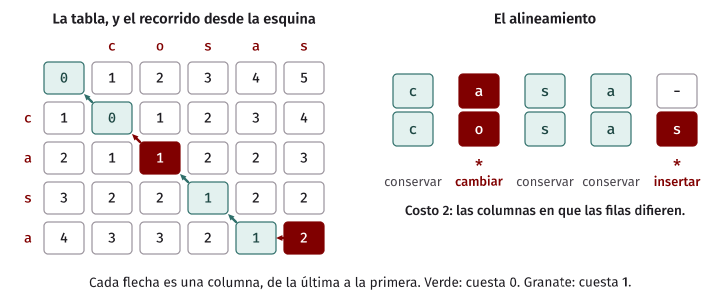
Las pruebas aplican las operaciones a la primera cadena y comprueban que sale la segunda, con un costo igual a la distancia, en 3000 pares al azar.
¿Y las rarezas de la definición? test_examples.cpp trae un árbitro que no sabe nada de alineamientos: una búsqueda
BFS sobre las cadenas, en la que cada arista es una operación. Es la definición tal cual, sin recurrencia. En 400
pares de cadenas cortas sobre {a, b}, permitiendo cadenas intermedias más largas, da lo mismo que la tabla.
Comparar versiones: dónde se usa
Si se quitan los cambios, y solo se permite borrar e insertar, el problema se convierte en uno que ya resolvimos.
Afirmación. El mínimo de operaciones para convertir a en b, solo con borrados e inserciones, es n + m − 2·L, donde L es el largo de la subsecuencia común más larga.
Técnica. Mirar lo que no se toca. Las columnas iguales de un alineamiento sin cambios son una subsecuencia común.
Primero, el lema de los alineamientos también vale con estas dos operaciones: en su demostración, borrar e insertar nunca crean una columna de cambio. Así que basta mirar alineamientos sin cambios.
Tomemos un alineamiento sin columnas de cambio, con k columnas iguales. Esas k columnas forman una subsecuencia común, así que k ≤ L. Los demás caracteres de a se borran, y son n − k; los demás de b se insertan, y son m − k. El costo es n + m − 2k, que es al menos n + m − 2L. Y se alcanza: tomando una LCS, se alinean sus caracteres, y lo demás va con huecos, lo que da k = L. ∎
Con casa y cosas: n + m − 2L = 4 + 5 − 2·3 = 3. Una unidad más que la distancia de edición, porque el cambio de
a por o ahora cuesta 2. La última línea del bloque de edit_demo lo dice:
Con solo borrar e insertar: 3Esto es lo que usan estas herramientas, en la medida en que podemos decirlo con seguridad:
-
diff. Comparar dos versiones de un archivo es esta misma cuenta, tomando cada línea como si fuera un carácter: las líneas que se conservan son una subsecuencia común, y lo demás se borra o se agrega. Las herramientas reales no siempre pagan el costo de la tabla completa, y no siempre garantizan el mínimo. La propia ayuda de GNUdiff, la versión 3.10 del entorno del curso, ofrece esta opción:$ diff --help | grep minimal -d, --minimal try hard to find a smaller set of changesLa existencia de esa opción dice que, sin ella, el programa no se esfuerza tanto por llegar al mínimo.
-
Correctores ortográficos. Para una palabra que no está en el diccionario, se pueden sugerir las palabras a menor distancia. La distancia de edición es una base, y los correctores reales usan más información. Hay errores frecuentes que esta distancia mide mal: intercambiar dos letras vecinas cuesta 2, y por eso existen variantes que lo cuentan como una sola operación.
-
Alineamiento de secuencias de ADN. En biología se alinean secuencias con esta misma tabla, cambiando los costos unitarios por puntajes para coincidencias, cambios y huecos. En su forma básica, la estructura de la recurrencia no cambia.
Demostrar programación dinámica: inducción sobre el orden de la tabla
Hemos hecho cuatro veces la misma demostración. Esta es la receta:
-
Escribir qué significa la casilla, en palabras y sin mencionar la recurrencia. Ese es el OPT de las demostraciones. Sin esta frase no hay nada que demostrar: la tabla “calcula lo que calcula”.
-
Fijar el orden de la tabla, y comprobar que cada casilla que la recurrencia lee va antes. Eso es lo que permite usar la hipótesis de inducción, y es también lo que garantiza que el programa no lea una casilla vacía.
-
Casos base. Se comprueban contra la frase, no contra la fórmula.
-
Paso, con dos direcciones. Una cosa se compara con la otra en cada sentido:
- Toda solución queda cubierta por la recurrencia. Se toma una solución óptima cualquiera, se mira la última decisión, y se cubren todos los casos posibles de esa decisión. Quitándola, queda una solución válida de un subproblema más pequeño. Aquí se usa la hipótesis.
- Cada opción de la recurrencia se puede conseguir. Se combina una solución óptima del subproblema con la decisión, y se comprueba que la combinación sigue siendo válida.
Al maximizar, la primera dirección es ≤ y la segunda es ≥. Al minimizar, como en la distancia de edición, se invierten.
-
Concluir que la casilla de la respuesta es correcta, y calcular el costo: casillas por trabajo en cada una.
Esto es la subestructura óptima, ahora como resultado y no como supuesto: la primera dirección dice que quitar la última decisión de una solución óptima deja algo que no puede ser mejor que el óptimo del subproblema.
¿Dónde suele fallar? En las dos direcciones:
- Si la recurrencia no cubre todas las opciones, se queda corta: en un problema de maximizar da menos de lo posible. Es lo que le ocurre al subproblema sin capacidad, y a la recurrencia de la subcadena si se usa para la subsecuencia.
- Si una opción de la recurrencia no se puede conseguir, se pasa: da una “solución” imposible. Es lo que le ocurre a la mochila con la fila equivocada, que suma el mismo objeto dos veces, y a p(j) si se cuenta una clase incompatible.
Idea clave. Una tabla que da el valor correcto en los ejemplos no prueba nada. Para demostrar una programación dinámica se escribe qué significa cada casilla, y se hace inducción en el orden en que se llena. El mismo orden sirve de demostración y de programa.
Greedy o programación dinámica
Ya conocemos dos técnicas de optimización. ¿Cómo se comparan?
| Greedy | Programación dinámica | |
|---|---|---|
| Decisión | Una regla local elige una opción, sin mirar las demás | Se calculan todas las opciones, y se queda con la mejor |
| Estado | Casi nada: la solución parcial | Una tabla con todos los subproblemas |
| Costo típico | El de ordenar | Casillas por trabajo en cada una |
| Demostración | Intercambio: la regla no pierde nada | Inducción sobre la tabla: se cubren todas las opciones |
| Riesgo | Una regla plausible y falsa | Un subproblema sin la información necesaria |
Cuando un greedy funciona, suele ser más simple y más rápido. Pero antes de aceptarlo hay que tener la demostración, porque un contraejemplo como los de hoy aparece en cuanto el problema cambia un poco. Una programación dinámica no tiene que acertar con ninguna regla: prueba las opciones. Solo tiene que acertar con el subproblema.
Si no se les ocurre ni la regla ni el contraejemplo, un buen primer paso es escribir la programación dinámica y correrla contra su greedy en instancias pequeñas. Ya vimos esa técnica en la semana 4, y sirve para encontrar la instancia que rompe la regla.
El código de la semana
En code/week-07:
| Archivo | Qué contiene |
|---|---|
fibonacci.h |
fib_plain, fib_memo, fib_table, fib_two_vars |
weighted_intervals.h |
WeightedInterval, compatible_prefix, weighted_table, weighted_choose, los dos greedy y la fuerza bruta |
knapsack.h |
knapsack_table, knapsack_choose, knapsack_one_row, la versión de menor a mayor, unbounded_knapsack, los greedy, knapsack_memo y la fuerza bruta |
sequences.h |
lcs_table, lcs_walk, longest_common_substring, edit_table, edit_walk, apply_steps, edit_two_rows, y los árbitros lcs_brute y edit_bfs |
fib_calls.cpp |
Las llamadas con y sin memoización |
weighted_demo.cpp |
Los contraejemplos, la tabla y el recorrido de los intervalos con pesos |
knapsack_demo.cpp |
Los contraejemplos, la tabla y el recorrido de la mochila |
knapsack_direction.cpp |
Una sola fila, en las dos direcciones |
pseudopoly_bench.cpp |
Cuánto cuesta cada bit de W. Se corre con make bench |
lcs_demo.cpp |
La tabla de algoritmo y logaritmo, y las dos reconstrucciones |
edit_demo.cpp |
Las tablas de distancia de edición, con su alineamiento |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. La medición va con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
Todas las pruebas de la semana 7 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- Fibonacci sin memoizar hace 2·F(n + 1) − 1 llamadas, y memoizando hace 2n − 1. Las cuatro versiones dan lo mismo.
- En los intervalos con pesos: cada contraejemplo falla como dice el texto. En 3000 instancias al azar, la tabla coincide con la fuerza bruta, y p por búsqueda binaria coincide con la definición, y siempre p(j) ≤ j − 1.
lower_bounden lugar deupper_boundda un valor menor en el ejemplo.- En la mochila: tabla, una fila de mayor a menor, memoización y fuerza bruta coinciden en 3000 instancias. La
reconstrucción cabe, y suma el óptimo. También están los casos sin objetos, con capacidad 0, con un objeto que no
cabe y con valores que no caben en
int. - La fila de menor a mayor coincide siempre con
unbounded_knapsack. - En la LCS: la tabla coincide con la fuerza bruta, y cada reconstrucción es una subsecuencia de las dos cadenas y tiene el largo correcto.
- En la distancia de edición:
casaacosasda 2. La tabla es simétrica. La reconstrucción, aplicada, produce la segunda cadena. Dos filas dan lo mismo que la tabla completa. El BFS sobre cadenas coincide con la tabla, y, sin cambios, con n + m − 2·L.
El problema opcional
En esta semana, la sesión de laboratorio es la Práctica 2. El problema de la carpeta lab/small_diff, un diff
pequeño, queda como ejercicio opcional. Tiene su enunciado, un esqueleto y sus casos: entren a la carpeta y corran
make test. El esqueleto ya lee la entrada y escribe una lista válida, pero larga. Puede haber varias respuestas con
el mínimo de cambios, así que el problema trae un verificador. Lean el enunciado con atención: qué cuenta como un
cambio no es lo mismo que en la distancia de edición de estos apuntes.
Resumen
- Programación dinámica: una recursión que repite subproblemas, en la que se guardan las respuestas. Sirve cuando hay pocas preguntas distintas. Fibonacci: 177 llamadas para 11 preguntas.
- Memoización (de arriba hacia abajo) y tabla (de abajo hacia arriba) hacen lo mismo. Si cada casilla solo lee unas pocas casillas anteriores, se puede ahorrar memoria.
- El método: el subproblema en una frase, la recurrencia, el orden y la reconstrucción. Luego, la demostración.
- Intervalos con pesos: T[j] es lo mejor con las primeras j clases por orden de fin. T[j] = máx(T[j − 1], v +
T[p(j)]), con p(j) por búsqueda binaria y
upper_bound, por los intervalos semiabiertos. O(n log n). El greedy de la semana 4 falla, porque el intercambio ya no conserva el valor. - Mochila 0/1: K(i, c) es lo mejor con los primeros i objetos y capacidad c. Θ(nW). Tomar por mayor valor/peso falla. Sin c en el subproblema, no se puede decidir.
- Pseudopolinomial: O(nW) es polinomial en el valor de W, y exponencial en los log W bits que lo escriben. Cada bit más de W puede duplicar el costo. Volverá en la semana 14.
- Una fila: en la mochila se recorre la capacidad de mayor a menor. Al revés, el programa resuelve en silencio la mochila sin límite de copias. Con una fila se pierde la reconstrucción directa.
- Subsecuencia no es subcadena: la subcadena tiene que ser contigua.
- LCS: L(i, j) sobre dos prefijos. Si los últimos caracteres coinciden, emparejarlos no pierde nada, porque nadie supera L(i − 1, j − 1) + 1. Si difieren, alguno de los dos no se usa. Θ(nm).
- Distancia de edición: el mínimo de operaciones es igual al mínimo costo de un alineamiento. D(i, j) mira las
tres formas de la última columna. Tabla de (n + 1) por (m + 1), Θ(nm). Se reconstruye caminando hacia atrás.
casaycosasestán a distancia 2. - Solo con borrar e insertar, el mínimo es n + m − 2·L. Es la cuenta que está detrás de comparar versiones de un archivo, línea por línea.
- Demostrar: se escribe qué significa cada casilla y se hace inducción en el orden de la tabla, con las dos direcciones. ≤ cubre todas las opciones, y ≥ comprueba que cada opción es válida.
Ejercicios
- Demuestren por inducción que
fib_plain(n)hace exactamente 2·F(n + 1) − 1 llamadas. Luego demuestren que, en esa recursión, F(k) se calcula F(n − k + 1) veces, para 1 ≤ k ≤ n. Compárenlo con la segunda parte de la salida defib_calls. - Intervalos con pesos, a mano. Con las clases [1, 4) v5, [3, 5) v1, [0, 6) v8, [4, 7) v4, [3, 8) v6, [5, 9) v3,
[6, 10) v2 y [8, 11) v4, calculen p(j) y T[j], y reconstruyan una solución. Comprueben con
weighted_table. - Definan en una frase el subproblema de los intervalos con pesos, y escriban su recurrencia, sin mirar los apuntes. Luego expliquen qué línea de la demostración del teorema se rompe si las clases se ordenan por hora de inicio, en vez de por hora de fin.
- Contar soluciones. Modifiquen la tabla de intervalos con pesos para que cuente cuántos subconjuntos de clases alcanzan el máximo. Comprueben con la fuerza bruta. Ojo con los empates, y con el orden de los casos.
- La mochila sin límite de copias. Demuestren por inducción sobre el orden de las casillas que la fila recorrida de menor a mayor calcula U(i, c) = máx(U(i − 1, c), v + U(i, c − w)). Luego demuestren que U es el máximo valor cuando cada objeto se puede tomar cualquier cantidad de veces.
- Cuando el greedy sí funciona. Si los objetos se pueden partir, y tomar una fracción x de un objeto da x·v con
un peso x·w, demuestren con un argumento de intercambio que tomar por mayor valor/peso es óptimo. ¿En qué línea se
rompe el argumento en la mochila 0/1? Usen el segundo ejemplo de
knapsack_demo. - Suma de subconjuntos. Dados n enteros positivos y un objetivo S, ¿hay un subconjunto que sume exactamente S?
Escriban el subproblema, la recurrencia y el programa con una sola fila de
bool, y compárenlo con la fuerza bruta. ¿Cuál es el costo? ¿Es polinomial? - La mochila por valor. Sea V la suma de los valores. Definan M(i, x) como el mínimo peso para conseguir un valor exactamente x con los primeros i objetos. Escriban la recurrencia, demuéstrenla y den el costo. ¿Cuándo conviene esto más que O(nW)? ¿Es polinomial en el tamaño de la entrada?
- La diagonal es segura. Demuestren que D(i − 1, j − 1) ≤ D(i − 1, j) + 1 y que D(i − 1, j − 1) ≤ D(i, j − 1) +
- Concluyan que, si a[i − 1] = b[j − 1], entonces D(i, j) = D(i − 1, j − 1).
test_examples.cpplo comprueba con cadenas al azar, pero aquí se pide la demostración.
- Concluyan que, si a[i − 1] = b[j − 1], entonces D(i, j) = D(i − 1, j − 1).
- Costos distintos. Cambien
edit_tablepara que insertar cueste p, borrar cueste q y cambiar cueste r. Demuestren que la recurrencia sigue siendo correcta. Demuestren que, si r ≥ p + q, existe un alineamiento óptimo sin cambios. Con p = q = 1 y r = 2, comprueben que da n + m − 2·L. - Una fila más una variable. Escriban
edit_two_rowscon una sola fila y una variable adicional. Expliquen qué casilla guarda esa variable, y por qué en la mochila no hacía falta. Compárenla conedit_tableen cadenas al azar. - Dar vuelto. Hay monedas de valores 1, 3 y 4, y cantidades ilimitadas de cada una. Escriban una programación dinámica que halle el mínimo de monedas para pagar una cantidad C. Muestren con el programa que el greedy de tomar la moneda más grande no da el mínimo para C = 6. Definan el subproblema, demuestren la recurrencia, y digan si el costo es polinomial.