Apuntes · Capítulo 12Flujo e intratabilidad
Modelar con flujo
Modelar con flujo
La semana pasada construimos una herramienta. Dada una red con capacidades, Ford-Fulkerson y Edmonds-Karp calculan un flujo máximo, y lo alcanzable en la red residual final da un corte mínimo. Con capacidades enteras, además, el flujo que sale es entero. Todo eso sonaba a un problema de oleoductos.
Esta semana no aparece ningún algoritmo nuevo de flujo. Aparece otra forma de trabajar: tenemos un problema que no menciona redes por ningún lado, como asignar estudiantes a secciones, ver si un equipo todavía puede ganar un campeonato o elegir qué proyectos conviene hacer. Construimos una red a propósito, de modo que sus flujos o sus cortes sean las soluciones de ese problema. Después corremos el mismo programa de siempre y leemos la respuesta.
El programa ya está escrito, así que lo difícil cambia de lugar. Ahora hay que diseñar la red y demostrar que representa lo que decimos. Esa demostración siempre tiene dos direcciones, y quien revisa solo una se lleva sorpresas. Vamos a ver una red que parece correcta y da una respuesta falsa, con una dirección de la demostración intacta.
La primera sesión define qué es una reducción y la aplica al matching bipartito y a los caminos disjuntos, de donde sale el teorema de Menger. La segunda usa flujo para asignar con cupos y decidir la eliminación en un campeonato, y usa el corte mínimo, en vez del flujo, para seleccionar proyectos. Al final vemos cómo se reconoce un problema de flujo, y qué hacer con una restricción que no es de capacidad.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Qué es una reducción, Cómo reconocer un problema de flujo y, de Matching bipartito, Las ideas que no alcanzan y La red.
En clase: Sesión A, de Matching bipartito a El teorema de Menger. Sesión B, de Asignación con cupos a Cómo leer la solución.
Después de clase: Una restricción que no es de capacidad, el Resumen y los Ejercicios, para repasar. Antes del laboratorio, Asignación con cupos otra vez y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, secs. 11.1 (Edge-Disjoint Paths), 11.2 (Vertex Capacities and Vertex-Disjoint Paths) y 11.3 (Bipartite Matching). CLRS, capítulo Matchings in Bipartite Graphs, 4.ª edición. Sesión B: Erickson, secs. 11.4 (Tuple Selection), 11.6 (Baseball Elimination) y 11.7 (Project Selection). Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-12. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El problema de laboratorio está enlab/section_assignment, y su extensión opcional enlab/section_bottleneck. Cada uno tiene su propiomake test.
Qué es una reducción
Reducir un problema A a un problema B es resolver A usando, como una caja negra, un algoritmo que ya existe para B. Tiene tres piezas:
- Una transformación: de cada instancia I de A se construye una instancia J de B.
- Una lectura: de una solución de J se obtiene una solución de I.
- Una demostración de que la lectura da una solución correcta y óptima de I.
En este capítulo B siempre es flujo máximo o corte mínimo, y A es el problema de turno. El costo total es el de construir J, más el de resolver J, más el de leer el resultado.
La tercera pieza es la que se olvida. Cuando A es un problema de optimización, lo que se demuestra tiene una forma fija. Si queremos maximizar:
- Dirección 1, de A hacia B. Cada solución de I, con valor v, da una solución de J con valor v. Así, el óptimo de J es por lo menos el óptimo de I. La red no perdió ninguna solución.
- Dirección 2, de B hacia A. Cada solución de J de las que devuelve el algoritmo, con valor v, da una solución de I con valor v. Así, el óptimo de I es por lo menos el óptimo de J. La red no inventó ninguna solución.
Con las dos, los óptimos coinciden, y lo que se lee es un óptimo de I. Con una sola no se sabe nada: la red podría tener soluciones de más, o de menos.
Idea clave. Una reducción correcta dice “las soluciones de un lado y las del otro se corresponden, con el mismo valor”. Una dirección no alcanza para eso. Se demuestran siempre las dos.
Una advertencia que vale para las próximas semanas. Aquí reducimos para resolver: el problema nuevo se convierte en uno que sabemos resolver. En la semana 13 las reducciones vuelven con otro propósito, y hay que fijarse en qué sentido van.
Matching bipartito
Un curso tiene varias secciones de laboratorio, y por ahora cada una admite a un solo estudiante. Es un caso de juguete que pronto vamos a generalizar. Cada estudiante puede ir a algunas secciones, según su horario. Queremos asignar a la mayor cantidad posible.
Un grafo bipartito tiene dos lados de nodos, L y R, y cada arista une un nodo de L con uno de R. Un matching bipartito (bipartite matching) es un conjunto de aristas sin nodos en común: nadie aparece dos veces. Se busca uno de tamaño máximo. Aquí L son los estudiantes, R son las secciones y cada arista es una opción. Los llamamos E0, E1, … y S0, S1, …, como en el código.
Las ideas que no alcanzan
Antes de usar flujo, probemos lo obvio. La regla más simple es que cada estudiante, en orden, tome la primera opción libre. La otra, más cuidadosa, es atender primero a quien tiene menos opciones, que parece el que corre más peligro.
Las dos fallan, y el programa matching_demo lo muestra comparándolas con una fuerza bruta que prueba todas las
combinaciones:
$ build/matching_demo
...
Cada uno a su primera opción libre falla:
  E0: S0 S1
  E1: S0
  primera opción libre:        1 (E0-S0)
  menos opciones primero:      2 (E0-S1, E1-S0)
  óptimo por fuerza bruta:     2
  flujo:                       2 (E0-S1, E1-S0)

Menos opciones primero también falla:
  E0: S0 S1
  E1: S2 S0
  E2: S2
  primera opción libre:        2 (E0-S0, E1-S2)
  menos opciones primero:      2 (E0-S0, E2-S2)
  óptimo por fuerza bruta:     3
  flujo:                       3 (E0-S1, E1-S0, E2-S2)
...
En el primer bloque, E0 se sienta en la única silla de E1. “Menos opciones primero” arregla justo ese caso. En el segundo bloque, E2 es el de menos opciones y toma S2. Luego E0 y E1 empatan con dos opciones. E0 toma S0, que era la única silla libre de E1. El problema de fondo es el mismo: una decisión ya tomada estorba, y estas reglas nunca vuelven atrás. Ordenar mejor no cura eso. Lo cura poder decirle a E0 “muévete a S1”, y eso es lo que hace una arista inversa.
La red
Dado el grafo bipartito, se construye esta red dirigida, con capacidades:
- Un nodo nuevo s, y una arista s → x de capacidad 1 para cada x de L.
- Un nodo nuevo t, y una arista y → t de capacidad 1 para cada y de R.
- Cada arista {x, y} del grafo se convierte en una arista x → y de capacidad 1.
Esta es la pregunta de repaso que pide una red de 3 por 3, con E0: S0 S1, E1: S0, E2: S1 S2:
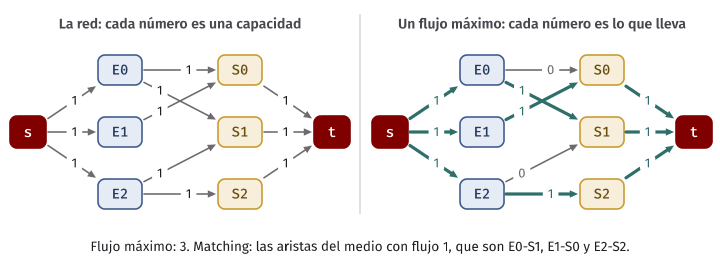
La red tiene tres capas de aristas, y todas las capacidades son 1. La lectura es directa: el matching son las aristas del medio que llevan flujo 1.
El teorema
Teorema. El tamaño de un matching máximo es igual al valor de un flujo máximo de la red. Además, las aristas del medio con flujo 1, en un flujo máximo entero, forman un matching máximo.
La demostración es directa, en las dos direcciones que pide una reducción, y usa la integralidad de la semana 11.
Dirección 1: de un matching a un flujo. Sea M un matching de tamaño k. Por cada arista {x, y} de M, enviamos 1 por el camino s → x → y → t. Hay que comprobar dos cosas. Se respetan las capacidades, porque ninguna arista recibe más de 1: x aparece en una sola arista de M, y lo mismo y, de modo que s → x e y → t se usan a lo sumo una vez. Se cumple la conservación, porque cada nodo recibe lo que entrega. El valor es k, ya que salen k unidades de s.
Dirección 2: de un flujo entero a un matching. Sea f un flujo entero de valor k. Como las capacidades son 1 y f es entero, cada arista lleva 0 o 1. Sea M el conjunto de aristas del medio con flujo 1. Veamos que es un matching. A cada x de L entra a lo sumo 1, porque solo le llega s → x. Por conservación, de x sale a lo sumo 1, y entonces x aparece a lo sumo una vez en M. A cada y de R, de forma simétrica, solo le sale y → t, así que entra a lo sumo 1, y aparece a lo sumo una vez. Para el tamaño, consideremos el corte que separa {s} ∪ L del resto. El valor de un flujo es el flujo neto que cruza cualquier corte. Las aristas de ese corte son las del medio, sin nada que vuelva, y entonces |M| = k.
Conclusión. Por la dirección 1, flujo máximo ≥ matching máximo. Por la dirección 2, aplicada al flujo máximo entero que garantiza la integralidad, matching máximo ≥ flujo máximo. Son iguales, y el M leído tiene tamaño máximo. ∎
Por qué importa que el flujo sea entero
La dirección 2 empieza con “f es entero”. No es un detalle. Tomen dos estudiantes y dos secciones, con todas las opciones posibles: E0 y E1 con S0 y S1, un ciclo de 4 aristas. Poner ½ en cada arista del medio, 1 en cada s → E y 1 en cada S → t es un flujo válido, de valor 2 y máximo. Pero “las aristas con flujo 1” son ninguna, y “media silla” no significa nada: ese flujo no se lee como un matching.
La dirección 2 solo necesita que exista un flujo máximo entero, y el teorema de integralidad de la semana 11 garantiza algo mejor: con capacidades enteras, Ford-Fulkerson encuentra uno, porque cada aumento empuja un entero. No se dice que todo flujo máximo sea entero, como muestra este ejemplo. Se dice que el que devuelve el programa lo es.
Error común. Razonar con cualquier flujo máximo como si fuera entero. Si su red viene de otro método, como un solucionador de programación lineal, el resultado puede tener fracciones, y la lectura deja de tener sentido. Si usan aumentos con capacidades enteras, el resultado es entero sin hacer nada más.
El truco de la integralidad es propio de las redes, y no se extiende sin más. En un triángulo, que no es bipartito, un matching tiene a lo sumo 1 arista. Con ½ en cada arista, cada nodo recibe en total 1, y se suman 3/2. Allí la versión fraccionaria sí da un valor mayor. Por eso esta reducción necesita que el grafo sea bipartito, para poder orientar las aristas de s hacia t.
Paso a paso
Corramos Edmonds-Karp en la red de 3 por 3:
$ build/matching_demo
Una red de 3 por 3:
  E0: S0 S1
  E1: S0
  E2: S1 S2
  camino: s E0 S0 t
  camino: s E2 S1 t
  camino: s E1 S0 E0 S1 E2 S2 t
  flujo máximo: 3
  matching: 3 (E0-S1, E1-S0, E2-S2)
...
Los dos primeros caminos son el greedy de siempre. El tercero es lo interesante. Sigámoslo:
| Tramo | Qué arista usa | Qué significa |
|---|---|---|
| s → E1 | de ida | E1 quiere entrar |
| E1 → S0 | de ida | E1 pide S0, que está ocupada por E0 |
| S0 → E0 | inversa de E0 → S0 | E0 suelta S0 |
| E0 → S1 | de ida | E0 pide S1, ocupada por E2 |
| S1 → E2 | inversa de E2 → S1 | E2 suelta S1 |
| E2 → S2 | de ida | E2 toma S2, que estaba libre |
| S2 → t | de ida | S2 entra al matching |
El estado del matching, después de cada camino:
| Camino | Matching |
|---|---|
| 1 | E0-S0 |
| 2 | E0-S0, E2-S1 |
| 3 | E1-S0, E0-S1, E2-S2 |
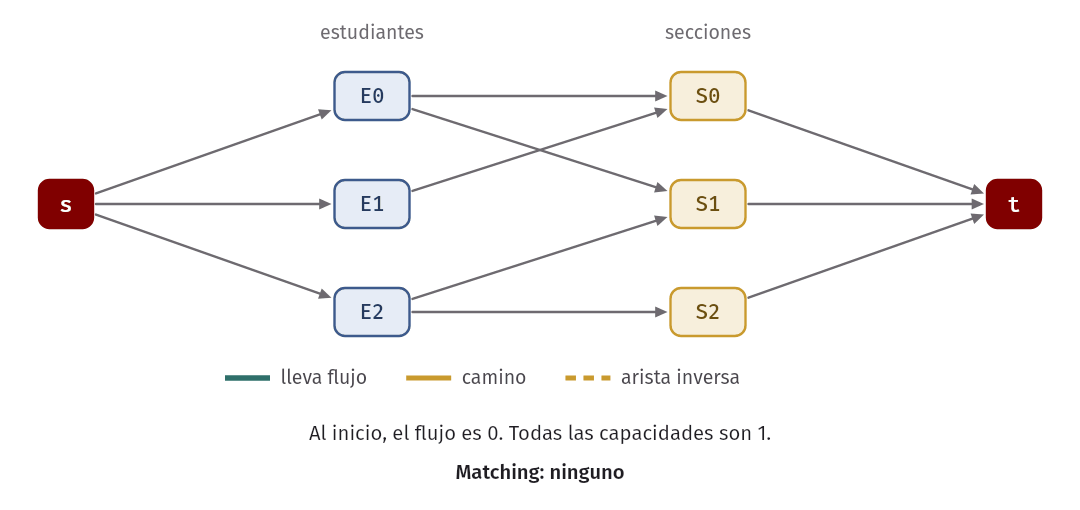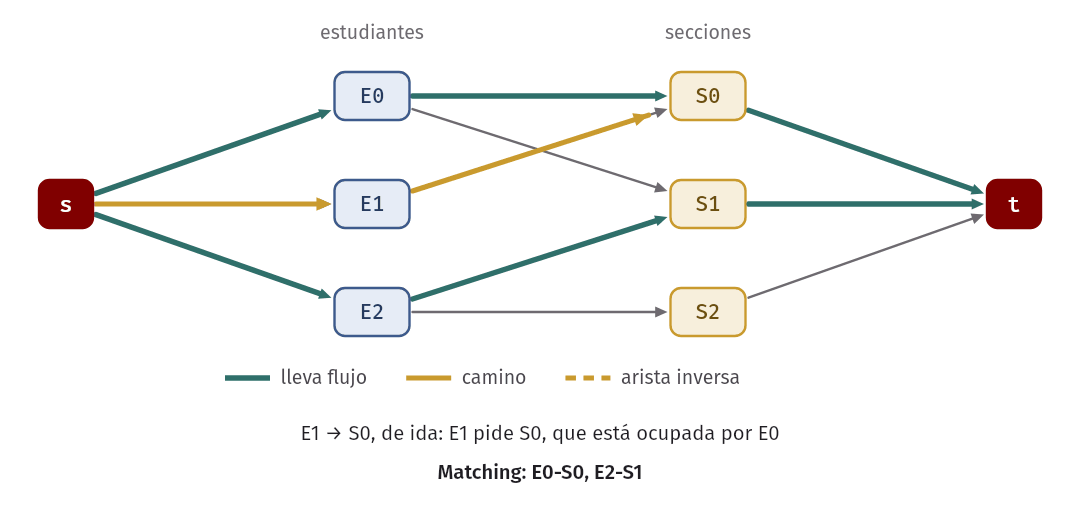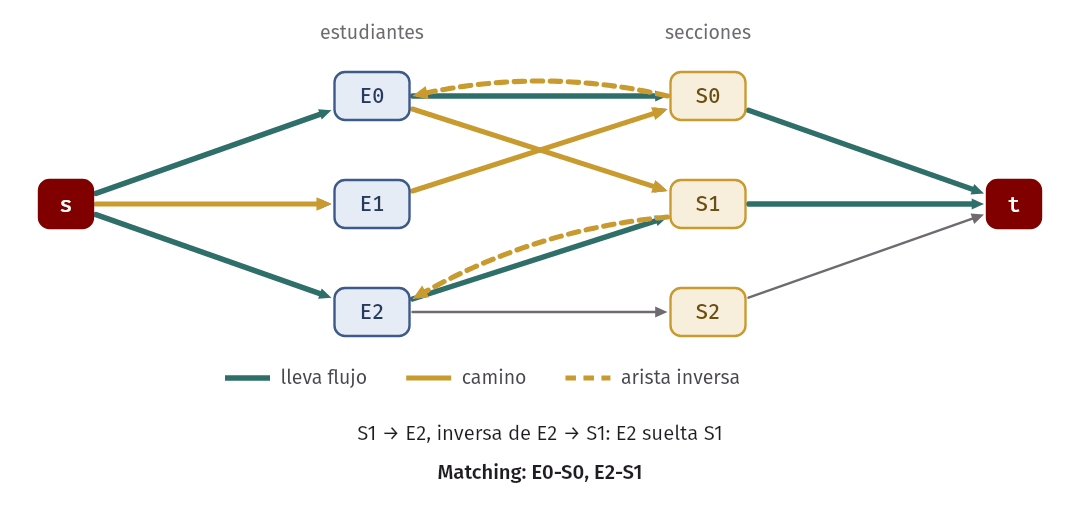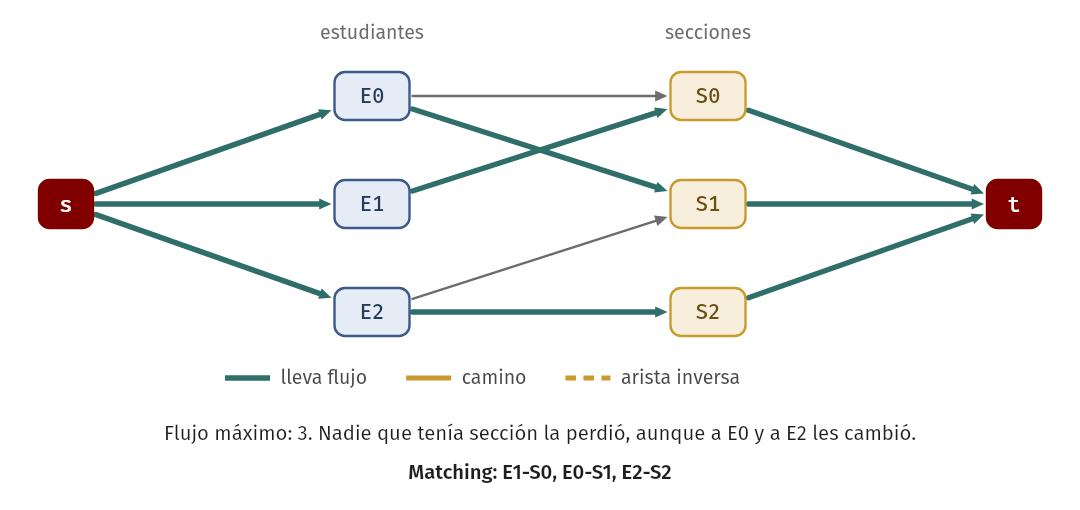
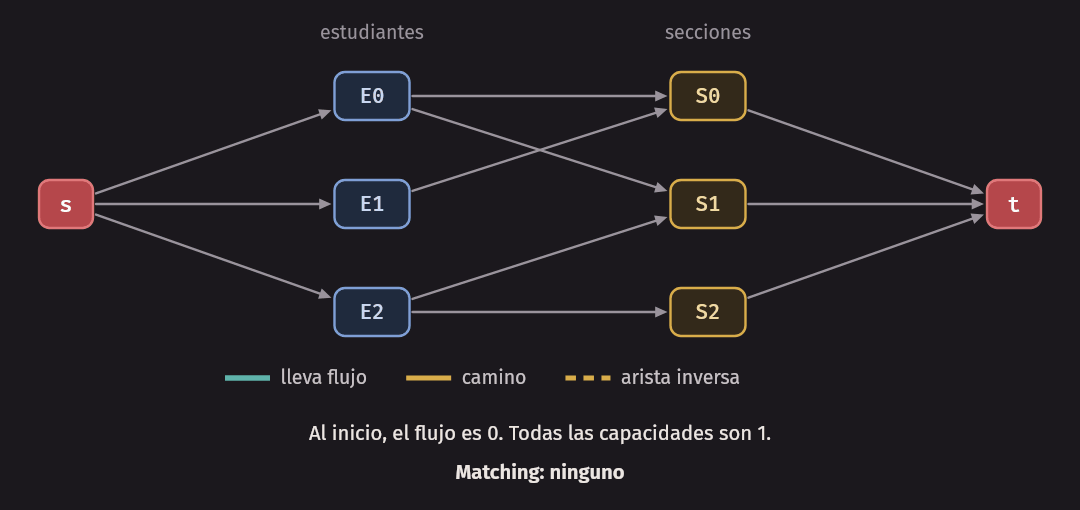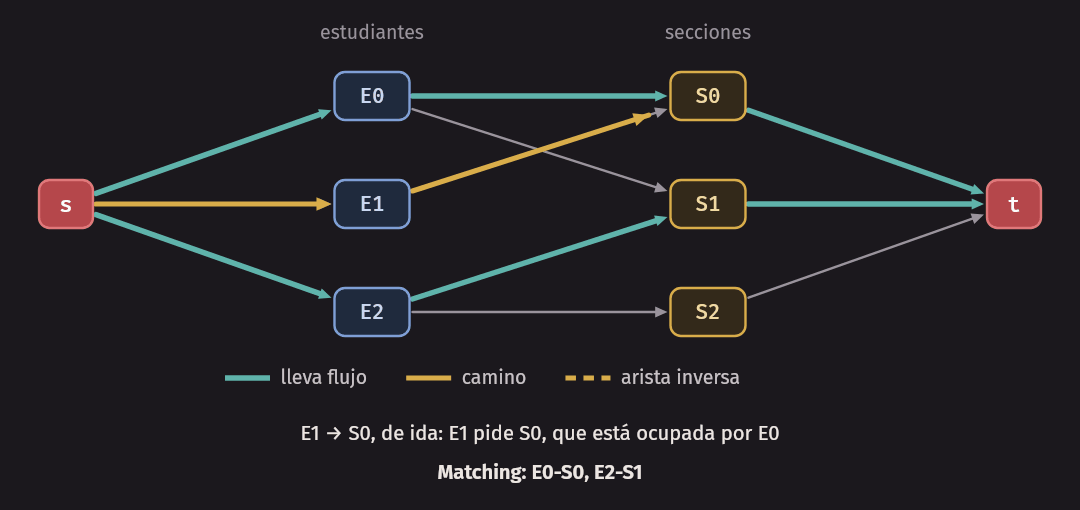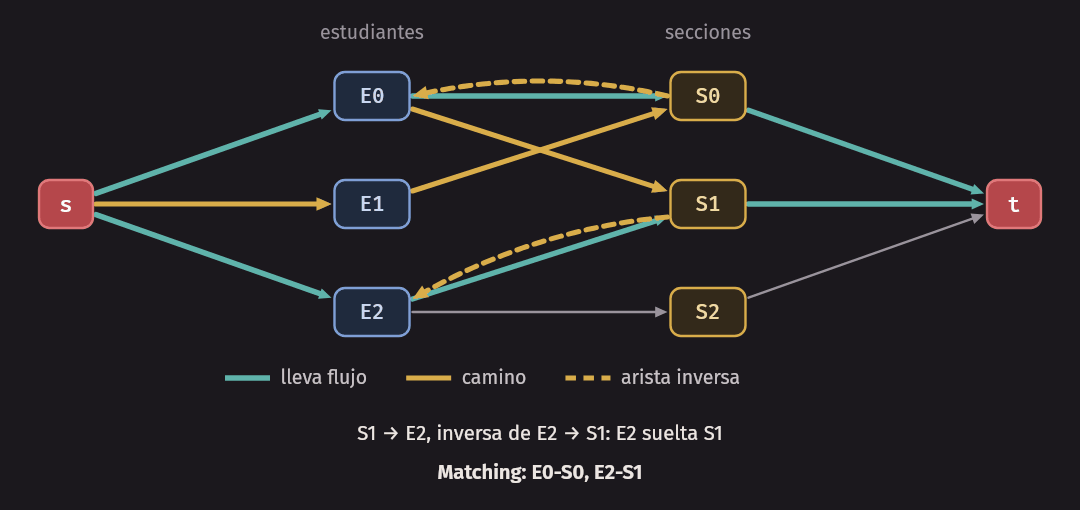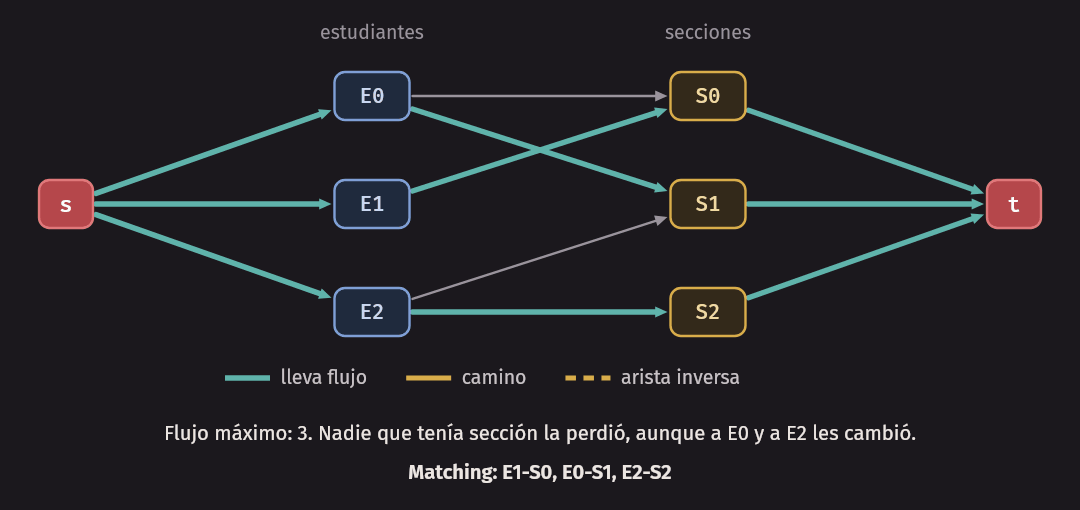
En la red residual de un matching, un camino de aumento alterna entre aristas sin usar y aristas usadas. Cada aumento agrega una arista más de las que quita, y deja a todos los que ya estaban asignados con alguna sección. Nadie que tenía sección la pierde, aunque le puede cambiar.
Idea clave. Lo que un greedy no puede hacer es cambiar de opinión. La arista inversa es, literalmente, “E0, suelta esa sección”. Lo que en la semana 11 era una regla de la red residual, aquí es una cadena de reasignaciones.
En C++
Usamos una clase de flujo como la de la semana pasada, con las aristas en pares, donde e ^ 1 es la arista inversa, y
la capacidad que queda en una arista es lo que se guarda. Está en flow.h, y esto es lo que usaremos de ella:
class MaxFlow {
public:
    explicit MaxFlow(int nodes);
    int add_edge(int from, int to, long long capacity);  // devuelve el número de la arista
    long long edmonds_karp(int s, int t);
    long long ford_fulkerson(int s, int t);
    std::vector<bool> reachable_from(int s) const;       // lo alcanzable en la red residual
    long long flow_on(int id) const;                     // lo que la inversa puede devolver
    int augmentations() const;
    // ...
};
La reducción se escribe casi igual que su definición. La capacidad de s → x queda como parámetro, porque enseguida veremos qué pasa si se olvida:
inline MatchingNetwork matching_network(const Options& options, int right, long long source_capacity = 1) {
    int left = static_cast<int>(options.size());
    MatchingNetwork net{MaxFlow(left + right + 2), 0, left + right + 1, {}};
    for (int i = 0; i < left; i++) net.flow.add_edge(net.source, 1 + i, source_capacity);
    for (int j = 0; j < right; j++) net.flow.add_edge(1 + left + j, net.sink, 1);
    for (int i = 0; i < left; i++) {
        net.middle.emplace_back();
        for (int j : options[at(i)]) net.middle.back().push_back(net.flow.add_edge(1 + i, 1 + left + j, 1));
    }
    return net;
}
La lectura también es una línea por cada arista del medio:
inline std::vector<int> read_matching(const MatchingNetwork& net, const Options& options) {
    std::vector<int> partner(options.size(), -1);
    for (std::size_t i = 0; i < options.size(); i++) {
        for (std::size_t k = 0; k < options[i].size(); k++) {
            if (net.flow.flow_on(net.middle[i][k]) == 1) partner[i] = options[i][k];
        }
    }
    return partner;
}
test_examples.cpp compara esto con la fuerza bruta en 3000 grafos al azar, comprueba que lo leído sea un matching de
verdad y que haya a lo sumo mín(|L|, |R|) aumentos.
Probar solo una dirección
Veamos qué tan fácil es equivocarse. Supongamos que alguien arma la red sin el límite en las aristas s → x, porque le parece redundante: “total, las aristas del medio ya tienen capacidad 1”. Le ponemos capacidad 1000 y corremos:
$ build/matching_demo
...
Sin el límite en s -> estudiante, E0 cuenta dos veces:
  E0: S0 S1
  E1:
  flujo con capacidad 1000 en s -> E: 2
  matching máximo real:               1
¿Qué parte de la demostración se rompe? La dirección 1 sigue valiendo, palabra por palabra: cada matching da un flujo del mismo valor. Alguien que solo revise esa dirección queda convencido. La que se rompe es la dirección 2: E0 puede recibir 2 unidades y entregar una a S0 y otra a S1. Lo leído ya no es un matching, porque E0 aparece dos veces. Con un solo estudiante que tiene dos opciones, el programa responde 2.
Lo simétrico también pasa. Una red demasiado estrecha conserva la dirección 2, porque todo lo que sale de ella es válido, pero pierde la dirección 1, y entonces algunas soluciones no caben en la red y la respuesta sale baja.
Error común. Probar solo una dirección de la reducción. “Toda solución da un flujo” no dice que todo flujo sea una solución, y es la segunda parte la que garantiza que lo que imprime el programa sea verdad. Antes de confiar en una red, hagan las dos preguntas: ¿puede representar cada solución?, y ¿todo flujo entero representa una solución?
Cuánto cuesta
Sea V la cantidad de nodos y E la de aristas del grafo bipartito. La red tiene V + 2 nodos y V + E aristas. El costo de Ford-Fulkerson es O(f) búsquedas, donde f es el valor del flujo máximo. Aquí f es muy chico, sin importar qué camino se elija:
- El flujo máximo es a lo sumo mín(|L|, |R|), que a su vez es a lo sumo V / 2.
- Cada búsqueda cuesta O(V + E).
En total, O(V · (V + E)), que es O(VE) cuando no hay nodos aislados, porque entonces V ≤ 2E. Un nodo aislado no aporta nada y se puede quitar antes. Con esto no hace falta el análisis de Edmonds-Karp, O(VE²), que da una cota peor en este caso: aquí sirve cualquier forma de buscar un camino.
Medimos el costo con grafos al azar de L = R = n, donde cada nodo de la izquierda tiene unas 3 opciones:
$ build/matching_bench
     n   aristas  matching  aumentos EK  ms EK  aumentos DFS  ms DFS
  2000      5995      1873         1873     34          1873      14
  4000     11995      3755         3755    136          3755      76
  8000     23998      7515         7515    662          7515     281
 16000     47996     15024        15024   2683         15024    1259
 32000     95997     30065        30065  13552         30065    4291
Estos tiempos se midieron una sola vez, en una máquina, dentro del contenedor del curso y compilando con -O2. En la de
ustedes serán otros. Lo que no depende de la máquina es la columna de aumentos, que es exactamente el tamaño del matching: en
una red con capacidades 1, cada aumento agrega 1. Al duplicar n, el tiempo con BFS se multiplicó por unos 4 o 5,
compatible con una cota de n², aunque unas pocas filas no alcanzan para afirmar más. La búsqueda con DFS tardó menos
que BFS en cada fila de esta medición, pero no vamos a explicar esa diferencia con solo estos datos. Las dos dan el
mismo matching, como exige el teorema.
En la práctica. Para grafos bipartitos grandes existe el algoritmo de Hopcroft-Karp, que cuesta O(E√V) porque aumenta por muchos caminos en cada fase. No hace falta en este curso. Con los tamaños de nuestro laboratorio, una búsqueda por aumento alcanza de sobra.
Caminos disjuntos en aristas
Cambiemos de problema. Una red de computadoras tiene enlaces dirigidos, y queremos saber cuántas rutas de s a t se pueden usar a la vez sin que dos compartan un enlace, para que la caída de uno afecte a una sola ruta. Dos caminos son disjuntos en aristas (edge-disjoint) si no comparten ninguna arista. Pueden compartir nodos. Se busca la máxima cantidad de caminos de s a t disjuntos en aristas.
La red es casi el mismo grafo: cada arista con capacidad 1. El candidato a teorema es:
El máximo de caminos de s a t disjuntos en aristas es igual al valor del flujo máximo.
Una dirección es inmediata. Si hay k caminos disjuntos en aristas, se envía 1 por cada uno: ninguna arista recibe más de 1, cada nodo interno recibe lo que entrega, y el valor es k. La otra dirección es menos obvia. Un flujo entero de valor k es un montón de aristas con flujo 1. ¿Son k caminos?
Un flujo puede tener ciclos
No siempre “se ve” que un flujo sea una lista de caminos. La definición de flujo solo pide capacidades y conservación, y un ciclo con 1 unidad circulando las cumple sin aportar nada al valor. Este es un flujo de valor 2, escrito a mano:
  s → a → b → t
  s → c → t
  b → d → c → b      (un ciclo que pasa por b y por c)
Se cumple la conservación en cada nodo. b recibe de a y de c, y entrega a t y a d. c recibe de s y de d, y entrega a t y a b. Es un flujo legítimo, y la demostración no puede suponer que no hay ciclos, porque tiene que valer para cualquier flujo entero. Por eso lo que sigue los aparta.
Descomposición de un flujo
Lema (descomposición). Sea f un flujo entero de valor k ≥ 0, donde cada arista lleva 0 o 1. Las aristas con flujo 1 se pueden repartir en k caminos simples de s a t, más algunos ciclos. Cada arista va en exactamente uno de ellos.
Técnica: inducción sobre la cantidad de aristas con flujo 1, caminando por el flujo. Llamemos F al conjunto de aristas con flujo 1. Si F es vacío, ya está, y entonces k = 0. Si no, hay dos casos.
Caso k ≥ 1. Empezamos en s y caminamos, usando cada vez una arista de F que salga del nodo actual. Nos detenemos apenas lleguemos a t o a un nodo por el que ya pasamos. Primero veamos que nunca nos atascamos. De s sale alguna arista, porque de s salen k más de las que entran y k ≥ 1. Si llegamos a un nodo v ≠ s, t por primera vez, entró por lo menos una arista de F, y por conservación sale por lo menos una, que todavía no hemos usado. Como los nodos son finitos, la caminata termina, y solo de dos formas:
- Llegamos a t sin repetir nodo. Lo recorrido es un camino simple de s a t. Lo quitamos de F. Lo que queda es un flujo entero de valor k − 1, porque cada nodo interno pierde una entrada y una salida, y s y t pierden 1 de balance.
- Repetimos un nodo v. La parte desde la primera visita a v hasta la segunda es un ciclo. Lo quitamos de F. Cada nodo del ciclo pierde una entrada y una salida, así que lo que queda es un flujo del mismo valor k.
En los dos casos F se achica, y aplicamos la hipótesis de inducción.
Caso k = 0, con F no vacío. Todos los nodos están balanceados, incluidos s y t. Empezamos en cualquier arista de F y caminamos igual. Nunca nos atascamos, por el balance, y como los nodos son finitos, en algún momento repetimos uno. Ese ciclo se quita, y lo que queda es un flujo de valor 0, con menos aristas. ∎
El caso k = 0 tiene un detalle que el programa tiene que respetar. Un ciclo puede pasar por s y por t. Por eso, el código saca caminos exactamente k veces, y después trata lo que queda como ciclos. Si caminara “mientras s tenga salidas”, tomaría un pedazo de ciclo por un camino. Esto es lo que produce con el flujo de arriba:
$ build/disjoint_demo
Un flujo de valor 2 con un ciclo, escrito a mano:
  caminos: 2
    s c t
    s a b t
  ciclo apartado: c b d c
...
El algoritmo se escribe con una pila de nodos visitados. Cuesta O(V + F): cada arista se usa una vez, y un nodo entra y sale del recorrido una vez por cada arista que lo visita.
algoritmo descomponer(flujo, s, t, k)
    salidas[v] ← aristas de flujo que salen de v, para cada nodo v
    para i desde 1 hasta k hacer
        recorrido ← [s]
        mientras el último de recorrido no sea t hacer
            v ← el último de recorrido
            w ← quitar una arista de salidas[v]
            si w ya está en recorrido entonces
                apartar como ciclo lo que hay en recorrido desde w
                dejar recorrido hasta w, sin quitar w
            sino
                agregar w a recorrido
            fin si
        fin mientras
        guardar recorrido como camino
    fin para
    lo que queda en salidas forma solo ciclos
fin algoritmo
El teorema
Teorema. En un grafo dirigido, el máximo de caminos de s a t disjuntos en aristas es igual al flujo máximo de la red con capacidades 1.
Dirección 1. k caminos disjuntos en aristas dan un flujo de valor k, como ya vimos. Si un camino repitiera un nodo, se puede acortar, así que tomamos caminos simples.
Dirección 2. Por la integralidad hay un flujo máximo entero, con cada arista en 0 o 1. Por el lema se reparte en k caminos simples, más ciclos que se descartan. Como cada arista va en uno solo, los caminos son disjuntos en aristas. ∎
El costo es de O(VE) si no hay nodos aislados: el flujo es a lo sumo la cantidad de aristas que salen de s, y eso es a lo sumo V − 1 en un grafo sin aristas repetidas. Con aristas repetidas, se cambia V por E.
El caso no dirigido
En un grafo no dirigido, una arista no tiene sentido fijo. El modelo usual es reemplazar cada arista {u, v} por dos aristas dirigidas, u → v y v → u, cada una con capacidad 1. Pero esto abre una duda: un flujo podría usar las dos, y entonces dos caminos comparten la misma arista no dirigida.
Eso pasa de verdad. Lo vemos en esta red, donde el flujo que calcula el programa usa una arista en las dos direcciones antes de arreglarla:
$ build/disjoint_demo
...
No dirigido: el flujo de esta red usa una arista en las dos direcciones.
  aristas canceladas: 1
  caminos: 3
    s t
    s b e t
    s d a c t
...
Teorema. El máximo de caminos disjuntos en aristas de un grafo no dirigido es igual al flujo máximo de la red con dos aristas dirigidas de capacidad 1 por cada arista.
Dirección 1. Dados k caminos simples disjuntos en aristas, orientamos cada uno de s a t. Cada arista no dirigida la usa un solo camino, en una sola dirección. Enviamos 1 por cada camino, y queda un flujo de valor k.
Dirección 2. Tomemos un flujo máximo entero. Si una arista {u, v} tiene flujo 1 en u → v y también en v → u, cancelamos: ponemos 0 en las dos. En u y en v, tanto lo que entra como lo que sale bajan en 1, así que la conservación sigue igual, y el valor no cambia, aun si u o v es s o t. Después de cancelar, cada arista no dirigida se usa en a lo sumo una dirección. Con el lema de descomposición sale k caminos, y como cada arista no dirigida se usa una vez, son disjuntos. ∎
Caminos disjuntos en nodos
Ahora pedimos más: dos caminos son disjuntos en nodos (vertex-disjoint) si no comparten ningún nodo, salvo s y t. En la red de computadoras, esto protege también contra la caída de un equipo, no solo de un enlace. En este grafo, los dos conceptos dan respuestas distintas:
  s → a ─┐     ┌→ d ─┐
         ├→ c ─┤     ├→ t
  s → b ─┘     └→ e ─┘
Hay 2 caminos disjuntos en aristas, y solo 1 disjunto en nodos, porque todos pasan por c.
Las capacidades de las aristas no pueden expresar esto. Con capacidad 1 en las aristas, c deja pasar 2. Y una capacidad de nodo no existe en nuestra definición de flujo. La salida es transformar el nodo en una arista.
Dividir un nodo
Cada nodo v distinto de s y t se divide en dos, v_in y v_out, unidos por una arista v_in → v_out de capacidad 1. Una arista u → v del grafo original pasa a ser u_out → v_in. Así, todo lo que entra a v llega a v_in, todo lo que sale de v sale de v_out, y entre los dos solo pasa 1.
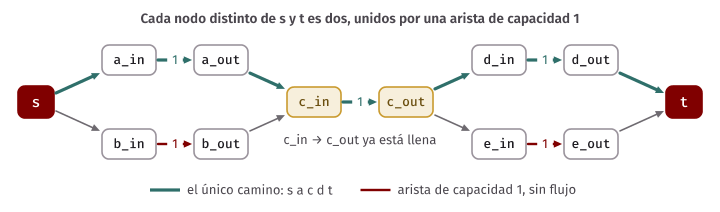
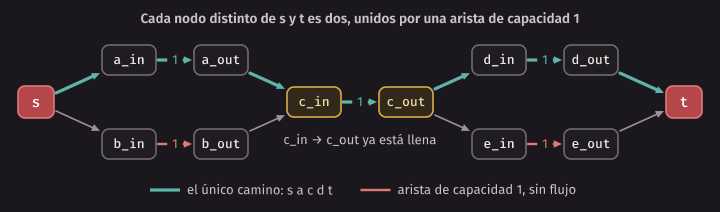
Esta es la respuesta a la pregunta de repaso: el número de caminos que pasan por un nodo se limita a 1 dividiéndolo en dos, con una arista de capacidad 1 en medio. Con otra capacidad, se limita a cualquier otro número. La técnica sirve siempre que un nodo tenga capacidad, no solo en este problema.
s y t no se dividen. Si lo hicieran, con capacidad 1, se permitiría un solo camino en total. Ellos son compartidos por todos los caminos, y la definición de disjuntos los excluye justamente por eso.
Teorema. Si no hay arista de s a t, el máximo de caminos de s a t disjuntos en nodos es igual al flujo máximo de la red dividida.
Dirección 1. Dados k caminos disjuntos en nodos, enviamos 1 por cada uno, pasando por v_in → v_out en cada nodo interno v. Como cada v está en un solo camino, cada arista de la red lleva a lo sumo 1.
Dirección 2. Tomemos un flujo máximo entero y descompongámoslo con el lema. Un camino de la red tiene que pasar por v_in → v_out cada vez que toca v, porque es la única salida de v_in y la única entrada de v_out. Si borramos esos pasos obtenemos un camino del grafo original. Y como v_in → v_out tiene capacidad 1, a lo sumo un camino toca v. Por lo tanto, los k caminos son disjuntos en nodos. ∎
El programa lo confirma en el grafo de arriba:
$ build/disjoint_demo
...
Dirigido, sin compartir aristas:
  caminos: 2
    s b c e t
    s a c d t
  corte mínimo: s->a s->b

El mismo grafo, sin compartir nodos:
  caminos: 1
    s a c d t
  separador mínimo: c
...
Si s y t son vecinos
Una arista directa s → t es un camino sin nodos internos, y entonces no choca con ningún otro. Si las aristas de la red tienen capacidad 1, el teorema sigue siendo cierto, y esa arista cuenta como un camino más: el máximo es 1 más el máximo del grafo sin esa arista. No hay nada que dividir en ese camino, y por eso la división de nodos no lo limita.
Con capacidad “sin límite” en las aristas, como vamos a querer enseguida para leer un separador, el resultado es absurdo: esa arista deja pasar tanto como su capacidad. Aquí usamos 5 como “sin límite” en una red de 4 nodos:
$ build/disjoint_demo
...
Con una arista directa s -> t:
  caminos: 3
    s b t
    s a t
    s t
  flujo si las aristas tienen capacidad "sin límite" (aquí, 5): 7
Los 7 son 5 por la arista directa y 2 por los nodos a y b. Eso no es un error de la red, sino una señal de algo real: si s y t son vecinos, quitar nodos no los puede separar. Por eso el teorema que sigue pide que no lo sean.
El teorema de Menger
Todo esto se junta en un teorema de 1927, que es anterior a los algoritmos de flujo. Dice que el máximo de cosas disjuntas es igual al mínimo de lo que hay que romper. Nosotros lo obtenemos casi gratis, como corolario de flujo máximo y corte mínimo.
Teorema de Menger, forma con aristas. En un grafo dirigido, sean s y t dos nodos distintos. El máximo de caminos de s a t disjuntos en aristas es igual al mínimo de aristas que hay que quitar para que no quede ningún camino de s a t.
Teorema de Menger, forma con nodos. En un grafo dirigido, sean s y t dos nodos distintos, sin arista de s a t. El máximo de caminos de s a t disjuntos en nodos es igual al mínimo de nodos, distintos de s y t, que hay que quitar para que no quede ningún camino de s a t.
Un conjunto de nodos así se llama separador (separator). La condición sobre la arista es necesaria: si s y t son vecinos, ningún conjunto de nodos los separa.
Demostración de la forma con aristas. Técnica: leer el corte mínimo. Por el teorema anterior, el máximo de caminos es el flujo máximo de la red con capacidades 1. Por flujo máximo y corte mínimo, es igual a la capacidad de un corte mínimo. Falta ver que el corte mínimo es igual al mínimo de aristas que desconectan. Lo hacemos en dos pasos.
- Un corte da un conjunto que desconecta. Sea (S, T) un corte con s en S y t en T, y sea F el conjunto de aristas de S a T, con |F| igual a la capacidad. Todo camino de s a t tiene que salir de S en algún momento, por una arista de F. Quitando F no queda ninguno.
- Un conjunto que desconecta da un corte. Sea F tal que, sin F, no hay camino de s a t. Sea S lo alcanzable desde s sin usar F. Entonces s está en S y t no. Toda arista de S a T está en F, porque si no, su destino sería alcanzable. La capacidad del corte es a lo sumo |F|.
Por lo tanto, los dos mínimos son iguales. ∎
Demostración de la forma con nodos. En la red dividida, damos capacidad “sin límite” a las aristas originales, y 1 a las aristas v_in → v_out. Esto no cambia el flujo máximo cuando s y t no son vecinos: todo camino pasa por algún nodo interno, y cada unidad queda limitada al pasar por él. Que “sin límite” es un número finito no importa, siempre que sea mayor que V: el corte que deja a s y a todos los v_in de un lado tiene solo aristas v_in → v_out, y cuesta a lo sumo V − 2. Así que un corte mínimo no contiene aristas originales.
- Un corte mínimo da un separador. Sea (S, T) un corte mínimo. Por lo anterior, sus aristas son todas de la forma v_in → v_out. Sea X el conjunto de esos v, con |X| igual a la capacidad. Supongamos que queda un camino de s a t sin tocar X. En la red corresponde a un camino de S a T, que tiene que cruzar por alguna arista. Esa arista no es una original, y tampoco es v_in → v_out con v fuera de X. Es una contradicción.
- Un separador da un corte. Sea X un separador, y sea A lo alcanzable desde s en el grafo sin X. Formamos S con s, con v_in y v_out de cada v de A y con x_in de cada x de X. Una arista original que sale de S parte de algún u_out con u en A o de s, y llega a v_in. Si v está en X o en A, entonces v_in está en S, y no cruza. Otro caso no hay, porque v sería alcanzable. Las únicas aristas que cruzan son x_in → x_out, y son a lo sumo |X|.
El mínimo de los dos lados coincide, y por el teorema anterior el máximo de caminos también. ∎
Los dos corolarios se comprueban con fuerza bruta en test_examples.cpp: en 1500 grafos al azar se revisa que los
caminos sean disjuntos de verdad y que haya tantos como el mínimo calculado probando todos los subconjuntos.
Idea clave. Máximo de caminos disjuntos igual a mínimo de cosas que hay que romper. Cuando un resultado dice “esto es lo máximo”, la mitad de la dificultad suele ser demostrarlo. Aquí el corte es una prueba que se puede revisar: si les muestro 2 caminos disjuntos y 2 aristas que los separan, ya saben que nadie puede hacer 3.
El programa lee las dos cosas. En el ejemplo de arriba, el corte s->a s->b y el separador c son los que aparecen en
la salida. Un corte mínimo no es único: en el primer caso, c->d c->e también funciona.
En los grafos no dirigidos valen los mismos enunciados, y se obtienen con el modelo de dos aristas por arista. Un corte (S, T) cuenta una vez cada arista no dirigida que lo cruza, porque solo una de sus dos direcciones va de S a T.
En la práctica. Menger explica por qué se habla de “k-conexión” en una red real. Si entre dos equipos hay k rutas disjuntas en nodos, ninguna falla de k − 1 equipos intermedios los separa. Y al revés, si los dos no son vecinos directos y ninguna falla de k − 1 los separa, esas k rutas existen. Es una propiedad que se puede calcular, no solo un deseo de diseño.
Asignación con cupos
Volvemos a la matrícula, ahora en serio. Hay n estudiantes y m secciones. Cada estudiante tiene una lista de secciones permitidas, y cada sección j tiene un cupo cⱼ ≥ 0. Cada estudiante va a lo sumo a una sección de su lista, y cada sección recibe a lo sumo cⱼ estudiantes. Se busca asignar a la mayor cantidad posible.
Es el matching con una sola diferencia, y la red también:
- s → estudiante, con capacidad 1.
- estudiante → sección, con capacidad 1, si esa sección está en su lista.
- sección j → t, con capacidad cⱼ.
algoritmo asignar_con_cupos(opciones, cupo, n, m)
    red ← red vacía con fuente s y sumidero t
    para i desde 0 hasta n - 1 hacer
        agregar a red la arista s → estudiante i con capacidad 1
        para cada sección j de opciones[i] hacer
            agregar a red la arista estudiante i → sección j con capacidad 1
        fin para
    fin para
    para j desde 0 hasta m - 1 hacer
        agregar a red la arista sección j → t con capacidad cupo[j]
    fin para
    k ← flujo máximo de red, con caminos de aumento
    devolver k y las aristas estudiante → sección que llevan flujo 1
fin algoritmo
Teorema. La mayor cantidad de estudiantes que se puede asignar es igual al flujo máximo, y las aristas del medio con flujo 1 en un flujo máximo entero son una asignación óptima.
Dirección 1: de una asignación a un flujo. Dada una asignación de k estudiantes, enviamos 1 por s → i → j → t por cada par (i, j). s → i e i → j se usan a lo sumo una vez, porque i tiene una sola sección. j → t recibe tantas unidades como estudiantes tiene j, que es a lo sumo cⱼ. El valor es k.
Dirección 2: de un flujo entero a una asignación. Con un flujo entero, cada arista s → i y cada i → j lleva 0 o 1. Al estudiante i entra a lo sumo 1, y por conservación sale a lo sumo 1: tiene a lo sumo una sección. A la sección j le entra lo que sale por j → t, que es a lo sumo cⱼ: respeta su cupo. Las secciones de cada estudiante son de su lista, porque solo existen esas aristas. Por el corte {s} ∪ estudiantes, los pares son tantos como el valor del flujo. ∎
La integralidad vuelve a hacer el trabajo: sin ella, un estudiante podría ir media hora a cada sección. Con capacidades enteras, el flujo que se obtiene es entero.
Las capacidades de la red están en sus lugares por una razón. La de s → i dice “una sola sección por persona”, como vimos con la red sin ese límite. La de j → t dice “no más de su cupo”: si se olvida, la dirección 2 se rompe, y salen secciones por encima del cupo. Cada capacidad es una regla del problema.
El flujo máximo es a lo sumo n, de modo que se hacen a lo sumo n aumentos y una búsqueda final, y cada búsqueda cuesta O(V + E) con V ≤ n + m + 2 y E ≤ n + m + D, donde D es la suma de los largos de las listas. Da O(n · (n + m + D)), sin que importe el tamaño de los cupos. Un cupo enorme no agrega aristas: es solo un número en una arista.
En C++. En este problema, las capacidades caben en
inty el flujo es a lo sumo n, porque cada arista s → i aporta 1. Fíjense en que eso se calcula, no se supone: la clase deflow.husalong long, porque en otras redes del capítulo las capacidades sí son grandes.
Los greedy, con cupos
Las reglas de antes tampoco mejoran con cupos. Esta instancia las hace fallar a las dos. El programa quota_demo arma la
red a mano, arista por arista, para que se pueda comparar con un dibujo:
$ build/quota_demo
Seis estudiantes y tres secciones, con cupos S0: 2, S1: 1, S2: 2
  E0: S0
  E1: S0
  E2: S2 S1
  E3: S0 S2
  E4: S2
  E5: S0

Los greedy y el árbitro:
  primera opción libre:   4
  menos opciones primero: 4
  fuerza bruta:           5

Flujo máximo: 5 de 6
Aristas del medio con flujo: E0-S0 E1-S0 E2-S1 E3-S2 E4-S2
Estudiantes alcanzables desde s: E0 E1 E5
Secciones alcanzables desde s: S0
...
Con la primera opción libre, E2 toma S2 y E3 también, porque S0 ya se llenó con E0 y E1. Entonces S2 queda llena y E4, que solo puede ir ahí, se queda fuera. Y queda libre S1, que solo E2 podía usar. La solución óptima manda a E2 a S1, y deja S2 para E3 y E4. Quien sobra es E5: E0, E1 y E5 solo pueden ir a S0, que tiene cupo 2, y eso no tiene arreglo.
La condición de Hall con cupos
Esa última frase es una prueba de optimalidad. Tres estudiantes que comparten dos sillas: se queda uno fuera, se asigne como se asigne. Lo notable es que esa explicación siempre existe, y que se lee del corte mínimo.
Para un conjunto A de estudiantes, sea N(A) el conjunto de secciones que aparecen en la lista de alguno de ellos, y sea c(N(A)) la suma de sus cupos.
Teorema (Hall con cupos). La mayor cantidad k de estudiantes que se puede asignar cumple
k = mín sobre todos los conjuntos A de ( n − |A| + c(N(A)) ).
Además, si R es lo alcanzable desde s en la red residual de un flujo máximo entero, A son los estudiantes de R, y B son las secciones de R, entonces B = N(A) y ese A alcanza el mínimo. Es decir, |A| − c(N(A)) = n − k.
Primero, la cota fácil. Para cualquier A y cualquier asignación, de los estudiantes de A se asignan a lo sumo c(N(A)), porque solo pueden ir a esas secciones. De los que no están en A se asignan a lo sumo n − |A|. Entonces k ≤ n − |A| + c(N(A)), para todo A.
Ahora, la igualdad. Técnica: calcular la capacidad del corte (R, resto). Sabemos, por la semana 11, que R contiene a s, no contiene a t, y que su corte tiene capacidad k. Falta ver cuánto vale esa capacidad en esta red.
- N(A) ⊆ B. Sea i de A, y j una sección de su lista. Si i → j lleva flujo 0, la arista tiene capacidad residual, y j está en R. Si i → j lleva flujo 1, entonces i tiene asignada a j y s → i está saturada. Entonces no se llegó a i desde s. La única otra forma de llegar a i es por una arista inversa j′ → i, con i → j′ llevando flujo 1. Como i lleva una sola unidad, j′ = j, y entonces j está en R.
- B ⊆ N(A). Sea j de B. Se llega a j por una arista residual. Las únicas que entran a j son i → j de ida y la inversa t → j. Como t no está en R, se llegó desde un estudiante i de R, y j está en la lista de i.
- La capacidad. Las aristas que salen de R son las s → i con i fuera de A, que suman n − |A|. También las j → t con j en B, que suman c(N(A)). Por el paso 1 no hay aristas i → j que salgan de R. Entonces k = n − |A| + c(N(A)). ∎
Corolario. Entran todos, es decir, k = n, si y solo si |A| ≤ c(N(A)) para todo conjunto A de estudiantes. Es el teorema de Hall, en su forma con cupos: el único obstáculo para asignar a todos es un grupo que no cabe en lo que tiene disponible. Con todos los cupos iguales a 1, es el teorema de Hall clásico sobre matchings.
En el ejemplo, la salida dice A = {E0, E1, E5} y N(A) = {S0}. Es lo prometido: |A| − c(N(A)) = 3 − 2 = 1 = 6 − 5.
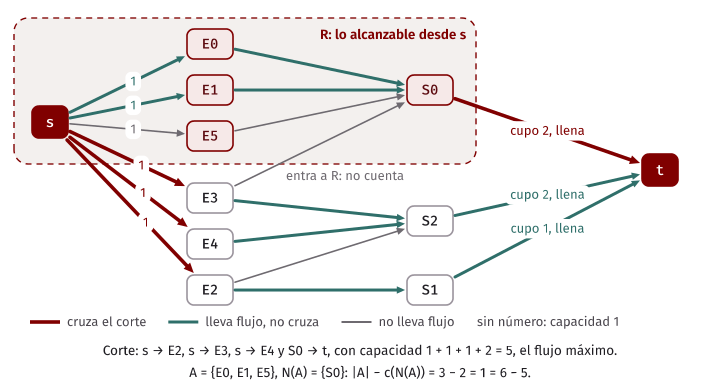
Error común. Decir que las secciones que limitan son “las que quedaron llenas”. En el ejemplo, S1 y S2 también quedaron llenas, y no son parte del problema: E2, E3 y E4 caben perfectamente. Es el mismo error de la semana pasada, el de confundir aristas saturadas con aristas del corte. El grupo que limita se lee de lo alcanzable, no de lo saturado.
Dos estudiantes y una sola silla
La pregunta de repaso: dos estudiantes quieren la misma sección con cupo 1, y otra sección queda libre. ¿Cómo se ve en la red? Depende de si alguno de los dos puede ir a la sección libre.
$ build/quota_demo
...
Dos quieren S0, con cupo 1, y S1 queda libre porque ninguno puede ir:
  flujo: 1
  S0 -> t lleva 1, S1 -> t lleva 0
  alcanzables desde s: s E0 E1 S0
Lo mismo, pero E1 también puede ir a S1:
  flujo: 2
  S0 -> t lleva 1, S1 -> t lleva 1
  alcanzables desde s: s
En el primer caso, S1 → t queda con capacidad de sobra, pero no se puede llegar a S1 desde s: no hay ninguna arista hacia ella. El flujo es 1, y E1 se queda sin sección. S0 → t es la arista saturada del corte. Lo alcanzable es {s, E0, E1, S0}, y eso dice A = {E0, E1} y N(A) = {S0}, con 2 − 1 = 1. La capacidad libre no ayuda si el corte la deja del otro lado.
En el segundo caso hay un camino de aumento hacia la sección libre, tal vez pasando por una arista inversa, y entran los dos. Como todos entraron, las aristas s → E están saturadas, y lo alcanzable es solo {s}, con A vacío.
Más capas: elegir de a varios
La misma idea sirve cuando una elección tiene varias partes. Supongamos un horario de exámenes: cada curso necesita una hora y un aula, cada hora tiene un límite de exámenes, y cada aula tiene un límite de horas. Una red por capas, con un nodo por curso, por hora y por aula, puede representar la elección como un camino:
s → curso → hora → aula → tCada camino de s a t es una tupla (curso, hora, aula). Un nodo con un límite se divide, como en los caminos disjuntos. Pero esto tiene un límite claro: la red solo ve pares de capas consecutivas. Puede decir “este curso cabe en esta hora” y “en esta hora, esta aula está libre”. No puede decir “este curso no puede usar esta aula”, porque el flujo no recuerda de dónde vino cada unidad cuando llega a la hora. Si las restricciones saltan capas, el modelo es falso. Y en el caso general no hay arreglo fácil: elegir tríos sin elementos en común de una lista arbitraria de tríos permitidos es 3-dimensional matching, un problema NP-completo. Qué significa eso se ve en las semanas 13 y 14.
Eliminación en un campeonato
En un campeonato de vóley no hay empates: cada partido lo gana un equipo. Faltan algunos partidos, y queremos saber si un equipo todavía puede quedar primero, aunque sea empatado con otros. Si no puede, está eliminado.
Los datos, para cada equipo i: wᵢ, las victorias que ya tiene, y g(i, j), los partidos que faltan entre i y j. Fijemos un equipo x y llamemos rₓ a los partidos que le faltan. Lo más que x puede alcanzar es
W = wₓ + rₓ.
Mirar la tabla no basta. En esta, inventada, Piura todavía puede llegar a 28 victorias, más que el líder actual:
$ build/baseball_demo
equipo   ganados  faltan  máximo  ¿eliminado?
Lima     27       4       31      no (flujo 5 de 5)
Cusco    26       4       30      no (flujo 5 de 5)
Ica      26       4       30      no (flujo 5 de 5)
Piura    25       3       28      sí (flujo 5 de 6)
Callao   20       3       23      sí, a simple vista: Lima ya lo pasó
...
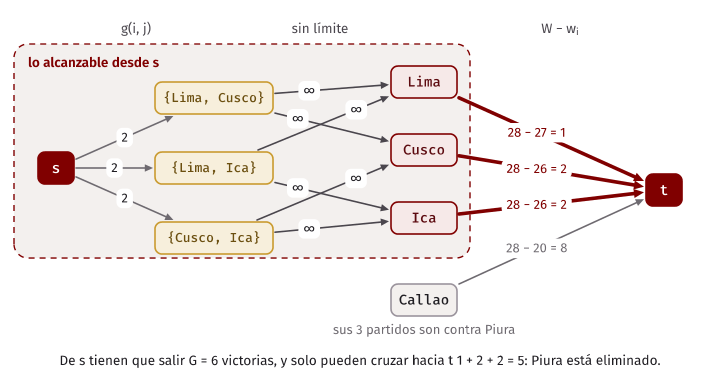
Lima, Cusco e Ica tienen pendientes 2 partidos entre cada par, en total 6, y los de Piura son contra Callao. Con 28, Piura parece vivo. Pero para que Lima no pase de 28, solo puede ganar 1 de sus 4 partidos. Cusco e Ica pueden ganar 2 cada uno. En total, 5. Pero los 6 partidos entre ellos se juegan, y alguien los gana. Sobra una victoria, y le toca a alguien que pasará a Piura.
Reducción
Primero, dos simplificaciones, cada una con su razón.
Si algún equipo ya tiene más de W victorias, x está eliminado, y no hace falta nada más. Es la eliminación trivial, la de Callao. Además, hay que comprobarlo antes de construir la red, porque vamos a usar capacidades W − wᵢ, y aquí serían negativas.
x gana todo lo que le falta. No se pierde nada. Si en un resultado en que x queda primero, x pierde algún partido, cambiar ese resultado hace que x sume una victoria y su rival pierda una, y x sigue primero. Entonces, si x puede quedar primero, puede hacerlo ganando todo. Los partidos de x desaparecen del problema: los rivales no ganan ninguno de esos.
Queda repartir las victorias de los partidos entre los demás, sin que nadie pase de W. Es un reparto, y por eso es un flujo. La red tiene:
- Un nodo por cada par {i, j}, con i, j distintos de x y g(i, j) > 0. Se llama nodo de partido.
- Un nodo por cada equipo i distinto de x.
- s → {i, j} con capacidad g(i, j): las victorias de ese par que hay que repartir.
- {i, j} → i y {i, j} → j, con capacidad sin límite: cualquiera de los dos puede ganar todos esos partidos.
- i → t con capacidad W − wᵢ, que es ≥ 0 porque ya descartamos la eliminación trivial: lo más que i puede ganar sin pasar a x.
Sea G la suma de los g(i, j) de esos pares, es decir, los partidos que no juega x. Para Piura, con W = 28 y G = 6, la red es esta:
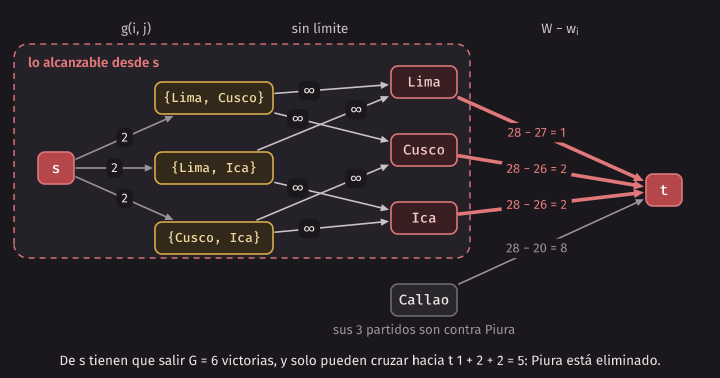
Teorema. Si ningún equipo tiene más de W victorias, x está eliminado si y solo si el flujo máximo es menor que G. Es decir, x puede quedar primero si y solo si el flujo satura todas las aristas que salen de s.
Dirección 1: de un resultado a un flujo. Supongamos que x puede quedar primero. Por lo visto arriba, puede hacerlo ganando todos sus partidos, y entonces termina con W. Tomemos los resultados de los demás partidos en ese caso. Por cada par, enviamos g(i, j) desde s, y de ahí a i tantas unidades como partidos ganó i, y a j las que ganó j. De i sale hacia t lo que ganó en total, y como i termina con a lo sumo W, eso es a lo sumo W − wᵢ. Es un flujo de valor G.
Dirección 2: de un flujo a un resultado. Supongamos un flujo entero de valor G. Satura todas las aristas de s. Lo que {i, j} envía a i es un entero: i gana esos partidos, y j gana el resto, que suma g(i, j) porque se conserva el flujo. Con x ganando todos los suyos, la tabla final le da wᵢ + (lo que entra a i), y eso es a lo sumo W por la capacidad de i → t. Entonces nadie pasa de W, y x queda primero.
Sin integralidad, esto no tendría sentido, porque no se puede ganar medio partido. Es entero porque las capacidades lo son. Si el flujo máximo es menor que G, no existe un flujo de valor G, y por la dirección 1 x no puede quedar primero. ∎
Error común. Olvidar que los rivales de x también juegan entre ellos. Decidir mirando solo si W alcanza al líder es la eliminación trivial, y deja pasar a Piura. El punto del problema es lo que los demás se quitan entre sí.
Lo que dice el corte
Si x está eliminado, ¿se le puede dar una explicación a un hincha? Sí, y es la misma de arriba: un grupo que entre todos no cabe por debajo de W.
Sea R el conjunto de equipos alcanzables desde s en la red residual final. Para un conjunto de equipos R, sea g(R) la cantidad de partidos que faltan entre equipos de R.
Teorema. Si el flujo máximo es menor que G, el conjunto R no es vacío y
Σ de wᵢ para i en R, más g(R), es mayor que |R| · W.
Por lo tanto, en cualquier resultado final de los partidos, algún equipo de R termina con más de W victorias.
Demostración. Sea S lo alcanzable desde s, y consideremos su corte, de capacidad menor que G. Si un nodo de partido {i, j} está en S, sus aristas sin límite tienen capacidad residual, y entonces i y j están en R. Las aristas que salen de S son s → {i, j} con {i, j} fuera de S, e i → t con i en R. La capacidad del corte es
(G − suma de g(i, j) con {i, j} en S) + suma de (W − wᵢ) con i en R.
Como es menor que G, sale que la suma de g(i, j) con {i, j} en S es mayor que la suma de (W − wᵢ) con i en R. Esa suma de los g(i, j) es a lo sumo g(R), porque cada uno de esos pares tiene sus dos equipos en R. Entonces g(R) > |R| · W − Σ wᵢ, que es la desigualdad del teorema. Si R fuera vacío, ningún nodo de partido estaría en S, y la capacidad sería G, lo que no es posible.
La conclusión es un promedio. Los partidos de g(R) se juegan todos entre equipos de R, de modo que, al final, los equipos de R suman por lo menos Σ wᵢ + g(R) victorias. Eso es más que |R| · W, y por eso alguno de ellos pasa de W. x no llega a más de W. ∎
Esta es una prueba que se puede revisar con una cuenta, sin saber nada de flujo:
$ build/baseball_demo
...
Piura: el grupo que lo elimina es Lima Cusco Ica
  victorias ya ganadas: 79
  partidos entre ellos: 6
  máximo para que nadie pase a Piura: 3 x 28 = 84
  fuerza bruta, ¿puede quedar primero?: no
79 + 6 = 85 victorias, y solo caben 84. Por las cuentas, alguien llega a 29. test_examples.cpp compara la decisión con
la fuerza bruta sobre todos los resultados posibles, en 2500 campeonatos al azar, y comprueba la desigualdad del
certificado cada vez que hay eliminación.
El costo: si hay e equipos, hay O(e²) nodos de partido y O(e²) aristas. Con Edmonds-Karp, son O(V · E²) = O(e² · e⁴) = O(e⁶) como cota, por equipo. Con Ford-Fulkerson, hay a lo sumo G aumentos, y cada búsqueda cuesta O(e²). En un campeonato real, esto es instantáneo.
Selección de proyectos
Hasta aquí, la respuesta se leía en el flujo. Ahora viene el otro lado: una aplicación en la que lo que importa es el corte.
Una empresa evalúa proyectos. Cada proyecto tiene una ganancia, que puede ser negativa: un costo. Algunos proyectos requieren otros: si se hace p y p requiere q, hay que hacer q. Se busca elegir un conjunto que respete los requisitos, con la mayor ganancia total.
Un conjunto X de proyectos es cerrado (closed) si, para cada p de X y cada q que p requiere, q también está en X. El problema es encontrar un conjunto cerrado de máxima ganancia. El conjunto vacío es cerrado, y entonces el óptimo es por lo menos 0.
Lo que no funciona
Una idea natural es ir proyecto por proyecto: mirar el proyecto junto con todo lo que le falta, y hacerlo si ese paquete, por sí solo, deja ganancia. Veamos este ejemplo:
$ build/projects_demo
proyecto    ganancia
tienda      5
reportes    4
app         9
servidor    -6
api         -8
auditoria   3
robot       2
sensor      -5
requisitos: tienda, reportes y app piden servidor; app y auditoria piden api; robot pide sensor

Greedy, paquete por paquete: (ninguno)
  ganancia: 0
...
Ningún paquete sirve por sí solo: tienda con servidor pierde 1, reportes con servidor pierde 2, y app con servidor y api pierde 5. Pero juntos pagan el servidor una sola vez. El problema es que los costos se comparten, y el greedy los cobra completos a cada proyecto.
La red
Construimos esto:
- Un nodo por proyecto, además de s y t.
- s → p con capacidad igual a la ganancia de p, si es positiva.
- q → t con capacidad igual al costo de q, es decir, a menos su ganancia, si es negativa.
- p → q con capacidad infinita, si p requiere q.
La interpretación es lo que importa. Un corte (S, T), con s en S, reparte los proyectos en dos lados. Decimos que los proyectos de S son los elegidos. Sea P la suma de todas las ganancias positivas.
Teorema. Los cortes de capacidad finita corresponden exactamente a los conjuntos cerrados: X = S − {s}. Además, la capacidad de ese corte es P − ganancia(X). Por lo tanto,
ganancia máxima = P − capacidad del corte mínimo,
y los elegidos son los nodos alcanzables desde s, sin contar s, en la red residual final.
Dirección 1: de un conjunto cerrado a un corte finito. Sea X cerrado, y S = {s} ∪ X. Una arista infinita p → q que salga de S tendría p en X y q fuera de X, lo que contradice que X es cerrado. Entonces la capacidad es finita.
Dirección 2: de un corte finito a un conjunto cerrado. Sea (S, T) un corte de capacidad finita, y X = S − {s}. Si p está en X, y p requiere q, entonces hay una arista infinita p → q. Si q no estuviera en X, esa arista saldría de S, y la capacidad sería infinita. Entonces X es cerrado.
La capacidad. Las aristas que salen de S son dos clases:
- s → p, con p fuera de X y ganancia positiva. Cuentan lo que dejamos de ganar.
- q → t, con q en X y ganancia negativa. Cuentan lo que pagamos.
Es decir, capacidad = (positivas fuera de X) + (costos dentro de X). Y como
ganancia(X) = (positivas dentro de X) − (costos dentro de X) = P − (positivas fuera de X) − (costos dentro de X),
resulta que ganancia(X) = P − capacidad. Maximizar la ganancia es minimizar el corte. Lo alcanzable desde s, por la semana 11, da un corte mínimo, y entonces es un conjunto cerrado óptimo. ∎
Idea clave. Un corte es una decisión binaria por cada nodo: de un lado o del otro. Si cada decisión tiene un costo, y las incompatibilidades se pueden prohibir con aristas infinitas, un corte mínimo elige la mejor combinación. Aquí no importa qué “fluye” en la red. El flujo es solo la forma de calcular el corte.
En el ejemplo
$ build/projects_demo
...
Corte mínimo:
  suma de ganancias positivas: 23
  corte mínimo:                16
  ganancia máxima:             7
  elegidos: tienda reportes app servidor api auditoria
  fuerza bruta:                7
...
P = 5 + 4 + 9 + 3 + 2 = 23. El corte mínimo vale 16, y sus aristas son estas:
| Arista del corte | Capacidad | Significa |
|---|---|---|
| servidor → t | 6 | se paga el servidor |
| api → t | 8 | se paga la API |
| s → robot | 2 | se renuncia a robot |
Elegidos: 5 + 4 + 9 + 3 − 6 − 8 = 7. Robot queda fuera, porque ganar 2 no paga el sensor de 5. sensor tampoco está: no
hay razón para pagarlo.
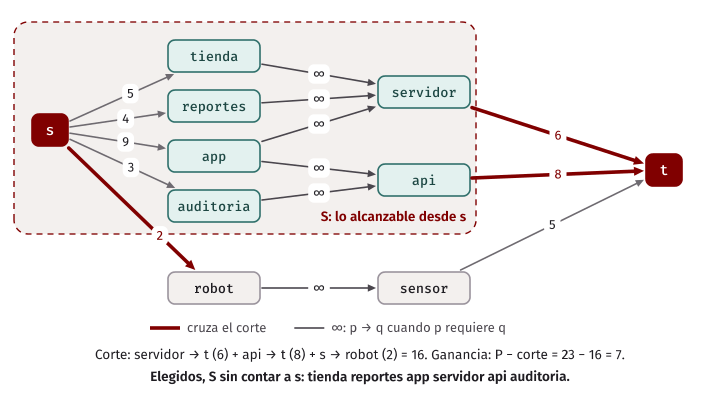
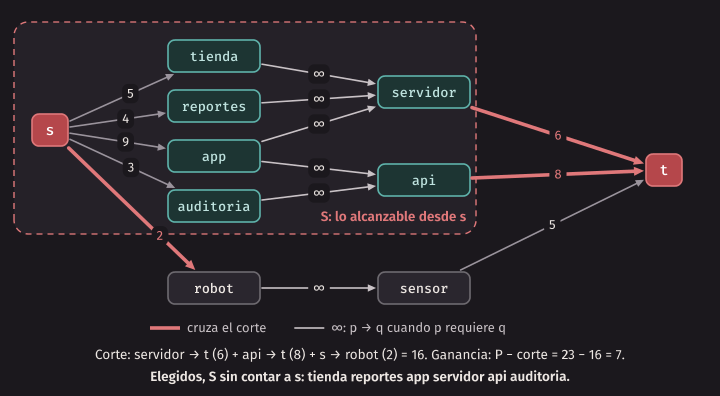
Puede haber varios conjuntos con la misma ganancia. Lo alcanzable desde s da uno de ellos, el que tiene menos nodos, aunque eso no hará falta en este capítulo.
Por qué infinito, y cuánto es infinito
La pregunta de repaso: ¿por qué las aristas de requisito tienen capacidad infinita? Porque un requisito no se puede “pagar” para saltárselo. Si la capacidad fuera finita, un corte podría tenerla y elegir p sin q, y la lectura diría que ese es un conjunto válido. Esto pasa si le ponemos capacidad 1:
$ build/projects_demo
...
Si los prerrequisitos tuvieran capacidad 1:
  la cuenta dice:              17
  elegidos: tienda reportes app auditoria robot
  ¿respetan los requisitos?    no
  suma de sus ganancias:       23
Se eligen todos los que dan ganancia y ninguno de los que cuestan. Es la dirección 2 rota, una vez más: el corte ya no representa una solución.
En un programa no hay infinito, y INT_MAX es una mala elección: sumado a un flujo, da overflow. Basta un número mayor que
cualquier corte que pueda ser mínimo. El corte {s} tiene capacidad exactamente P, así que el mínimo es a lo sumo P. Una
arista de capacidad P + 1 no puede estar en un corte mínimo. En el programa:
long long infinity = result.positive_total + 1;Eso sí tiene una consecuencia práctica. El flujo no pasa de P, de modo que estas aristas nunca se saturan y lo alcanzable
las cruza siempre: por eso el conjunto leído es cerrado. Y las capacidades residuales quedan a lo sumo en 2P + 1, que
cabe en long long si las ganancias suman menos de unos 4 × 10¹⁸. Con int, un total de 3 × 10⁹ ya no cabe:
test_examples.cpp prueba exactamente ese caso.
También pueden existir ciclos de requisitos: si p requiere q, y q requiere p, los dos van juntos. La demostración no
supuso que no hay ciclos, y las pruebas al azar de test_examples.cpp los incluyen.
Cómo leer la solución
Resumiendo dónde está la respuesta en cada reducción del capítulo:
| Problema | Qué se calcula | Dónde está la respuesta |
|---|---|---|
| Matching, asignación con cupos | Flujo máximo | Aristas del medio con flujo 1 |
| Caminos disjuntos | Flujo máximo | Aristas con flujo 1, descompuestas en caminos, sin los ciclos |
| Menger: lo mínimo que desconecta | Corte mínimo | Aristas de R a su complemento en la red original, o nodos con v_in en R y v_out fuera |
| Hall con cupos: el grupo que limita | Corte mínimo | Estudiantes y secciones alcanzables desde s |
| Eliminación: ¿queda vivo? | Valor del flujo | ¿Es igual a G? |
| Eliminación: el grupo culpable | Corte mínimo | Equipos alcanzables desde s |
| Selección de proyectos | Corte mínimo | Proyectos alcanzables desde s |
Siempre, R es lo alcanzable desde s en la red residual al final. Y las aristas de un corte se leen en la red original, de R hacia afuera. Como vimos en la semana pasada, no toda arista saturada cruza el corte.
Cómo reconocer un problema de flujo
No hay una receta, pero hay señales:
- Un recurso que se reparte. Unidades que salen de algún lado, pasan por lugares con un límite, y llegan a otro: cupos, victorias, rutas.
- Elecciones de a uno. Cada persona elige una opción de un conjunto. Eso es una arista s → persona con capacidad 1.
- Límites de “a lo sumo”. Cupos, capacidades, “no más de k”. Cada uno es una capacidad en una arista, o en un nodo dividido.
- Una sola decisión binaria por objeto, con costos. Adentro o afuera, con penalidades e incompatibilidades. Eso es un corte, como en los proyectos.
Y hay señales en contra:
- Una restricción que une tres cosas a la vez. La red solo recuerda el nodo actual, no de dónde viene una unidad. Si la regla es “este estudiante no puede ir a esta sección en este horario”, y los tres son independientes, una red por capas no puede expresarla.
- Costos por combinación. “Si elijo x e y, gano un bono.” Algunos caben, otros no. Hay que demostrar la reducción, no esperar que funcione.
- Un grafo que no es bipartito. El matching en un grafo general se resuelve en tiempo polinomial, pero no con esta red, y el triángulo de arriba muestra por qué falla.
- Una restricción de “al menos”. Es el tema de la próxima sección.
Y, ante la duda, el método es el mismo: escribir las dos direcciones. Si una de las dos no sale, la demostración les dice qué parte del modelo está mal.
Una restricción que no es de capacidad
Agregamos una regla al problema: se asigna gente de dos grupos a dos turnos, y tiene que haber al menos dos de cada grupo. La tentación es poner capacidad 2 en la arista del grupo. Pero una capacidad dice “a lo sumo”, no “al menos”. Una forma corta de verlo: el flujo cero siempre respeta todas las capacidades, y aquí no cumple la regla. Ninguna elección de capacidades puede prohibirlo.
El programa lower_bound_demo usa esta red, donde cada unidad es una persona. El grupo A tiene 4 personas y B tiene 2. T1
tiene cupo 3 y T2 tiene cupo 2. A puede poner hasta 3 en T1 y 1 en T2, y B solo puede ir a T2:
$ build/lower_bound_demo
Grupo A: 4 personas. Grupo B: 2 personas. Turnos: T1 con cupo 3, T2 con cupo 2.
A puede ir a T1 (hasta 3) o a T2 (1). B solo puede ir a T2.

Sin restricción:
  total 5, grupo A 4, grupo B 1
Capacidad 2 en s -> grupo, que significa "a lo sumo dos":
  total 4, grupo A 2, grupo B 2
Cota inferior 2 en s -> grupo:
  total 5, grupo A 3, grupo B 2
  fuerza bruta: 5

Si B pudiera aportar solo por T2 y T2 tuviera cupo 1, no hay solución:
  factible: no, fuerza bruta: -1
El flujo máximo sin restricción deja a B con 1, aunque existe otra solución del mismo valor que cumple la regla. Con capacidad 2, se cumple la regla por casualidad, pero se pierde a una persona: A no puede poner 3. Ninguna de las dos es la respuesta, que es 5 con (3, 2).
Error común. Modelar una restricción que no es de capacidad, como “al menos dos de cada grupo”, poniendo un número en una arista. Una capacidad es una cota superior. Si la regla es una cota inferior, la red tiene que cambiar.
Cotas inferiores
La forma estándar es la cota inferior (lower bound): cada arista u → v debe llevar entre ℓ y c. Se quita lo obligatorio y se contabiliza aparte. Damos a la arista capacidad c − ℓ, y anotamos que v recibió ℓ y que u entregó ℓ, sin que el resto de la red se entere. Para que esas cuentas cuadren, se agrega una fuente nueva s* con s* → v de capacidad ℓ, un sumidero nuevo t* con u → t* de capacidad ℓ, y una arista t → s sin límite. Hay un flujo de valor no negativo que cumple las cotas si y solo si un flujo máximo de s* a t* satura todas las aristas de s*. Si es así, se anota lo que lleva t → s, se quita esa arista y se sigue aumentando de s a t. El valor final es lo anotado más lo aumentado.
No vamos a demostrar esto aquí: es un ejercicio del capítulo. Lo que sí hacemos es comprobarlo: max_flow_with_lower_bounds
coincide con una fuerza bruta que prueba todos los valores de cada arista en 1500 redes pequeñas, sin aristas que entren a s ni salgan de t, incluida la decisión de si
hay solución. Es una prueba de que el programa hace lo que dice, y no reemplaza a la demostración.
El código de la semana
En code/week-12:
| Archivo | Qué contiene |
|---|---|
flow.h |
La clase MaxFlow: add_edge, edmonds_karp, ford_fulkerson, reachable_from, flow_on, y el conteo de aumentos |
matching.h |
matching_network, read_matching, max_matching, is_matching, los dos greedy y la fuerza bruta |
disjoint_paths.h |
decompose_flow, edge_disjoint_paths, undirected_edge_disjoint_paths, minimum_edge_cut, split_network, vertex_disjoint_paths, minimum_vertex_separator |
baseball.h |
check_team, certificate_holds y la fuerza bruta |
projects.h |
best_projects, is_closed, el greedy por paquetes y la fuerza bruta |
lower_bounds.h |
max_flow_with_lower_bounds y la fuerza bruta |
matching_demo.cpp |
La red de 3 por 3, los greedy que fallan y la red sin límite en s → E |
disjoint_demo.cpp |
Descomposición, aristas, nodos, no dirigido y s vecino de t |
quota_demo.cpp |
Una red con cupos escrita a mano, lo alcanzable, y dos estudiantes con una silla |
baseball_demo.cpp |
La tabla del campeonato y el grupo que elimina a Piura |
projects_demo.cpp |
El greedy, el corte mínimo y la capacidad finita |
lower_bound_demo.cpp |
Tres modelos de “al menos dos de cada grupo” |
matching_bench.cpp |
Aumentos y tiempo del matching. Se corre con make bench |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. La medición va con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
Todas las pruebas de la semana 12 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- En el matching: 3000 grafos al azar, donde flujo con BFS, flujo con DFS y fuerza bruta coinciden, lo leído es un matching, y hay a lo sumo mín(|L|, |R|) aumentos. Los greedy fallan donde dice el texto. Sin el límite en s → E, el flujo da 2 y el matching da 1.
- En la descomposición: 2000 flujos armados sumando caminos y ciclos. Salen tantos caminos como el valor, todos simples, y ninguna unidad se pierde. Un ciclo que pasa por s y por t no se toma por un camino.
- En Menger: 1500 grafos al azar, con las dos formas. Los caminos son disjuntos de verdad, y son tantos como el mínimo calculado por fuerza bruta. Con una arista directa, hay uno más que sin ella.
- En el caso no dirigido: 1500 grafos, donde ninguna arista se usa dos veces.
- En el campeonato: 2500 instancias, comparadas con todos los resultados posibles de los partidos. El certificado cumple su desigualdad cada vez que hay eliminación.
- En los proyectos: 3000 instancias, con requisitos cíclicos, comparadas con los 2ⁿ subconjuntos. El conjunto leído es cerrado y
suma el valor calculado. También hay un caso con ganancias que no caben en
int. - En las cotas inferiores: 1500 redes pequeñas, comparadas con todos los valores posibles de cada arista.
Una de estas pruebas encontró un bug real mientras se escribía el capítulo: la primera versión de decompose_flow perdía
aristas al apartar un ciclo que no empezaba en el nodo inicial. Una descomposición parece demasiado simple para necesitar
pruebas, y la condición “ninguna unidad se pierde” es lo que lo delató.
La medición va aparte, con make bench. Aquí tardó menos de medio minuto, casi todo en la fila de n = 32000.
El laboratorio
El problema de la sesión está en lab/section_assignment: asignar estudiantes a secciones, con cupos, y un verificador que
revisa la asignación. Se resuelve con la red de la sección de cupos, que está en pseudocódigo. Pueden implementar Edmonds-Karp
o reutilizar su código de flujo. El esqueleto lee la entrada y no asigna a nadie, así que da WA en casi todos los casos.
cd lab/section_assignment
make test
La extensión, en lab/section_bottleneck, es opcional. Cuando no entran todos, pide además el grupo de estudiantes y de
secciones que lo explica, en el sentido del teorema de Hall con cupos. Su verificador no confía en ustedes: recalcula N(A), y
comprueba que |A| − c(N(A)) sea exactamente lo que falta.
Lean los límites en cada enunciado antes de elegir cómo guardar la red. No toda representación de un grafo cabe en esos límites.
Resumen
- Una reducción transforma una instancia, lee la solución y demuestra que se corresponden. Se demuestran las dos direcciones: toda solución da una solución de la red, y toda solución de la red da una solución.
- Matching bipartito: s → izquierda, derecha → t y las aristas del medio, todas con capacidad 1. El matching son las aristas del medio con flujo 1. Cuesta O(V · (V + E)), que es O(VE) sin nodos aislados, porque el flujo es a lo sumo V / 2.
- Integralidad: la lectura necesita un flujo entero. Existen flujos máximos fraccionarios, como ½ en un ciclo de 4, pero con capacidades enteras Ford-Fulkerson encuentra uno entero.
- Una arista olvidada: sin la capacidad en s → x, sigue valiendo una dirección y la otra no. La red responde 2, donde la verdad es 1.
- Descomposición: un flujo entero se reparte en caminos de s a t, tantos como su valor, más ciclos que se descartan. La conservación impide atascarse.
- Caminos disjuntos en aristas: capacidades 1. En un grafo no dirigido, dos aristas dirigidas por cada una, y se cancela si el flujo usa las dos.
- Caminos disjuntos en nodos: cada nodo se divide en v_in → v_out con capacidad 1. s y t no se dividen. Una arista directa s → t cuenta como un camino, sin nodos internos.
- Menger: el máximo de caminos disjuntos es igual al mínimo de aristas, o de nodos, que desconecta. La forma con nodos pide que s y t no sean vecinos. Los dos son corolarios de flujo máximo y corte mínimo.
- Asignación con cupos: como el matching, con capacidad cⱼ en j → t. Cuesta O(n · (n + m + D)), sin que importen los cupos.
- Hall con cupos: k = mín de n − |A| + c(N(A)). Lo alcanzable desde s da ese A, con B = N(A). Es el grupo que explica lo que falta. Las secciones llenas no lo son.
- Eliminación: primero el caso trivial, para que W − wᵢ no sea negativo. x gana todo. Las victorias de los demás se reparten con una red, y x vive si y solo si se satura s. El corte da un grupo cuyo promedio de victorias pasa de W.
- Selección de proyectos: s → ganancia, costo → t, p → q infinito. Los cortes finitos son los conjuntos cerrados, y ganancia = P −
corte. Los elegidos son lo alcanzable. Infinito es P + 1, en
long long. - Una capacidad es “a lo sumo”. “Al menos dos” no se escribe con un número en una arista: se necesita una cota inferior.
- Una red no recuerda de dónde viene una unidad. Si la regla une tres cosas a la vez, desconfíen del modelo.
Ejercicios
- A mano. Dibujen la red para E0: S0 S1 S2, E1: S0, E2: S0 S1, E3: S1, con todas las capacidades en 1. Corran caminos de aumento a mano, en el orden que quieran, hasta que no quede ninguno. Digan quién se queda fuera, y den el conjunto A del teorema de Hall que lo explica.
- Las dos direcciones. Reescriban, sin mirar, la demostración de matching en las dos direcciones. Marquen en qué línea se usa cada una de las tres clases de aristas, y en cuál se usa la integralidad.
- Una red demasiado estrecha. Alguien pone capacidad 1 en todas las aristas j → t de la asignación con cupos, “para simplificar”.
¿Qué dirección de la demostración se rompe? Den una instancia donde la respuesta salga mal y compruébenla con la fuerza bruta de
matching.h. - Secciones en copias. En vez de una arista j → t de capacidad cⱼ, se podría copiar cada sección cⱼ veces y usar matching. Demuestren que da la misma respuesta. ¿Cuántas aristas tiene esa red, comparada con la de los apuntes? ¿Qué pasa con un cupo de 5000?
- Hall, a mano. Demuestren el teorema de Hall clásico sin usar flujo, por inducción sobre |L|: un grafo bipartito tiene un matching que cubre L si y solo si |A| ≤ |N(A)| para todo A ⊆ L. Comparen esa demostración con la que sale del corte.
- Grafos regulares. Un grafo bipartito es d-regular si todos sus nodos tienen grado d, con d ≥ 1. Demuestren que tiene un matching que cubre todos los nodos: den un flujo fraccionario de valor |L| en la red y usen la integralidad. Concluyan que sus aristas se pueden repartir en d matchings.
- Capacidades de nodo. Dado un grafo dirigido, cada nodo v tiene una capacidad c(v), y cada arista una capacidad. Definan el problema
del flujo máximo con estas capacidades, den la red, y demuestren las dos direcciones. Escriban la función con
MaxFlowy pruébenla en un ejemplo que resuelvan a mano. - Cubrir un DAG. En un DAG, se quiere cubrir todos los nodos con la menor cantidad de caminos que no comparten nodos. Demuestren que el mínimo es V − (matching máximo), en la red bipartita con un x_out y un y_in por nodo, y una arista x_out → y_in por cada arista x → y. Programen la lectura de los caminos, y compárenla con una fuerza bruta en DAG pequeños.
- Eliminación: todos o nadie. Construyan un campeonato de 4 equipos donde x tenga W mayor que las victorias actuales de todos, y
esté eliminado, y el grupo R tenga exactamente 2 equipos. Comprueben con
check_team. Luego demuestren que si x no está eliminado y gana un partido más que estaba pendiente con y, x sigue sin estar eliminado. - Empates y puntos. Si los partidos pudieran empatar, con 3 puntos por victoria y 1 por empate para cada equipo, ¿sigue funcionando la red con capacidades “repartir g partidos”? Muestren qué parte de la demostración se rompe, con un ejemplo. El problema general con esa regla de puntos es más difícil: no intenten resolverlo, expliquen por qué un partido ya no reparte siempre lo mismo.
- Selección de proyectos en C++. Agreguen a
projects.huna función que dé todos los proyectos que aparecen en todo conjunto óptimo, y otra para los que aparecen en alguno. Pista: comparen lo alcanzable desde s con lo que puede llegar a t en la red residual. Compruébenlo con la fuerza bruta. - Cotas inferiores. Demuestren la transformación de los apuntes: hay un flujo de valor no negativo que respeta todas las cotas si y solo si el flujo
máximo de s* a t* satura todas las aristas de s*. Usen la misma estructura de dos direcciones que en todo el capítulo. Luego
apliquen la transformación a mano a una arista s → A con ℓ = 2 y c = 4, y comparen con
lower_bound_demo.