Apuntes · Capítulo 13Flujo e intratabilidad
P, NP y reducciones
P, NP y reducciones
La semana pasada usamos reducciones para resolver: un problema que no hablaba de redes se convertía en un flujo máximo, y un programa ya escrito daba la respuesta. Todo eso terminaba con buenas noticias.
Esta semana las reducciones cambian de oficio. Hay problemas que nadie sabe resolver rápido, por más que lo intenten desde hace décadas: el conjunto independiente en un grafo general, el problema del viajero, el 3-coloreo. No hay ninguna demostración de que sean imposibles de resolver rápido, y tampoco hay un algoritmo. Lo que sí hay es una red de reducciones entre ellos, y esa red dice algo muy fuerte: son, en un sentido preciso, el mismo problema. Quien resuelva uno rápido los resuelve a todos.
Para decir eso con cuidado hacen falta tres definiciones, y las vamos a dar en orden: problema de decisión, P y NP. Con ellas se puede plantear la pregunta abierta más famosa de la computación, y se puede definir la reducción polinomial, que es la herramienta de esta semana y de la próxima. El error más frecuente es el sentido de la flecha, así que le dedicamos una sección.
La segunda sesión trabaja con reducciones concretas: conjunto independiente, cobertura de vértices y clique resultan ser tres caras de lo mismo. Después viene el giro práctico. SAT es difícil en teoría, y aun así hay programas que resuelven fórmulas enormes en segundos, en muchos casos, sin ninguna garantía para todos. Por eso codificar un problema como una fórmula es un método de trabajo, y en el laboratorio lo van a usar para resolver sudokus de 25 por 25, donde un backtracking simple no termina.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Problemas parecidos con destinos distintos, Problemas de decisión, La clase P, P contra NP y SAT y CNF.
En clase: Sesión A, de El tamaño de la entrada se mide en bits a Por qué la mochila no demuestra P = NP. Sesión B, de Conjunto independiente y cobertura de vértices a Al menos uno y a lo sumo uno.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El formato DIMACS y
minisat, El laboratorio: un sudoku como fórmula y El código de la semana. Para ampliar, Un solucionador SAT por dentro y las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, secs. 12.1 (A Game You Can’t Win), 12.2 (P versus NP) y 12.3 (NP-hard, NP-easy, and NP-complete). CLRS, capítulo NP-Completeness, 4.ª edición. Sesión B: Erickson, secs. 12.5 (Reductions and Sat), 12.8 (The General Pattern) y 12.9 (Clique and Vertex Cover). CLRS, capítulo NP-Completeness, 4.ª edición. Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-13. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El problema de laboratorio está enlab/sudoku_sat, con su propiomake test.
Problemas parecidos con destinos distintos
Empecemos con dos pares de problemas que parecen casi iguales.
Camino mínimo y camino más largo. Dado un grafo con pesos no negativos, el camino más corto entre dos nodos sale con Dijkstra en tiempo polinomial. Ahora cambien una palabra: el camino simple más largo, el que no repite nodos. Nadie conoce un algoritmo polinomial para eso. Una idea natural es negar los pesos y correr Bellman-Ford, pero eso no sirve. Un ciclo positivo se convierte en un ciclo negativo, y entonces “el camino de peso mínimo” deja de estar definido si se permite repetir nodos.
El motivo de fondo se ve en los subproblemas. Un tramo de un camino mínimo es también un camino mínimo, y esa subestructura óptima es lo que aprovechan Dijkstra y Bellman-Ford. Un tramo de un camino simple más largo no tiene por qué ser el más largo entre sus extremos: puede que el más largo de ese tramo pase por nodos que el resto del camino ya usó. Para decidir, entonces, hay que recordar qué nodos se usaron. Esos son los 2ⁿ estados de Held-Karp de la semana 10. En un DAG el problema se vuelve fácil, con programación dinámica en orden topológico, porque ahí no se puede volver a un nodo.
2-coloreo y 3-coloreo. Un coloreo (coloring) propio asigna un color a cada nodo, de modo que dos vecinos no tengan el mismo color. Con 2 colores, un BFS lo resuelve en O(V + E): al pintar un nodo, cada vecino queda obligado a tener el otro color, y solo falta ver si aparece un choque. Con 3 colores, al pintar un nodo, cada vecino todavía tiene dos opciones. Esa pequeña libertad destruye el método, y nadie conoce un algoritmo polinomial para 3-coloreo.
Hace falta decir qué significa “difícil” con precisión. No sabemos demostrar que estos problemas no tienen algoritmo rápido. Sí sabemos otra cosa: comparar unos problemas con otros.
Idea clave. “No conozco un algoritmo rápido” no es lo mismo que “no existe”. La teoría de esta semana no demuestra que estos problemas sean imposibles de resolver rápido. Demuestra que todos ellos se sostienen o se caen juntos.
Problemas de decisión
Un problema de decisión (decision problem) es uno cuya respuesta es sí o no. Cada entrada particular es una instancia, y hay instancias “sí” e instancias “no”.
La mayoría de los problemas que hemos visto son de optimización: el conjunto independiente más grande, el camino más corto. Cada uno tiene una versión de decisión, que recibe un número k además de la instancia:
| Optimización | Decisión |
|---|---|
| Conjunto independiente máximo de G | ¿Tiene G un conjunto independiente de tamaño al menos k? |
| Cobertura de vértices mínima de G | ¿Tiene G una cobertura de vértices de tamaño a lo sumo k? |
| Mínimo de colores para G | ¿Se puede colorear G con k colores? |
| Tour más corto | ¿Hay un tour de longitud a lo sumo L? |
| Mochila de mayor valor | ¿Hay objetos con peso a lo sumo W y valor al menos V? |
¿No perdemos nada al quedarnos con la decisión? Para lo que nos interesa, no. Si la decisión se resuelve en tiempo polinomial, la optimización también, en los casos de esta semana. El conjunto independiente máximo tiene tamaño entre 0 y n, así que una búsqueda binaria sobre k encuentra el tamaño máximo con O(log n) preguntas. Y si además quieren el conjunto, no solo su tamaño, el truco es este: fijen el tamaño máximo k y recorran los nodos. Para cada nodo v, pregunten si G sin v todavía tiene un conjunto independiente de tamaño k. Si lo tiene, borren v. Lo que queda al terminar son nodos tales que cada uno es necesario para llegar a k, y entonces son exactamente el conjunto buscado. Son n preguntas más. El ejercicio 4 les pide programarlo.
En el sentido contrario es inmediato: si saben calcular el óptimo, comparan con k. Así, los dos problemas son polinomiales o no lo son al mismo tiempo. Trabajamos con la decisión porque hace más limpias las definiciones: una reducción transforma una pregunta de sí o no en otra.
El tamaño de la entrada se mide en bits
“Polinomial” hay que decirlo respecto de algo. La definición formal usa el tamaño de la entrada en bits: cuántos bits hacen falta para escribirla. La llamamos b.
En un grafo sin números grandes, esto no cambia nada. Una lista de aristas ocupa O((V + E) log V) bits, y un algoritmo polinomial en V + E es polinomial en b. Por eso hasta ahora medíamos en V y en E, sin preocuparnos.
Los números son otra historia, y ya lo vimos en la semana 7. El número W se escribe con unos log W bits. Con 40 bits se puede escribir un W de alrededor de un billón. La mochila cuesta O(nW), y esa cuenta es polinomial en n y en el valor de W, pero no en los bits que lo escriben. Con n fijo, cada bit adicional puede duplicar W, y por tanto la tabla. Por eso la llamamos pseudopolinomial. Si la entrada son n objetos con números de c bits, b es de orden n · c, y el trabajo puede llegar a n · 2ᶜ.
Lo mismo le pasa a probar si N es primo dividiendo por todos los números hasta √N. Parece rápido, porque √N es “poco”. Pero N tiene b = log N bits, de modo que √N = 2^(b/2), que es exponencial en b.
Error común. Decir que un algoritmo es polinomial porque su fórmula no tiene exponentes, sin mirar si los símbolos son cantidades de objetos o valores de números. O(nW) tiene aspecto polinomial. Solo lo es si W tiene un valor pequeño respecto de la entrada, por ejemplo si W ≤ n².
La clase P
P es la clase de los problemas de decisión que tienen un algoritmo correcto para toda instancia, y que corre en tiempo O(bᶜ) para alguna constante c, donde b es el tamaño de la instancia en bits.
Pertenecen a P, entre otros: ¿hay un camino de s a t?, ¿hay un camino de peso a lo sumo L, con pesos no negativos?, ¿hay un matching de tamaño k?, ¿hay un flujo de valor k?, ¿es 2-coloreable el grafo?, ¿hay un árbol de expansión de peso a lo sumo L?
Dos aclaraciones. Primera: es una propiedad del problema, no de un programa. Un problema está en P si existe un algoritmo polinomial, aunque el que ustedes escribieron sea exponencial. Segunda: “polinomial” no significa “rápido” sin más, porque O(b¹⁰⁰) es polinomial. Se usa como frontera porque es robusta. No cambia si se cambia de máquina razonable o de una representación razonable a otra, y se cierra bajo composición: un polinomial de un polinomial es polinomial. Esa última propiedad es la que van a usar las reducciones.
La clase NP
Miren el conjunto independiente. Encontrar uno de tamaño k parece difícil. Pero si alguien les trae una lista de k nodos y les dice “este es”, comprobarlo es muy fácil: revisan cada arista y ven que no tenga los dos extremos en la lista.
Esa asimetría es lo que define a NP. La lista es la prueba de que la respuesta es sí. A esa prueba la llamamos certificado.
Definición. Un problema de decisión está en NP si existe un algoritmo V, el verificador, y un polinomio p, tales que:
- V recibe una instancia x y un certificado (certificate) c, de a lo sumo p(|x|) bits, y corre en tiempo polinomial en |x|.
- Si x es una instancia “sí”, existe algún c con el que V acepta.
- Si x es una instancia “no”, V rechaza todo c.
Las dos últimas condiciones se complementan, y ninguna implica a la otra: V nunca se deja engañar, y toda respuesta “sí” tiene alguna prueba corta. Nadie dice de dónde sale c. El verificador solo lo revisa.
En la semana 11 usamos esta misma idea sin nombrarla: un corte con la capacidad justa prueba que un flujo es máximo, y lo revisa un verificador que no necesita ninguna solución de referencia. En el laboratorio de esta semana también hay uno: revisa que el tablero cumpla las reglas.
Un ejemplo: conjunto independiente
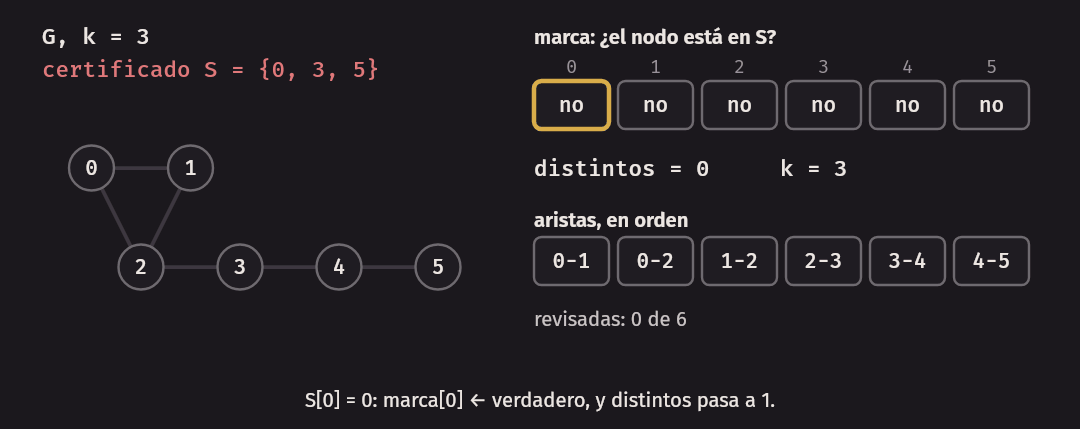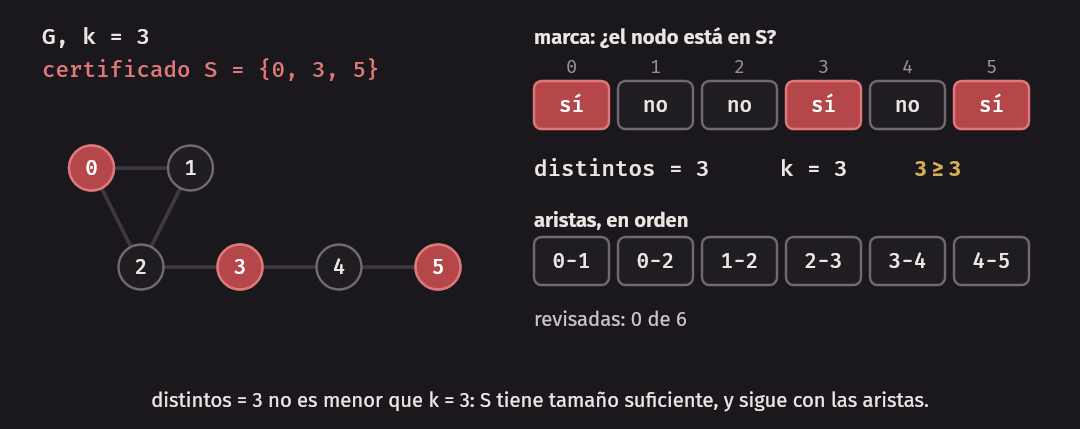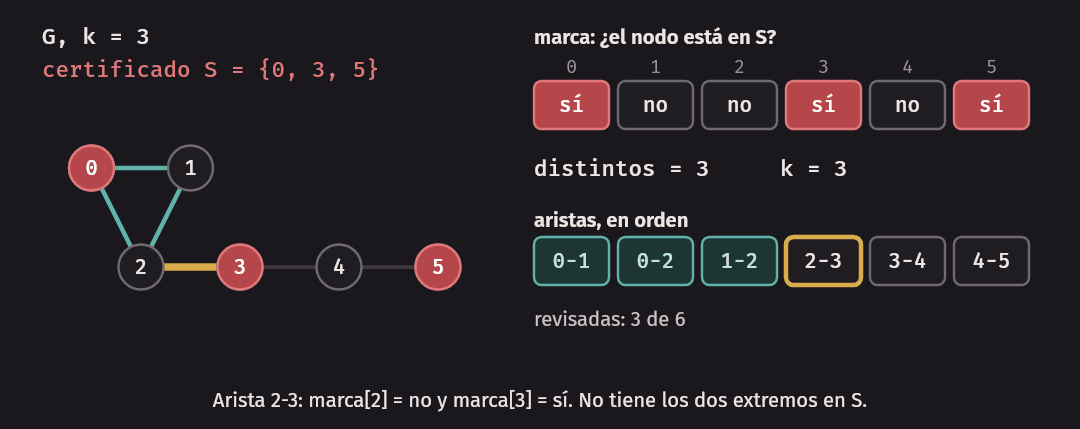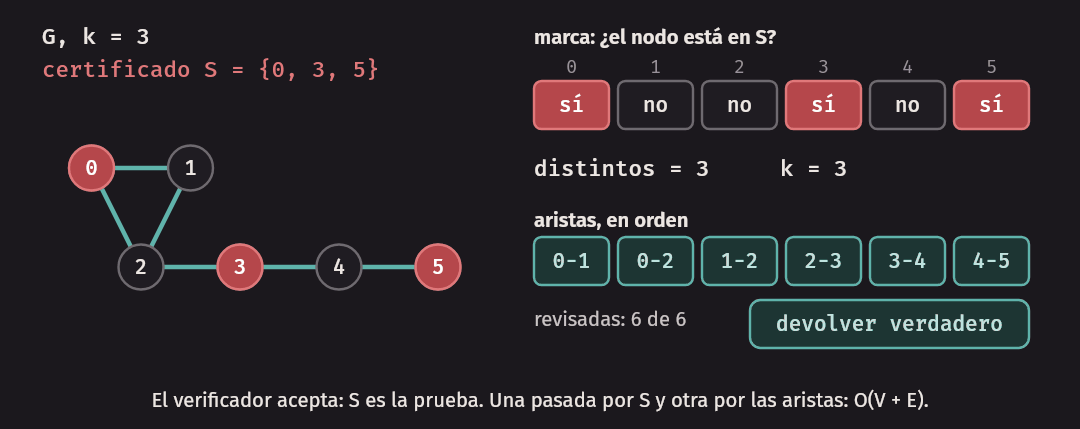
Un conjunto independiente (independent set) de un grafo es un conjunto de nodos entre los cuales no hay ninguna arista. Entonces, la primera pregunta de repaso: ¿qué es un certificado para conjunto independiente, qué se verifica y cuánto cuesta?
- El certificado es la lista S de nodos. Ocupa a lo sumo V · log V bits, que es polinomial.
- Se verifica que S tenga al menos k nodos distintos y que ninguna arista tenga sus dos extremos en S.
- Cuesta O(V + E): se marcan los nodos de S en un arreglo y se pasa una vez por las aristas.
algoritmo verificar_independiente(G, k, S)
    marca ← arreglo de V valores falso
    distintos ← 0
    para i desde 0 hasta |S| - 1 hacer
        si no marca[S[i]] entonces
            marca[S[i]] ← verdadero
            distintos ← distintos + 1
        fin si
    fin para
    si distintos < k entonces
        devolver falso
    fin si
    para i desde 0 hasta E - 1 hacer
        (u, v) ← aristas[i]
        si marca[u] y marca[v] entonces
            devolver falso
        fin si
    fin para
    devolver verdadero
fin algoritmo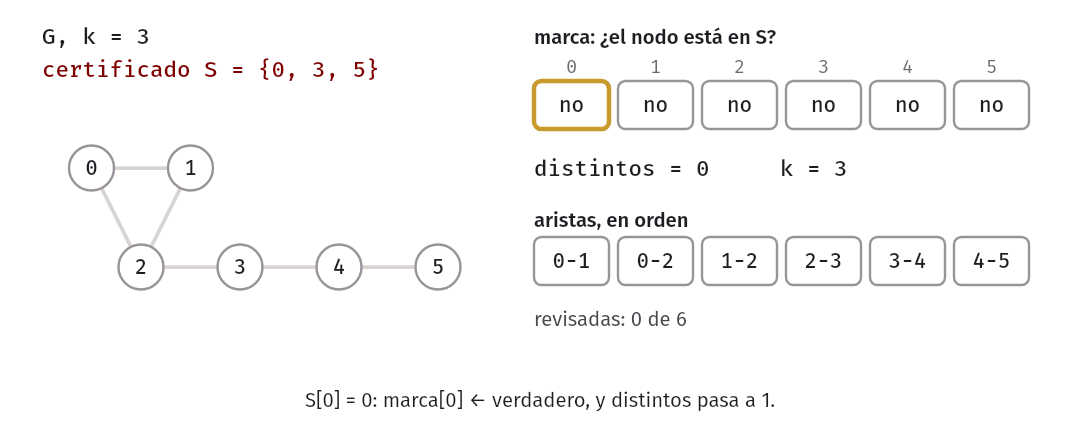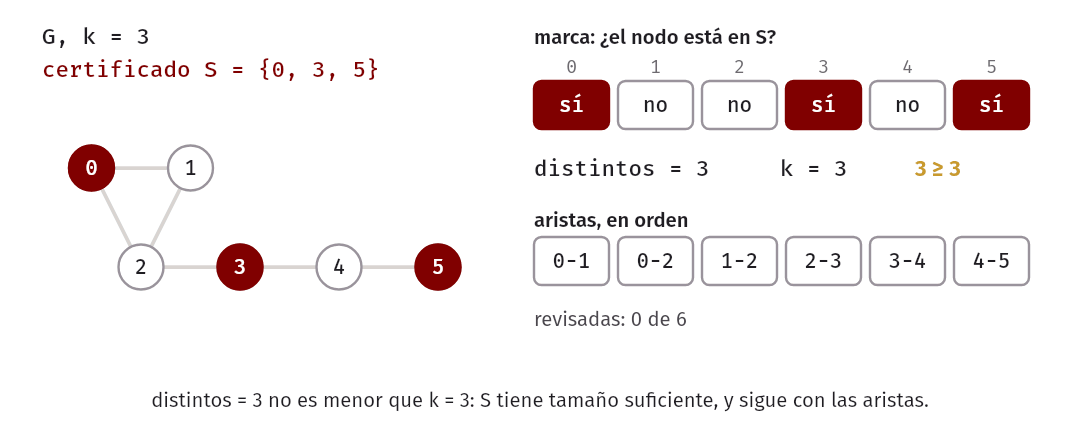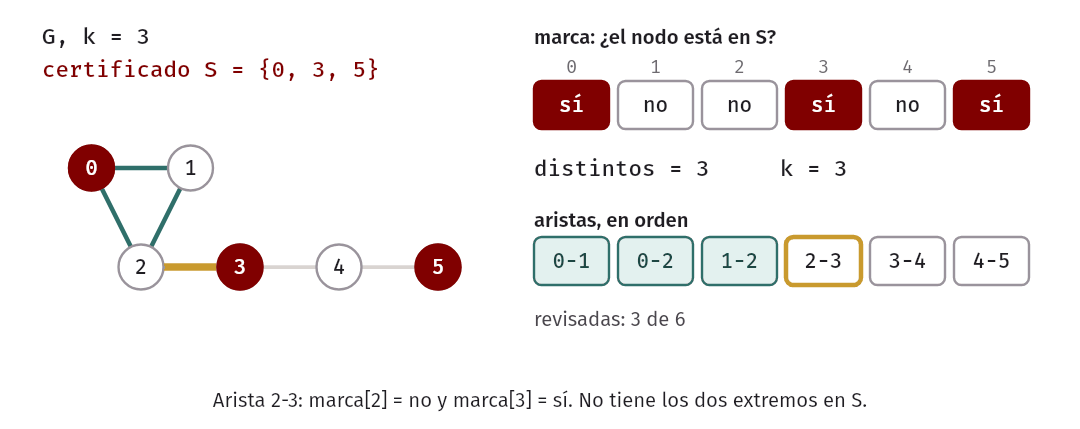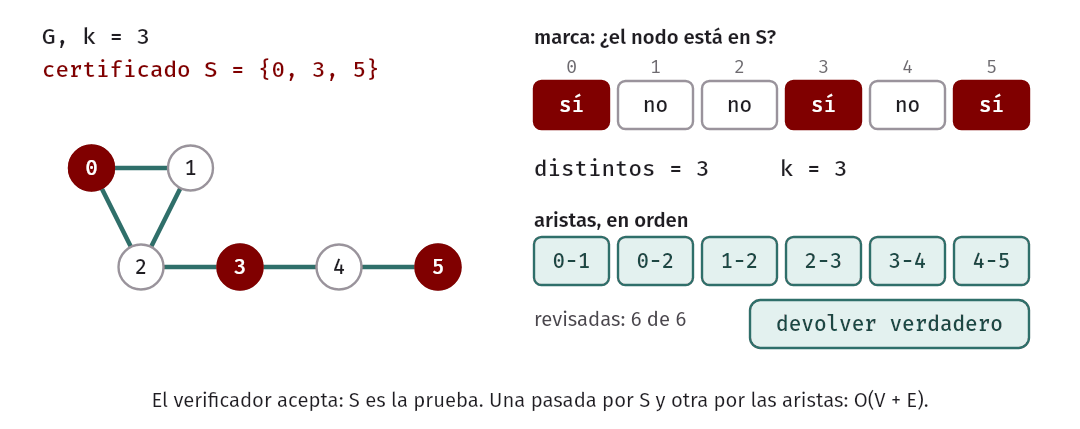
Otros certificados
| Problema | Certificado | Qué se verifica | Costo |
|---|---|---|---|
| Cobertura de vértices | La lista de nodos | A lo sumo k nodos, y cada arista toca a alguno | O(V + E) |
| Clique | La lista de nodos | Al menos k nodos, y todo par es vecino | O(V²) con una matriz |
| Coloreo con k colores | El color de cada nodo | Colores de 1 a k, y ninguna arista con dos iguales | O(V + E) |
| SAT | El valor de cada variable | Cada cláusula tiene un literal verdadero | Lineal en la fórmula |
| Ciclo hamiltoniano | El orden de los nodos | Cada nodo una vez, y cada par seguido es una arista | O(V) con una matriz |
| Mochila (decisión) | La lista de objetos | Suma de pesos ≤ W y suma de valores ≥ V | Polinomial en b |
| ¿N es compuesto? | Un divisor d | 1 < d < N, y d divide a N | Polinomial en b |
En la mochila, las sumas se hacen con números de muchos bits, y aun así cuestan algo polinomial en b. Fíjense en que aquí no aparece el problema de O(nW): verificar es sumar, no llenar una tabla.
Lo que no parece tener certificado
La definición es asimétrica: solo pide pruebas para el “sí”. ¿Qué certificado corto probaría que un grafo no tiene un conjunto independiente de tamaño k? Nadie conoce uno. Listar todos los subconjuntos no vale, porque no es corto. Y lo mismo pasa con “el conjunto independiente máximo tiene tamaño exactamente k”, que tiene una parte de “no hay ninguno más grande”. Eso no quiere decir que estos problemas no estén en NP. Quiere decir que no se sabe.
P ⊆ NP
Teorema. Todo problema de P está en NP.
Demostración directa. Sea A un problema de P, con un algoritmo polinomial. Definimos este verificador: ignora el certificado (puede ser vacío), corre el algoritmo con x y acepta si responde sí. Corre en tiempo polinomial. Si x es una instancia “sí”, acepta con cualquier certificado, y si es una instancia “no”, los rechaza a todos. Eso es exactamente lo que pide la definición. ∎
Qué significa la N
NP viene de nondeterministic polynomial: lo que se resuelve en tiempo polinomial en una máquina idealizada que puede “adivinar” el certificado. No vamos a usar esa máquina, porque la definición con verificador dice lo mismo. Lo que hay que retener es lo que no significa.
Error común. Leer NP como “no polinomial”. NP no es lo contrario de P. Todo lo que está en P también está en NP, así que “¿está ordenada esta lista?” está en NP, y también “¿hay un camino de s a t?”. Son frases ciertas, aunque suenen raras. Decir “ese problema es NP, así que no tiene algoritmo polinomial” está mal por dos motivos: estar en NP no dice nada de eso, y lo que se suele querer decir es “NP-completo”, que tampoco lo demuestra.
Todo problema de NP se puede resolver por fuerza bruta, porque se pueden probar todos los certificados: hay a lo sumo 2^(p(b)+1), y verificar cada uno es polinomial. Es exponencial, pero muestra que NP no contiene nada imposible de resolver en ese sentido. Por eso el error “NP-completo significa que no se puede resolver” está mal: se puede, el problema es hacerlo rápido.
P contra NP
La pregunta es esta: ¿P = NP? Dicho de otro modo, si una solución se puede comprobar rápido, ¿se puede también encontrar rápido?
Sabemos que P ⊆ NP. Nadie sabe si la inclusión es estricta. No hay demostración en ningún sentido, y es uno de los problemas abiertos más famosos de la matemática: el Instituto Clay ofrece un premio de un millón de dólares por resolverlo.
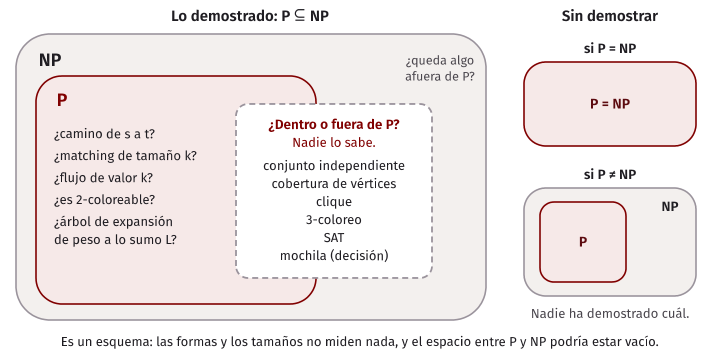
La mayoría de los investigadores cree que P ≠ NP. Es una creencia, no un resultado. Se apoya en que décadas de esfuerzo, sobre miles de problemas de muchas áreas, no han producido un algoritmo polinomial para ninguno de los más difíciles de NP, y en que la igualdad tendría consecuencias que parecen demasiado buenas: encontrar sería casi siempre tan fácil como revisar. Nada de eso es una prueba. Hasta que alguien la dé, cualquier frase de ese tipo sobre un problema NP-completo, “este problema no tiene algoritmo polinomial”, debe llevar el “si P ≠ NP” delante.
Error común. Decir “está demostrado que P ≠ NP” o “NP-completo significa que es imposible en tiempo polinomial”. Lo que está demostrado es otra cosa: si uno de esos problemas tuviera un algoritmo polinomial, todos los de NP lo tendrían.
Reducciones polinomiales
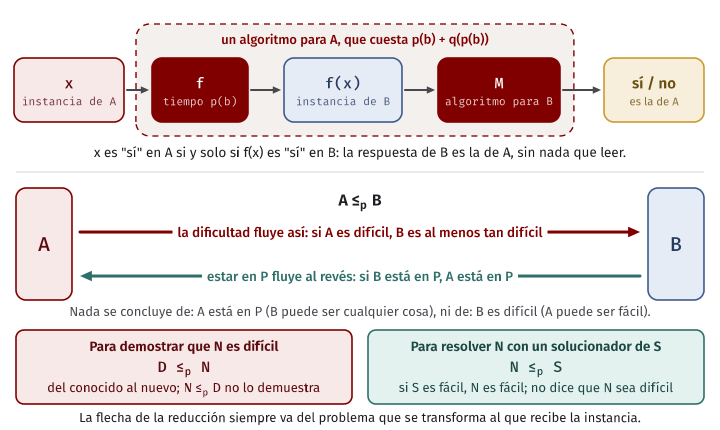
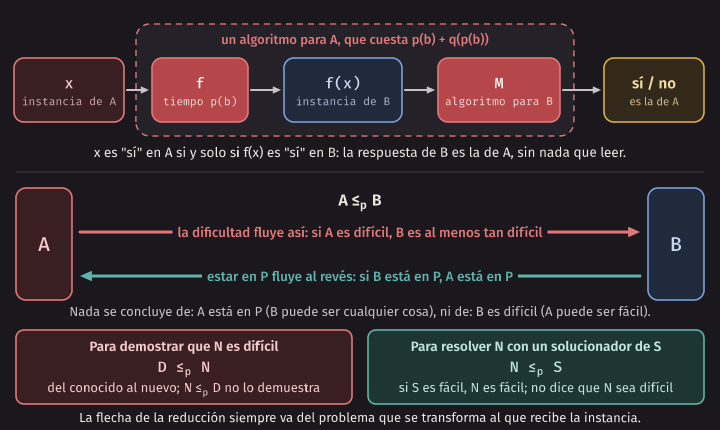
Definición. Una reducción polinomial (polynomial-time reduction) del problema de decisión A al problema de decisión B es una función f tal que:
- f se calcula en tiempo polinomial en el tamaño de x.
- Para toda instancia x de A: x es “sí” en A si y solo si f(x) es “sí” en B.
Se escribe A ≤ₚ B, y se lee “A se reduce a B”. También se la llama reducción de Karp.
El símbolo se lee bien si se piensa como “A es a lo sumo tan difícil como B”, salvo un costo polinomial. Quien sabe resolver B, sabe resolver A.
Compárenla con las reducciones de la semana pasada. Allá se resolvía A llamando a un algoritmo para B y leyendo la solución después, para un problema de optimización. Aquí todo es más estricto. La instancia se transforma una vez, y la respuesta de B es la respuesta de A, sin nada que leer. Pero la disciplina es la misma: se demuestran las dos direcciones.
Como f corre en tiempo polinomial, tampoco puede escribir una salida demasiado larga: si f tarda a lo sumo p(b) pasos, entonces |f(x)| ≤ p(b). Eso importa en la demostración que sigue.
El teorema central
Teorema 1. Si A ≤ₚ B y B está en P, entonces A está en P.
Demostración directa, componiendo algoritmos. Sea f la reducción, que corre en tiempo p(b) para una entrada de b bits. Sea M un algoritmo para B, que corre en tiempo q(m) para una entrada de m bits. Para resolver A en la instancia x, de b bits, se calcula f(x) y se corre M con f(x).
Es correcto: M responde sí exactamente cuando f(x) es “sí” en B, y eso pasa exactamente cuando x es “sí” en A, por la condición 2.
Es polinomial: calcular f(x) cuesta p(b) (tomamos p y q no decrecientes, por ejemplo con coeficientes no negativos), y el resultado mide a lo sumo p(b) bits, de modo que M cuesta a lo sumo q(p(b)). La suma p(b) + q(p(b)) es un polinomio en b, porque un polinomio de un polinomio es un polinomio. ∎
La segunda parte de la demostración es el motivo de medir la salida de f: si f escribiera algo exponencial, M tendría que leerlo todo.
Corolario, la contrarrecíproca. Si A ≤ₚ B y A no está en P, entonces B no está en P.
Eso es lo que hace útil todo esto. Si tienen un problema que creen difícil, y le reducen a él uno que se sabe difícil, el nuevo hereda la dificultad.
Teorema 2, transitividad. Si A ≤ₚ B y B ≤ₚ C, entonces A ≤ₚ C.
Demostración directa. Sean f y g las dos reducciones, y sea h(x) = g(f(x)). Para la correctitud, x es “sí” en A si y solo si f(x) es “sí” en B, y eso pasa si y solo si g(f(x)) es “sí” en C. Para el costo, f corre en p(b) y escribe a lo sumo p(b) bits, y g corre en q(p(b)) sobre eso: la suma es polinomial en b. ∎
Por esta transitividad, las reducciones forman una cadena: cada una que demostremos se puede pegar a las anteriores.
Lo que dice y lo que no dice
La segunda pregunta de repaso se contesta en una tabla. Si A ≤ₚ B:
| Si se sabe que… | Se concluye | ¿Por qué? |
|---|---|---|
| B está en P | A está en P | Teorema 1 |
| A no está en P | B no está en P | Contrarrecíproca |
| A es difícil | B es al menos tan difícil como A | Quien resuelva B, resuelve A |
| A está en P | Nada sobre B | B puede ser cualquier cosa |
| B es difícil | Nada sobre A | A puede ser fácil |
En la tercera fila, fíjense en lo que no se dice. No se dice que B esté en NP, ni que sea igual de difícil que A: B podría ser mucho más difícil. Para concluir que son equivalentes hace falta también B ≤ₚ A.
La dirección correcta
Este es el error de esta parte del curso, así que vale la pena pensarlo con un ejemplo. Supongan que quieren demostrar que un problema nuevo N es difícil, y conocen un problema difícil D.
- Bien: D ≤ₚ N. Se transforma el problema conocido en el nuevo. Si alguien resolviera N rápido, usaría f para resolver D rápido. Entonces N no es más fácil que D.
- Mal: N ≤ₚ D. Se transforma el nuevo en el conocido. Lo único que dice es que quien resuelva D resuelve N. N no es más difícil que D, y podría ser muy fácil.
Un ejemplo concreto de que la flecha al revés no prueba nada. El 2-coloreo se resuelve con un BFS. Pues bien, 2-coloreo ≤ₚ 3-coloreo.
La reducción. Dado G, se construye G′: se le agrega un nodo nuevo a, vecino de todos los demás.
Dirección 1: si G se colorea con 2 colores, G′ se colorea con 3. Se usan esos dos colores en G y el tercero en a. Las aristas de G están bien, y cada arista nueva tiene un extremo con el tercer color y el otro con uno de los dos primeros.
Dirección 2: si G′ se colorea con 3 colores, G se colorea con 2. Sea c el color de a. Como a es vecino de todos, ningún nodo de G tiene el color c, y entonces G usa solo los otros dos. ∎
La reducción es correcta, el 3-coloreo parece difícil, y nadie concluye de ahí que el 2-coloreo sea difícil, porque es
fácil. Lo comprueba reduction_demo, y las pruebas lo revisan en todos los grafos de hasta 5 nodos:
$ build/reduction_demo
...
2-coloreo a 3-coloreo: agregar un nodo vecino de todos.
  ciclo de 4: 2 colores con BFS: sí; 3 colores en el grafo con el nodo nuevo: sí
  ciclo de 5: 2 colores con BFS: no; 3 colores en el grafo con el nodo nuevo: no
Error común. Hacer la reducción al revés: del problema nuevo hacia uno conocido. Eso solo dice que el nuevo no es más difícil que el conocido. Para demostrar dificultad, la flecha va del conocido al nuevo. Una regla para acordarse: la dificultad fluye en el sentido de ≤ₚ, de izquierda a derecha.
Eso no quiere decir que la otra dirección sea inútil. Es justo lo que se hace para resolver. Las reducciones a flujo de la semana 12, y las de esta semana a SAT, van del problema que nos interesa hacia uno con buen solucionador. Es lo correcto para ese fin. Lo que no pueden hacer es demostrar que el problema es difícil. Codificar el sudoku en SAT, que es lo que hacemos en el laboratorio, no dice que el sudoku sea difícil.
| Quiero… | La flecha va… | Lo que concluyo |
|---|---|---|
| Resolver N con un solucionador de S | N ≤ₚ S | Si S es fácil, N es fácil |
| Demostrar que N es difícil, sabiendo que D lo es | D ≤ₚ N | N no es más fácil que D |
NP-difícil y NP-completo: un adelanto
Ya tienen todo para las dos palabras que se dicen más. La semana 14 las trabaja a fondo, y aquí solo las definimos, porque en las semanas 9 y 12 aparecieron sin explicación.
- Un problema X es NP-difícil (NP-hard) si todo problema de NP se reduce a X. Es decir, X es al menos tan difícil como cualquiera de NP.
- Un problema X es NP-completo (NP-complete) si es NP-difícil y además está en NP.
Por el teorema 1, si un solo problema NP-difícil estuviera en P, todo NP estaría en P, y entonces P = NP. Por eso se dice que todos los problemas NP-completos se sostienen o caen juntos.
Parece imposible demostrar que X es NP-difícil, porque habría que dar una reducción desde todos los problemas de NP. Basta dar una vez esa demostración, y el teorema de Cook-Levin la da para SAT. Después de eso se usa la transitividad: si SAT ≤ₚ X, todo problema de NP se reduce a X pasando por SAT. Ese es el programa de la semana 14.
Lo que vamos a usar sin demostrar todavía es el siguiente hecho, que la semana 14 prueba desde 3-SAT: el conjunto independiente es NP-completo. Con eso, las reducciones de esta semana dan que cobertura de vértices y clique también lo son. Eso es lo que prometió la semana 9, cuando mostró que en un árbol estos problemas se resuelven con programación dinámica y dijo que en un grafo general son difíciles. Un árbol es un caso especial, con una estructura que una recurrencia aprovecha. Un grafo general no se conoce que la tenga. El 3-dimensional matching que mencionó la semana 12 es otro de estos problemas.
En la práctica. Que un problema sea NP-completo no significa que no se pueda resolver. Significa que no hay que esperar un algoritmo polinomial correcto para todos los casos, si P ≠ NP. Las salidas reales son cuatro: una instancia pequeña se resuelve exactamente, como con Held-Karp; un caso especial puede ser fácil, como el árbol; se puede renunciar al óptimo, que es la semana 15; o se le pasa a un solucionador que suele funcionar bien, que es el final de esta semana.
Por qué la mochila no demuestra P = NP
Esta es la quinta pregunta de repaso: si la mochila se resuelve en O(nW), ¿por qué eso no demuestra P = NP?
La versión de decisión de la mochila es NP-completa. Aquí lo asumimos: la semana 14 demuestra que suma de subconjuntos es NP-completa, y ese problema es un caso especial de la mochila, con cada valor igual a su peso y con V = W, de modo que un algoritmo para la mochila resuelve suma de subconjuntos. Si O(nW) fuera polinomial, tendríamos un algoritmo polinomial para un problema NP-completo, y entonces P = NP.
Pero O(nW) no es polinomial en los bits de la entrada. Como W se escribe con log W bits, el costo es exponencial en esa parte de la entrada. Con n objetos y un W de 100 bits, la tabla puede tener cerca de 2¹⁰⁰ columnas, aunque la entrada se escriba en pocas líneas. No hay contradicción con nada: es un algoritmo pseudopolinomial, que sirve si W es pequeño, y que no dice nada sobre P contra NP.
Conjunto independiente y cobertura de vértices
Pasemos a las reducciones concretas. Todos los grafos de esta parte son no dirigidos y simples: sin lazos y sin aristas repetidas.
Una cobertura de vértices (vertex cover) es un conjunto de nodos que toca a toda arista: cada arista tiene al menos un extremo en el conjunto. Imaginen cámaras en las esquinas de un barrio, de modo que toda cuadra quede vista por alguna.
Los dos problemas de decisión son:
- Conjunto independiente. Dados G y k, ¿hay un conjunto independiente de tamaño al menos k?
- Cobertura de vértices. Dados G y k, ¿hay una cobertura de tamaño a lo sumo k?
En la semana 9 ya apareció el lema que sigue, en un árbol. Vale en cualquier grafo, y es la tercera pregunta de repaso.
Lema. Sea G = (V, E) un grafo, y sea S ⊆ V. S es un conjunto independiente si y solo si V − S es una cobertura de vértices.
Demostración directa, en las dos direcciones.
Si S es independiente, sea {u, v} una arista cualquiera. Los dos extremos no pueden estar en S, porque S es independiente. Entonces al menos uno está en V − S, y la arista queda cubierta. Como vale para toda arista, V − S es una cobertura.
Si V − S es una cobertura, sean u y v dos nodos de S. Ninguno está en V − S. Si {u, v} fuera una arista, quedaría sin cubrir, y eso contradice que V − S es una cobertura. Entonces no hay arista entre ellos, y S es independiente. ∎
La reducción
Teorema. Conjunto independiente ≤ₚ cobertura de vértices, con f(G, k) = (G, n − k), donde n = |V|.
Tiempo. f copia el grafo y resta dos números: tiempo lineal.
Dirección 1: de “sí” a “sí”. Si G tiene un conjunto independiente S con |S| ≥ k, por el lema V − S es una cobertura, y |V − S| = n − |S| ≤ n − k.
Dirección 2: de “sí” a “sí”, al revés. Si G tiene una cobertura C con |C| ≤ n − k, por el lema V − C es independiente, y |V − C| = n − |C| ≥ k. ∎
Esta reducción funciona igual en el otro sentido: cobertura de vértices ≤ₚ conjunto independiente, con f(G, k) = (G, n − k), y la misma demostración. Los dos problemas son equivalentes. Además se tiene la fórmula de la semana 9:
cobertura mínima = n − conjunto independiente máximo.
Hay un borde que conviene ver. Si k > n, no hay ningún conjunto independiente de ese tamaño, y n − k es negativo, de modo que tampoco hay ninguna cobertura de ese tamaño. Coinciden, como debe ser. Las pruebas lo comprueban con k fuera de rango.
Corriendo la reducción
reduction_demo toma un grafo de 6 nodos y compara las dos respuestas, cada una con su fuerza bruta. CI es conjunto
independiente, y CV es cobertura de vértices:
$ build/reduction_demo
G tiene 6 nodos y estas aristas: 0-1 0-2 1-2 2-3 3-4 4-5
conjunto independiente máximo: {0, 3, 5}, tamaño 3
cobertura mínima:              {0, 2, 4}, tamaño 3
V − S = {1, 2, 4}, ¿es cobertura? sí

Conjunto independiente a cobertura, con k → n − k:
  k  CI(G, k)  CV(G, n − k)
  0  sí        sí
  1  sí        sí
  2  sí        sí
  3  sí        sí
  4  no        no
  5  no        no
  6  no        no
  7  no        no
...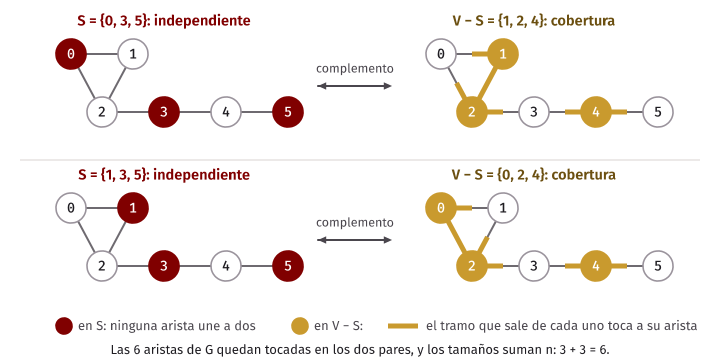
Fíjense en un detalle: el complemento de {0, 3, 5} es {1, 2, 4}, y la fuerza bruta devolvió otra cobertura mínima, {0,
2, 4}, cuyo complemento {1, 3, 5} es otro conjunto independiente máximo. El lema no dice que haya uno solo. Dice que van
en pares. test_examples revisa el lema para cada subconjunto, en todos los grafos de hasta 5 nodos. Revisa las
reducciones en esos mismos grafos, y en 300 grafos al azar de 6 a 8 nodos.
Idea clave. Como dijo la semana 9, el lema no hace fácil ninguno de los dos problemas. Solo los traduce uno al otro. Una reducción no resuelve nada por sí sola. Dice que los dos problemas tienen el mismo destino.
Conjunto independiente y clique
Un clique es un conjunto de nodos donde todo par es vecino. Es lo contrario de un conjunto independiente, donde ningún par lo es. Esa frase sugiere el camino.
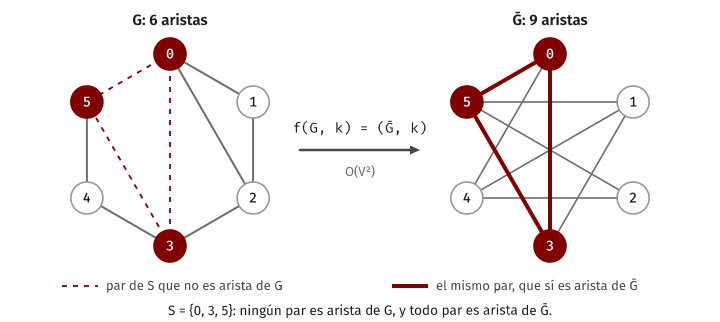
El grafo complementario de G = (V, E), que escribimos Ḡ, tiene los mismos nodos, y un par {u, v} es arista de Ḡ exactamente cuando no es arista de G.
Lema. S es un conjunto independiente de G si y solo si S es un clique de Ḡ.
Demostración directa. Tomen cualquier par de nodos distintos u, v de S. Por la definición de Ḡ, {u, v} no es arista de G si y solo si es arista de Ḡ. “Ningún par de S es arista de G” dice entonces exactamente lo mismo que “todo par de S es arista de Ḡ”. ∎
Esa única frase contiene las dos direcciones, porque cada paso es un “si y solo si”.
Teorema. Conjunto independiente ≤ₚ clique, con f(G, k) = (Ḡ, k).
Tiempo. Construir Ḡ recorre todos los pares de nodos: O(V²) comprobaciones, cada una O(1) con una matriz de adyacencia. Eso es polinomial. Fíjense en que el resultado puede ser más largo que la entrada: un grafo con pocas aristas tiene un complemento con muchas.
Correctitud. G tiene un conjunto independiente de tamaño al menos k si y solo si Ḡ tiene un clique de tamaño al menos k, por el lema. ∎
El complemento del complemento es G, así que también vale clique ≤ₚ conjunto independiente, con la misma f.
$ build/reduction_demo
...
El complemento tiene estas aristas: 0-3 0-4 0-5 1-3 1-4 1-5 2-4 2-5 3-5
clique máximo del complemento: {0, 3, 5}, tamaño 3
  k  CI(G, k)  clique(complemento, k)
  0  sí        sí
  1  sí        sí
  2  sí        sí
  3  sí        sí
  4  no        no
  5  no        no
  6  no        no
  7  no        no
...
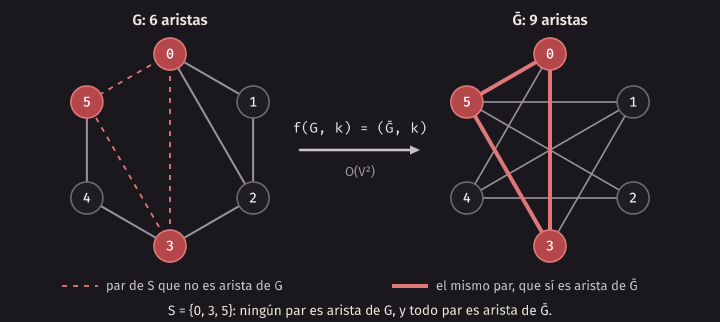
Y por transitividad, cobertura de vértices ≤ₚ clique: se pega una con la otra. Primero (G, k) pasa a (G, n − k), y luego a (Ḡ, n − k). La cadena ya se escribe sola, y así queda el código:
inline Instance independent_set_to_vertex_cover(const Instance& in) { return {in.graph, in.graph.n - in.k}; }
inline Instance independent_set_to_clique(const Instance& in) { return {complement(in.graph), in.k}; }
inline Instance vertex_cover_to_clique(const Instance& in) {
    return independent_set_to_clique(independent_set_to_vertex_cover(in));
}
Tres problemas, dos reducciones cortas, y el mismo destino para los tres. Conociendo que el conjunto independiente es NP-completo, lo que demuestra la próxima semana, y sabiendo que los tres están en NP por la tabla de certificados, los tres resultan NP-completos.
Paso a paso: de cobertura a clique
Sigamos una instancia por toda la cadena, con el grafo G de 6 nodos. La pregunta es si tiene una cobertura de tamaño a lo sumo 3. La reducción compuesta la convierte en una pregunta sobre el complemento:
| Paso | Instancia | Una solución | Qué se comprueba |
|---|---|---|---|
| Cobertura de vértices | (G, 3) | {0, 2, 4} | Las aristas 0-1, 0-2, 1-2, 2-3, 3-4 y 4-5 tocan a alguno de los tres |
| Conjunto independiente | (G, 6 − 3) = (G, 3) | {1, 3, 5} | Es el complemento de la anterior, y ninguna arista de G une a dos de ellos |
| Clique | (Ḡ, 3) | {1, 3, 5} | 1-3, 1-5 y 3-5 son aristas de Ḡ |
Es una coincidencia que aquí los dos k valgan 3, porque n es 6. Con k = 2, la cobertura pasa a tener una pregunta sobre un clique de tamaño 4, y entonces las dos respuestas son “no”: el grafo no tiene una cobertura de tamaño 2, porque el triángulo 0-1-2 ya necesita 2 nodos y la arista 4-5 necesita otro. El complemento tampoco tiene un clique de tamaño 4.
El patrón de una reducción
Todas las reducciones de estas dos semanas tienen la misma forma. Para demostrar A ≤ₚ B:
- Escribir f. Dada una instancia x de A, describir la instancia f(x) de B. f tiene que correr en tiempo polinomial, así que no puede apoyarse en una respuesta que no sabe calcular en ese tiempo. Si A está en P, f sí puede resolverla (ejercicio 2), aunque esa reducción no enseña nada.
- Comprobar el tiempo. Calcular cuánto tarda f, en función del tamaño de x. Debe ser polinomial.
- Si x es “sí”, f(x) es “sí”. Dada una solución de x, construir una solución de f(x).
- Si f(x) es “sí”, x es “sí”. Dada una solución de f(x), construir una solución de x.
El paso 4 se puede escribir también al revés: si x es “no”, f(x) es “no”. Es lo mismo, porque es la contrarrecíproca. Lo que no se puede hacer es probar el paso 3 dos veces. El paso 4 siempre parte de una solución cualquiera de f(x), que puede ser más rara que las que produce el paso 3.
Hay que distinguir dos cosas que se llaman igual. La dirección de la reducción, A ≤ₚ B, dice qué problema se transforma en cuál. Las dos direcciones de la demostración son los pasos 3 y 4, y las dos son obligatorias, en cualquier sentido que vaya la reducción.
Una reducción que falla
Veamos qué pasa si se copia sin cuidado. Alguien piensa: “cobertura y conjunto independiente son complementarios, así que f(G, k) = (G, k) debe servir”. El programa busca el contraejemplo más pequeño:
$ build/reduction_demo
...
Una reducción mal hecha: conservar k, sin cambiarlo por n − k.
  el contraejemplo más chico: 2 nodos, aristas: 0-1
  k = 2: CI dice no, CV dice sí
...
Una sola arista con k = 2. No hay dos nodos independientes, porque son vecinos, y en cambio los dos nodos son una cobertura de tamaño 2. Una respuesta distinta en una sola instancia basta para que f no sea una reducción. Y la misma idea sirve para revisar sus reducciones: pruébenlas con fuerza bruta, en todos los grafos pequeños, antes de confiar en la demostración.
Error común. Que f “resuelva” antes de transformar. Una f que prueba todos los subconjuntos y luego escribe una instancia trivial de B, con la respuesta correcta, cumple el “si y solo si”. Pero no es una reducción, porque no corre en tiempo polinomial. Lo que descalifica a esa f es su tiempo, no que conozca la respuesta.
SAT y CNF
SAT es el problema central de la teoría, y resulta ser también muy útil en la práctica. Vamos con las definiciones.
- Una variable booleana vale verdadero o falso.
- Un literal es una variable x o su negación ¬x.
- Una cláusula es un “o” de literales: x₁ ∨ ¬x₂ ∨ x₃. Se cumple si al menos uno de sus literales es verdadero.
- Una fórmula está en forma normal conjuntiva, o CNF (conjunctive normal form), si es un “y” de cláusulas.
- Un modelo de una fórmula es una asignación de valores que la hace verdadera.
SAT: dada una fórmula, ¿tiene un modelo? Si lo tiene, decimos que es satisfacible.
Por ejemplo, (x₁ ∨ x₂) ∧ (¬x₁ ∨ x₃) ∧ (¬x₁ ∨ ¬x₃) ∧ (¬x₂ ∨ x₄) es satisfacible. Si x₁ es verdadera, las cláusulas segunda y tercera piden x₃ y ¬x₃, lo cual es imposible. Así que x₁ es falsa, y entonces x₂ y luego x₄ son verdaderas. x₃ queda libre.
SAT está en NP: el certificado es el modelo, y verificarlo es revisar cada cláusula una vez. Eso es lo que hace
satisfies en cnf.h, en unas pocas líneas.
Podemos trabajar solo con CNF, sin perder nada. Una fórmula booleana cualquiera se puede convertir en CNF de tamaño polinomial, agregando variables nuevas. La fórmula resultante no es igual a la original, pero es satisfacible exactamente cuando la original lo es. Esa técnica se llama transformación de Tseitin, y no la necesitamos en detalle. Lo que no conviene hacer es aplicar la distributividad directamente, porque la fórmula puede crecer de forma exponencial.
Por fuerza bruta, hay 2ⁿ asignaciones para n variables. Nadie conoce un algoritmo polinomial para SAT, y el teorema de Cook-Levin, que la próxima semana se enuncia, dice que SAT es NP-completo.
Un solucionador SAT por dentro
Un solucionador SAT (SAT solver) es un programa que recibe una fórmula en CNF y responde con un modelo, o dice que no hay ninguno. La idea básica es de 1960 y 1962: se llama DPLL, por sus autores Davis, Putnam, Logemann y Loveland. Es backtracking con una observación:
- Propagación unitaria. Si una cláusula tiene todos sus literales falsos salvo uno, sin asignar, ese literal tiene que ser verdadero. No hay nada que decidir.
algoritmo dpll(formula, valores)
    mientras haya una cláusula con todos sus literales falsos, salvo uno sin asignar, hacer
        hacer verdadero ese literal en valores
    fin mientras
    si alguna cláusula tiene todos sus literales falsos entonces
        devolver falso
    fin si
    si todas las variables tienen valor entonces
        devolver verdadero
    fin si
    x ← una variable sin asignar
    si dpll(formula, valores con x verdadera) entonces
        devolver verdadero
    fin si
    devolver dpll(formula, valores con x falsa)
fin algoritmo
Es correcto porque la propagación solo asigna lo que es obligatorio, y porque el final prueba los dos valores posibles de x. Si responde falso, no hay modelo con los valores que traía. En el peor caso es exponencial, como todo lo que conocemos para SAT.
Sigámoslo con la fórmula de arriba. Las variables se escriben con su número, y un signo menos es la negación, igual que en el código:
$ build/cnf_demo
...
DPLL con (1 ∨ 2) ∧ (¬1 ∨ 3) ∧ (¬1 ∨ ¬3) ∧ (¬2 ∨ 4):
decisión: 1
  unitaria: 3
  conflicto
decisión: -1
  unitaria: 2
  unitaria: 4
  decisión: 3
satisfacible: -1 2 3 4| Paso | Qué pasa | Por qué |
|---|---|---|
| decisión 1 | x₁ verdadera | Ninguna cláusula obliga, y se prueba |
| unitaria 3 | x₃ verdadera | ¬1 ya es falso en (¬1 ∨ 3) |
| conflicto | (¬1 ∨ ¬3) es falsa | Los dos literales son falsos: hay que volver |
| decisión −1 | x₁ falsa | Era la otra opción |
| unitaria 2 | x₂ verdadera | 1 es falso en (1 ∨ 2) |
| unitaria 4 | x₄ verdadera | ¬2 es falso en (¬2 ∨ 4) |
| decisión 3 | x₃ verdadera | Ninguna cláusula la obliga, y queda el modelo |
Por qué sirve aunque SAT sea difícil
Los solucionadores de hoy, como minisat, agregan a esa base unas ideas que cambiaron todo. La principal es el
aprendizaje de cláusulas: cuando hay un conflicto, se analiza por qué, se escribe una cláusula nueva que resume esa
causa, y se la agrega a la fórmula, así que, mientras esa cláusula se conserve, ese mismo error no se repite. minisat borra periódicamente parte de las aprendidas. Además, al volver,
puede saltarse varios niveles de decisiones de una vez, y elige la siguiente variable según cuáles han intervenido en
conflictos recientes. Este conjunto de técnicas se conoce como CDCL (conflict-driven clause learning).
Nada de eso cambia el peor caso. Lo que pasa es que las fórmulas que salen de problemas reales suelen tener estructura que estas técnicas aprovechan, sin que se sepa bien explicar por qué en general.
Y hay fórmulas pequeñas y muy duras. Un ejemplo clásico es el principio del palomar: n + 1 palomas en n huecos. No hay solución, y un humano lo ve al instante. Para un solucionador basado en estas técnicas, es otra historia. Se sabe, desde un resultado de Haken de 1985, que toda refutación de esa fórmula por resolución, que es el razonamiento en el que se basan estas técnicas, tiene tamaño exponencial en n:
$ build/sat_bench
huecos  variables  cláusulas  respuesta  conflictos  CPU (s)
     5         30         81      UNSAT         251 0.000532
     6         42        133      UNSAT        1206 0.003166
     7         56        204      UNSAT       10495  0.05256
     8         72        297      UNSAT       76178 0.459086
     9         90        415      UNSAT      551941  4.24575
    10  se acabó el límite de 20 s de CPU
El tiempo es el que informa minisat, con un límite de 20 segundos de CPU por fórmula, medido en el contenedor del
curso con make bench, en una máquina compartida. Depende de esa máquina. Lo que muestra la tabla se limita a esto: de
5 a 9 huecos, los conflictos se multiplican por entre 4,8 y 8,7 a cada paso, y con 10 huecos, una fórmula de 110
variables, no terminó en ese límite. En cambio, en el laboratorio van a ver una fórmula de 15625 variables, de un sudoku
de 25 por 25, que en este mismo contenedor se resuelve en menos de un segundo.
Conclusión: el tamaño de la fórmula no dice cuánto va a tardar. SAT sigue siendo difícil en el peor caso, y un solucionador es una herramienta práctica sin ninguna garantía. Por eso conviene probarlo con su problema, antes de confiar o desconfiar.
En la práctica. Los solucionadores SAT se usan en la verificación de hardware y de software, y en planificación, entre otras áreas. El motivo es económico: alguien ya escribió y afinó el solucionador. A ustedes les toca el trabajo de modelar, igual que con el flujo, y el programa que busca no cambia de un problema a otro.
Codificar un problema en CNF
El método es siempre el mismo:
- Escoger las variables, de modo que cada una signifique algo: “el nodo v tiene el color c”.
- Escribir una o varias cláusulas por cada regla del problema.
- Demostrar que los modelos de la fórmula corresponden a las soluciones.
- Pasar la fórmula por el solucionador y leer la respuesta.
Es una reducción como las de la semana 12, con las tres piezas de siempre: transformación, lectura y demostración. Va en el sentido que sirve para resolver: de nuestro problema hacia SAT.
Casi todas las reglas se arman con tres piezas. Sobre una lista de variables x₁, …, xₘ:
| Regla | Cláusulas | Cuántas |
|---|---|---|
| Al menos uno | x₁ ∨ x₂ ∨ … ∨ xₘ | 1 |
| A lo sumo uno | ¬xᵢ ∨ ¬xⱼ, para cada par i < j | m(m − 1)/2 |
| Exactamente uno | Las dos anteriores | 1 + m(m − 1)/2 |
¿Por qué funciona “a lo sumo uno”? Una cláusula ¬xᵢ ∨ ¬xⱼ prohíbe que xᵢ y xⱼ sean verdaderas a la vez. Si se prohíbe para cada par, no puede haber dos verdaderas. Hay otras formas de escribirla, con variables auxiliares y menos cláusulas, pero esta es la más simple y es la que usamos en el curso.
Exactamente uno de tres
Esta es la cuarta pregunta de repaso. “Exactamente uno de x, y, z es verdadero” se escribe con cuatro cláusulas:
(x ∨ y ∨ z) ∧ (¬x ∨ ¬y) ∧ (¬x ∨ ¬z) ∧ (¬y ∨ ¬z)
El programa imprime la fórmula en DIMACS y la tabla de verdad completa, que además revisan las pruebas:
$ build/cnf_demo
Exactamente uno de x, y, z. Las variables son 1, 2 y 3:
p cnf 3 4
1 2 3 0
-1 -2 0
-1 -3 0
-2 -3 0

x y z  fórmula  verdaderas
0 0 0  0        0
0 0 1  1        1
0 1 0  1        1
0 1 1  0        2
1 0 0  1        1
1 0 1  0        2
1 1 0  0        2
1 1 1  0        3
...
La fórmula vale 1 exactamente en las tres filas con una sola variable verdadera.
El formato DIMACS y minisat
DIMACS es el formato de texto que entienden casi todos los solucionadores:
- Las líneas que empiezan con
cson comentarios. - El encabezado es
p cnf V C: V variables y C cláusulas. - Cada cláusula es una lista de enteros que termina en
0. El entero 3 es x₃, y −3 es ¬x₃. Por eso las variables se numeran desde 1: el 0 ya tiene otro significado.
El archivo ejemplos/formula.cnf es nuestra fórmula de cuatro cláusulas:
c (x1 o x2) y (no x1 o x3) y (no x1 o no x3) y (no x2 o x4)
p cnf 4 4
1 2 0
-1 3 0
-1 -3 0
-2 4 0
Corramos minisat. Recibe el archivo de la fórmula y el nombre del archivo donde debe escribir la respuesta:
$ minisat ejemplos/formula.cnf build/formula.res
============================[ Problem Statistics ]=============================
|                                                                             |
|  Number of variables:             4                                         |
|  Number of clauses:               4                                         |
|  Parse time:                   0.00 s                                       |
|  Eliminated clauses:           0.00 Mb                                      |
|  Simplification time:          0.00 s                                       |
|                                                                             |
============================[ Search Statistics ]==============================
| Conflicts |          ORIGINAL         |          LEARNT          | Progress |
|           |    Vars  Clauses Literals |    Limit  Clauses Lit/Cl |          |
===============================================================================
===============================================================================
restarts              : 1
conflicts             : 0              (nan /sec)
decisions             : 1              (0.00 % random) (inf /sec)
propagations          : 3              (inf /sec)
conflict literals     : 0              ( nan % deleted)
Memory used           : 10.00 MB
CPU time              : 0 s

SATISFIABLE
$ echo $?
10
$ cat build/formula.res
SAT
-1 2 -3 4 0
Hay tres cosas que aprender de esa salida:
- El código de salida da la respuesta: 10 si es satisfacible, y 20 si no lo es. Por eso
makepiensa que falló, si lo llaman desde un Makefile sin más cuidado. - El modelo va en el archivo de respuesta, no en la terminal. La primera línea es
SAT, y la segunda tiene un literal por variable, y termina en 0. - Este modelo no es el mismo que encontró nuestro DPLL, que tenía x₃ verdadera. Los dos son correctos: x₃ estaba libre. Un solucionador devuelve un modelo, y no promete cuál.
Sin solución, el archivo solo dice UNSAT. La opción -verb=0 calla la mayor parte de la terminal:
$ minisat -verb=0 ejemplos/unsat.cnf build/unsat.res
UNSATISFIABLE
$ echo $?
20
$ cat build/unsat.res
UNSAT
Y dos trampas de formato. Si el encabezado no coincide con lo que hay en el archivo, minisat solo avisa, y sigue.
Además, una variable cuyo número es mayor que todos los que aparecen en las cláusulas tampoco aparece en la respuesta. Si su número es menor, sí sale, con un valor que no significa nada:
$ cat ejemplos/bad_header.cnf
c el encabezado miente: dice 5 variables y 9 cláusulas
p cnf 5 9
1 -2 0
$ minisat -verb=0 ejemplos/bad_header.cnf build/bad.res
WARNING! DIMACS header mismatch: wrong number of variables.
WARNING! DIMACS header mismatch: wrong number of clauses.
SATISFIABLE
$ cat build/bad.res
SAT
1 -2 0
Las variables 3, 4 y 5 no están en la respuesta. Un programa que lee esa línea debe leer hasta el 0, y tratar las que falten como falsas.
En C++. Para llamar a
minisatdesde un programa se escribe la fórmula en un archivo y se usastd::system. Lo que devuelve no es el código de salida directamente: hay que extraerlo conWEXITSTATUS, de<sys/wait.h>, que es de POSIX y no del estándar de C++. Lo mismo vale paramkdtemp, que crea una carpeta temporal con un nombre único, de modo que dos programas que corren a la vez no se pisen. Todo eso está enminisat.h.
Ejemplo: el coloreo de grafos
Una facultad debe programar los exámenes finales. Cada curso es un nodo, y dos cursos con algún alumno en común están unidos por una arista, porque no pueden tomar su examen a la misma hora. Si hay c turnos, la pregunta es si el grafo se colorea con c colores.
Variables. Una variable por cada par (nodo, color). x(v, a) significa “el nodo v tiene el color a”. Son V · c variables. En DIMACS, con todo numerado desde 0, la variable de (v, a) es v · c + a + 1.
Reglas.
- Cada nodo tiene al menos un color: x(v, 0) ∨ x(v, 1) ∨ … ∨ x(v, c − 1), para cada nodo v.
- Dos vecinos no comparten color: ¬x(u, a) ∨ ¬x(v, a), para cada arista {u, v} y cada color a.
- Cada nodo tiene a lo sumo un color: ¬x(v, a) ∨ ¬x(v, b), para cada nodo v y cada par a < b.
Cuántas cláusulas. V + E · c + V · c(c − 1)/2. Eso es polinomial, y la fórmula se escribe en tiempo proporcional a su tamaño.
algoritmo codificar_coloreo(G, c)
    para v desde 0 hasta V - 1 hacer
        agregar la cláusula x(v, 0) ∨ ... ∨ x(v, c - 1)
        para a desde 0 hasta c - 1 hacer
            para b desde a + 1 hasta c - 1 hacer
                agregar la cláusula ¬x(v, a) ∨ ¬x(v, b)
            fin para
        fin para
    fin para
    para i desde 0 hasta E - 1 hacer
        (u, v) ← aristas[i]
        para a desde 0 hasta c - 1 hacer
            agregar la cláusula ¬x(u, a) ∨ ¬x(v, a)
        fin para
    fin para
fin algoritmo
Teorema. G se puede colorear con c colores si y solo si esta fórmula es satisfacible. Además, de un modelo se lee un coloreo propio.
Demostración directa, en las dos direcciones.
Dirección 1: de un coloreo a un modelo. Sea col un coloreo propio. Hagan x(v, a) verdadera exactamente cuando col(v) = a. Cada nodo tiene exactamente un color, así que se cumplen las cláusulas de “al menos uno” y “a lo sumo uno”. Si {u, v} es una arista, col(u) ≠ col(v), de modo que x(u, a) y x(v, a) no pueden ser verdaderas a la vez, y se cumple su cláusula.
Dirección 2: de un modelo a un coloreo. Sea un modelo. Por “al menos uno” y “a lo sumo uno”, cada nodo tiene exactamente un a con x(v, a) verdadera. Definan col(v) = a. Si {u, v} es una arista y col(u) = col(v) = a, entonces x(u, a) y x(v, a) son verdaderas, y eso viola la cláusula de esa arista y ese color. Entonces col es propio. ∎
En C++ queda igual que la definición. add_at_least_one y add_at_most_one están en cnf.h, y escriben las cláusulas
de la tabla:
inline int color_variable(int node, int color, int colors) { return node * colors + color + 1; }

inline Cnf encode_coloring(const Graph& g, int colors, bool at_most_one) {
    Cnf formula;
    formula.variables = g.n * colors;
    std::vector<int> vars(colors);
    for (int v = 0; v < g.n; v++) {
        for (int c = 0; c < colors; c++) vars[c] = color_variable(v, c, colors);
        add_at_least_one(formula, vars);
        if (at_most_one) add_at_most_one(formula, vars);
    }
    for (auto [u, v] : g.edges) {
        for (int c = 0; c < colors; c++) formula.add({-color_variable(u, c, colors), -color_variable(v, c, colors)});
    }
    return formula;
}
El parámetro at_most_one está por un motivo que veremos enseguida. La salida es real, y los grafos son pequeños a
propósito, para que pueda seguirse a mano:
$ build/coloring_demo
El triángulo con 3 colores. Variable v · 3 + c + 1 para el nodo v y el color c:
p cnf 9 21
1 2 3 0
-1 -2 0
-1 -3 0
-2 -3 0
4 5 6 0
-4 -5 0
-4 -6 0
-5 -6 0
7 8 9 0
-7 -8 0
-7 -9 0
-8 -9 0
-1 -4 0
-2 -5 0
-3 -6 0
-4 -7 0
-5 -8 0
-6 -9 0
-1 -7 0
-2 -8 0
-3 -9 0

minisat terminó con el código 10. El archivo de respuesta dice:
SAT
-1 -2 3 4 -5 -6 -7 8 -9 0

Con 2 colores, minisat terminó con el código 20. El archivo dice:
UNSAT
...
Leamos ese modelo. Las variables verdaderas son 3, 4 y 8.
| Variable | Fórmula v · 3 + c + 1 | Nodo | Color |
|---|---|---|---|
| 3 | 0 · 3 + 2 + 1 | 0 | 2 |
| 4 | 1 · 3 + 0 + 1 | 1 | 0 |
| 8 | 2 · 3 + 1 + 1 | 2 | 1 |
Tres colores distintos para los tres nodos: era la única forma. Y son 21 cláusulas: V + E · c + V · c(c − 1)/2 = 3 + 9 + 9.
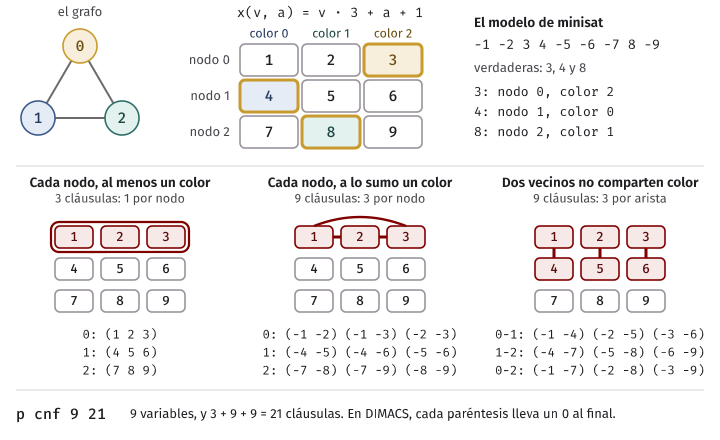
La misma salida sigue con grafos conocidos, que permiten comprobar la respuesta a mano. Un ciclo de longitud impar no se colorea con 2 colores. K4, con 4 nodos todos vecinos, necesita 4. El grafo de Petersen, de 10 nodos y 15 aristas, necesita 3:
ciclo de 5 con 2 colores: 10 variables, 20 cláusulas, código 20: no se puede
ciclo de 5 con 3 colores: 15 variables, 35 cláusulas, código 10: 1 2 1 0 2 (propio)
K4 con 3 colores: 12 variables, 34 cláusulas, código 20: no se puede
K4 con 4 colores: 16 variables, 52 cláusulas, código 10: 2 3 0 1 (propio)
Petersen con 2 colores: 20 variables, 50 cláusulas, código 20: no se puede
Petersen con 3 colores: 30 variables, 85 cláusulas, código 10: 1 0 2 1 0 2 1 1 0 2 (propio)
Las pruebas comparan con la fuerza bruta en 150 grafos al azar, de 1 a 7 nodos y con 1 a 3 colores, y revisan cada
respuesta con is_proper_coloring.
Al menos uno y a lo sumo uno
El error clásico al codificar es escribir “al menos uno” y olvidar “a lo sumo uno”. Pero no siempre es un bug. La respuesta depende del problema, y conviene distinguir tres casos con cuidado. Los tres se comprueban aquí.
Primer caso: no hace daño, en el coloreo
Quiten “a lo sumo un color por nodo” de la fórmula del coloreo. Un modelo puede dar ahora dos colores al mismo nodo. Aun así, el coloreo que se lee es correcto.
Afirmación. Sin esa regla, la fórmula sigue siendo satisfacible exactamente cuando el grafo se colorea con c colores, y escoger cualquier color verdadero de cada nodo da un coloreo propio.
Demostración directa. Sea un modelo de la fórmula sin la regla. Cada nodo tiene al menos un color verdadero. Escojan uno cualquiera por nodo. Si {u, v} es una arista y les tocó el mismo color a, entonces x(u, a) y x(v, a) son verdaderas, y eso viola la cláusula de esa arista. Entonces la elección es un coloreo propio. En el otro sentido, un coloreo propio da un modelo, igual que antes, porque hay menos cláusulas que cumplir. ∎
Un nodo con varios colores verdaderos solo tiene más opciones de las que necesita.
$ build/coloring_demo
...
Sin "a lo sumo un color por nodo":
Petersen con 3 colores: 30 variables, 55 cláusulas, código 10: 2 1 2 1 0 1 0 0 2 2 (propio)
Una arista con 3 colores tiene 6 modelos con la regla y 12 sin ella.
Un modelo con dos colores en un nodo: nodo 0 = { 1 2 } nodo 1 = { 0 }
De 12 modelos sin la regla, en 12 cualquier elección da un coloreo propio.
Son 30 cláusulas menos para Petersen, y la respuesta sigue siendo correcta. Las pruebas revisan todos los modelos, en todos los grafos de hasta 4 nodos con hasta 3 colores.
Segundo caso: ya está implícita, por el principio del palomar
Ahora, un cuadrado latino de lado n: una tabla de n por n, donde cada fila y cada columna tiene cada símbolo una sola vez. Es un sudoku sin cajas, y lo usamos como ejemplo porque su fórmula es más corta. Una variable por cada (fila, columna, símbolo).
Supongan que escriben “cada celda tiene al menos un símbolo” y “cada símbolo sale a lo sumo una vez en cada fila”, y que olvidan “cada celda tiene a lo sumo un símbolo”. Esa regla olvidada ya está implicada por las otras dos.
Afirmación. En cualquier modelo de esas dos reglas, cada celda tiene exactamente un símbolo verdadero.
Demostración, por conteo (principio del palomar). Fijen una fila, y cuenten las variables verdaderas de esa fila. Como hay n celdas y cada una tiene al menos un símbolo, son al menos n. Como hay n símbolos y cada uno sale a lo sumo una vez en la fila, son a lo sumo n. Entonces son exactamente n. Si alguna celda tuviera dos símbolos, y las demás al menos uno, serían n + 1 o más. Eso no puede pasar. ∎
Eso depende de que haya tantos símbolos como celdas en una fila, que es lo que pasa en un cuadrado latino, y también en un sudoku. El programa cuenta en una sola fila, y lo comprueba con todas las asignaciones:
$ build/latin_demo
Cuántas soluciones tiene el cuadrado de lado 2:
  reglas completas:                      2
  celda al menos uno, línea a lo sumo uno: 2
  solo reglas de al menos uno:           35

El argumento del palomar, en una fila de n celdas (todas las asignaciones):
  n = 2: 2 modelos, 0 con dos símbolos en una celda
  n = 3: 6 modelos, 0 con dos símbolos en una celda
  n = 4: 24 modelos, 0 con dos símbolos en una celda
...
Son n! modelos, uno por cada permutación, y ninguno pone dos símbolos en una celda. Esta omisión tampoco produce un bug. Y es solo un ahorro de cláusulas, que además no siempre conviene: una cláusula redundante le puede ayudar a un solucionador a propagar antes, o no. Si les interesa, mídanlo.
Tercer caso: rompe la respuesta
El bug aparece cuando no queda ninguna regla de “a lo sumo uno”. Es el error natural de quien escribe “cada celda tiene un símbolo, cada fila tiene cada símbolo y cada columna tiene cada símbolo”, y traduce cada una como una sola cláusula grande. En el cuadrado de lado 2, en la primera tabla de la salida anterior, eso ya tiene 35 modelos, mientras que las soluciones reales son 2. Se ve por qué: si todas las variables son verdaderas, cada una de esas cláusulas grandes se cumple, y así queda un modelo que no significa nada.
Con minisat, en el cuadrado de lado 3:
$ build/latin_demo
...
Un cuadrado de lado 3, con 1 en la celda (0, 0) y 2 en la celda (1, 1):
reglas completas: 27 variables, 110 cláusulas, minisat dice SAT
  1 3 2
  3 2 1
  2 1 3
  es un cuadrado latino
celda al menos uno, línea a lo sumo uno: 27 variables, 65 cláusulas, minisat dice SAT
  1 3 2
  3 2 1
  2 1 3
  es un cuadrado latino
solo al menos uno: 27 variables, 29 cláusulas, minisat dice SAT
  1 3 2
  3 2 1
  2 1 1
  NO es un cuadrado latino

El mismo cuadrado con 1 en (0, 0) y 1 en (0, 1), que no tiene solución:
reglas completas: 27 variables, 110 cláusulas, minisat dice UNSAT
celda al menos uno, línea a lo sumo uno: 27 variables, 65 cláusulas, minisat dice UNSAT
solo al menos uno: 27 variables, 29 cláusulas, minisat dice SAT
  1 1 2
  3 3 1
  2 2 1
  NO es un cuadrado latino
Las dos fallas son reales. En el primer tablero, solo con “al menos uno”, la última fila repite el 1. Eso no le molesta a la fórmula. En el segundo, la fórmula está diciendo que un cuadrado sin solución es satisfacible, y el 1 repetido en la primera fila se imprime sin más. La fórmula ya no significa lo que queríamos: la dirección 2 de la demostración, de un modelo a una solución, se perdió.
Error común. Codificar “al menos uno” y olvidar “a lo sumo uno”. En el coloreo no hace daño, y en el cuadrado latino se puede quitar una de esas reglas si otra la implica. Pero si se quitan todas, la fórmula acepta tableros absurdos, y hasta declara satisfacible lo imposible. Por eso, el criterio no es “escribir siempre todo” ni “quitar lo que parece de más”: es hacer la demostración de la dirección 2, de un modelo a una solución, con las cláusulas que se escribieron. Si la demostración no pasa, falta una regla.
El laboratorio: un sudoku como fórmula
El laboratorio de esta semana es lab/sudoku_sat. Un sudoku de orden k tiene n = k · k filas, columnas y dígitos, y
cajas de k por k. Ustedes completan dos funciones, y un programa que les damos, driver.h, las conecta con minisat:
encodeescribe la fórmula en DIMACS, con una variable por cada terna (fila, columna, dígito). Son n³: 729 en un tablero de 9 por 9.decodelee la respuesta y escribe el tablero, o la palabraimposible.
La lista de reglas sale de leer el enunciado con calma: una regla por cada celda, por cada fila, por cada columna y por
cada caja. Falta otra para los valores que ya vienen dados, y esas son cláusulas de un solo literal. Una cláusula de un
literal obliga a su variable. Antes de programar, calculen a mano cuántas variables y cláusulas van a escribir. El
encabezado debe coincidir, porque el programa revisa eso y termina con un error si no coincide. minisat, en cambio,
solo avisaría.
Dos cosas se pueden comprobar en el laboratorio, una vez que funcione:
- La regla “a lo sumo un dígito por celda” está implicada, por el mismo argumento del palomar de arriba. Quítenla, y el juez sigue dando AC.
- Si se quitan todas las reglas de “a lo sumo uno”, la cosa se rompe, como en el cuadrado latino. Quítenlas y miren qué dice el juez.
Y un comentario sobre el tiempo. El último paso del laboratorio pide comparar con un backtracking. Si no tienen a mano
su solucionador de Introducción a la Programación, backtrack_bench trae uno, por filas y con los dígitos en orden, que
informa nodos y tiempo con un sudoku de 17 valores dados:
$ build/backtrack_bench
valores dados: 17
resultado: tiene solución
nodos: 69175317
segundos: 3.9239
Este sudoku es difícil para este orden de búsqueda, no en general: ese tablero fue construido para que la primera
fila de la solución tenga los dígitos en orden inverso. Tiempo con std::chrono::steady_clock, compilado con -O2, en
el contenedor del curso, en una máquina compartida con otros procesos, en una sola corrida. Depende de la máquina, y en
otra corrida del mismo programa salieron poco más de 3 segundos. Los nodos no dependen de la máquina.
El código de la semana
| Archivo | Qué tiene |
|---|---|
graphs.h |
Grafos pequeños, verificadores, fuerzas brutas, complemento y las reducciones |
cnf.h |
CNF, DIMACS, “al menos uno”, “a lo sumo uno”, el verificador de SAT, fuerza bruta y DPLL |
minisat.h |
Llamar a minisat desde C++ y leer su respuesta |
coloring.h |
El coloreo como CNF, y su lectura |
latin.h |
El cuadrado latino como CNF, con las reglas que se quieran activar |
reduction_demo.cpp |
Las reducciones en un grafo de 6 nodos, una mal hecha y el 2-coloreo |
cnf_demo.cpp |
Exactamente uno de tres, y DPLL paso a paso |
coloring_demo.cpp |
El coloreo con minisat |
latin_demo.cpp |
Los tres casos de “al menos uno” y “a lo sumo uno” |
sat_bench.cpp |
El principio del palomar con minisat |
backtrack_bench.cpp |
Un backtracking de sudoku para comparar |
ejemplos/ |
Tres archivos DIMACS pequeños |
test_examples.cpp |
Las pruebas de lo que afirman estos apuntes |
$ make test
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
todas las pruebas pasaron
make test compila con sanitizers y necesita minisat, que está en el entorno del curso. make bench corre las dos
mediciones de este capítulo con -O2, y tarda menos de un minuto: el palomar se detiene en el primer tamaño que agota
el límite.
Resumen
- Decisión: las definiciones son para problemas de sí o no. La optimización se reduce a ellos con búsqueda binaria, en los casos de esta semana.
- Bits: el tamaño se mide en los bits de la entrada. O(nW) no es polinomial, porque W ocupa solo log W bits.
- P: problemas de decisión con un algoritmo polinomial en todas sus instancias.
- NP: problemas de decisión donde cada “sí” tiene un certificado corto, y un verificador polinomial que nunca acepta un “no”. P ⊆ NP, porque el verificador puede ignorar el certificado. NP no significa “no polinomial”.
- P contra NP: sigue abierto. La mayoría cree que P ≠ NP: es una creencia, sin demostración.
- Reducción polinomial A ≤ₚ B: una función polinomial f con x “sí” en A si y solo si f(x) “sí” en B. Si B está en P, A también. Si A es difícil, B es al menos tan difícil. Es transitiva.
- La dirección: para demostrar que N es difícil, D ≤ₚ N, del conocido al nuevo. Al revés, solo se muestra que N no es más difícil. 2-coloreo ≤ₚ 3-coloreo no hace difícil al 2-coloreo.
- NP-difícil: todo NP se reduce a él. NP-completo: además está en NP. Se trabajan en la semana 14, donde se demuestra que conjunto independiente lo es.
- La mochila: la decisión es NP-completa, lo que se asume aquí. O(nW) es exponencial en los bits, así que no dice nada sobre P = NP.
- Conjunto independiente y cobertura: S es independiente si y solo si V − S es cobertura. f(G, k) = (G, n − k).
- Conjunto independiente y clique: S es independiente en G si y solo si es clique en Ḡ. f(G, k) = (Ḡ, k), en O(V²).
- El patrón: escribir f, comprobar que es polinomial, y demostrar las dos direcciones.
- SAT: ¿tiene modelo una fórmula en CNF? Está en NP. Los solucionadores combinan propagación unitaria, búsqueda y aprendizaje de cláusulas. No hay garantía: 90 variables del palomar pueden tardar más que un sudoku de miles.
- Codificar: variables con significado y cláusulas por cada regla. Al menos uno: una cláusula. A lo sumo uno: una por cada par. Se demuestra como cualquier reducción.
- DIMACS y
minisat:p cnf V C, literales con signo y 0 al final. Código 10 si es SAT, 20 si es UNSAT, y el modelo en el archivo de respuesta. Un encabezado mal escrito solo da un aviso. - Al menos uno sin a lo sumo uno: inocuo en el coloreo, implicado por el palomar si queda una regla que cuente, y un bug real si no queda ninguna. Lo decide la demostración de la dirección 2.
Ejercicios
- Certificados. Para cada problema, den un certificado, digan qué se verifica y cuánto cuesta en función de la entrada: cobertura de vértices; camino hamiltoniano entre s y t; ¿se puede partir una lista de enteros en dos grupos de igual suma?; ¿se puede colorear G con 3 colores? ¿En cuáles conocen además un algoritmo polinomial para resolverlos?
- Verdadero o falso. Justifiquen cada una, con una demostración corta o con un contraejemplo. Si A ≤ₚ B y A está en P, entonces B está en P. Si A ≤ₚ B y B ≤ₚ A, y A está en P, entonces B está en P. Si A está en P y B es cualquier problema que tiene al menos una instancia “sí” y una “no”, entonces A ≤ₚ B. Ningún problema de NP se puede resolver en tiempo polinomial.
- Las otras flechas. Escriban y demuestren, con sus dos direcciones, las reducciones cobertura de vértices ≤ₚ
conjunto independiente y clique ≤ₚ cobertura de vértices. Compruébenlas con las fuerzas brutas de
graphs.h, en todos los grafos de hasta 5 nodos. - De la decisión a la solución. Supongan que tienen solamente la función
has_independent_set, y úsenla como caja negra. Programen una función que devuelva un conjunto independiente máximo, con O(n) llamadas. Demuestren que lo que queda al final es independiente. Pista: el argumento de la sección de problemas de decisión. - Bits. Un programa decide si un número N es primo probando divisores hasta √N. Con N de 64 bits, ¿cuántas divisiones hace como máximo? ¿Y con N de 128 bits? ¿Es polinomial en los bits? Hagan la misma cuenta con la mochila, con 100 objetos y W de 64 bits.
- Una reducción con un error. Alguien propone f(G, k) = (Ḡ, n − k) como reducción de conjunto independiente a
clique. Con
graphs.h, busquen el contraejemplo más pequeño, y expliquen qué parte de la demostración se rompe. - Más colores. Demuestren que c-coloreo ≤ₚ (c + 1)-coloreo, para todo c ≥ 1, con las dos direcciones. Si se sabe que 3-coloreo es NP-completo, ¿qué se concluye de 4-coloreo? ¿Y por qué 2-coloreo ≤ₚ 3-coloreo no dice nada de 2-coloreo?
- Contar en CNF. Escriban en CNF “a lo sumo dos de x₁, …, x₅ son verdaderas” y “al menos dos de x₁, …, x₅ son
verdaderas”, sin variables nuevas. ¿Cuántas cláusulas salen? Compruébenlas con una tabla de verdad en C++ usando
for_each_model. Generalicen a “a lo sumo k de m”. - Clique en SAT. Codifiquen en CNF “G tiene un clique de tamaño k”, con una variable x(i, v) para “el i-ésimo nodo
del clique es v”. Escriban las reglas, demuestren las dos direcciones y programen
encode_clique. Comparen conhas_clique, usandorun_minisat, en todos los grafos de hasta 5 nodos. - Camino hamiltoniano en SAT. Codifiquen en CNF “G tiene un camino hamiltoniano”, con una variable x(p, v) para “en la posición p del camino va el nodo v”. ¿Cuántas variables y cláusulas salen? Prográmenlo, y compárenlo con Held-Karp de la semana 10 en grafos de 8 nodos.
- Cuenta del sudoku. En un sudoku de orden k, sin valores dados, cuenten las variables y las cláusulas de la fórmula completa, con “exactamente uno” en cada una de las cuatro familias. Evalúen la fórmula para k = 3 y k = 5. Después demuestren que basta con “al menos un dígito por celda” y “a lo sumo una vez” en filas, columnas y cajas: ¿cuántas cláusulas se ahorran? Compruébenlo con su laboratorio.
- Afinar DPLL. Agreguen a la clase
Dplldecnf.hla regla del literal puro: si una variable aparece con un solo signo en las cláusulas que todavía no se cumplen, se le puede dar ese valor sin cambiar si la fórmula es satisfacible: si hay un modelo, hay uno con ese valor. Demuestren esa afirmación, y den un ejemplo de un modelo que sí se pierde. Después midandecisions()con y sin la regla, en fórmulas de palomar de 4, 5 y 6 huecos. Reporten lo que salga, aunque la regla no ayude.