Apuntes · Capítulo 3Demostrar y dividir
Selección en tiempo lineal, Karatsuba y el par más cercano
Selección en tiempo lineal, Karatsuba y el par más cercano
La semana pasada aprendimos a pasar de un algoritmo recursivo a su recurrencia, y a resolverla con el árbol de recursión o con el teorema maestro. Usamos eso con mergesort, donde todo sale parejo: dos mitades iguales y una mezcla lineal. Esta semana hay tres problemas donde dividir no es tan cómodo, y en cada uno aparece una idea nueva de diseño.
- Selección. Queremos el k-ésimo menor de un arreglo sin ordenarlo. Aquí la dificultad es que los subproblemas son de distinto tamaño, y el teorema maestro no aplica. La idea nueva es gastar un poco de trabajo en elegir bien el pivote, para que la división quede pareja aunque la entrada sea la peor.
- Multiplicación. Multiplicar números de n dígitos dividiéndolos en dos no mejora nada, hasta que se descubre que tres productos bastan donde parecía que hacían falta cuatro. La idea nueva es bajar el número de subproblemas: el exponente de la recurrencia depende de él.
- Par más cercano. Dividir es fácil, y lo difícil es combinar. Hay que mirar pares que cruzan de una mitad a la otra, que pueden ser Θ(n²). La idea nueva es una demostración geométrica: la propia respuesta de las mitades limita a cuántos vecinos hay que mirar.
En las tres, la pregunta no es solo cuánto cuesta, sino por qué el truco funciona siempre, incluidos los casos raros: valores repetidos, un número con un dígito de más, puntos sobre la línea que divide. Esos casos raros son los que hacen fallar un programa y una demostración.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, El k-ésimo menor, Quickselect: partir y seguir por un solo lado y Multiplicar números grandes. Con eso llegan con el problema de cada sesión y la idea de partir que se va a mejorar.
En clase: Sesión A, de La mediana de medianas a Por qué 5 y no 3. Sesión B, Karatsuba y El par más cercano.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El par más cercano otra vez y El código de la semana. Para ampliar, En C++, En la práctica: lo que usan las bibliotecas, ¿Se nota en la práctica? y las lecturas de apoyo del recuadro siguiente.
Lectura. Erickson, secs. 1.8 (Linear-Time Selection) y 1.9 (Fast Multiplication). CLRS, capítulo Medians and Order Statistics, 4.ª edición. Sobre el par más cercano, estos apuntes son el texto principal.
Código. Los programas de este capítulo están en
code/week-03. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/closest_pair.
El k-ésimo menor
El k-ésimo menor de un arreglo A de n elementos es el valor que queda en la posición k si A se ordena de menor a mayor. Contamos k desde 0, igual que los índices: k = 0 es el mínimo y k = n − 1 es el máximo. La mediana es el caso k = (n − 1) div 2. Cuando n es par hay dos candidatos naturales, y este valor de k elige el menor, que llamamos mediana inferior.
Los valores pueden repetirse, y la definición no se complica por eso: si A = 4, 1, 4, 4, 2, ordenado queda 1, 2, 4, 4, 4, y el valor con k = 3 es 4.
La solución obvia es ordenar y leer la posición k, en Θ(n log n). Pero ordenar calcula mucho más de lo que se pidió: la posición de todos los elementos, cuando solo queremos uno. Para k = 0 sabemos que basta una pasada, con n − 1 comparaciones. ¿Se puede hallar la mediana, que parece el caso más difícil, también en tiempo lineal? La respuesta es sí, y en el peor caso. Es uno de los resultados más sorprendentes del divide y vencerás, y es lo que demostraremos en la primera mitad de este capítulo.
Quickselect: partir y seguir por un solo lado
En Estructuras de Datos vieron quicksort: se elige un pivote, se parte el arreglo y se ordena cada lado. Si solo buscamos un elemento, no hace falta ordenar los dos lados. Después de partir sabemos en cuál de ellos está la respuesta, y el otro se descarta. Eso es quickselect.
Vamos a partir en tres grupos, y más adelante veremos que esto importa para la demostración: L con los menores que el pivote, E con los iguales y G con los mayores.
algoritmo partir(A, pivote)
    L ← lista vacía
    E ← lista vacía
    G ← lista vacía
    para i desde 0 hasta |A| - 1 hacer
        si A[i] < pivote entonces
            agregar A[i] al final de L
        sino si A[i] > pivote entonces
            agregar A[i] al final de G
        sino
            agregar A[i] al final de E
        fin si
    fin para
    devolver L, E, G
fin algoritmo

algoritmo quickselect(A, k)
    mientras |A| > 1 hacer
        pivote ← A[0]
        L, E, G ← partir(A, pivote)
        si k < |L| entonces
            A ← L
        sino si k < |L| + |E| entonces
            devolver pivote
        sino
            k ← k - |L| - |E|
            A ← G
        fin si
    fin mientras
    devolver A[0]
fin algoritmo
Aquí |A| es la cantidad de elementos de A. Esta versión toma como pivote el primer elemento, la regla más simple posible.
Afirmación. Si 0 ≤ k < |A|, quickselect(A, k) termina y devuelve el k-ésimo menor de A. Lo demostramos con
una invariante de ciclo.
Invariante. Al inicio de cada vuelta, 0 ≤ k < |A|, y el k-ésimo menor del A actual es la respuesta buscada.
Inicio. Al entrar, A y k son los de la entrada, así que se cumple.
Mantenimiento. Si ordenáramos A, aparecerían primero los elementos de L, luego los de E y luego los de G, porque todo elemento de L es menor que todo elemento de E y todo elemento de E es menor que todo elemento de G. Entonces las posiciones 0 a |L| − 1 del arreglo ordenado son de L, las siguientes |E| son de E y las demás son de G. Hay tres casos:
- Si k < |L|, la posición k cae en L, y dentro de L sigue siendo la posición k. Al hacer A ← L se mantiene la invariante.
- Si |L| ≤ k < |L| + |E|, la posición k cae en E, y todos los elementos de E valen lo mismo que el pivote. Devolverlo es correcto.
- Si no, la posición k cae en G, y dentro de G es la posición k − |L| − |E|. Como k < |A| = |L| + |E| + |G|, ese índice es menor que |G|.
Terminación. El pivote está en A, así que E tiene al menos un elemento y L y G son estrictamente más cortos que A. El tamaño baja en cada vuelta.
Salida. Si el ciclo termina porque |A| = 1, la invariante da k = 0 y la respuesta es A[0].
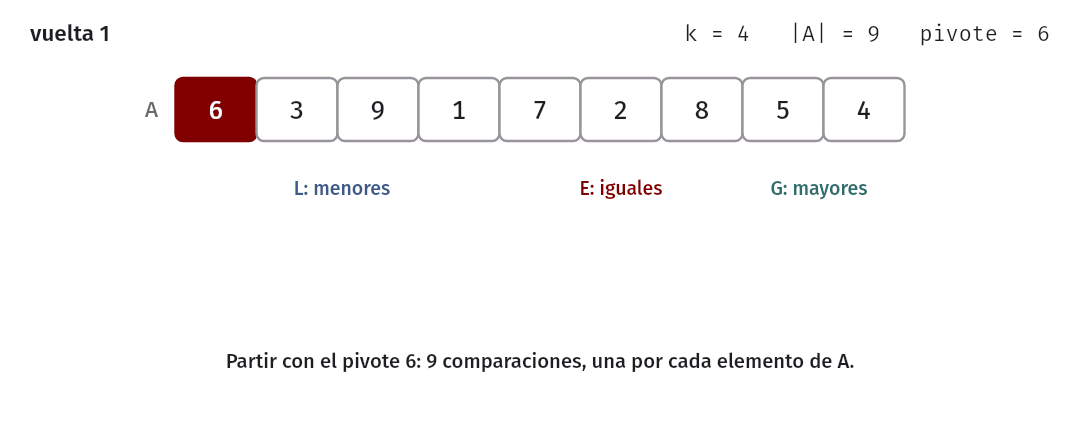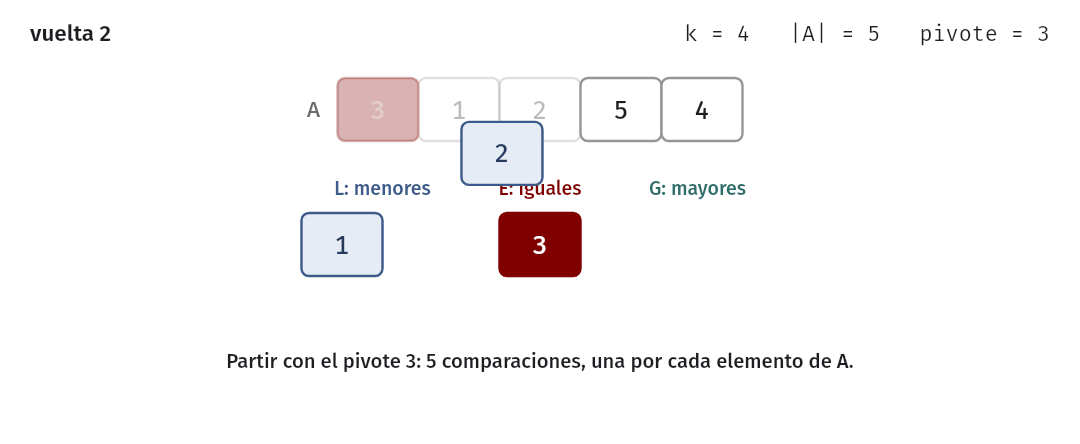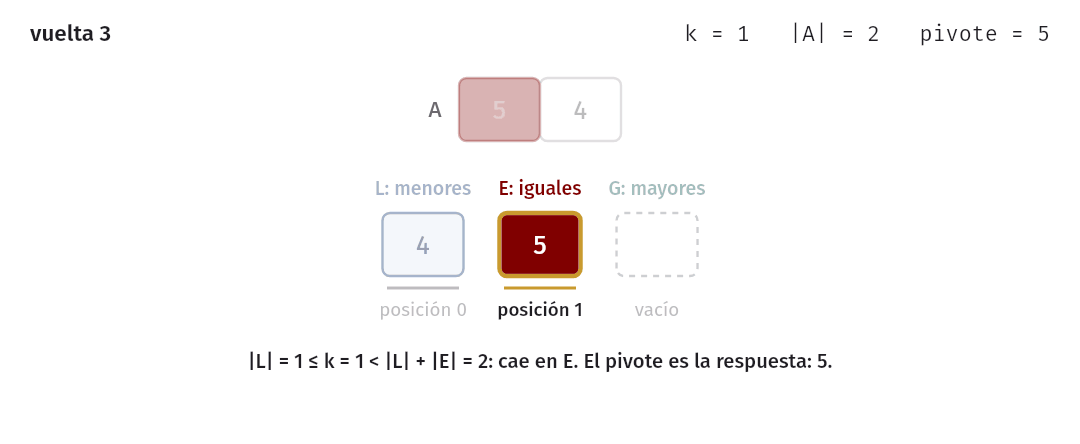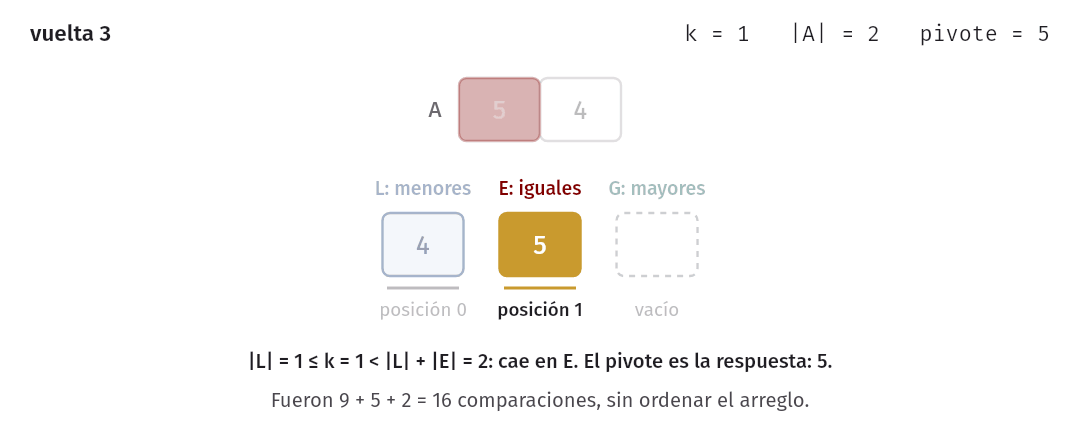
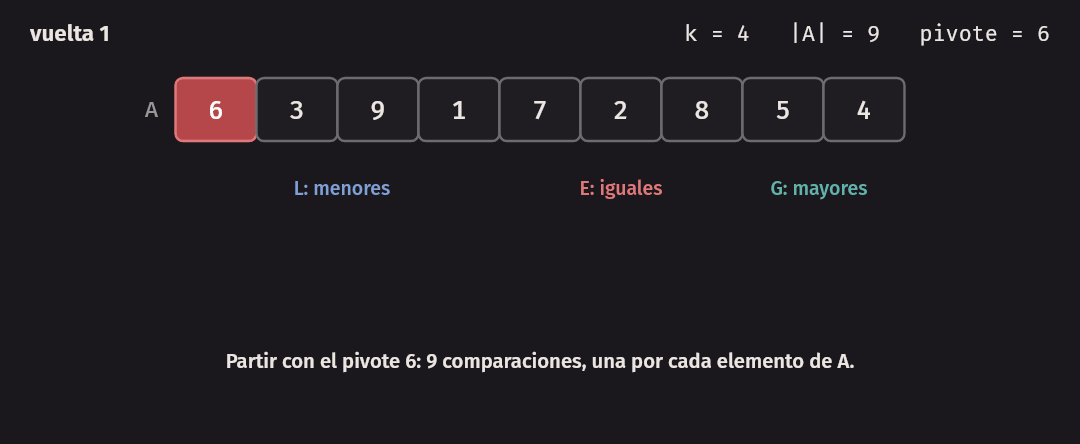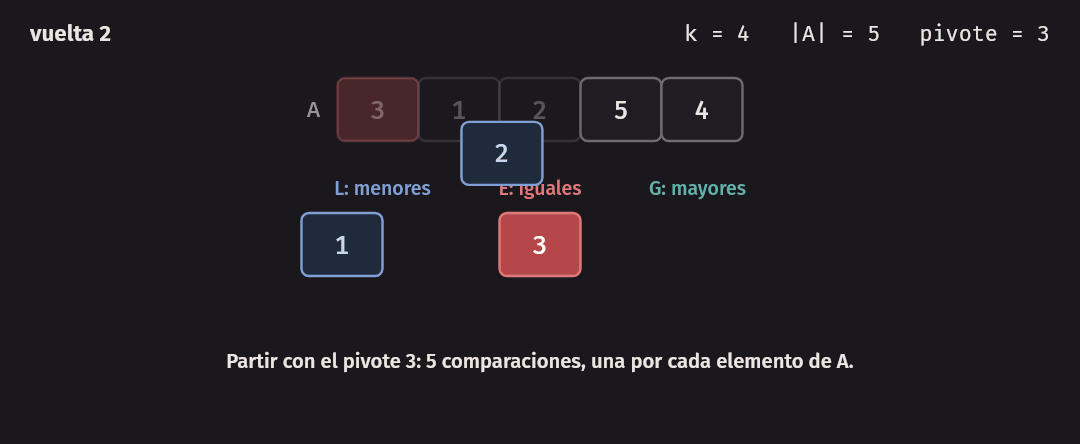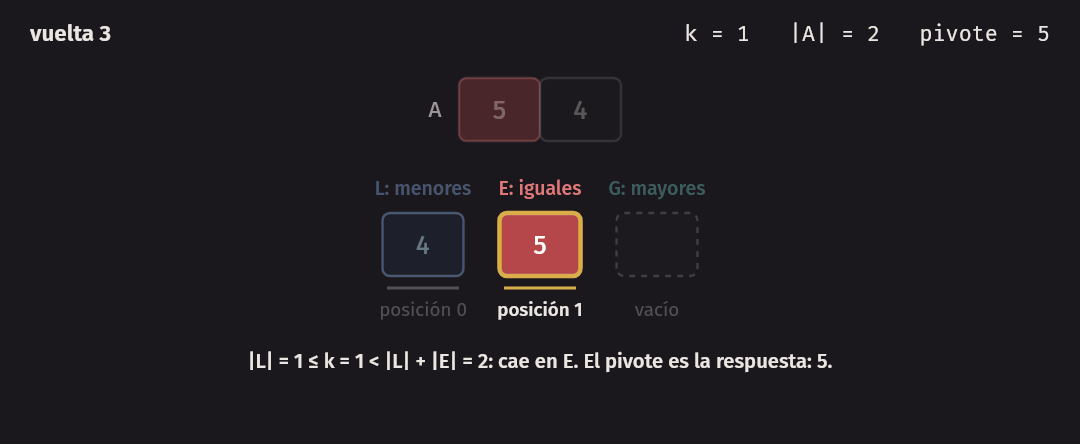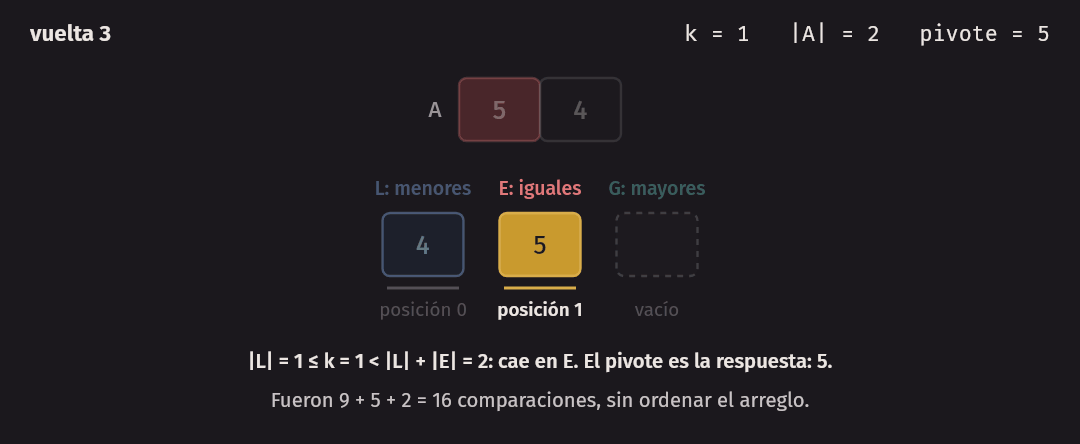
Sigamos el programa quickselect_trace con A = 6, 3, 9, 1, 7, 2, 8, 5, 4 y k = 4. Ordenado, el arreglo es 1, 2,
3, 4, 5, 6, 7, 8, 9, así que la respuesta debe ser 5.
$ build/quickselect_trace
k = 4  A = [6 3 9 1 7 2 8 5 4]
  pivote 6  menores [3 1 2 5 4]  iguales [6]  mayores [9 7 8]
k = 4  A = [3 1 2 5 4]
  pivote 3  menores [1 2]  iguales [3]  mayores [5 4]
k = 1  A = [5 4]
  pivote 5  menores [4]  iguales [5]  mayores []
  k cae en los iguales: respuesta 5
16 comparaciones
En forma de tabla, con cómo cambia cada variable:
| Vuelta | k | |A| | Pivote | |L| | |E| | |G| | Decisión |
|---|---|---|---|---|---|---|---|
| 1 | 4 | 9 | 6 | 5 | 1 | 3 | k < 5: seguir por L |
| 2 | 4 | 5 | 3 | 2 | 1 | 2 | k ≥ 3: seguir por G, con k = 4 − 3 = 1 |
| 3 | 1 | 2 | 5 | 1 | 1 | 0 | 1 ≤ k < 2: el pivote es la respuesta |
Fueron 9 + 5 + 2 = 16 comparaciones, una por cada elemento en cada partición. Ordenar habría calculado además el lugar de los otros ocho elementos.
El peor caso
Cada partición cuesta Θ(|A|). Si el pivote parte cerca de la mitad, el tamaño cae a la mitad y el costo total es n + n/2 + n/4 + … ≤ 2n. Pero nada obliga a que sea así. Tomemos un arreglo ya ordenado y k = n − 1, el máximo. El primer elemento es el mínimo, así que L queda vacío, E tiene un elemento y G tiene todos los demás. Los tamaños son n, n − 1, n − 2, …, 2, y el total de comparaciones es
n + (n − 1) + … + 2 = n(n + 1)/2 − 1 = Θ(n²).
El programa lo cuenta. Este conteo no depende de la máquina, y test_select comprueba la fórmula exacta:
arreglo ordenado, k = n - 1, primer elemento como pivote
        n   comparaciones   n(n+1)/2 - 1
     1000          500499         500499
     2000         2000999        2000999
     4000         8001999        8001999
     8000        32003999       32003999
Al duplicar n, el conteo se multiplica por 4. Ojo con un detalle: qué entrada es mala depende de k. Con el mismo arreglo ordenado y k = 0, el primer pivote ya es la respuesta y basta una pasada, con n comparaciones. Con el arreglo ordenado al revés pasa lo contrario: k = 0 es el caso malo. Y con el arreglo ordenado y la mediana, los tamaños van de n a cerca de n/2, y el total sigue siendo Θ(n²), porque son unos n/2 términos de tamaño al menos n/2.
Todo depende del pivote. Fijémonos en qué necesitamos exactamente. Supongamos que tenemos una forma de elegir, en tiempo O(n), un pivote que deje en cada lado a lo sumo α·n elementos, para alguna constante α < 1. Entonces el costo total sería a lo sumo
c·n + c·α·n + c·α²·n + … ≤ c·n / (1 − α) = O(n).
No hace falta la mediana exacta: basta con un pivote razonable, que siempre quite una fracción fija. Con α = 0,99 también sería lineal, aunque con una constante enorme. El problema se reduce a garantizar esa fracción, sin suerte y sin importar la entrada.
Idea clave. Quickselect no necesita el pivote perfecto. Necesita un pivote que siempre descarte una fracción constante del arreglo. Una suma geométrica se encarga del resto.
La mediana de medianas
La idea, de Blum, Floyd, Pratt, Rivest y Tarjan, es buscar el pivote en una muestra pequeña y bien repartida, y usar la propia selección de forma recursiva para hallarlo:
- Repartir A en grupos de 5 por posición: ⌈n/5⌉ grupos, y el último puede tener menos de 5.
- Hallar la mediana inferior de cada grupo. Cada grupo tiene a lo sumo 5 elementos, así que es trabajo constante por grupo.
- Con esas ⌈n/5⌉ medianas, hallar su mediana inferior, llamando recursivamente al mismo algoritmo. Ese valor es el pivote.
- Partir A con ese pivote y seguir por un solo lado, como en quickselect.
El nombre mediana de medianas (median of medians) viene del paso 3.
algoritmo medianas_de_grupos(A)
    M ← lista vacía
    inicio ← 0
    mientras inicio < |A| hacer
        grupo ← los elementos de A desde inicio hasta antes de mín(inicio + 5, |A|)
        ordenar grupo
        agregar grupo[(|grupo| - 1) div 2] al final de M
        inicio ← inicio + 5
    fin mientras
    devolver M
fin algoritmo

algoritmo seleccionar(A, k)
    si |A| ≤ 5 entonces
        ordenar A
        devolver A[k]
    fin si
    M ← medianas_de_grupos(A)
    pivote ← seleccionar(M, (|M| - 1) div 2)
    L, E, G ← partir(A, pivote)
    si k < |L| entonces
        devolver seleccionar(L, k)
    sino si k < |L| + |E| entonces
        devolver pivote
    sino
        devolver seleccionar(G, k - |L| - |E|)
    fin si
fin algoritmo
Correctitud. Por inducción fuerte sobre n = |A|. Si n ≤ 5, se ordena y se lee. Si n ≥ 6, entonces |M| = ⌈n/5⌉ < n, y por hipótesis inductiva la llamada sobre M devuelve su mediana inferior. Ese valor es un elemento de A, así que E no está vacío y L y G tienen menos de n elementos. El resto es el mismo razonamiento de tres casos de quickselect, con la hipótesis inductiva en lugar de la invariante. Observen que la elección del pivote no interviene en la correctitud: solo importa que sea un elemento de A. Influye únicamente en el costo.
Sigamos una vuelta con 23 elementos. Son ⌈23/5⌉ = 5 grupos, y el último tiene solo 3.
$ build/mom_trace
n = 23
grupo: 12 3 25 8 17  ordenado: 3 8 12 17 25  mediana: 12
grupo: 40 6 31 22 9  ordenado: 6 9 22 31 40  mediana: 22
grupo: 15 37 1 28 19  ordenado: 1 15 19 28 37  mediana: 19
grupo: 44 11 33 5 26  ordenado: 5 11 26 33 44  mediana: 26
grupo: 14 30 2  ordenado: 2 14 30  mediana: 14
medianas: 12 22 19 26 14
pivote (mediana inferior de las medianas): 19
elementos <= pivote: 13
elementos >= pivote: 11
cota 3n/10 - 3: 3.9
menores: 12  iguales: 1  mayores: 10
cota 7n/10 + 3: 19.1
Ahora dibujemos los grupos como columnas, cada una ordenada de arriba abajo, y las columnas ordenadas por su mediana. La fila de las medianas es la del medio:
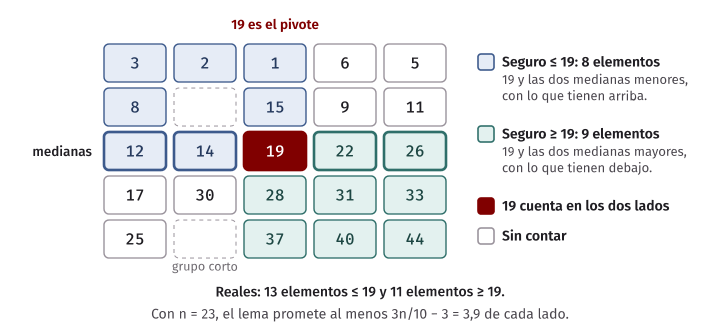
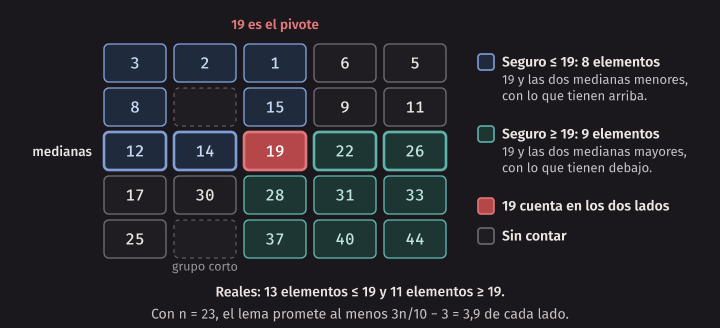
El pivote es 19. Los valores a la izquierda de 19 en la fila de medianas (12 y 14) son menores o iguales que 19, y además cada uno arrastra lo que está arriba en su columna. Del mismo modo, 22 y 26 son mayores o iguales que 19 y arrastran lo que está debajo. Sin mirar nada más sabemos que 3, 8, 12, 2, 14, 1, 15 y 19 son a lo sumo 19, y que 19, 28, 37, 22, 31, 40, 26, 33 y 44 son al menos 19. Los conteos reales son 13 y 11, y son mayores, porque también hay otros elementos en esas regiones, como el 17 o el 30, que la demostración no cuenta.
Con ese pivote se sigue la búsqueda. Queremos la mediana, k = 11. Este es el resto de la misma salida, con una
línea por llamada de seleccionar que sigue por un lado. No muestra las llamadas sobre las medianas, que buscan
cada pivote.
la mediana, k = 11
|A| = 23, k = 11: pivote 19, |L| = 12, |E| = 1, |G| = 10
|A| = 12, k = 11: pivote 8, |L| = 5, |E| = 1, |G| = 6
|A| = 6, k = 5: pivote 12, |L| = 2, |E| = 1, |G| = 3
|A| = 3, k = 2: se ordena [14 15 17] y la respuesta es 17
ordenando, la posicion 11 es 17; la funcion dio 17| Llamada | |A| | k | Pivote | |L| | |E| | |G| | Decisión |
|---|---|---|---|---|---|---|---|
| 1 | 23 | 11 | 19 | 12 | 1 | 10 | k < 12: sigue por L |
| 2 | 12 | 11 | 8 | 5 | 1 | 6 | k ≥ 6: sigue por G, con k = 11 − 6 = 5 |
| 3 | 6 | 5 | 12 | 2 | 1 | 3 | k ≥ 3: sigue por G, con k = 5 − 3 = 2 |
| 4 | 3 | 2 | |A| ≤ 5: se ordena y se lee |
Fíjense en que en la segunda llamada el pivote fue 8, que en esos 12 elementos deja 5 por debajo y 6 por encima: un corte muy parejo sin que el algoritmo haya ordenado casi nada. En la tercera, 12 deja 2 y 3.
Cuántos elementos quedan a cada lado
Fijemos la convención y demostremos la cota exacta. Sea n ≥ 1, m = ⌈n/5⌉ la cantidad de grupos, y p el pivote: la mediana inferior de las m medianas, que ocupa el lugar ⌈m/2⌉ al ordenarlas, contando desde 1.
Lema. Hay al menos 3n/10 − 3 elementos de A que son ≤ p, y al menos 3n/10 − 3 elementos de A que son ≥ p. En consecuencia, |L| ≤ 7n/10 + 3 y |G| ≤ 7n/10 + 3.
Técnica: contar directamente. Ordenamos las medianas y usamos solo la posición de cada una, de modo que los valores repetidos no molestan.
Paso 1: medianas a cada lado. Al ordenar las m medianas, p está en el lugar ⌈m/2⌉. Las medianas de los lugares 1 a ⌈m/2⌉ son ≤ p: son ⌈m/2⌉. Las de los lugares ⌈m/2⌉ a m son ≥ p: son m − ⌈m/2⌉ + 1 = ⌊m/2⌋ + 1, y eso es al menos ⌈m/2⌉. Entonces, en cada dirección, hay al menos ⌈m/2⌉ grupos cuya mediana está de ese lado de p. Cada grupo aporta su mediana una sola vez, aunque tenga el mismo valor que otra.
Paso 2: elementos por grupo. En un grupo de exactamente 5 elementos, la mediana inferior es la tercera al ordenar. Hay 3 elementos ≤ que ella (contándola) y 3 elementos ≥ que ella (contándola). Si la mediana del grupo es ≤ p, esos tres son ≤ p. Si es ≥ p, los otros tres son ≥ p.
Paso 3: el grupo corto. A lo sumo un grupo tiene menos de 5 elementos. Por prudencia no le contamos nada. Quedan al menos ⌈m/2⌉ − 1 grupos completos en cada dirección, y como los grupos son disjuntos, sus elementos son distintos como posiciones de A. Entonces hay al menos 3(⌈m/2⌉ − 1) elementos ≤ p, y al menos otros tantos ≥ p.
Paso 4: la cuenta. Como m = ⌈n/5⌉ ≥ n/5, tenemos ⌈m/2⌉ ≥ m/2 ≥ n/10. Por lo tanto 3(⌈m/2⌉ − 1) ≥ 3(n/10 − 1) = 3n/10 − 3.
Paso 5: los tamaños. L son los elementos estrictamente menores que p, y ninguno de los que son ≥ p está en L. Entonces |L| ≤ n − (3n/10 − 3) = 7n/10 + 3. Por el mismo argumento con los ≤ p, |G| ≤ 7n/10 + 3. ∎
Tres comentarios sobre esta cuenta.
El “3” al final no es adorno. La frase “al menos 3n/10 elementos a cada lado” es solo aproximada, y conviene saber por qué. Con n = 23, 3n/10 = 6,9, y lo que el lema promete es 3,9. Cuando todos los grupos son completos (n múltiplo de 5), el paso 3 no descarta nada y sí salen 3⌈m/2⌉ ≥ 3n/10. El −3 paga el grupo corto y el redondeo. Otros libros restan otra constante porque descartan además el grupo de p. Es una cuenta más gruesa y tan válida como esta.
Los repetidos son la razón para partir en tres. Toda la cuenta se hizo sobre ”≤ p” y ”≥ p”, y es cierta con repetidos. Si partiéramos en solo dos grupos, “menores” y “mayores o iguales”, un arreglo con todos los elementos iguales dejaría a todos del mismo lado, y cada vuelta quitaría solo el pivote: al menos cuadrático, con el pivote “perfecto”. Con tres grupos, E absorbe todos los iguales, y L y G respetan la cota sin importar cuántos repetidos haya.
La cota casi se alcanza. tight_input de select.h construye una entrada donde el pivote deja justo 3⌈m/2⌉
elementos ≤ p: la mitad de los grupos tiene sus tres menores entre los valores más pequeños de todos, y lo demás
queda por encima. Así que el 3/10 no se puede mejorar para esta regla, salvo por la constante. Este programa
cuenta los dos lados con n = 1000 y varios tipos de entrada:
$ build/pivot_bound
n = 1000, cota 3n/10 - 3 = 297
entrada                <= piv   >= piv
al azar                   507      494
ordenado                  498      503
todos iguales            1000     1000
tres valores              673      659
construida                300      701
Las filas con todos iguales o con tres valores suman más de n, porque los elementos iguales a p se cuentan en
las dos columnas. La fila construida llega a 300, a 3 de la cota de 297. Observen que las entradas comunes,
como la ordenada o la que sale al azar, quedan cerca de la mitad. El peor caso existe, pero hay que construirlo
a propósito. test_select comprueba el lema con todo n hasta 400 para cinco tipos de entrada.
Error común. Decir “el pivote de la mediana de medianas es la mediana”. No lo es: es un elemento garantizado entre el 30 % y el 70 % del arreglo, aproximadamente. Con eso basta, y es justo lo que el análisis usa.
La recurrencia
Sea T(n) el mayor costo del algoritmo con cualquier entrada de a lo sumo n elementos. Definirlo así hace que T no decrezca con n, lo que usaremos en un momento. Una llamada con n ≥ 6 hace:
- Hallar las medianas de los grupos: trabajo constante por grupo, y son ⌈n/5⌉ grupos. O(n) en total.
- Una llamada recursiva sobre M, con ⌈n/5⌉ elementos.
- Partir, O(n).
- A lo sumo una llamada recursiva más, sobre L o sobre G, con a lo sumo 7n/10 + 3 elementos.
Entonces hay una constante c > 0 tal que
T(n) ≤ T(⌈n/5⌉) + T(⌊7n/10⌋ + 3) + c·n.
Sin los redondeos, es la recurrencia que aparece en la guía de esta semana:
T(n) ≤ T(n/5) + T(7n/10) + c·n.
Error común. Aplicar el teorema maestro a esta recurrencia. El teorema trata recurrencias T(n) = a·T(n/b)
- f(n), con a subproblemas del mismo tamaño, y aquí hay dos de tamaños distintos. No hay ningún a ni ningún b. Un intento típico es “son dos subproblemas, tomo b = 5”: 2T(n/5) + n da Θ(n) y parece acertar, pero por casualidad. El mismo razonamiento aplicado a T(n/3) + T(2n/3) + n, con b = 3, también daría Θ(n), y esa recurrencia es Θ(n log n), como veremos enseguida. Tomar el subproblema más grande dos veces, 2T(7n/10) + n, es una cota válida pero inútil: da O(n^1,95). Hay que usar el árbol de recursión o probar por inducción.
La intuición: el árbol de recursión
Dibujemos el árbol de la versión sin redondeos, con c = 1. La raíz trabaja n. Sus hijos trabajan n/5 y 7n/10, que suman 9n/10. Cada nodo de tamaño s tiene hijos que suman 9s/10, así que cada nivel completo suma 9/10 de lo que suma el anterior:
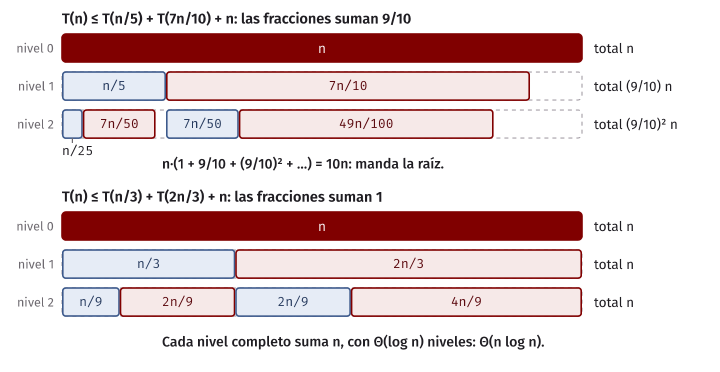
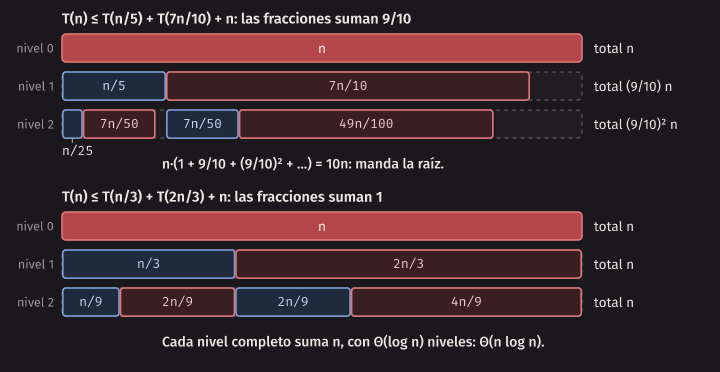
Los niveles bajan como una serie geométrica, y la raíz manda: el total es a lo sumo n·(1 + 9/10 + (9/10)² + …) = 10n. La clave es que 1/5 + 7/10 = 9/10 < 1: los dos subproblemas juntos son más pequeños que el problema. Da igual que sean desiguales. La parte de abajo de la figura muestra la recurrencia del error común anterior, T(n/3) + T(2n/3) + n. Ahí las fracciones suman 1, y volveremos a ella en la sección siguiente.
La prueba de la versión sin redondeos
Afirmación. Si T(n) ≤ T(n/5) + T(7n/10) + n, y T(n) ≤ 10n en los valores pequeños, entonces T(n) ≤ 10n para todo n. Por inducción fuerte. Supongamos la cota para valores menores que n:
T(n) ≤ 10·(n/5) + 10·(7n/10) + n = 2n + 7n + n = 10n.
Se prueba exactamente la constante que se afirma, como vimos la semana pasada. Salió 10n, y no 10n más algo, y por eso la inducción cierra. También se ve de dónde sale el 10: es 1 / (1 − 9/10).
La prueba completa
La cuenta anterior ignora los redondeos, y una inducción puede romperse justo por esos detalles. Hagamos la versión seria, con la recurrencia que realmente sale del algoritmo.
Teorema. seleccionar cuesta O(n) en el peor caso.
Técnica: inducción fuerte, con un rango de valores pequeños como casos base.
Primero, los casos pequeños son finitos. El algoritmo solo ordena directamente con n ≤ 5. Pero para el análisis podemos tratar como “pequeño” cualquier rango fijo, y eso no cambia el algoritmo. Tomemos n < 80, por razones que se verán abajo. Para n ≥ 6, toda llamada recursiva es sobre menos de n elementos, como vimos en la correctitud. Entonces T(n) ≤ T(⌈n/5⌉) + T(n − 1) + c·n, y por inducción T(n) es un número finito para cada n. Sea a el mayor valor de T(n) con 1 ≤ n < 80. Es una constante: no depende de la entrada.
La constante. Sea d = máx(20c, a). Vamos a probar que T(n) ≤ d·n para todo n ≥ 1.
Base. Si 1 ≤ n < 80, T(n) ≤ a ≤ a·n ≤ d·n.
Paso. Sea n ≥ 80, y supongamos la cota para todo valor entre 1 y n − 1. Los dos subproblemas son más pequeños que n: ⌈n/5⌉ ≤ n/5 + 1 < n, y 7n/10 + 3 < n cuando n > 10. Entonces, como d·x crece con x,
T(n) ≤ d·(n/5 + 1) + d·(7n/10 + 3) + c·n = d·(9n/10 + 4) + c·n.
Como n ≥ 80, 4 ≤ n/20, y entonces 9n/10 + 4 ≤ 19n/20. Por lo tanto,
T(n) ≤ d·(19n/20) + c·n = d·n − d·n/20 + c·n ≤ d·n,
donde el último paso usa d ≥ 20c. ∎
Aquí se entiende para qué sirve el rango grande de casos base. Los “+1” y “+3” suman un 4·d que hay que pagar, y solo se puede pagar con lo que deja libre la fracción 9/10 cuando n es suficientemente grande. El número 80 no tiene nada de especial: con cualquier n₀ > 40 funcionaría, cambiando el 20 por otra constante. Lo que sí importa es que 1/5 + 7/10 sea estrictamente menor que 1.
Como partir ya exige mirar los n elementos, el costo es también Ω(n). Entonces, en el peor caso, seleccionar cuesta Θ(n).
Error común. Confundir el umbral de la implementación con el de la demostración. El programa pasa a ordenar directamente con n ≤ 5, o con algún otro umbral chico. El 80 solo existe en la demostración: dice dónde empieza a valer el paso inductivo. Un n = 40 corre con la misma recursión, y la demostración simplemente lo cubre con la constante a.
Para ver la recurrencia con números, recurrence_table calcula T5(n) = T5(⌈n/5⌉) + T5(⌊7n/10⌋ + 3) + n, con
T5(n) = n para n < 80. Tomamos c = 1 y el rango pequeño más barato posible. La columna T3 la explicamos en la
sección siguiente.
$ build/recurrence_table
         n    T5(n)/n    T3(n)/n
     10000       6.31       9.29
     40000       7.05      11.61
    160000       7.63      13.76
    640000       8.10      15.89
   2560000       8.49      18.11
  10240000       8.79      20.27
mayor T5(n)/n con n hasta 10240000: 8.79
T5(n)/n crece cada vez menos y se mantiene muy por debajo de la cota demostrada de 20n. Una tabla no demuestra nada: el crecimiento podría seguir más adelante. Lo que da la garantía es la prueba de arriba, y la tabla solo sirve para detectar si nos equivocamos en ella.
Por qué 5 y no 3
¿Por qué grupos de 5 y no de 3, que parecen más baratos? Repitamos la cuenta con grupos de 3. La mediana de un grupo completo deja 2 elementos a cada lado, contándola. Con m = ⌈n/3⌉ grupos, por el mismo argumento hay al menos 2(⌈m/2⌉ − 1) elementos a cada lado, y eso es al menos n/3 − 2. Entonces el lado que sigue tiene a lo sumo 2n/3 + 2 elementos, y la recurrencia queda
T(n) ≤ T(n/3) + T(2n/3) + c·n.
Ahora las dos fracciones suman 1/3 + 2/3 = 1. El árbol ya no baja, como en la parte de abajo de la figura de la sección anterior: cada nivel completo suma c·n, y hay Θ(log n) niveles, porque la rama corta llega a tamaño 1 después de log₃ n niveles y la larga después de log n en base 3/2. El total es Θ(n log n), no O(n).
La columna T3 de la tabla anterior muestra justo eso: T3(n)/n sigue creciendo, y casi la misma cantidad cada vez que n se multiplica por 4. Es la huella de un logaritmo.
Hay que decir con precisión qué probamos. Con grupos de 3, este argumento solo da O(n log n), que no es mejor que ordenar. No demostramos que ningún algoritmo con grupos de 3 pueda ser lineal; de hecho, se conocen variantes modificadas que lo logran. Lo que falla es la cuenta directa. Con grupos de 7 también funciona: quedan 4 elementos por grupo, y 1/7 + 5/7 = 6/7 < 1. Grupos más grandes dan mejores fracciones, a cambio de más trabajo en hallar la mediana de cada grupo. El número 5 es el menor grupo impar con el que la cuenta directa cierra.
Idea clave. En T(n) ≤ T(αn) + T(βn) + c·n, todo depende de α + β. Si es menor que 1, los niveles decrecen y manda la raíz: Θ(n). Si es exactamente 1, todos los niveles pesan igual: Θ(n log n). Si es mayor que 1, el costo crece más rápido.
En C++
La partición en tres de select.h usa std::vector para los tres grupos. Reserva memoria en cada llamada, y
aquí eso no importa: queremos que el programa se parezca a la demostración. comparisons cuenta cada elemento
comparado con el pivote.
struct Parts {
    std::vector<int> less;
    std::vector<int> equal;
    std::vector<int> greater;
};

inline Parts partition3(const std::vector<int>& a, int pivot, long long& comparisons) {
    Parts parts;
    for (int x : a) {
        comparisons++;
        if (x < pivot) {
            parts.less.push_back(x);
        } else if (x > pivot) {
            parts.greater.push_back(x);
        } else {
            parts.equal.push_back(x);
        }
    }
    return parts;
}
La selección sigue el pseudocódigo línea por línea:
inline int median_of_medians(const std::vector<int>& a, long long& comparisons) {
    std::vector<int> medians = group_medians(a, comparisons);
    std::size_t middle = (medians.size() - 1) / 2;
    return select_linear(std::move(medians), middle, comparisons);
}

inline int select_linear(std::vector<int> a, std::size_t k, long long& comparisons) {
    assert(k < a.size());
    if (a.size() <= 5) {
        sort_group(a, comparisons);
        return a[k];
    }
    int pivot = median_of_medians(a, comparisons);
    Parts parts = partition3(a, pivot, comparisons);
    if (k < parts.less.size()) {
        return select_linear(std::move(parts.less), k, comparisons);
    }
    if (k < parts.less.size() + parts.equal.size()) {
        return pivot;
    }
    return select_linear(std::move(parts.greater), k - parts.less.size() - parts.equal.size(), comparisons);
}
select_linear recibe el arreglo por valor, y el std::move evita copiarlo al bajar. Como vieron la semana
pasada, copiar un std::vector en cada llamada cuesta Θ(n) por llamada. Aquí eso no cambiaría el orden, porque
esa llamada ya trabaja Θ(n), pero sí se paga en la práctica. La profundidad de la recursión es O(log n), porque
cada llamada baja el tamaño por lo menos a 7n/10 + 3, así que no hay peligro para la pila.
En C++.
std::nth_element(first, nth, last)reordena el rango para que ennthquede el valor que tendría si estuviera ordenado, con los menores o iguales antes y los mayores o iguales después. Sirve para k-ésimo menor y para medianas, y#include <algorithm>lo trae. No ordena los lados. El estándar pide costo lineal en promedio, no en el peor caso.
En la práctica: lo que usan las bibliotecas
Con esta teoría uno esperaría que las bibliotecas usen la mediana de medianas. No lo hacen. Este programa mide
cuatro formas de hallar la mediana en arreglos al azar: ordenar, std::nth_element, quickselect con pivote al
azar y nuestra select_linear. Las dos primeras columnas numéricas cuentan comparaciones, por elemento, y las
otras son tiempos.
$ build/select_bench
        n |  cmp.azar/n   cmp.mdm/n |   sort ms    nth ms   azar ms    mdm ms
   125000 |        6.48        8.27 |       6.8       0.8       1.2       5.3
   250000 |        3.67        8.35 |      14.5       2.0       2.5      11.1
   500000 |        4.12        8.36 |      32.7       3.1       5.4      24.4
  1000000 |        2.00        8.38 |      65.3       7.3      10.8      48.1
  2000000 |        3.31        8.41 |     141.9      14.9      22.0      91.2
  4000000 |        3.14        8.41 |     295.5      28.8      39.3     177.6
  8000000 |        3.62        8.43 |     616.5      63.7      95.7     365.8
Los tiempos dependen de la máquina y de la carga del momento. Se compiló con -O2, sin sanitizers, y cada dato
es la mediana de 7 corridas. Las comparaciones sí se repiten exactas con la misma semilla.
Tres cosas se leen en la tabla. La columna cmp.mdm/n se queda cerca de 8,4 al duplicar n, y eso es lo que el
teorema predice para las comparaciones: lineal, con una constante bastante mayor que 1. Los tiempos de mdm ms
también se duplican más o menos con n. Y aun así la mediana de medianas pierde: en estas corridas fue unas 5
a 8 veces más lenta que std::nth_element, y unas 4 veces más lenta que el pivote al azar. Solo a ordenar le
gana, y por menos de 2 veces. La columna cmp.azar/n salta entre 2 y 6,5 porque es una sola corrida con pivotes
al azar, pero queda por debajo de cmp.mdm/n. Parte de la diferencia de tiempo viene de nuestro programa, que
reserva vectores en cada llamada; una versión en el mismo arreglo recortaría esa parte, pero la cuenta de
comparaciones seguiría pagando la búsqueda del pivote.
Las bibliotecas prefieren un pivote simple. En el entorno del curso, con g++ 14, el código de std::nth_element
está en bits/stl_algo.h: elige el pivote como la mediana de tres elementos, cuenta la profundidad y, si pasa
de 2⌊log₂ n⌋ particiones, cambia a un método con heap que cuesta O(n log n). Por eso es rápido en casos comunes
y nunca es Θ(n²), pero en su peor caso no llega a ser lineal, y lo dice el estándar: promedio lineal. Eso es de
esta biblioteca, y otra podría hacerlo de otra forma. Una elección al azar del pivote protege de otro modo:
ninguna entrada fija es mala de antemano. El análisis del costo esperado necesita Probabilidad y no lo hacemos
aquí. Lo que sí se ve en la tabla es su costo por elemento, estable al duplicar n.
¿Entonces para qué sirve la mediana de medianas? Por dos razones. Prueba que el problema se puede resolver en O(n) en el peor caso, lo cual es una afirmación sobre lo que es posible. Y cuando alguien puede construir una entrada mala a propósito, como en un servidor que recibe datos de cualquiera, una garantía de peor caso vale algo. También sirve de seguro: algunas implementaciones cambian a un método con garantía si las particiones salen malas, que es lo mismo que hace aquí el heap.
En la práctica. Si necesitan la mediana en C++, usen
std::nth_element. Es una línea y rápida. La mediana de medianas se estudia por lo que enseña sobre recurrencias y garantías, no para reemplazarlo.
Multiplicar números grandes
Un entero de 64 bits se multiplica en una instrucción. Pero los números de la criptografía tienen miles de bits, y los de un cálculo de precisión arbitraria, millones de dígitos. Allí hay que escribir la multiplicación a mano, dígito por dígito. Un número es un arreglo de dígitos, y la pregunta es cuántos productos de un dígito por un dígito hacen falta para multiplicar dos números de n dígitos. Trabajaremos en base 10, porque se sigue mejor. Todo funciona igual en base 2³² o cualquier otra.
La escuela. Multiplicar cada dígito de x por cada dígito de y: n² productos de un dígito, más las sumas con acarreo, que no cambian el orden. Es Θ(n²).
Dividir en dos, primer intento. Partimos cada número en parte alta y parte baja, con m = n div 2 dígitos en la baja:
x = a·10^m + b, y = c·10^m + d.
Entonces
x·y = a·c·10^(2m) + (a·d + b·c)·10^m + b·d.
Multiplicar por una potencia de 10 solo mueve dígitos, y sumar cuesta O(n). Quedan cuatro productos de números de n/2 dígitos:
T(n) = 4T(n/2) + O(n).
Es el caso de las hojas del teorema maestro: n^(log₂ 4) = n² le gana a O(n), y T(n) = Θ(n²). Dividir no ganó nada. Es instructivo ver por qué: las cuatro multiplicaciones de n/2 dígitos cuestan 4·(n/2)² = n², lo mismo de antes. Dividir no ayuda por sí solo. Lo que haría falta es tener menos subproblemas.
Karatsuba
Karatsuba observó en 1960 que en realidad no necesitamos a·d y b·c por separado, sino su suma. Y esa suma se puede sacar de un solo producto más:
(a + b)(c + d) = a·c + a·d + b·c + b·d,
así que
a·d + b·c = (a + b)(c + d) − a·c − b·d.
Los productos a·c y b·d ya hacía falta calcularlos. Entonces bastan tres productos, y lo demás son sumas y restas, que cuestan O(n).
algoritmo karatsuba(x, y)
    n ← máximo entre los dígitos de x y los dígitos de y
    si n ≤ 3 entonces
        devolver multiplicar_escuela(x, y)
    fin si
    m ← n div 2
    a, b ← parte alta y parte baja de x, con m dígitos en la parte baja
    c, d ← parte alta y parte baja de y, con m dígitos en la parte baja
    p1 ← karatsuba(a, c)
    p2 ← karatsuba(b, d)
    p3 ← karatsuba(a + b, c + d)
    devolver p1·10^(2m) + (p3 - p1 - p2)·10^m + p2
fin algoritmo
La correctitud es una inducción fuerte sobre n que usa la identidad de arriba. Falta una sola condición: que los subproblemas sean más cortos, y eso nos lleva al caso base.
Por qué el caso base es n ≤ 3 y no n ≤ 1
La parte baja tiene ⌊n/2⌋ dígitos y la alta ⌈n/2⌉ dígitos. Pero a + b puede tener un dígito más: con n = 3, a = 99 y b = 9 se suman a 108, que tiene 3 dígitos. Es decir, en p3 los números miden hasta ⌈n/2⌉ + 1 dígitos. Con n = 3 eso da 3, y el tamaño no baja. Con n ≥ 4 sí baja, porque ⌈n/2⌉ + 1 ≤ n − 1. Por eso el caso base cubre hasta n = 3: así el tamaño baja siempre, sin necesidad de razonar sobre los valores.
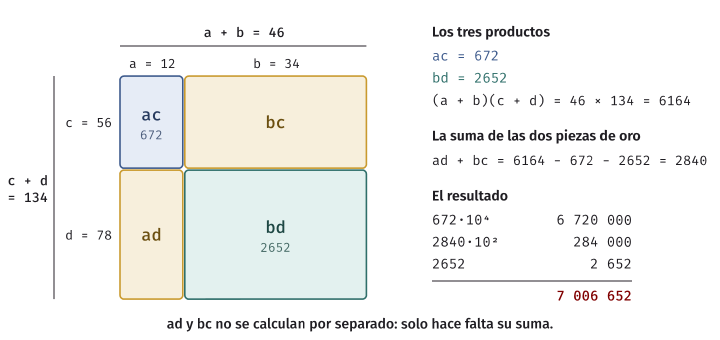
Sigamos una multiplicación, con 1234 × 5678. Aquí n = 4 y m = 2:
$ build/karatsuba_trace
a = 12, b = 34, c = 56, d = 78, m = 2
ac = 672
bd = 2652
(a + b)(c + d) = 46 x 134 = 6164
ad + bc = 6164 - 672 - 2652 = 2840
resultado = 7006652
la escuela da = 7006652
La cuenta final: 672·10⁴ + 2840·10² + 2652 = 6 720 000 + 284 000 + 2 652 = 7 006 652. Observen que a + b = 46 y c + d = 134. Este último tiene tres dígitos, un dígito más que sus partes, y el algoritmo lo trata sin problema.
El costo
La recurrencia exacta, con T(n) el mayor costo con números de a lo sumo n dígitos, es
T(n) ≤ 3T(⌈n/2⌉ + 1) + c·n para n ≥ 4.
Normalmente se escribe T(n) = 3T(n/2) + O(n). El teorema maestro, con a = 3 y b = 2, compara O(n) con n^(log₂ 3), y ganan las hojas: T(n) = Θ(n^(log₂ 3)). Como log₂ 3 = 1,58496…, escribimos Θ(n^1,585) como abreviatura. El número exacto es el logaritmo: 1,585 es su redondeo.
¿Y el “+1”? No cambia el resultado, y se puede demostrar con un cambio de variable. Sea S(n) = T(n + 3). Para n ≥ 1, como ⌈(n + 3)/2⌉ + 1 ≤ ⌈n/2⌉ + 3 y T no decrece,
S(n) = T(n + 3) ≤ 3T(⌈(n + 3)/2⌉ + 1) + c·(n + 3) ≤ 3T(⌈n/2⌉ + 3) + c·(n + 3) = 3S(⌈n/2⌉) + c·(n + 3).
S ya cumple una recurrencia sin el “+1”, con trabajo extra O(n), y sigue siendo O(n^(log₂ 3)). Como T(n) = S(n − 3) ≤ S(n), T también. En la otra dirección, con números sin partes nulas hay tres llamadas de al menos ⌊n/2⌋ dígitos cada una, y T(n) ≥ 3T(⌊n/2⌋), que da Ω(n^(log₂ 3)) en el peor caso.
De dónde sale la ganancia, en el árbol: el nivel i tiene 3^i nodos de tamaño n/2^i, con trabajo total c·n·(3/2)^i. Cada nivel pesa 3/2 del anterior, así que mandan las hojas, y son 3^(log₂ n) = n^(log₂ 3). Con cuatro subproblemas había 4^(log₂ n) = n² hojas. Bajar de 4 a 3 cambió el exponente, no solo una constante.
Idea clave. En a·T(n/b) + O(n) con muchas hojas, el exponente es log_b a. Ahorrar un solo subproblema cambia el exponente, y ese ahorro vale más que cualquier mejora del trabajo de combinar. La misma idea da el algoritmo de Strassen para matrices: 7 productos de tamaño n/2 en vez de 8.
En C++
karatsuba.h guarda los dígitos en un std::vector<int>, del menos significativo al más significativo, sin
ceros a la izquierda. El cero es el vector vacío. threshold es el umbral para usar la escuela, y debe ser al
menos 3 por lo que acabamos de ver.
inline Digits karatsuba(const Digits& x, const Digits& y, std::size_t threshold, long long& digit_products) {
    assert(threshold >= 3);
    std::size_t n = std::max(x.size(), y.size());
    if (x.empty() || y.empty()) {
        return {};
    }
    if (n <= threshold) {
        return school_multiply(x, y, digit_products);
    }
    std::size_t m = n / 2;
    Digits b = slice(x, 0, m);
    Digits a = slice(x, m, x.size());
    Digits d = slice(y, 0, m);
    Digits c = slice(y, m, y.size());

    Digits ac = karatsuba(a, c, threshold, digit_products);
    Digits bd = karatsuba(b, d, threshold, digit_products);
    Digits sums = karatsuba(add(a, b), add(c, d), threshold, digit_products);
    Digits middle = subtract(subtract(sums, ac), bd);  // ad + bc

    Digits result = add(add(shifted(ac, 2 * m), shifted(middle, m)), bd);
    trim(result);
    return result;
}
Los dos números pueden tener largos distintos. El algoritmo los parte a los dos en la misma posición, y una
parte alta vacía simplemente es cero. test_karatsuba compara el resultado con school_multiply en cientos de
pares al azar de largos iguales y distintos, también con todos nueves, y con productos que caben en 64 bits,
calculados por el procesador.
¿Se nota en la práctica?
Hay dos preguntas distintas. La primera es si la teoría predice bien, y se responde con un conteo que no depende de la máquina: productos de un dígito por un dígito, con la escuela y con Karatsuba de umbral 3, en números al azar.
$ build/karatsuba_count
       n        escuela    razon      karatsuba    razon
      16            256     0.00            120     0.00
      32           1024     4.00            453     3.77
      64           4096     4.00           1313     2.90
     128          16384     4.00           3864     2.94
     256          65536     4.00          12038     3.12
     512         262144     4.00          35686     2.96
    1024        1048576     4.00         107748     3.02
    2048        4194304     4.00         320861     2.98
    4096       16777216     4.00         962380     3.00
    8192       67108864     4.00        2895612     3.01
   16384      268435456     4.00        8695871     3.00
   32768     1073741824     4.00       26057885     3.00
   65536     4294967296     4.00       78165329     3.00
En la escuela, al duplicar n los productos se multiplican exactamente por 4. En Karatsuba, por cerca de 3, que es la razón que predice n^(log₂ 3) porque 2^(log₂ 3) = 3. Con n = 65536 ya la diferencia es de casi 55 veces, porque 4294967296 / 78165329 ≈ 54,9. Y no es exactamente 3 porque los números con dígito de más cambian un poco el tamaño de los subproblemas.
La segunda pregunta es cuándo gana en tiempo, y es una pregunta muy distinta, porque un producto de la escuela
es una instrucción dentro de un ciclo sobre un arreglo, mientras que Karatsuba reserva vectores, copia, suma y
resta. Este programa mide las dos con -O2, sin sanitizers:
$ build/karatsuba_bench 262144
microsegundos por multiplicacion
       n      escuela     umbral 3   umbral 128    esc/u3  esc/u128
      16          0.2          5.6          0.2      0.04      0.95
      32          0.6         17.6          0.6      0.04      0.99
      64          2.2         60.8          2.2      0.04      0.99
     128          9.9        188.2          9.9      0.05      1.01
     256         33.4        575.2         35.3      0.06      0.95
     512        136.3       1777.2        114.8      0.08      1.19
    1024        528.8       4812.1        369.8      0.11      1.43
    2048       1918.8      14877.1       1162.2      0.13      1.65
    4096       7401.4      52581.2       4370.2      0.14      1.69
    8192      32221.0     145868.5      11165.9      0.22      2.89
   16384     120437.3     381234.3      38112.1      0.32      3.16
   32768     599088.0    1155659.7      92233.5      0.52      6.50
   65536    2330401.8    4419787.0     321476.4      0.53      7.25
  131072    9431325.0   12666355.1     789361.8      0.74     11.95
  262144   58873990.7   57706431.0    4047510.4      1.02     14.55

n = 16384 con distintos umbrales
  umbral     microseg
       3     563765.5
       8     203841.3
      16     144803.1
      32      94903.5
      64      61352.2
     128      59770.8
     256      70581.4
     512      73600.5
    1024      81137.0
Hay que leer esta tabla con cuidado, porque la máquina estaba compartida con otros procesos y los tiempos se mueven bastante, sobre todo con n pequeño y con n muy grande. Hicimos dos corridas completas, y esto es lo que coincidió en las dos:
- Karatsuba con umbral 3 pierde durante mucho tiempo. Con n = 16384 todavía era unas 3 veces más lento que
la escuela (
esc/u3de 0,32 en las dos corridas). La razón sube al duplicar n, como debe ser, porque la escuela crece por 4 y Karatsuba por cerca de 3. Solo llega a 1 cerca del final: en esta corrida, en n = 262144, con 1,02. En la otra corrida fue 1,07 en n = 131072 y 1,31 en n = 262144. El cruce es real, pero está en más de cien mil dígitos. - Con umbral 128 el cuadro cambia. Hasta n = 128 ese programa corre el mismo código de la escuela, así que
esc/u128solo mide ruido. Entre 256 y 1024 las dos corridas no se ponen de acuerdo, con valores de 0,91 a 2,29, y no afirmamos nada. Desde n = 2048 gana en las dos corridas, con razón de 1,65 o más, y con n = 262144 es unas 14 veces más rápido. - El umbral importa mucho, y su valor exacto poco. Con n = 16384, pasar de umbral 3 a umbral 128 reduce el tiempo unas 9 a 14 veces, y entre 64 y 512 las dos corridas dan tiempos muy parecidos.
Por eso, en este programa y en esta máquina, no tiene sentido hablar de “el punto de cruce” con precisión de un dígito. Lo que sí podemos decir es que la mezcla gana claramente desde unos pocos miles de dígitos, y que Karatsuba puro tardaría más de cien mil en empatar.
Por eso toda implementación seria cambia a la multiplicación de la escuela cuando n es pequeño: el costo de
Karatsuba tiene una constante más grande, y en números cortos pierde. La segunda tabla muestra el efecto de
elegir ese umbral. Nótese que estos números son de esta implementación: en base 10, con un std::vector por
cada subproblema. Una implementación en base 2⁶⁴ sobre un buffer reutilizado tendrá otro punto de cruce, así que
el número exacto no se traslada. Lo que se traslada es el fenómeno: a partir de cierto tamaño gana el
exponente menor, y por debajo gana la constante menor.
En la práctica. Las bibliotecas de enteros grandes, como GMP, combinan varios algoritmos según el tamaño: la multiplicación de la escuela con números chicos, Karatsuba después, y métodos con mejor exponente para números enormes, como Toom-Cook y los basados en la transformada rápida de Fourier. Karatsuba fue solo el primero en bajar de n².
El par más cercano
Tenemos n puntos en el plano, con n ≥ 2, y queremos dos de ellos a la menor distancia posible. Es un problema que aparece en sistemas de información geográfica, en la detección de colisiones y al agrupar datos.
Dos decisiones de entrada, que se conservan en todo este capítulo:
- Los puntos pueden repetirse. Dos posiciones de la entrada con el mismo punto forman un par a distancia 0. La palabra “par” significa dos posiciones distintas.
- Trabajaremos con el cuadrado de la distancia, d²(p, q) = (p.x − q.x)² + (p.y − q.y)². Para comparar da lo mismo, porque la raíz es creciente, y así no hay decimales ni errores de redondeo. Con δ escribimos una distancia, y con δ² su cuadrado, que es lo único que el programa guarda.
La fuerza bruta mira todos los pares, en Θ(n²). ¿Se puede hacer mejor?
En una dimensión es fácil: al ordenar, el par más cercano está en dos vecinos del orden, así que ordenar y mirar los vecinos cuesta Θ(n log n). En dos dimensiones eso falla. Ordenar por x o por y deja como vecinos a puntos que están muy lejos en la otra coordenada, y separa puntos muy cercanos. Divide y vencerás lo resuelve.
Dividir
Se ordenan los puntos por x, una sola vez, y luego se parten por posición en ese orden: la mitad izquierda son los primeros, y la derecha, los demás. Sea mid = n div 2, y sea ℓ la x del punto en la posición mid. Entonces todo punto de la izquierda tiene x ≤ ℓ, y todo punto de la derecha tiene x ≥ ℓ. Dicho de otro modo, x = ℓ es una línea vertical que separa las mitades, y puede haber puntos sobre ella en las dos mitades. Partir por posición garantiza que los tamaños sean n/2, sin importar lo que pase con las x.
Error común. Partir por valor: “la izquierda son los que tienen x < ℓ”. Con todos los puntos sobre una vertical, la izquierda queda vacía y la derecha los tiene todos, y la recursión nunca termina. Partan por posición.
Se resuelve cada mitad, y salen δ_I y δ_D. Sea δ = mín(δ_I, δ_D). Quedan solo los pares que cruzan, con un punto en cada mitad. Son hasta n²/4, y mirarlos todos daría T(n) = 2T(n/2) + Θ(n²) = Θ(n²): no se ganó nada.
La franja
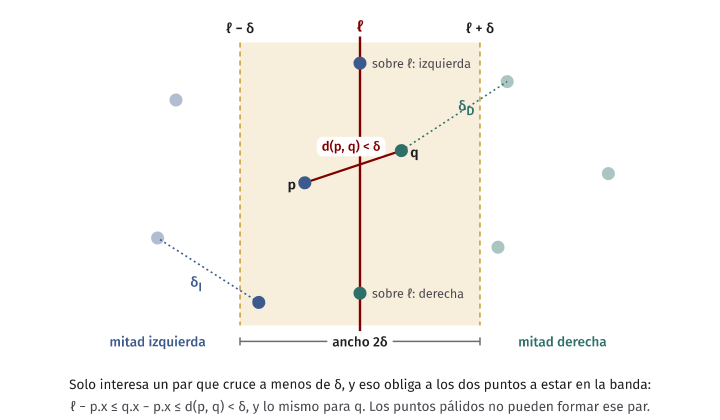
Solo nos interesa un par que cruce a distancia menor que δ. Si p está a la izquierda y q a la derecha, con d(p, q) < δ, entonces
ℓ − p.x ≤ q.x − p.x ≤ d(p, q) < δ.
La primera desigualdad vale porque q.x ≥ ℓ. La misma cuenta da q.x − ℓ < δ. Entonces los dos puntos están en la franja: el conjunto de puntos con |x − ℓ| < δ, una banda de ancho 2δ alrededor de la línea. Con cuadrados, la condición es (x − ℓ)² < δ².
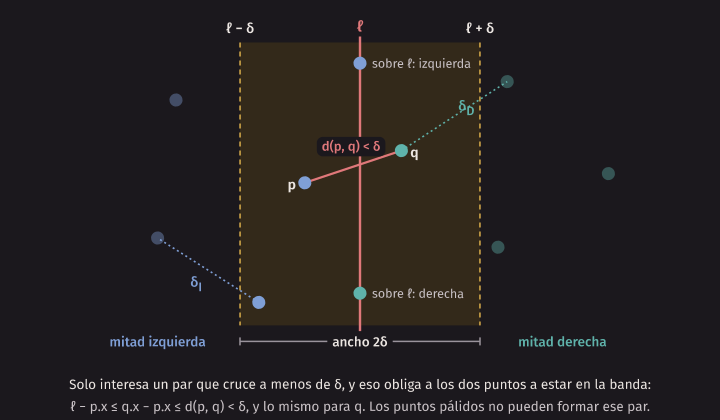
Podría parecer que basta mirar, a cada lado, el punto más cercano a la línea en x. No basta: el par puede estar
en cualquier lugar de la franja. El siguiente es el segundo experimento de strip_demo. Los más cercanos a la
línea, uno por lado, son (−1, 100) y (1, −100), a distancia² 40004, y la respuesta es el par (−2, 0), (2, 0).
Están más lejos de la línea, pero a la misma altura. (En la salida, I y D marcan la mitad de cada punto.)
linea x = 1
mejor izquierda = 10001, mejor derecha = 10001, delta^2 = 10001
franja por y: (1,-100)D (-2,0)I (2,0)D (-1,100)I
distancia^2 entre los mas cercanos a la linea: 40004
fuerza bruta = 16
La franja no alcanza por sí sola: toda la entrada puede caer dentro, como en el ejemplo. El truco es el orden por y.
Lo que dice el empaquetado
Ordenemos la franja por y: S[0], S[1], … Los empates en y se resuelven como sea. La afirmación central es que cada punto solo necesita compararse con los 7 que le siguen. Fijamos el número 7, y demostramos exactamente ese.
Lema (los 7 siguientes). Sea δ > 0. Supongamos que dos puntos cualesquiera de la mitad izquierda están a distancia al menos δ, y lo mismo con la mitad derecha. Sea S la franja |x − ℓ| < δ, ordenada por y con cualquier desempate. Si i < j y d(S[i], S[j]) < δ, entonces j − i ≤ 7.
Técnica: principio del palomar, cubriendo una caja con cuadrados pequeños.
Paso 1: todos caen en una caja. Sean p = S[i] y q = S[j]. Como la distancia es menor que δ, q.y − p.y < δ. Todos los puntos S[i], S[i+1], …, S[j] tienen y entre p.y y q.y, por el orden, así que su y está en [p.y, p.y + δ). Además están en la franja. Esos puntos forman el conjunto C, con j − i + 1 puntos.
Paso 2: separarlos por mitad, no por geometría. Cada punto de C pertenece a una de las dos mitades de la entrada. Un punto de la mitad izquierda tiene x ≤ ℓ, y por estar en la franja x > ℓ − δ. Entonces cae en el cuadrado cerrado Q_I = [ℓ − δ, ℓ] × [p.y, p.y + δ], de lado δ. Un punto de la mitad derecha cae en Q_D = [ℓ, ℓ + δ] × [p.y, p.y + δ]. Un punto sobre la línea se cuenta en el cuadrado de su mitad. Dos puntos iguales, uno de cada mitad, están uno en cada cuadrado.
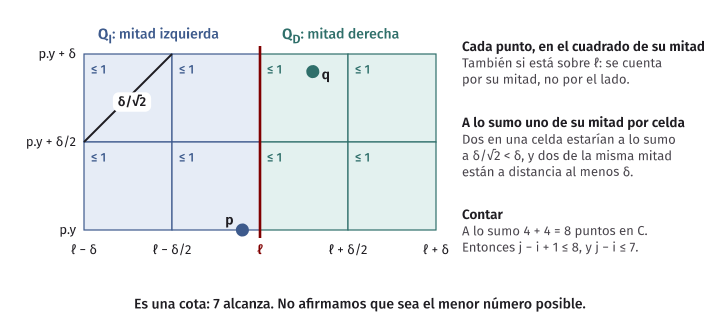
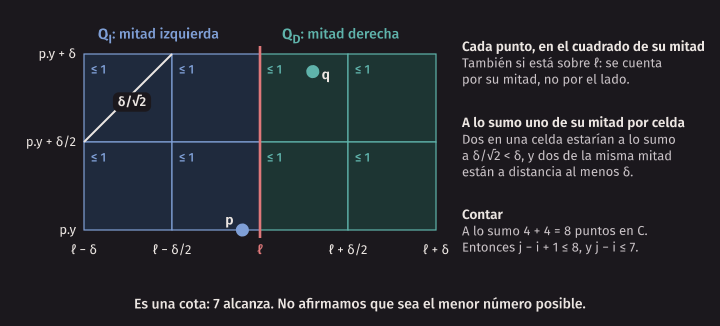
Paso 3: a lo sumo uno por celda. Dividimos Q_I en 4 celdas cerradas de lado δ/2. Dos puntos en una misma celda están a distancia a lo sumo la diagonal, (δ/2)·√2 = δ/√2, y eso es menor que δ porque δ > 0. Pero dos puntos de la mitad izquierda están a distancia al menos δ, por hipótesis. Entonces cada celda tiene a lo sumo un punto de la mitad izquierda. A un punto en el borde de dos celdas se le asigna cualquiera de ellas: lo que importa es que las 4 celdas cubren Q_I. Hay a lo sumo 4 puntos de la mitad izquierda en C. Lo mismo vale para Q_D y la mitad derecha.
Paso 4: contar. C tiene a lo sumo 4 + 4 = 8 puntos, así que j − i + 1 ≤ 8, y j − i ≤ 7. ∎
Tres observaciones sobre esta demostración, que es donde suelen estar los errores:
- Puntos sobre la línea. No hubo que decir nada especial, porque clasificamos por mitad y no por el lado geométrico. Cuando todos los puntos están sobre una vertical, ℓ es esa vertical, la franja los contiene a todos si δ > 0, y el lema sigue valiendo.
- Puntos repetidos. Si hay dos iguales dentro de una mitad, esa mitad da δ = 0. Entonces la franja queda vacía, porque |x − ℓ| < 0 es imposible, y la respuesta 0 ya está lista. No se necesita el lema. Si hay dos iguales uno en cada mitad, con δ > 0, el lema aplica. El par está a distancia 0 < δ, y como ambos tienen x = ℓ, están en la franja.
- La franja es estricta. Usamos |x − ℓ| < δ. Un punto con |x − ℓ| = δ exacto queda afuera sin riesgo, porque solo nos interesan pares estrictamente mejores que δ.
¿Hace falta que sea 7? El lema dice que 7 alcanza, y eso es todo lo que necesitamos: una constante. Otros
libros cuentan otra cifra, porque cubren la caja de otra forma. No afirmamos que 7 sea el menor número posible.
test_strip revisó 36000 conjuntos de puntos, con coordenadas de distintos rangos y con verticales, y el mayor
salto observado fue 3. Eso no prueba nada sobre el peor caso, solo que el lema no falló. Pero mirar solo al
siguiente sí está mal, y mirar a los 2 siguientes también. Estos son los experimentos 3 y 4 de strip_demo:
linea x = 0
mejor izquierda = 2564, mejor derecha = 65, delta^2 = 65
franja por y: (-1,0)I (8,1)D (0,2)D
solo con el siguiente: 65
con los 7 siguientes: 5
fuerza bruta = 5

linea x = 1
mejor izquierda = 12301, mejor derecha = 11908, delta^2 = 11908
franja por y: (0,0)I (-99,50)I (99,51)D (1,99)D
con los 1 siguientes: 11908
con los 2 siguientes: 11908
con los 3 siguientes: 9802
fuerza bruta = 9802
En el primero, el punto (−1, 0) tiene como siguiente en la franja a (8, 1), que está lejos, y el que le interesa, (0, 2), viene después. En el segundo hay dos puntos interpuestos.
El algoritmo
Falta un último detalle: cómo tener la franja ordenada por y sin pagar un ordenamiento en cada nivel. Pedimos que cada llamada, además de la respuesta, deje su rango ordenado por y. Las dos mitades vuelven ordenadas, y al combinar basta con mezclarlas, igual que en mergesort, en Θ(n). La franja se saca de esa lista ordenada con una pasada, y conserva el orden.
algoritmo par_mas_cercano(P)
    ordenar P por x
    devolver resolver(P, 0, |P|)
fin algoritmo

algoritmo resolver(P, lo, hi)
    si hi - lo ≤ 3 entonces
        d ← el menor d²(P[i], P[j]) entre todos los pares del rango
        ordenar P[lo .. hi - 1] por y
        devolver d
    fin si
    mid ← (lo + hi) div 2
    linea ← P[mid].x
    d ← mín(resolver(P, lo, mid), resolver(P, mid, hi))
    mezclar por y las dos partes ordenadas, dejando P[lo .. hi - 1] ordenado por y
    S ← lista vacía
    para i desde lo hasta hi - 1 hacer
        si (P[i].x - linea)² < d entonces
            agregar P[i] al final de S
        fin si
    fin para
    para i desde 0 hasta |S| - 1 hacer
        para j desde i + 1 hasta mín(i + 7, |S| - 1) hacer
            d ← mín(d, d²(S[i], S[j]))
        fin para
    fin para
    devolver d
fin algoritmo
Con dos o tres puntos el caso base no calcula nada raro. Con al menos 4 puntos, cada mitad tiene al menos 2, y por eso d está siempre bien definido antes de la franja. Dentro del segundo ciclo, d puede bajar mientras se recorre. Eso no altera el conjunto S ni la demostración: S se construyó antes, con el d de las mitades.
Error común. Leer
lineadespués de las llamadas recursivas. Esas llamadas reordenan el rango por y, así que después P[mid] es otro punto, y la línea queda en cualquier lado. El programa sigue pasando muchos casos, porque el error solo se nota cuando la respuesta cruza justo en un nivel donde la línea quedó mal. Guarden la línea antes.
Teorema (correctitud). resolver(P, lo, hi) devuelve la menor distancia² entre pares del rango, y deja el
rango ordenado por y.
Técnica: inducción fuerte sobre el tamaño del rango.
Base. Con a lo sumo 3 puntos, se miran todos los pares y se ordena.
Paso. Antes de las llamadas el rango está ordenado por x, con todo lo de la izquierda en x ≤ ℓ y todo lo de la derecha en x ≥ ℓ, por partir por posición. Por hipótesis, las llamadas devuelven δ_I² y δ_D², y dejan cada parte ordenada por y. Tras la mezcla el rango está ordenado por y. Sea δ² el menor de los dos valores, y D² la verdadera respuesta del rango. Todo valor que el algoritmo mira es la distancia² de un par real, así que el resultado nunca baja de D². Falta ver que llegue a D².
- Si D = δ, entonces D² ya es el valor inicial de d, y el resultado es D².
- Si D < δ, el par (p, q) que da D no puede estar dentro de una mitad, porque ahí todos los pares están a distancia al menos δ. Entonces cruza, y por lo que vimos, los dos puntos están en la franja. En particular δ > 0. Las hipótesis del lema se cumplen, y entonces están a lo sumo a 7 posiciones de S. El ciclo los compara y d llega a D². ∎
Costo. Ordenar por x una vez cuesta Θ(n log n). En resolver, la mezcla, la construcción de S y el ciclo
doble, con a lo sumo 7 vecinos por punto, son Θ(n). Entonces
T(n) = 2T(n/2) + Θ(n) = Θ(n log n),
y el total es Θ(n log n).
Error común. Ordenar la franja por y en cada nivel, en lugar de mezclar. Es más fácil de programar y parece inofensivo, pero el trabajo de combinar pasa a Θ(n log n) en el peor caso, cuando la franja contiene casi todo: T(n) = 2T(n/2) + Θ(n log n) = Θ(n log² n), como vimos la semana pasada. Ese factor log n de más no se ve en un caso pequeño, y sí en la cuenta.
Siguiendo un nivel
Tomemos diez puntos, ya ordenados por x: (1,9), (2,3), (3,7), (4,1), (5,5), (6,4), (7,10), (8,8), (9,2), (10,6).
Este es el primer experimento de strip_demo, que calcula el primer nivel por fuerza bruta.
$ build/strip_demo
linea x = 6
mejor izquierda = 8, mejor derecha = 5, delta^2 = 5
franja por y: (4,1)I (6,4)D (5,5)I (8,8)D (7,10)D
  posiciones 0 y 1: distancia^2 13
  posiciones 0 y 2: distancia^2 17
  posiciones 0 y 3: distancia^2 65
  posiciones 0 y 4: distancia^2 90
  posiciones 1 y 2: distancia^2 2  mejora
  posiciones 1 y 3: distancia^2 20
  posiciones 1 y 4: distancia^2 37
  posiciones 2 y 3: distancia^2 18
  posiciones 2 y 4: distancia^2 29
  posiciones 3 y 4: distancia^2 5
respuesta = 2, fuerza bruta = 2
Paso a paso:
| Paso | Qué se hace | Resultado |
|---|---|---|
| Dividir | mid = 5 | ℓ = 6. Izquierda: x de 1 a 5. Derecha: x de 6 a 10 |
| Izquierda | mejor distancia² | 8, por ejemplo (1,9) y (3,7) |
| Derecha | mejor distancia² | 5, con (7,10) y (8,8) |
| δ² | el menor | 5 |
| Franja | (x − 6)² < 5 | x de 4 a 8: 5 puntos |
| Por y | se mezclan | (4,1), (6,4), (5,5), (8,8), (7,10) |
| Comparar | cada uno con los siguientes | (6,4) y (5,5): distancia² 2, mejora |
| Respuesta | 2 |
La respuesta es un par que cruza y que no se habría visto dentro de ninguna mitad.
Los casos raros, uno por uno
Conviene pasar a mano estos casos antes de programar:
| Entrada | Qué pasa |
|---|---|
| Dos puntos | Caso base. Es la respuesta |
| Todos iguales | δ = 0 en las mitades. La franja queda vacía. La respuesta es 0 |
| Un par repetido, cada punto en una mitad | δ > 0. Los dos están sobre la línea, en la franja, a 0 |
| Todos sobre una vertical | ℓ es esa vertical. Todos en la franja. Por posición, las mitades siguen midiendo n/2. La respuesta sale con la lista ordenada por y |
| Todos sobre una horizontal | Las y empatan. Cualquier desempate sirve: el lema lo permite |
| Dos columnas pegadas | La franja contiene casi todo en cada nivel, y ahí 7 vecinos por punto es lo que mantiene el costo |
Sigamos a mano el caso de la vertical, porque ahí se ve que el desempate del orden por x no importa. Son 8
puntos con x = 5 y alturas 0, 3, 10, 13, 20, 23, 30 y 33. Todas las x empatan, así que cualquier orden es un
orden válido por x, y test_strip comprueba estas dos posibilidades:
| Primer orden posible | Segundo orden posible | |
|---|---|---|
| Izquierda (alturas) | 0, 10, 20, 30 | 0, 3, 10, 13 |
| Derecha (alturas) | 3, 13, 23, 33 | 20, 23, 30, 33 |
| ℓ | 5 | 5 |
| δ² | 100 | 9 |
| Franja | los 8 puntos | los 8 puntos |
| Lo que encuentra la franja | 9, entre vecinos que cruzan | nada menor que 9 |
| Respuesta | 9 | 9 |
En el primer orden las mitades se intercalan en altura, y la respuesta sale de la franja. En el segundo está dentro de cada mitad, y la franja no mejora nada. El lema no supone ninguno de los dos.
En la práctica. Con punto flotante hay que pensar en errores de redondeo, y por eso aquí conviene el cuadrado en enteros. Antes de declarar un tipo, calculen el mayor valor posible de cada resta, cada producto y cada suma con los límites de su problema. El laboratorio les pide justo esa cuenta.
El código de la semana
code/week-03/
├── select.h              partir en tres, quickselect, mediana de medianas
├── quickselect_trace.cpp sigue quickselect y cuenta su peor caso
├── mom_trace.cpp         sigue una vuelta de la mediana de medianas
├── pivot_bound.cpp       elementos a cada lado del pivote
├── recurrence_table.cpp  las recurrencias con grupos de 5 y de 3
├── select_bench.cpp      compara selección: comparaciones y tiempos
├── karatsuba.h           dígitos, la escuela y Karatsuba
├── karatsuba_trace.cpp   sigue 1234 × 5678
├── karatsuba_count.cpp   cuenta productos de dígitos
├── karatsuba_bench.cpp   mide la escuela contra Karatsuba
├── strip.h               herramientas de fuerza bruta para la franja
├── strip_demo.cpp        cuatro experimentos con la franja
├── bench.h               medidor de tiempos del curso
├── test_select.cpp       pruebas de selección
├── test_karatsuba.cpp    pruebas de la multiplicación
├── test_strip.cpp        pruebas del lema de la franja
└── lab/closest_pair/     el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Las pruebas comprueban lo que este
capítulo afirma, con assert: las fórmulas exactas de los conteos, la cota del lema para n hasta 400, la
respuesta de Karatsuba frente a la escuela, y los ejemplos de la franja. make bench corre las mediciones con
-O2 y sin sanitizers.
$ make test
test_select: ok
test_karatsuba: ok
test_strip: ok (mayor salto observado: 3)
Todas las pruebas pasaron.
strip.h usa fuerza bruta a propósito, y solo calcula un nivel de la división. Sirve para revisar las
afirmaciones del capítulo, y no resuelve el laboratorio. Allí les toca escribir el algoritmo.
El laboratorio
En lab/closest_pair está el enunciado, un esqueleto y los casos.
cd lab/closest_pair
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Los casos grandes se generan con los programas casos/gen_NN.cpp. Sugerencia para trabajar: escriban la fuerza
bruta primero, y úsenla como referencia contra la versión rápida en muchas entradas pequeñas al azar, con pocos
valores distintos para que salgan repetidos y empates. Compilen con sanitizers mientras desarrollan, y recuerden
que el juez compila con -O2 y sin ellos.
Resumen
- El k-ésimo menor se halla sin ordenar. Quickselect parte y sigue por un solo lado, y cuesta Θ(n²) en el peor caso, porque todo depende del pivote. Un arreglo ordenado con k = n − 1 hace exactamente n(n + 1)/2 − 1 comparaciones.
- La mediana de medianas con grupos de 5 garantiza al menos 3n/10 − 3 elementos ≤ p y otros tantos ≥ p. Partir en tres hace que la cota valga con repetidos, y deja a lo sumo 7n/10 + 3 en cada lado.
- La recurrencia T(n) ≤ T(⌈n/5⌉) + T(⌊7n/10⌋ + 3) + c·n da O(n), porque 1/5 + 7/10 < 1. El teorema maestro no aplica, porque los subproblemas tienen distinto tamaño. Se usa el árbol de recursión y se demuestra por inducción, con un rango de casos base que absorbe los redondeos.
- Con grupos de 3 las fracciones suman 1 y esta recurrencia da Θ(n log n). Por eso 5 y no 3.
- En la práctica, las bibliotecas prefieren un pivote simple o al azar.
std::nth_elementes lineal en promedio. - Karatsuba multiplica con tres productos en lugar de cuatro, porque a·d + b·c = (a + b)(c + d) − a·c − b·d. T(n) = 3T(n/2) + O(n) = Θ(n^(log₂ 3)) ≈ Θ(n^1,585). Por el dígito extra de a + b, el caso base llega a n = 3.
- Reducir subproblemas cambia el exponente. En la práctica se pasa a la multiplicación de la escuela con n pequeño, porque la constante de Karatsuba es mayor, y el punto de cruce depende de la implementación.
- El par más cercano se divide por posición en el orden por x. Solo importan los pares que cruzan, a distancia menor que δ, y estos están en la franja |x − ℓ| < δ.
- En la franja ordenada por y, cada punto se compara con los 7 siguientes. Se demuestra cubriendo con 8 celdas de lado δ/2, clasificando cada punto por su mitad, lo que cubre puntos sobre la línea y puntos repetidos.
- Con el orden por y mantenido al mezclar, el total es Θ(n log n). Ordenar la franja en cada nivel da Θ(n log² n).
Ejercicios
- ¿Qué entrada hace que quickselect con el primer elemento como pivote cueste Θ(n²)? Den una para k = n − 1 y
otra para k = 0, y cuenten las comparaciones exactas con la convención de
partition3. ¿Qué pasa con un arreglo donde todos son iguales? - Demuestren, sin mirar los apuntes, que la mediana de medianas deja al menos 3n/10 − 3 elementos a cada lado. Luego calculen para n = 100 y n = 103 cuántos promete el lema exactamente, antes de redondear.
- Comprueben por inducción que T(n) ≤ T(n/5) + T(7n/10) + n da T(n) ≤ 10n. ¿Cuál es la constante si el trabajo extra es 3n en lugar de n?
- Repitan la cuenta del lema con grupos de 7 y escriban la recurrencia. ¿Da O(n)? Repítanla con grupos de 4 y mediana inferior, y expliquen por qué el lado que se debe contar es el peor de los dos. ¿Qué suman las fracciones?
- Modifiquen
select_linearpara que parta solo en dos grupos: menores y mayores o iguales. Córranla con un arreglo de elementos iguales, cuenten las comparaciones y expliquen el resultado usando el lema. Después digan qué línea de la demostración deja de valer. - Si un algoritmo divide en 7 productos de tamaño n/2 con trabajo extra Θ(n²), ¿cuál es su costo? ¿Y con 8 productos? Comparen los exponentes, y digan por qué el trabajo extra no decide aquí.
- Multipliquen a mano con Karatsuba 3141 × 5926, hasta llegar a productos de a lo sumo 3 dígitos. Cuenten cuántos productos de un dígito por un dígito usaron, y compárenlos con los 16 de la escuela. ¿Qué llamada tiene un dígito de más?
- Cambien
karatsuba_bench.cpppara buscar el mejor umbral con n = 4096 en su propia máquina. Corran tres veces. ¿Coincide con el de estos apuntes? ¿Qué cambiaría en el umbral siaddysubtractreservaran menos memoria? - ¿Por qué no basta con mirar los puntos más cercanos a la línea en x? Construyan un ejemplo propio de 6
puntos, distinto al de los apuntes, y compruébenlo con la fuerza bruta de
strip.h. - En la entrada (−99, 15), (−20, 98), (0, 0), (1, 99), (25, 1), (99, 70), con la línea en x = 1, calculen δ² y la franja ordenada por y. Encuentren un par de la franja a menos de δ y a 5 posiciones. Revisen si eso contradice el lema, y si ese par es la respuesta final.
- El lema se demostró con cuadrados de lado δ/2. ¿Por qué no sirve con celdas de lado δ? ¿Se puede deducir algo con celdas de lado δ/√2? Escriban la cuenta que resulta.
- Implementen el par más cercano en el laboratorio, y midan con n y 2n, usando
casos/gen_18.cppcon n cambiado. Luego reemplacen la mezcla por un ordenamiento en cada nivel, y comparen. ¿Se nota el log n de más con estos tamaños? Digan cómo midieron.