Apuntes · Capítulo 4Greedy y grafos
Cotas inferiores y primeros greedy
Cotas inferiores y primeros greedy
Las últimas dos semanas diseñamos algoritmos cada vez más rápidos dividiendo el problema: mergesort ordena en Θ(n log n), la selección corre en tiempo lineal, el par más cercano baja de Θ(n²) a O(n log n). Esa racha deja una pregunta natural: ¿se puede ordenar más rápido todavía? ¿Hay algún truco de divide y vencerás que todavía no se nos ocurrió y que ordene en Θ(n log log n)?
Esta semana abre la parte del curso sobre greedy y grafos. La primera sesión responde esa pregunta con un tipo de resultado que no hemos visto: una cota inferior, que no habla de un algoritmo sino de todos los algoritmos posibles, incluidos los que nadie ha inventado. Si un algoritmo ordena comparando, tiene entradas en las que hace al menos log₂(n!) comparaciones, y eso es Ω(n log n). Luego veremos dos maneras de vivir con ese resultado. Counting sort lo esquiva porque no compara. Quicksort con pivote al azar se queda dentro de la cota, y lo interesante es otra cosa: por qué el azar lo protege de las entradas malas.
La segunda sesión entra de lleno en greedy, el tema central de esta parte del curso. Es la técnica más fácil de programar y la más fácil de equivocarse: se toma la opción que hoy parece mejor y no se vuelve atrás. Veremos tres reglas razonables que dan respuestas equivocadas, una regla que siempre acierta, y la forma de demostrarlo: el argumento de intercambio.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Qué es una cota inferior, Ordenar comparando: el modelo, Greedy: decidir sin volver atrás, Selección de intervalos y Tres reglas que fallan.
En clase: Sesión A, de El árbol de decisiones a Counting sort: esquivar la cota sin contradecirla, y Quicksort con pivote al azar ✂️ si hay tiempo. Sesión B, de La regla correcta: la que termina antes a El patrón de una demostración greedy.
Después de clase: el Resumen y los Ejercicios, para repasar, y los resúmenes de las semanas 1 a 3 para la Práctica 1. Opcional: El código de la semana, el problema de laboratorio y Quicksort con pivote al azar ✂️ si no se vio en clase. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, sec. 1.5 (Quicksort). CLRS, capítulos Sorting in Linear Time y Quicksort, 4.ª edición. Sesión B: Erickson, secs. 4.1 (Storing Files on Tape), 4.2 (Scheduling Classes) y 4.3 (General Pattern). CLRS, capítulo Greedy Algorithms, 4.ª edición. Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-04. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El problema opcional de laboratorio está enlab/class_scheduley tiene su propiomake test.
Qué es una cota inferior
Cuando decimos “mergesort cuesta O(n log n)” damos una cota superior de un algoritmo: este programa nunca se pasa de tanto. Para demostrarla basta analizar ese programa.
Una cota inferior (lower bound) es una afirmación sobre un problema: ningún algoritmo de cierto tipo puede hacerlo mejor en el peor caso. No basta con probar diez algoritmos y ver que todos son lentos, ni con decir “no se me ocurre nada mejor”. Hay que dar un argumento que valga también para los programas que todavía no existen.
Eso parece imposible, y sin precisar más lo es. Hace falta fijar dos cosas:
- Qué puede hacer el algoritmo, es decir, el modelo. Si no decimos qué operaciones tiene permitidas, no hay nada que acotar.
- Qué se cuenta. En el modelo se cuenta una operación, y el costo real del programa es por lo menos esa cuenta.
Empecemos con un ejemplo pequeño, para ver la forma del argumento.
Afirmación. Todo algoritmo que halla el máximo de n números distintos comparándolos de a dos hace al menos n − 1 comparaciones.
Técnica. Contar lo que tiene que ocurrir para que la respuesta esté justificada, sin mirar qué algoritmo es.
Supongamos que el algoritmo responde que el máximo es m. Tomemos otro elemento x ≠ m. Si x nunca perdió una comparación, el algoritmo no tiene ninguna información que lo distinga de un máximo: podríamos aumentar x a un valor mayor que todos sin cambiar ninguna respuesta que el algoritmo recibió, y como las respuestas son las mismas, volvería a contestar m, ahora equivocado. Así que cada uno de los n − 1 elementos distintos de m perdió por lo menos una vez. Cada comparación tiene un solo perdedor. Por lo tanto hay al menos n − 1 comparaciones. ∎
El ciclo de siempre, que recorre el arreglo guardando el mayor, hace exactamente n − 1. La cota inferior y el algoritmo coinciden, y sabemos que no hay nada que mejorar: en este modelo, el problema está cerrado.
Idea clave. Una cota superior se demuestra exhibiendo un algoritmo. Una cota inferior se demuestra con un argumento sobre todos los algoritmos del modelo. Cuando ambas coinciden, el problema queda resuelto en ese modelo.
Ordenar comparando: el modelo
Un ordenamiento por comparaciones (comparison sort) solo puede conocer el orden de sus datos comparando dos
de ellos. Puede mover elementos y hacer todo el cómputo que quiera con lo que ya sabe, y eso no se cuenta. Lo
que se cuenta es cuántas comparaciones hace. Insertion sort, mergesort, heapsort, quicksort y std::sort son de
este tipo.
En este modelo el algoritmo no puede usar un elemento como índice de un arreglo, ni mirar sus bits, ni sumarlo. Solo puede preguntar “¿a[i] < a[j]?”. Vamos a estudiar primero los algoritmos deterministas: con la misma entrada, hacen siempre las mismas comparaciones.
Basta mirar entradas con n elementos distintos. Si un algoritmo tiene que ordenar cualquier arreglo, en particular tiene que ordenar estos, y un peor caso entre ellos es también una entrada mala para el algoritmo. Con elementos distintos, además, una comparación solo tiene dos respuestas posibles. Un lenguaje con comparación de tres salidas (menor, igual, mayor) no gana nada aquí, porque la salida “igual” nunca ocurre.
El árbol de decisiones
Empecemos con un algoritmo concreto para 3 elementos x, y, z, en las posiciones a[0], a[1], a[2]:
algoritmo ordenar_tres(a)
    si a[1] < a[0] entonces
        intercambiar a[0] y a[1]
    fin si
    si a[2] < a[1] entonces
        intercambiar a[1] y a[2]
        si a[1] < a[0] entonces
            intercambiar a[0] y a[1]
        fin si
    fin si
fin algoritmo
Lo que el programa haga después de cada respuesta depende solo de las respuestas anteriores. Por eso podemos dibujar todas sus ejecuciones juntas, como un árbol. Cada nodo interno es una comparación, con los elementos originales. Cada rama es una respuesta. Cada hoja dice en qué orden quedaron los elementos.
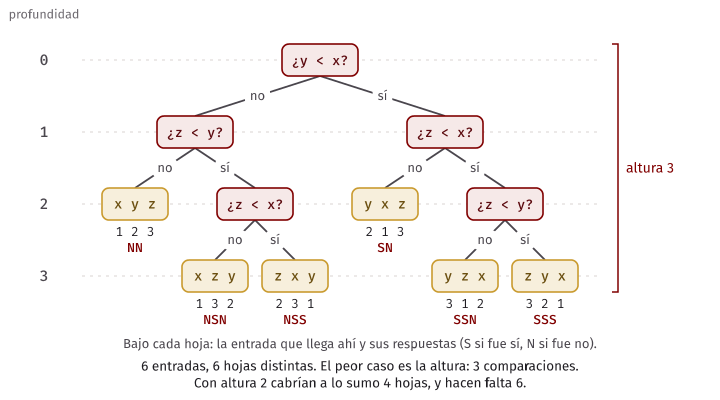
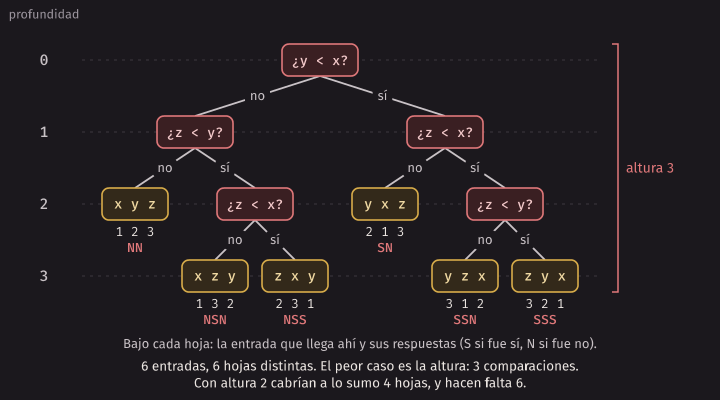
Este dibujo es el árbol de decisiones (decision tree) del algoritmo para n = 3.
- Una ejecución es un camino de la raíz a una hoja.
- El número de comparaciones de esa ejecución es la profundidad de la hoja.
- El peor caso del algoritmo es la altura del árbol, la profundidad de la hoja más honda.
Corramos el algoritmo real con las 6 permutaciones. El programa sort_three anota la respuesta de cada
comparación: S si fue sí, N si fue no.
$ build/sort_three
entrada  respuestas  comparaciones  salida
1 2 3    NN          2              1 2 3
1 3 2    NSN         3              1 2 3
2 1 3    SN          2              1 2 3
2 3 1    NSS         3              1 2 3
3 1 2    SSN         3              1 2 3
3 2 1    SSS         3              1 2 3
Seis entradas, seis cadenas de respuestas distintas: cada entrada termina en su propia hoja. Eso no es casualidad, y es el corazón de la demostración que sigue.
Cada algoritmo por comparaciones tiene un árbol de decisiones para cada n. Si el algoritmo es complicado, el árbol es enorme y nadie lo va a dibujar, pero existe. Y sobre esos árboles sí podemos razonar en general, aunque no sepamos nada del algoritmo.
La cota inferior para ordenar
Teorema. Para todo n ≥ 1 y todo ordenamiento por comparaciones determinista, existe una entrada de n elementos distintos con la que el algoritmo hace al menos ⌈log₂(n!)⌉ comparaciones.
Fíjense en lo que afirma, y en el orden de los cuantificadores: para cada algoritmo hay una entrada mala, que puede ser distinta de un algoritmo a otro. Es una afirmación sobre el peor caso. No dice nada sobre las demás entradas.
Técnica. Contar hojas en el árbol de decisiones: el árbol necesita muchas hojas, y un árbol binario con muchas hojas tiene que ser alto.
Paso 1: hay al menos n! hojas alcanzadas. Tomemos n elementos distintos fijos. Hay n! formas de disponerlos en el arreglo de entrada. Supongamos que dos disposiciones distintas, P y Q, llegan a la misma hoja. El algoritmo recibió las mismas respuestas con las dos, así que hizo exactamente los mismos movimientos: tomó el elemento de la misma posición de entrada para cada posición de salida. Si la salida de P es el arreglo ordenado, la de Q es otra cosa, porque P y Q tienen elementos distintos en alguna posición. Entonces el algoritmo se equivoca con una de las dos, y eso no puede pasar. Por lo tanto, las n! disposiciones llegan a n! hojas distintas.
El árbol completo del algoritmo puede tener más hojas, incluso ramas a las que ninguna de estas entradas llega nunca. Por eso, de aquí en adelante miramos solo la parte del árbol que recorren estas n! entradas. Esa parte tiene exactamente n! hojas.
Paso 2: un árbol binario de altura h tiene a lo sumo 2ʰ hojas. Por inducción sobre h. Con h = 0 el árbol es una sola hoja, y 2⁰ = 1. Con h > 0, la raíz tiene a lo sumo dos subárboles de altura a lo sumo h − 1, cada uno con a lo sumo 2ʰ⁻¹ hojas, y en total son a lo sumo 2ʰ.
Paso 3: se juntan. Sea h la altura de esa parte del árbol. Entonces n! ≤ 2ʰ, y tomando logaritmos, h ≥ log₂(n!). Como h es entero, h ≥ ⌈log₂(n!)⌉. Su hoja más honda corresponde a una de las n! entradas, y con esa entrada el algoritmo hace h comparaciones. ∎
Falta ver que eso es Ω(n log n)
Afirmación. log₂(n!) = Ω(n log n). Más precisamente, para n ≥ 4, log₂(n!) ≥ (n/4) log₂ n.
Técnica. Tirar los factores chicos del producto y acotar por debajo los que quedan.
n! = 1 · 2 · ⋯ · n. Quedémonos solo con los factores desde ⌈n/2⌉ hasta n, y olvidemos los demás, que valen al menos 1.
- ¿Cuántos son? n − ⌈n/2⌉ + 1 = ⌊n/2⌋ + 1. Eso es al menos n/2, tanto si n es par como si es impar.
- ¿Cuánto vale cada uno? Al menos ⌈n/2⌉, que es al menos n/2.
Por lo tanto, n! ≥ (n/2)^(n/2). Si n = 5, por ejemplo, los factores son 3, 4 y 5, tres factores mayores o iguales a 2,5, y 120 ≥ 2,5^2,5, que es cerca de 9,9. El exponente n/2 no tiene que ser entero para que esto valga: tenemos al menos n/2 factores, cada uno mayor o igual a n/2, y n/2 ≥ 1.
Tomando logaritmos:
log₂(n!) ≥ (n/2) · log₂(n/2) = (n/2) · (log₂ n − 1)Y para n ≥ 4 se cumple que log₂ n ≥ 2, así que log₂ n − 1 ≥ (log₂ n)/2. Reemplazando:
log₂(n!) ≥ (n/2) · (log₂ n)/2 = (n/4) · log₂ nEso es Ω(n log n), con constante 1/4 a partir de n = 4. ∎
La cota no se puede subir de orden, porque n! ≤ nⁿ da log₂(n!) ≤ n log₂ n. Entonces log₂(n!) = Θ(n log n). Y como mergesort hace O(n log n) comparaciones, el resultado es exacto en orden: ordenar comparando cuesta Θ(n log n) en el peor caso, y mergesort es óptimo en este modelo, salvo la constante.
La segunda tabla de lower_bound_table pone números a las desigualdades. Son valores calculados con double y
redondeados a enteros:
       n     (n/4) log n   (n/2) log(n/2)        log n!         n log n
       4              2                2             5               8
      16             16               24            44              64
     256            512              896          1684            2048
    4096          12288            22528         43250           49152
   65536         262144           491520        954037         1048576
 1048576        5242880          9961472      19458756        20971520
Las constantes de la demostración son modestas, porque tiramos la mitad de los factores. El valor verdadero está mucho más cerca de n log₂ n, y por eso la cota real es bastante más fuerte de lo que hizo falta demostrar.
Idea clave. La demostración no necesita saber nada del algoritmo. Usa solo tres hechos: cada comparación se responde sí o no, el algoritmo tiene que distinguir las n! disposiciones, y con h preguntas de sí o no se distinguen a lo sumo 2ʰ casos.
Tres elementos, con números
Para n = 3, ⌈log₂ 6⌉ = 3. Con dos comparaciones hay a lo sumo 4 hojas, y hacen falta 6: con dos comparaciones
es imposible ordenar 3 elementos en todos los casos, sea cual sea el algoritmo. Y ordenar_tres hace a lo
sumo 3, como muestra la tabla anterior. Entonces 3 es el número exacto para n = 3.
La misma cota, vista como un juego
Hay otra forma de leer la demostración, útil para recordarla. Imaginen un adversario que responde las comparaciones del algoritmo, pero no decide la entrada de antemano. Guarda la lista de todas las permutaciones coherentes con lo que ya respondió. Ante cada pregunta, divide la lista en las que responden sí y las que responden no, y contesta lo que deje la parte más grande.
Empieza con n! posibilidades, y cada respuesta deja al menos la mitad. Después de q preguntas quedan al menos n!/2^q. El algoritmo no puede terminar mientras queden dos: serían dos entradas con las mismas respuestas, y ya vimos que el algoritmo fallaría con una de ellas. Entonces, para llegar a 1, n!/2^q ≤ 1, y q ≥ log₂(n!). Es el mismo argumento de las hojas, sin dibujar el árbol.
El programa adversary_demo juega ese juego contra un insertion sort real, con n = 4:
$ build/adversary_demo
n = 4, inserción. Permutaciones posibles: 24
  ¿e1 < e0? sí, quedan 12
  ¿e2 < e0? sí, quedan 8
  ¿e2 < e1? sí, quedan 4
  ¿e3 < e0? sí, quedan 3
  ¿e3 < e1? sí, quedan 2
  ¿e3 < e2? sí, quedan 1

n = 5, cota 7
  inserción  10 comparaciones, posibles al final: 1, entrada: 4 3 2 1 0
  mergesort    8 comparaciones, posibles al final: 1, entrada: 4 2 3 1 0
n = 8, cota 16
  inserción  28 comparaciones, posibles al final: 1, entrada: 7 6 5 4 3 2 1 0
  mergesort   17 comparaciones, posibles al final: 1, entrada: 7 3 5 1 6 2 4 0
Noten dos cosas. Cada pregunta deja al menos la mitad de lo que había, como se prometió. Y la entrada mala que queda al final depende del algoritmo: contra insertion sort sale el arreglo invertido, y contra mergesort sale otra. Es el orden de los cuantificadores del teorema, visible en la pantalla: para cada algoritmo, una entrada.
La cota frente a algoritmos reales
El programa lower_bound_table recorre todas las permutaciones de n elementos, cuenta las comparaciones de
insertion sort y de mergesort con un comparador que las anota, y las pone junto a ⌈log₂(n!)⌉, calculado con
enteros. Los conteos son exactos y no dependen de la máquina.
$ build/lower_bound_table
 n       n!  cota  inserción       mergesort       hojas distintas
                   mejor  peor     mejor  peor     ins.     merge
 1        1     0       0     0        0     0        1         1
 2        2     1       1     1        1     1        2         2
 3        6     3       2     3        2     3        6         6
 4       24     5       3     6        4     5       24        24
 5      120     7       4    10        5     8      120       120
 6      720    10       5    15        7    11      720       720
 7     5040    13       6    21        9    14     5040      5040
 8    40320    16       7    28       12    17    40320     40320
 9   362880    19       8    36       13    21   362880    362880
Tres cosas que leer:
- Las columnas de hojas valen n!. Cada permutación lleva a su propia cadena de respuestas, como dice el Paso 1.
- Las columnas “peor” nunca bajan de la cota. Mergesort la alcanza hasta n = 4, y desde n = 5 queda por encima. La cota no promete que exista un algoritmo que la alcance exactamente, ni dice que mergesort sea el mejor para cada n: dice que nadie baja de ahí.
- Las columnas “mejor” sí bajan de la cota. Insertion sort, con una entrada ya ordenada, hace n − 1 comparaciones, y con n = 9 eso es 8 frente a 19. Esto no contradice nada. Ver el siguiente recuadro.
Error común. Decir que un algoritmo con mejor caso rápido rompe la cota inferior. “Insertion sort ordena en Θ(n) una entrada ya ordenada, entonces se puede ordenar en menos de n log n.” La cota habla del peor caso: dice que en cada algoritmo existe alguna entrada cara. Que otras entradas sean baratas es perfectamente compatible con eso. Para romperla habría que ordenar todas las entradas con menos comparaciones, y eso es lo que el teorema excluye.
Counting sort: esquivar la cota sin contradecirla
Hay algoritmos que ordenan en tiempo lineal. El más simple es counting sort (ordenamiento por conteo): si los valores son enteros en el rango de 0 a k − 1, se cuenta cuántas veces aparece cada uno y se escriben en orden.
algoritmo counting_sort(a, n, k)
    cuenta ← arreglo de k ceros
    para i desde 0 hasta n - 1 hacer
        cuenta[a[i]] ← cuenta[a[i]] + 1
    fin para
    siguiente ← 0
    para v desde 0 hasta k - 1 hacer
        para c desde 1 hasta cuenta[v] hacer
            a[siguiente] ← v
            siguiente ← siguiente + 1
        fin para
    fin para
fin algoritmo
El costo es Θ(n + k), y no aparece ninguna comparación entre elementos. ¿Contradice el teorema? No, porque no
es un ordenamiento por comparaciones. La línea cuenta[a[i]] usa el valor como índice de un arreglo. Saltar a
una casilla elegida por el valor es una operación con k resultados posibles, no dos. El árbol de decisiones
binario no modela esa línea, y el Paso 2 ya no se aplica.
inline void counting_sort(std::vector<int>& a, int k) {
    std::vector<std::size_t> count(static_cast<std::size_t>(k), 0);
    for (int value : a) {
        count[static_cast<std::size_t>(value)]++;  // el valor se usa como índice
    }
    std::size_t next = 0;
    for (int value = 0; value < k; value++) {
        for (std::size_t c = 0; c < count[static_cast<std::size_t>(value)]; c++) {
            a[next++] = value;
        }
    }
}
Este es el precio: hay que saber que los datos son enteros en un rango conocido y chico. Con palabras, con
números decimales o con un struct y un comparador cualquiera, no se aplica directamente. Y k pesa, en tiempo y
en memoria. El programa counting_bench mide contra std::sort, compilado con -O2, tomando el menor de 5
intentos. Los tiempos son de una corrida en el contenedor del curso, con la máquina compartida, y dependen de la
máquina; lo que vale la pena mirar es la forma.
$ build/counting_bench
        n          k  counting ms  std::sort ms
  1000000       1000          1.1          50.4
  4000000       1000          4.2         214.3
 16000000       1000         21.0         853.6
  1000000    1000000          9.6          88.6
  1000000   10000000         25.9          87.3
     1000   10000000         12.4           0.0
Con k fijo y n creciendo, counting sort escala de forma casi lineal y gana por un factor grande. Pero en la
última fila hay 1000 elementos y diez millones de casillas: counting sort recorre todas las casillas, y
std::sort termina antes de que el reloj, con esta precisión, alcance a registrar algo.
Idea clave. Una cota inferior vale dentro de su modelo. Salir del modelo no es hacer trampa, pero tiene condiciones: counting sort cambia la generalidad de “cualquier cosa comparable” por la suposición de “enteros en un rango chico”.
Quicksort con pivote al azar ✂️
Quicksort es un ordenamiento por comparaciones, así que la cota le aplica como a cualquiera. Lo que nos interesa ahora es otra pregunta. Ustedes ya lo conocen de Estructuras de Datos y saben que con un pivote fijo una entrada ya ordenada lo vuelve cuadrático. ¿Por qué elegir el pivote al azar arregla eso?
algoritmo quicksort(a, lo, hi)
    si hi - lo < 2 entonces
        devolver
    fin si
    r ← número al azar entre lo y hi - 1
    intercambiar a[lo] y a[r]
    pivote ← a[lo]
    p ← lo
    para i desde lo + 1 hasta hi - 1 hacer
        si a[i] < pivote entonces
            p ← p + 1
            intercambiar a[i] y a[p]
        fin si
    fin para
    intercambiar a[lo] y a[p]
    quicksort(a, lo, p)
    quicksort(a, p + 1, hi)
fin algoritmo
El rango es semiabierto: se ordena de a[lo] a a[hi − 1]. Al salir de la partición, los elementos de [lo, p) son menores que el pivote, y los de [p + 1, hi) son mayores o iguales.
El azar está en el algoritmo, no en los datos
Conviene separar dos afirmaciones que se parecen y son muy distintas:
- Pivote fijo, entrada al azar. Si los datos llegan en un orden uniformemente al azar, el primer elemento funciona bien en promedio. Pero aquí estamos suponiendo algo sobre los datos, y los datos reales no están obligados a cumplirlo: muchas veces llegan casi ordenados.
- Pivote al azar, entrada cualquiera. Fijen la entrada que quieran, incluso la peor que puedan imaginar. El programa tira sus monedas después de recibirla. El promedio se toma sobre las monedas del programa, no sobre las entradas, y la afirmación vale para cada entrada.
La segunda es mucho más fuerte, porque no le pide nada al mundo. No existe una “entrada mala” que alguien pueda preparar con anticipación, porque el mal caso ya no depende solo de la entrada. Un pivote malo puede salir, pero solo por mala suerte, y tiene que seguir saliendo muchas veces para hacer daño.
La intuición: la mitad de los pivotes son razonables
Lo siguiente es un razonamiento y no una demostración. El análisis formal necesita herramientas de Probabilidad, que no suponemos en este curso.
Digamos que un pivote es bueno si, en un rango de m elementos distintos, cae en la mitad central de las posiciones finales: deja al menos un cuarto de los elementos a cada lado, aproximadamente. Hay unas m/2 posiciones buenas de m, así que un pivote elegido al azar es bueno con probabilidad de al menos 1/2, más o menos como una moneda.
- Un pivote bueno deja cada lado con a lo sumo 3m/4 elementos, más o menos.
- Sigamos a un elemento cualquiera a través de la recursión. Cada pivote bueno multiplica el tamaño de su rango por a lo sumo 3/4. Después de t pivotes buenos, el tamaño es a lo sumo n · (3/4)ᵗ, que llega a 1 cuando t = log_(4/3) n, alrededor de 2,41 · log₂ n.
- Los pivotes buenos salen una de cada dos veces, en promedio. Entonces ese elemento recorre unos 4,8 · log₂ n niveles, antes de quedar solo. Los pivotes malos también achican el rango, y por eso esta cuenta se pasa de larga.
- En cada nivel los rangos no se pisan, así que entre todos hacen a lo sumo n comparaciones.
Por eso se esperan O(log n) niveles y O(n log n) comparaciones. La cuenta seguida arriba es para un solo elemento. Afirmar lo mismo para el nivel más hondo de todo el árbol requiere el análisis formal, y no lo vamos a hacer. En su lugar, miremos un ejemplo y midamos.
Este es el tamaño de cada rango, nivel por nivel, con 16 elementos ya ordenados. Un punto es un rango de un solo elemento.
$ build/quicksort_trace
Primer elemento como pivote:
  nivel 1: 16
  nivel 2: 15
  nivel 3: 14
  nivel 4: 13
  nivel 5: 12
  nivel 6: 11
  nivel 7: 10
  nivel 8: 9
  nivel 9: 8
  nivel 10: 7
  nivel 11: 6
  nivel 12: 5
  nivel 13: 4
  nivel 14: 3
  nivel 15: 2
  nivel 16: .
Pivote al azar, semilla 7:
  nivel 1: 16
  nivel 2: 15
  nivel 3: 7 7
  nivel 4: 6 . 5
  nivel 5: 2 3 3 .
  nivel 6: . 2 2
  nivel 7: . .
Con el primer elemento, cada nivel saca un solo elemento. Con pivote al azar también salió un pivote malo, en el primer nivel: fue el extremo, y dejó 15. No importó, porque el siguiente partió 15 en 7 y 7. Un pivote malo cuesta un nivel de más, no arruina la ejecución.
Midiendo
El programa quicksort_levels cuenta comparaciones y niveles con semilla fija, de modo que los conteos salen
iguales cada vez. El tiempo es de una corrida con -O2, en una máquina compartida, y depende de la máquina.
c/nlogn es comparaciones dividido entre n log₂ n. Es un extracto: primero, las filas de n = 64 000.
$ build/quicksort_levels
pivote y partición  entrada       n  comparac.  niveles  c/nlogn      ms
primero, en dos   ordenada    64000  2047968000   63999 2004.25    1177.5
primero, en dos   al azar     64000     1208356      38    1.18       5.4
azar, en dos      ordenada    64000     1245835      37    1.22       3.0
azar, en dos      al azar     64000     1182428      36    1.16       6.0
azar, en dos      iguales     64000  2047968000   63999 2004.25    1075.3
azar, en tres     iguales     64000      127998       1    0.13       0.1
azar, en tres     ordenada    64000     1945879      37    1.90       3.8
Y algunas filas con n menores, para ver cómo crece:
primero, en dos   ordenada     4000     7998000    3999  167.10       5.5
azar, en dos      ordenada     4000       53480      25    1.12       0.2
azar, en dos      iguales      4000     7998000    3999  167.10       8.3

primero, en dos   ordenada    16000   127992000   15999  572.79      80.8
azar, en dos      ordenada    16000      270137      31    1.21       0.8
azar, en dos      iguales     16000   127992000   15999  572.79     105.1
Lean las filas por pares:
- Primero contra azar, con la misma entrada ordenada. Con el primer elemento como pivote hay 2 047 968 000 comparaciones, que es exactamente n(n − 1)/2, y 63 999 niveles: cada partición saca un solo elemento. Con pivote al azar son 1 245 835 y 37 niveles. Más de mil veces menos comparaciones, con el mismo programa y la misma entrada.
- Primero, con entrada al azar. Le va bien, igual que a la versión aleatorizada. Eso es la primera afirmación de arriba, y es lo que engaña en una prueba rápida. Depende de cómo vengan los datos.
- Al pasar de 16 000 a 64 000, n se multiplica por 4 y las comparaciones de “primero, ordenada” por unos 16.
Es Θ(n²). Las de “azar, ordenada” se multiplican por unos 4,6. Crecen como n log n:
c/nlognqueda cerca de 1,2.
Ahora fijemos la entrada ordenada y cambiemos solo las semillas. Lo único que varía es el azar del programa:
entrada ordenada, n = 64000, 1000 semillas
comparaciones: mínimo 1145604, promedio 1235073, máximo 1382522
niveles:       mínimo 33, promedio 37, máximo 46
pivotes buenos, en llamadas de 16 o más elementos: 52.1 %
En mil corridas, el máximo de comparaciones está un 12 % por encima del promedio. Y el nivel más hondo promedia 37, por debajo de la estimación gruesa de arriba: 4,8 · log₂ 64000 es cerca de 77. La proporción de pivotes buenos sale un poco sobre la mitad, como se esperaba: la cuenta con división entera deja algo más de la mitad de las posiciones como buenas, y aquí solo miramos rangos de 16 elementos o más. El peor caso en teoría sigue siendo Θ(n²): una secuencia de monedas muy desafortunada puede dar pivotes malos todo el tiempo. Lo que ocurre es que esas secuencias son extremadamente improbables, y en estas mil corridas nada se acercó.
Error común. Creer que el azar arregla todo. La fila “azar, en dos, iguales” muestra otra cosa: 2 047 968 000 comparaciones. Si todos los elementos son iguales, ningún pivote separa nada, porque esta partición deja todo en el lado derecho. La cuenta de “la mitad de los pivotes son razonables” supone elementos distintos. Con muchos repetidos hace falta la partición en tres que se vio en Estructuras de Datos: menores, iguales y mayores, sin volver a tocar los iguales. La fila “azar, en tres, iguales” da 1 nivel y 127 998 comparaciones. Y en “azar, en tres, ordenada”
c/nlognsube a 1,9 porque esa versión hace hasta dos preguntas por elemento: ¿menor? y ¿mayor?
¿Y la cota inferior?
Quicksort con pivote al azar no la contradice. Si se fija de antemano toda la secuencia de monedas, lo que queda es un algoritmo determinista, y a ese se le aplica el teorema: tiene una entrada con al menos ⌈log₂(n!)⌉ comparaciones. Lo que cambia es que esa entrada mala depende de las monedas, y por eso nadie la puede preparar sin conocerlas.
El teorema que demostramos es para algoritmos deterministas. También se sabe que el número esperado de comparaciones de cualquier ordenamiento por comparaciones aleatorizado es Ω(n log n) en su peor entrada, pero esa versión necesita un argumento sobre la profundidad promedio de las hojas. Aquí lo enunciamos sin demostrarlo.
En C++. El estándar pide desde C++11 que
std::sorthaga O(n log n) comparaciones. En la biblioteca deg++, libstdc++, está implementado con introsort (la función__introsort_loopenbits/stl_algo.h): un quicksort que, si la recursión se hunde demasiado, cambia a heapsort. Eso le da una garantía de peor caso sin depender de la suerte. Con un comparador propio sigue siendo por comparaciones, y la cota le aplica.
En la práctica. El azar protege mientras la entrada no dependa de las monedas. Si un servicio ordena datos que le envían desconocidos y usa una semilla fija y conocida, alguien puede correr el mismo generador y fabricar la entrada mala. Las reglas fijas para elegir pivote, como la mediana de tres elementos, reducen el problema de los datos casi ordenados, pero siguen teniendo entradas malas que se pueden construir.
Greedy: decidir sin volver atrás
Un algoritmo greedy toma una decisión en cada paso, la que hoy parece mejor según alguna regla, y nunca la deshace. No explora alternativas como una búsqueda, ni guarda subproblemas. Suele ser muy corto y muy rápido.
Eso es la mitad fácil. La mitad difícil es que la mayoría de las reglas que suenan bien son incorrectas, y que probar con unos cuantos ejemplos no alcanza para detectarlo. En esta parte del curso todo greedy viene con su demostración, y antes de ella, con una regla parecida que falla.
Selección de intervalos
Un instituto tiene una sola aula y una lista de clases que quisieran dictarse ahí. Cada clase tiene una hora de inicio y una de fin. Se quiere dictar la mayor cantidad posible de clases, sin que dos se crucen. No importa cuáles, ni cuánto dure cada una: cuenta el número.
Cada clase es un intervalo semiabierto [s, f), con s < f: ocupa el aula desde el instante s, incluido, hasta justo antes del instante f. Una clase que termina a las 10 no se cruza con una que empieza a las 10: el aula queda libre justo a tiempo.
Definición. Dos intervalos [s₁, f₁) y [s₂, f₂) se cruzan si tienen algún instante en común. Eso ocurre si y solo si s₁ < f₂ y s₂ < f₁. Si no se cruzan, son compatibles. Una solución válida es un conjunto de clases compatibles de a pares. Una solución óptima es una solución válida con el mayor número de clases.
struct Interval {
    int start;
    int finish;
    bool operator==(const Interval&) const = default;
};

inline bool overlap(const Interval& a, const Interval& b) {
    return a.start < b.finish && b.start < a.finish;
}
Las comparaciones son estrictas. Eso es lo que hace que [8, 10) y [10, 12) sean compatibles: la primera condición sería 8 < 12, verdadera, y la segunda 10 < 10, falsa.
Error común. Escribir
<=enoverlap, o<donde va<=al revisar si el aula ya se liberó. Con intervalos cerrados, dos clases seguidas contarían como un cruce, y el programa diría que hacen falta más aulas de las necesarias. Antes de programar, decidan qué pasa en el borde, y agreguen una prueba justo ahí. La nuestra esassert(!overlap({8, 10}, {10, 12})).
Hay 2ⁿ subconjuntos de clases, así que probarlos todos no es una opción con n grande. Pero sirve de árbitro con
n pequeño: la función max_compatible_brute prueba todos y da el óptimo verdadero, con el que vamos a comparar
cada regla.
Tres reglas que fallan
Todas tienen el mismo esquema: recorrer las clases según una regla, y tomar cada una que no se cruce con lo ya tomado. Las tres dan siempre una solución válida. Y las tres se equivocan en el tamaño.
Corramos build/greedy_rules. Cada bloque pasa una lista de clases por las cuatro reglas.
Primera regla: la que empieza antes
Parece sensato: no dejar el aula vacía. El problema es una clase que empieza muy temprano y dura todo el día.
Contra empieza antes:
  clases: [8,18) [9,11) [11,13) [13,15)
  óptimo por fuerza bruta: 3
  empieza antes: 1 (válida) -> [8,18)
  dura menos   : 3 (válida) -> [9,11) [11,13) [13,15)
  menos cruces : 3 (válida) -> [9,11) [11,13) [13,15)
  termina antes: 3 (válida) -> [9,11) [11,13) [13,15)
Toma [8, 18) y ya no cabe nada más. La respuesta correcta es 3, y la distancia puede ser tan grande como se quiera: con una clase larga y k clases cortas debajo, la regla da 1 y el óptimo da k.
Segunda regla: la que dura menos
Si la clase larga era el problema, tomemos primero las cortas. Pero una clase corta puede estorbar a dos largas.
Contra dura menos:
  clases: [8,12) [12,16) [11,13)
  óptimo por fuerza bruta: 2
  empieza antes: 2 (válida) -> [8,12) [12,16)
  dura menos   : 1 (válida) -> [11,13)
  menos cruces : 2 (válida) -> [8,12) [12,16)
  termina antes: 2 (válida) -> [8,12) [12,16)
[11, 13) dura 2 horas, la menor, y se cruza con las otras dos, que además sí son compatibles entre ellas, porque [8, 12) y [12, 16) se tocan solo en el borde.
Tercera regla: la que tiene menos cruces
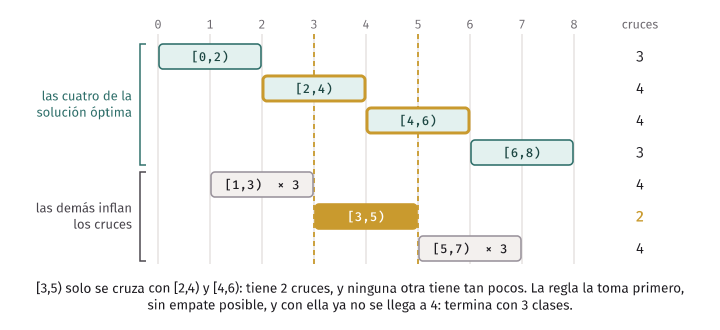
Más astuta: tomar la clase que estorbe a menos clases, sacar las que se cruzan con ella, y repetir, volviendo a contar entre las que quedan. Nuestro contraejemplo tiene once clases. Las cuatro de arriba son la solución óptima. Las demás están puestas para inflar los cruces de esas cuatro:
![Las clases sobre un eje de 0 a 8, con sus cruces. Las cuatro de la solución óptima: [0,2) con 3 cruces, [2,4) con 4, [4,6) con 4 y [6,8) con 3. Las demás: [1,3) tres veces, con 4 cruces cada una; [3,5), resaltada, con 2; y [5,7) tres veces, con 4 cada una. Unas líneas punteadas en 3 y 5 muestran que [3,5) solo se cruza con [2,4) y 4,6)
Contra menos cruces:
  clases: [0,2) [2,4) [4,6) [6,8) [1,3) [1,3) [1,3) [3,5) [5,7) [5,7) [5,7)
  óptimo por fuerza bruta: 4
  empieza antes: 4 (válida) -> [0,2) [2,4) [4,6) [6,8)
  dura menos   : 4 (válida) -> [0,2) [2,4) [4,6) [6,8)
  menos cruces : 3 (válida) -> [3,5) [0,2) [6,8)
  termina antes: 4 (válida) -> [0,2) [2,4) [4,6) [6,8)

En esa lista, cruces de cada clase:
  [0,2): 3
  [2,4): 4
  [4,6): 4
  [6,8): 3
  [1,3): 4  (no está en ninguna solución óptima)
  [1,3): 4  (no está en ninguna solución óptima)
  [1,3): 4  (no está en ninguna solución óptima)
  [3,5): 2  (no está en ninguna solución óptima)
  [5,7): 4  (no está en ninguna solución óptima)
  [5,7): 4  (no está en ninguna solución óptima)
  [5,7): 4  (no está en ninguna solución óptima)
Menos cruces, con cualquier forma de romper empates: entre 3 y 3
[3, 5) tiene 2 cruces y es la única con tan pocos, así que la regla la toma primero, sin empate posible. Y esa
clase no está en ninguna solución óptima: la primera decisión ya perdió. Por si los empates de los pasos
siguientes pudieran rescatarla, fewest_conflicts_range prueba todas las formas de romperlos, y siempre da 3.
Los contraejemplos de las otras dos reglas son igual de contundentes. Sus primeras elecciones, [8, 18) y [11,
13), tampoco están en ninguna solución óptima, y test_examples.cpp lo comprueba con fuerza bruta.
Válida no es óptima
En los tres bloques, la salida dice (válida). Las reglas nunca produjeron un horario con cruces. Comprobemos
también qué tan seguido fallan, en instancias al azar de hasta 12 clases, contra la fuerza bruta:
$ build/rules_random
20000 instancias de 2 a 12 clases
respuestas inválidas de cualquier regla: 0
instancias en que la regla no llega al óptimo:
  empieza antes   5423  (27.11 %)
  dura menos       684  (3.42 %)
  menos cruces       2  (0.01 %)
  termina antes      0  (0.00 %)
Lean la columna de “menos cruces”: 2 fallos en 20 000. Es una regla incorrecta que pasaría casi cualquier prueba al azar de este tamaño, y aun así está demostrado que falla. Una prueba solo puede mostrar que una regla es incorrecta. Los ceros de “termina antes” no demuestran nada todavía.
Error común. Demostrar que el greedy da una solución válida y creer que eso prueba que es óptima. “Nunca toma dos clases que se crucen, así que es correcto” vale palabra por palabra para las tres reglas que acabamos de refutar. La validez es la parte fácil. Lo que hay que demostrar es que ninguna otra solución válida es más grande.
La regla correcta: la que termina antes
Elegir la clase que termina antes, entre las que todavía caben. La intuición: lo único que una clase le quita al resto del día es el aula hasta su hora de fin. La que termina antes es la que deja más tiempo libre, sin importar cuándo empezó.
algoritmo seleccionar_clases(clases, n)
    ordenar clases por hora de fin, de menor a mayor
    elegidas ← lista vacía
    libre ← -∞
    para i desde 0 hasta n - 1 hacer
        si libre ≤ clases[i].inicio entonces
            agregar clases[i] a elegidas
            libre ← clases[i].fin
        fin si
    fin para
    devolver elegidas
fin algoritmo
Es el ≤ el que dice que una clase puede empezar justo cuando la anterior termina.
Basta comparar con la última clase elegida, y no con todas. La razón es que las clases se recorren por hora de fin: la última elegida es la que termina más tarde entre las elegidas, y si la nueva empieza después de ella, también empieza después de todas las otras.
Sigamos un ejemplo con ocho clases, ya ordenadas por hora de fin. libre es el instante desde el que el aula
está libre.
| Clase | ¿libre ≤ inicio? | ¿Se toma? | libre después |
|---|---|---|---|
| [8, 10) | −∞ ≤ 8 | sí | 10 |
| [9, 11) | 10 ≤ 9, no | no | 10 |
| [10, 12) | 10 ≤ 10 | sí, justo en el borde | 12 |
| [11, 13) | 12 ≤ 11, no | no | 12 |
| [8, 13) | 12 ≤ 8, no | no | 12 |
| [12, 14) | 12 ≤ 12 | sí, justo en el borde | 14 |
| [13, 15) | 14 ≤ 13, no | no | 14 |
| [15, 16) | 14 ≤ 15 | sí | 16 |
![Animación del recorrido por las ocho clases, con la línea de libre sobre un eje de 8 a 16 y abajo la fila del aula. libre empieza en −∞. [8, 10): −∞ ≤ 8, se toma, y libre pasa a 10. [9, 11): 10 ≤ 9 es falso, no se toma. [10, 12): 10 ≤ 10, se toma justo en el borde, y libre pasa a 12. [11, 13): 12 ≤ 11 es falso. [8, 13): 12 ≤ 8 es falso. [12, 14): 12 ≤ 12, se toma justo en el borde, y libre pasa a 14. [13, 15): 14 ≤ 13 es falso. 15, 16): 14 ≤ 15, se toma, y libre pasa a 16. Al final, el aula tiene cuatro clases
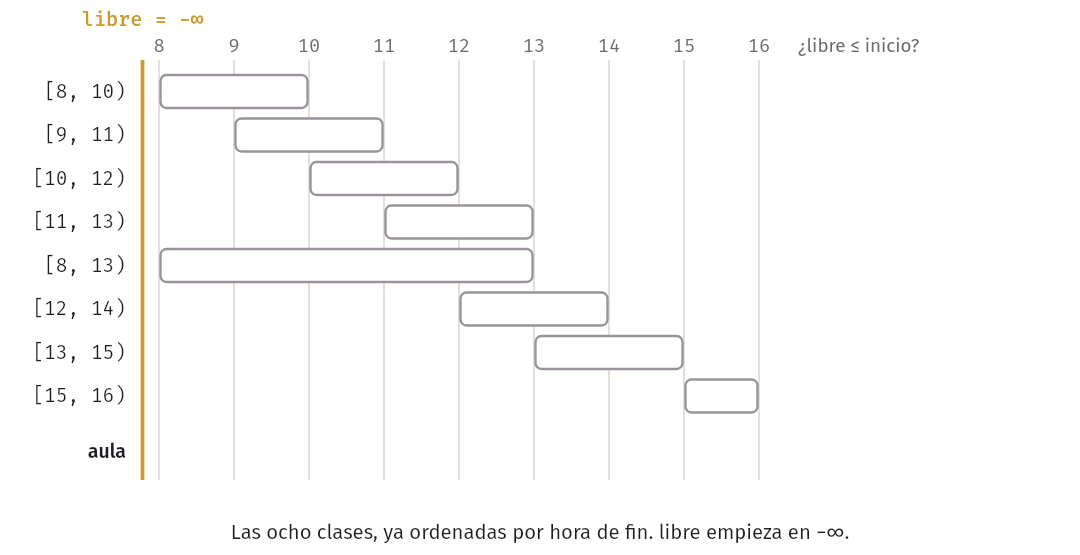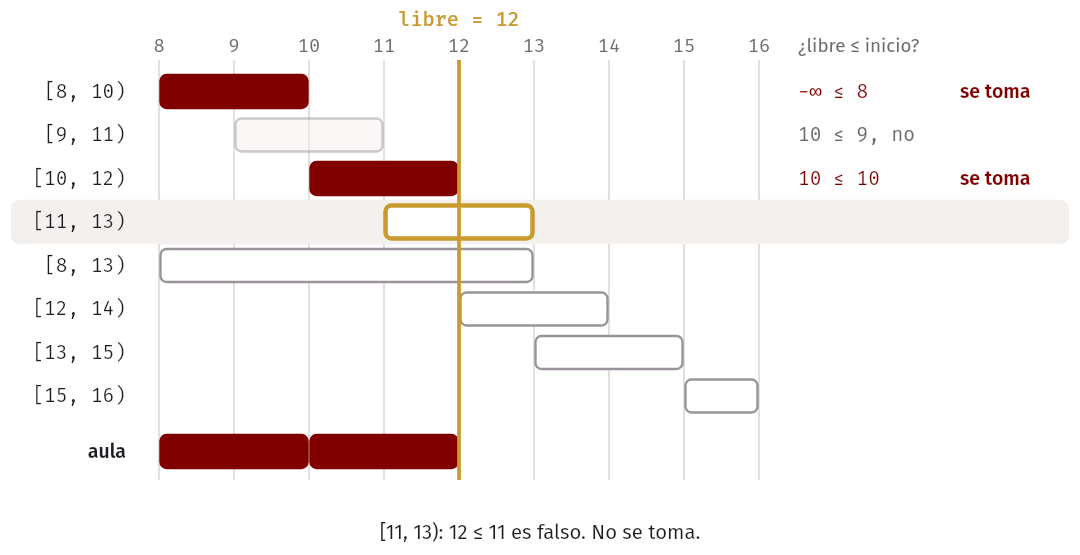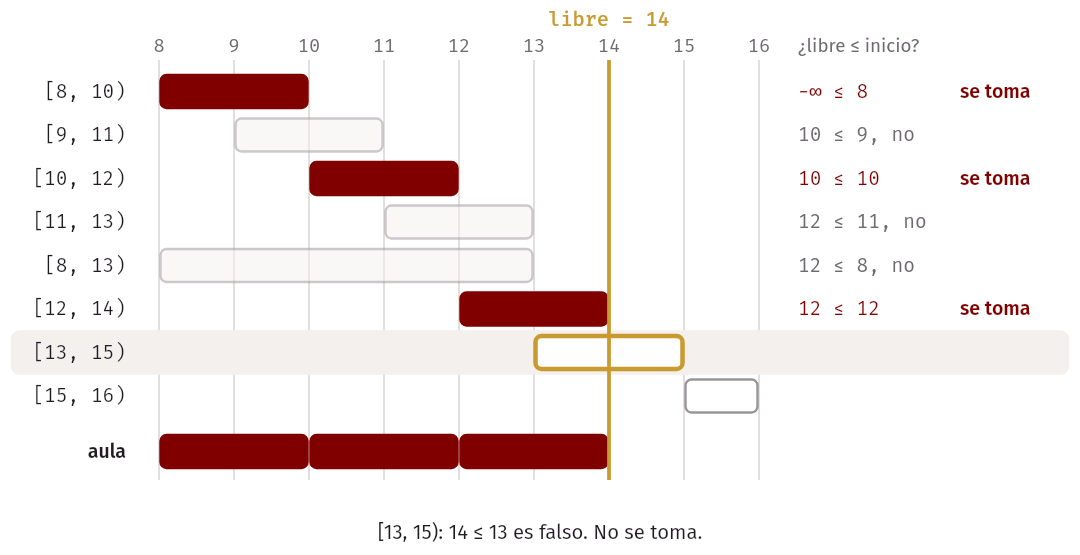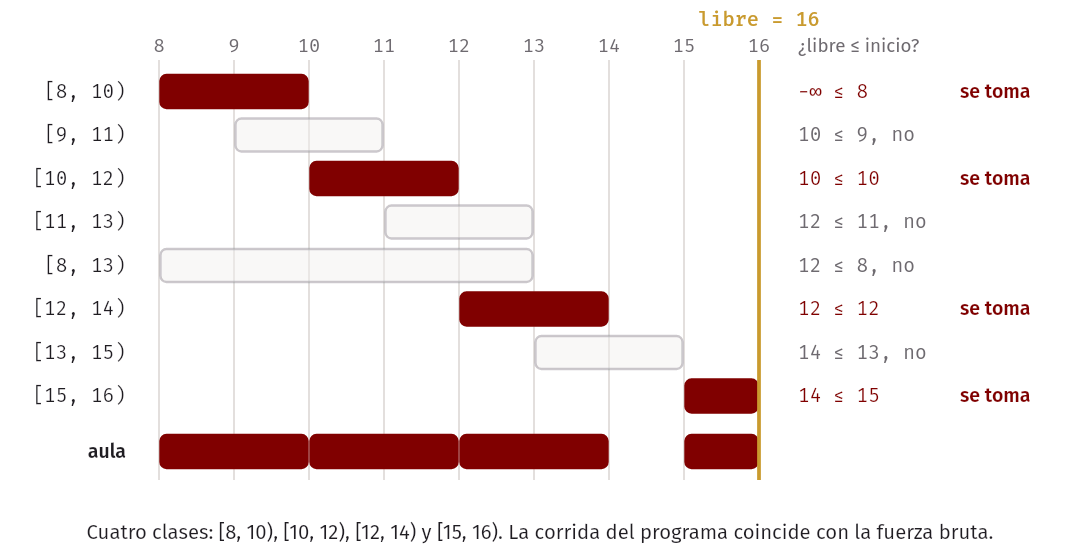
Son cuatro clases, y la corrida del programa coincide con la fuerza bruta. Esta es la primera línea de su salida; las siguientes aparecen más adelante:
$ build/interval_traces
Selección (4 clases, óptimo 4): [8,10) [10,12) [12,14) [15,16)
Si tratáramos el borde como un cruce, con < en vez de ≤, el recorrido tomaría [8, 10), [11, 13) y [15, 16):
3 clases en vez de 4.
inline std::vector<Interval> select_by_finish(std::vector<Interval> classes) {
    std::sort(classes.begin(), classes.end(),
              [](const Interval& a, const Interval& b) { return a.finish < b.finish; });
    std::vector<Interval> chosen;
    for (const Interval& c : classes) {
        // Invariante: chosen es válida y está ordenada por tiempo.
        if (chosen.empty() || chosen.back().finish <= c.start) {
            chosen.push_back(c);
        }
    }
    return chosen;
}
El costo lo pone el ordenamiento: O(n log n), y luego un recorrido de Θ(n). Con las clases ya ordenadas por fin, basta con Θ(n).
Demostración: el argumento de intercambio
Vamos a demostrar dos afirmaciones por separado, porque son cosas distintas.
Afirmación 1 (validez). Las clases elegidas son compatibles de a pares.
Se toma una clase solo si empieza en o después de libre, la hora de fin de la última elegida. Por eso las
elegidas g₁, g₂, …, gₖ, en el orden en que se tomaron, cumplen f(gᵢ) ≤ s(gᵢ₊₁). Si i < j, entonces f(gᵢ) ≤
s(gᵢ₊₁) < f(gᵢ₊₁) ≤ ⋯ ≤ s(gⱼ), así que gᵢ termina antes de que gⱼ empiece, y no se cruzan. ∎
Las tres reglas falsas también tienen una afirmación así. La que las separa es la siguiente.
Afirmación 2 (optimalidad). Ninguna solución válida tiene más de k clases, donde k es lo que eligió el greedy.
Técnica. Argumento de intercambio (exchange argument): tomar una solución óptima cualquiera y transformarla, paso a paso, en la del greedy, sin que deje de ser válida ni pierda clases. Si se puede llegar a la del greedy sin empeorar, la del greedy era igual de buena.
Preparación. Sea O = {x₁, x₂, …, xₘ} una solución óptima, con sus clases ordenadas por inicio. Como son compatibles, ese orden es también el orden por fin: f(xᵢ) ≤ s(xᵢ₊₁) < f(xᵢ₊₁). Como la solución del greedy es válida (Afirmación 1) y O es óptima, m ≥ k. Queremos ver que m = k.
Si n = 0, no hay nada que demostrar. Si no, el greedy toma al menos una clase, porque la primera que mira siempre cabe.
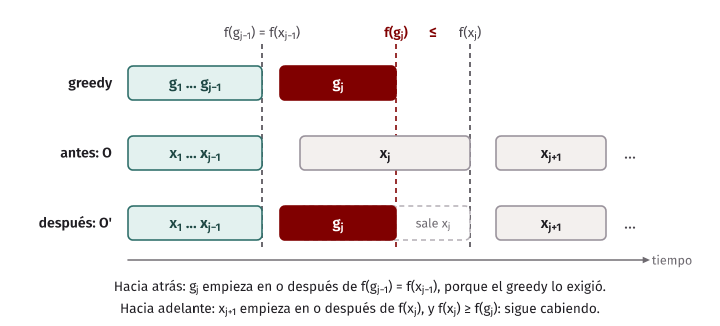
El intercambio: arreglar la primera diferencia. Supongamos que O coincide con el greedy en las primeras j − 1 posiciones, es decir, xᵢ = gᵢ para i < j, y que xⱼ ≠ gⱼ, con j ≤ k. Queremos cambiar xⱼ por gⱼ.
Primero, gⱼ termina a más tardar cuando termina xⱼ. Cuando el greedy eligió gⱼ, miró las clases en orden de fin y tomó la primera que empezaba en o después de f(gⱼ₋₁). La clase xⱼ cumple esa condición, porque s(xⱼ) ≥ f(xⱼ₋₁) = f(gⱼ₋₁). (Si j = 1, no hay condición alguna.) Así que xⱼ era una candidata, y el greedy eligió a la candidata de menor fin:
f(gⱼ) ≤ f(xⱼ)Segundo, el cambio no rompe nada. Sea O′ = {x₁, …, xⱼ₋₁, gⱼ, xⱼ₊₁, …, xₘ}. Veamos cada vecino:
- Hacia atrás: gⱼ empieza en o después de f(gⱼ₋₁) = f(xⱼ₋₁), porque el greedy lo exigió. Así que es compatible con x₁, …, xⱼ₋₁.
- Hacia adelante: toda clase xₗ con l > j empieza en o después de f(xⱼ), que es mayor o igual a f(gⱼ). Así que gⱼ termina antes de que xₗ empiece, y es compatible con ella.
En particular, gⱼ no es ninguna de las xₗ con l > j, ya que estas empiezan en o después de f(gⱼ), y gⱼ empieza antes. Por eso O′ tiene el mismo número de clases que O. Es una solución válida con m clases, así que también es óptima, y coincide con el greedy en una posición más que O.
Repetir. Aplicando este cambio hasta k veces, obtenemos una solución óptima O* cuyas primeras k clases son exactamente g₁, …, gₖ, con m clases en total.
El último paso, que no se puede omitir. Falta ver que O* no tiene clases de más. Supongamos que m > k.
Entonces hay una clase xₖ₊₁ en O*, y como O* es válida, xₖ₊₁ empieza en o después de f(gₖ). Además termina
después de empezar, así que f(xₖ₊₁) > f(gₖ), y aparece después de gₖ en el orden del greedy. Cuando el recorrido
llegó a ella, libre todavía valía f(gₖ), porque gₖ fue la última elegida. La condición libre ≤ inicio se
cumplía, y el greedy la habría tomado. Contradicción. Luego m = k. ∎
Sigamos la demostración con las ocho clases del ejemplo. El greedy eligió [8,10) [10,12) [12,14) [15,16). Otra solución óptima, también de 4 clases y sin ninguna clase en común con las tres primeras del greedy, es [9,11) [11,13) [13,15) [15,16). El programa hace los cambios en orden:
Intercambio, empezando en: [9,11) [11,13) [13,15) [15,16)
  posición 1: [8,10) [11,13) [13,15) [15,16)  válida
  posición 2: [8,10) [10,12) [13,15) [15,16)  válida
  posición 3: [8,10) [10,12) [12,14) [15,16)  válida
![Cuatro filas sobre un eje de 8 a 16. Inicio: [9,11) [11,13) [13,15) [15,16). Posición 1: entra [8,10) y sale [9,11), con 10 ≤ 11. Posición 2: entra [10,12) y sale [11,13), con 12 ≤ 13. Posición 3: entra [12,14) y sale [13,15), con 14 ≤ 15. 15,16) coincide con el greedy desde el inicio. Las filas de las tres posiciones son válidas
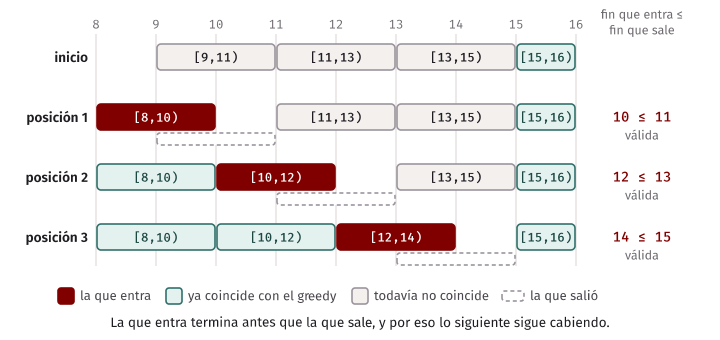
En cada paso la clase que entra termina antes que la que sale, y por eso lo que viene después sigue cabiendo. La cuarta posición ya coincide. Al final, la solución óptima se convirtió en la del greedy sin perder ninguna clase.
Idea clave. El patrón del intercambio: tomen una solución óptima cualquiera. Busquen la primera diferencia con el greedy. Cambien esa decisión por la del greedy y comprueben que sigue siendo válida y no empeora. Repitan. Luego revisen que no sobre nada al final.
Dónde se rompen las reglas falsas
Una demostración es buena si, al aplicarla a un algoritmo falso, se rompe en un lugar preciso. Toda la demostración descansa en una línea: f(gⱼ) ≤ f(xⱼ). Con “dura menos”, esa línea es falsa. En [8,12) [12,16) [11,13), el greedy elige g₁ = [11, 13), y la solución óptima tiene x₁ = [8, 12). Aquí f(g₁) = 13 es mayor que f(x₁) = 12. Al cambiarla, g₁ choca con x₂ = [12, 16). Eso es exactamente lo que vimos fallar. “Empieza antes” y “menos cruces” se rompen en el mismo sitio.
Partición de intervalos
Ahora queremos dictar todas las clases, en la menor cantidad posible de aulas. Una asignación es válida si dos clases en la misma aula nunca se cruzan.
La pregunta no es la misma de antes. Antes podíamos descartar clases. Ahora no se descarta nada, y lo que se cuenta son las aulas.
Una cota inferior
Definición. La profundidad (depth) de un conjunto de intervalos es el mayor número de ellos que contienen un mismo instante. Un intervalo [s, f) contiene al instante t si s ≤ t < f.
Afirmación. Si la profundidad es d, hacen falta al menos d aulas.
Si d clases contienen al instante t, todas se están dictando a la vez en ese momento: se cruzan de a pares, y dos clases que se cruzan no pueden compartir aula. Con menos de d aulas, dos caerían en la misma. Es decir, si en algún momento hay 4 clases a la vez, hacen falta al menos 4 aulas. ∎
Noten el parecido con la Sesión A. Esta es una cota inferior sobre todas las asignaciones, sin importar qué algoritmo las produzca.
Falta ver si la cota se puede alcanzar. En principio podría no bastar con d: que a cada momento haya pocas clases no garantiza de inmediato que un reparto consistente exista. Pero aquí sí basta.
Una idea que falla
Ya tenemos un algoritmo óptimo para llenar una aula. Entonces suena natural: llenar la primera aula con la selección óptima, quitar esas clases, llenar la segunda con lo que quede, y seguir. Cada aula queda lo más llena posible, ¿no? Veamos:
Clases [10,11) [8,12) [11,17) [15,16)
  llenar aula por aula con la selección: 3 aulas
  por orden de inicio: 2 aulas
  mínimo por fuerza bruta: 2 aulas
  máximo simultáneo: 2
La selección por fin elige [10, 11) y [15, 16), que son dos clases, el máximo para una aula. Las que quedan, [8, 12) y [11, 17), se cruzan, y necesitan una aula cada una. Son 3 en total. En cambio, {[8, 12), [15, 16)} y {[10, 11), [11, 17)} usan solo 2. Elegir lo mejor para la primera aula perjudicó a las demás: un óptimo local por aula no da un óptimo global.
El algoritmo que sí funciona
Hay que recorrer en otro orden: por hora de inicio. Cada clase se pone en cualquier aula que esté libre, y se abre una nueva solo si no hay ninguna.
algoritmo asignar_aulas(clases, n)
    ordenar clases por hora de inicio, de menor a mayor
    H ← heap de mínimos, vacío, con la hora en que se libera cada aula abierta
    aulas ← 0
    para i desde 0 hasta n - 1 hacer
        si H no está vacío y mínimo de H ≤ clases[i].inicio entonces
            a ← aula del mínimo de H
            sacar el mínimo de H
        sino
            a ← aulas
            aulas ← aulas + 1
        fin si
        aula[i] ← a
        insertar (clases[i].fin, a) en H
    fin para
    devolver aulas
fin algoritmo
El heap solo sirve para encontrar rápido un aula libre. Si alguna está libre, la que se libera primero también lo está. Cuesta O(n log n): ordenar y luego a lo sumo n operaciones sobre un heap de a lo sumo n elementos.
Sigamos las mismas ocho clases de antes, ahora por inicio. Con empate de inicio mantenemos el orden de la lista, que es lo que hace el programa. En el heap, cada par es (hora en que se libera, aula).
| Clase | Mínimo del heap | ¿Libre? | Aula | Heap después |
|---|---|---|---|---|
| [8, 10) | vacío | no | 0, nueva | (10,0) |
| [8, 13) | (10,0) | 10 ≤ 8, no | 1, nueva | (10,0) (13,1) |
| [9, 11) | (10,0) | 10 ≤ 9, no | 2, nueva | (10,0) (11,2) (13,1) |
| [10, 12) | (10,0) | 10 ≤ 10, sí | 0 | (11,2) (12,0) (13,1) |
| [11, 13) | (11,2) | 11 ≤ 11, sí | 2 | (12,0) (13,1) (13,2) |
| [12, 14) | (12,0) | 12 ≤ 12, sí | 0 | (13,1) (13,2) (14,0) |
| [13, 15) | (13,1) | 13 ≤ 13, sí | 1 | (13,2) (14,0) (15,1) |
| [15, 16) | (13,2) | 13 ≤ 15, sí | 2 | (14,0) (15,1) (16,2) |
![Animación de las ocho clases entrando a las aulas, con el heap a la derecha y abajo cuántas clases ya puestas hay a la vez en cada hora. [8, 10): el heap está vacío, se abre el aula 0. [8, 13): 10 ≤ 8 es falso, se abre el aula 1. [9, 11): 10 ≤ 9 es falso, se abre el aula 2. [10, 12): 10 ≤ 10, va al aula 0. [11, 13): 11 ≤ 11, va al aula 2. [12, 14): 12 ≤ 12, va al aula 0. [13, 15): 13 ≤ 13, va al aula 1. [15, 16): 13 ≤ 15, va al aula 2. Al final, el aula 0 tiene [8, 10), [10, 12) y [12, 14); el aula 1, [8, 13) y [13, 15); el aula 2, [9, 11), [11, 13) y [15, 16). Por hora, de 8 a 15, hay 2, 3, 3, 3, 3, 2, 1 y 1 clases a la vez. A las 9 una línea cruza [8, 10), [8, 13) y 9, 11)
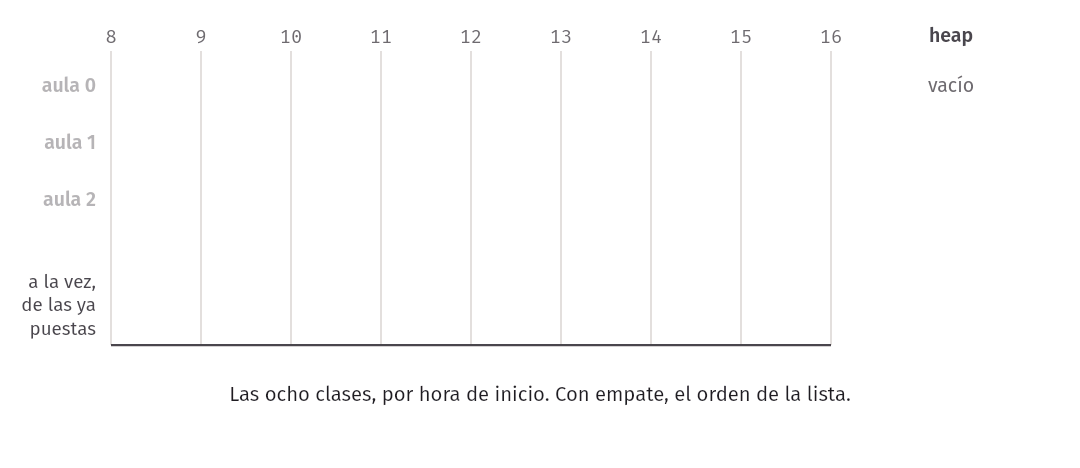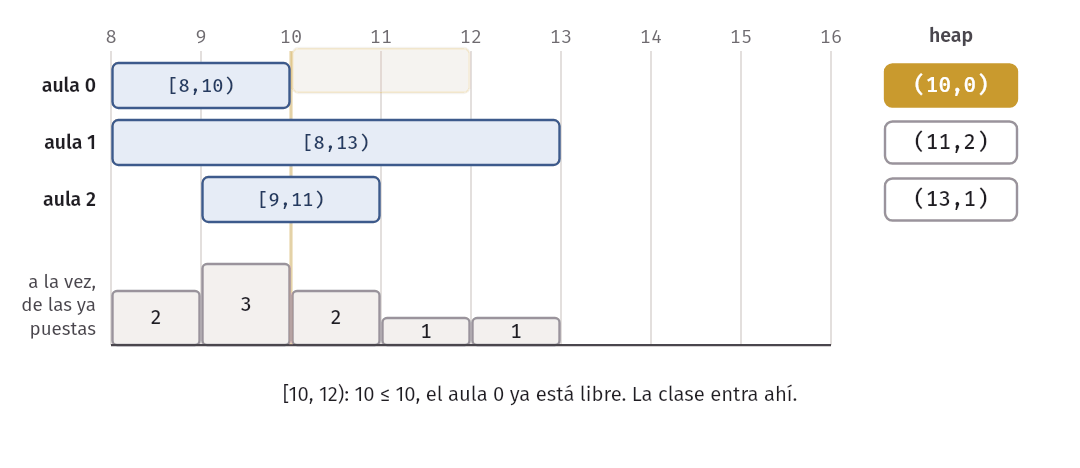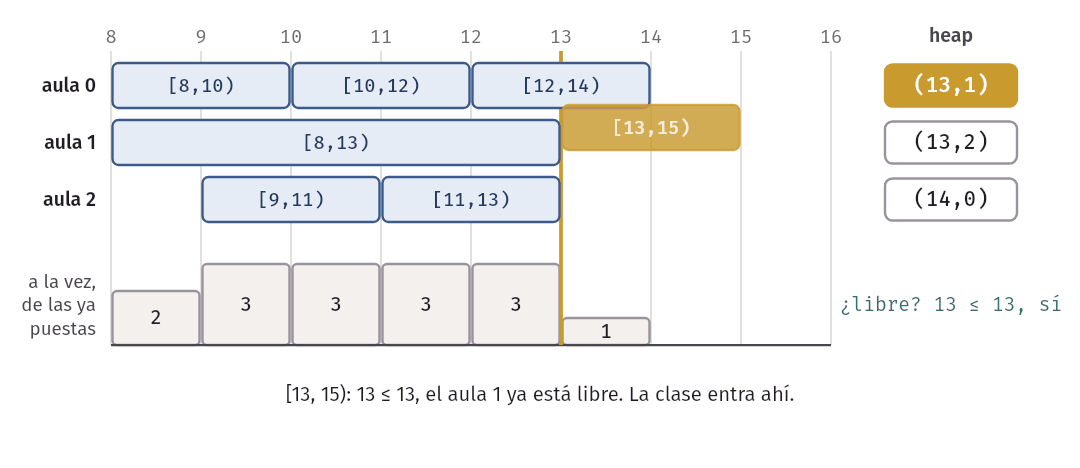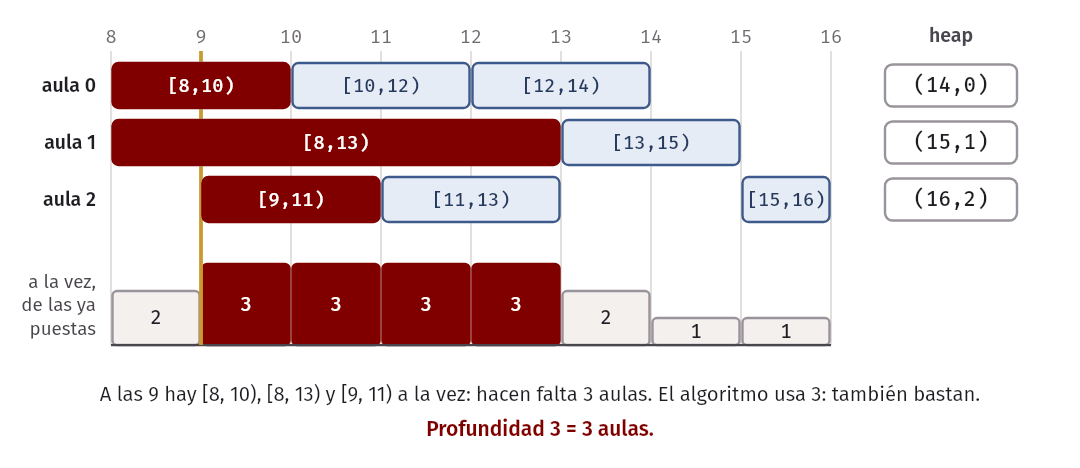
Aulas: 3, máximo simultáneo: 3
  [8,10) -> aula 0
  [9,11) -> aula 2
  [10,12) -> aula 0
  [11,13) -> aula 2
  [8,13) -> aula 1
  [12,14) -> aula 0
  [13,15) -> aula 1
  [15,16) -> aula 2
Y aquí va el caso del borde, comprobado también en el programa:
Clases [8,10) y [10,12): se cruzan = no, aulas = 1inline std::vector<int> assign_rooms(const std::vector<Interval>& classes) {
std::vector<std::size_t> order(classes.size());
for (std::size_t i = 0; i < order.size(); i++) order[i] = i;
std::sort(order.begin(), order.end(), [&](std::size_t x, std::size_t y) {
if (classes[x].start != classes[y].start) return classes[x].start < classes[y].start;
return x < y; // con empate, el orden de entrada: así el resultado no depende de std::sort
});
using RoomEnd = std::pair<int, int>; // (hora en que se desocupa, aula)
std::priority_queue<RoomEnd, std::vector<RoomEnd>, std::greater<RoomEnd>> busy;
std::vector<int> room(classes.size());
int opened = 0;
for (std::size_t i : order) {
if (!busy.empty() && busy.top().first <= classes[i].start) {
room[i] = busy.top().second;
busy.pop();
} else {
room[i] = opened++;
}
busy.push({classes[i].finish, room[i]});
}
return room;
}En C++.
std::priority_queueda el mayor por defecto. Para tener el menor arriba hay que pasarlestd::greater, y por eso aparece el tercer parámetro del template. Ystd::pairse compara primero por el primer campo, que aquí es la hora.
Demostración
Teorema. asignar_aulas produce una asignación válida con exactamente d aulas, donde d es la profundidad.
Técnica. Alcanzar la cota inferior: ver que el algoritmo nunca usa más de lo que la cota obliga.
Validez. Una clase c se pone en un aula solo si la hora en que se libera esa aula es ≤ s(c). Esa hora es el fin de la última clase puesta en esa aula. Así que dentro de cada aula, cada clase empieza en o después del fin de la anterior. Por la misma cuenta de la Afirmación 1, las clases de un aula son compatibles de a pares.
A lo sumo d aulas. Supongamos que el algoritmo abre el aula número k, contada desde 1, al procesar la clase c. Eso pasa solo si el mínimo del heap es mayor que s(c), o sea, las k − 1 aulas abiertas se liberan todas después de s(c). Cada una tiene una última clase c′ con f(c′) > s(c). Además, c′ ya fue procesada, y como se procesa por inicio, s(c′) ≤ s(c). Es decir, c′ contiene al instante s(c). Las k − 1 clases c′, junto con c misma, son k clases que contienen a s(c). Por lo tanto, la profundidad es d ≥ k. Eso vale para todo k, incluido el último. El algoritmo usa a lo sumo d aulas.
Al menos d aulas. Es la cota inferior que ya demostramos. Ninguna asignación, ni esta, puede usar menos.
Juntando las dos, usa exactamente d aulas, y nadie puede usar menos. ∎
Idea clave. Esta es otra forma de demostrar un greedy, además del intercambio. Se busca una cota inferior que toda solución deba pagar y luego se muestra que el algoritmo la paga exactamente. Si a una cota se le puede dar alcance, no hace falta comparar con ninguna solución óptima.
Contar sin asignar
Si solo hace falta el número de aulas, no hay que asignar nada: basta calcular la profundidad, recorriendo los inicios y fines en orden y llevando la cuenta.
inline int max_simultaneous(const std::vector<Interval>& classes) {
    std::vector<std::pair<int, int>> events;
    for (const Interval& c : classes) {
        events.push_back({c.start, +1});
        events.push_back({c.finish, -1});
    }
    std::sort(events.begin(), events.end());
    int now = 0;
    int most = 0;
    for (const auto& event : events) {
        now += event.second;
        most = std::max(most, now);
    }
    return most;
}
Error común. Procesar los inicios antes que los fines cuando coinciden en el mismo instante. Con [8, 10) y [10, 12), eso cuenta 2 clases a la vez en el instante 10, y da una aula de más. Como
-1 < +1, ordenar los pares deja los fines primero, que es lo que dice el intervalo semiabierto.
El patrón de una demostración greedy
Con estos dos ejemplos ya se ve el método que seguiremos las próximas semanas.
- Escribir la regla con precisión, incluyendo qué pasa con los empates.
- Buscar un contraejemplo a la regla, y a las reglas parecidas. Si aparece, se acabó. Si no aparece, no prueba nada.
- Demostrar la validez. Suele ser corta, y no es lo importante.
- Demostrar la optimalidad, por una de dos vías:
- Intercambio: transformar una solución óptima en la del greedy sin empeorarla.
- Cota inferior alcanzada: mostrar un número que toda solución debe pagar, y que el greedy paga exactamente.
- Analizar el costo, que casi siempre es el de ordenar.
En la práctica. Un pequeño cambio en el problema puede hacer que un greedy deje de servir. Si a cada clase se le agrega un valor y se busca el máximo valor total en vez del máximo número de clases, la regla de la que termina antes ya no funciona: una sola clase muy valiosa puede cruzarse con todas las que el greedy tomó. Ese problema se resuelve con programación dinámica, la técnica de una parte posterior del curso. Antes de reutilizar un greedy, revisen en qué línea de la demostración se usa cada supuesto.
El código de la semana
En code/week-04:
| Archivo | Qué contiene |
|---|---|
comparison_sorts.h |
CountingLess, un comparador que cuenta y anota respuestas. sort_three, insertion_sort, merge_sort, ceil_log2_factorial |
counting_sort.h |
counting_sort |
quicksort.h |
quicksort_two_way y quicksort_three_way, con contadores de comparaciones, niveles y pivotes buenos |
intervals.h |
Interval, overlap, is_valid, las cuatro reglas, las fuerzas brutas, assign_rooms, max_simultaneous |
adversary.h |
Adversary, y dos ordenamientos que preguntan por posiciones de la entrada |
sort_three.cpp |
La tabla de las 6 permutaciones |
adversary_demo.cpp |
El adversario contra insertion sort y mergesort |
quicksort_trace.cpp |
Los tamaños de los rangos por nivel, con 16 elementos |
lower_bound_table.cpp |
Comparaciones reales contra la cota, y las desigualdades de log₂(n!) |
counting_bench.cpp |
Counting sort contra std::sort |
quicksort_levels.cpp |
Las tablas de quicksort y las 1000 semillas |
greedy_rules.cpp |
Los tres contraejemplos, pasados por las cuatro reglas |
rules_random.cpp |
Cuántas veces falla cada regla al azar |
interval_traces.cpp |
Los ejemplos de selección, de aulas y de la idea que falla |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. Las mediciones van con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined sort_three.cpp -o build/sort_three
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined adversary_demo.cpp -o build/adversary_demo
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined quicksort_trace.cpp -o build/quicksort_trace
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined interval_traces.cpp -o build/interval_traces
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined greedy_rules.cpp -o build/greedy_rules
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
g++ -Wall -Wextra -std=c++20 -O2 lower_bound_table.cpp -o build/lower_bound_table
g++ -Wall -Wextra -std=c++20 -O2 counting_bench.cpp -o build/counting_bench
g++ -Wall -Wextra -std=c++20 -O2 quicksort_levels.cpp -o build/quicksort_levels
g++ -Wall -Wextra -std=c++20 -O2 rules_random.cpp -o build/rules_random
build/test_examples
Todas las pruebas de la semana 4 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
sort_threeordena las 6 permutaciones con a lo sumo 3 comparaciones, y llega a 6 hojas distintas.- Ni insertion sort ni mergesort bajan de la cota entre n = 2 y n = 7, y cada permutación llega a su propia hoja.
- El adversario obliga a los dos a llegar a la cota. Si se corre insertion sort otra vez con la entrada que deja el adversario, hace exactamente las mismas comparaciones.
- La cadena de desigualdades de log₂(n!) se cumple para todo n de 4 a 100 000.
- Primer elemento como pivote, entrada ordenada: exactamente n(n − 1)/2 comparaciones. Todos iguales con partición en dos: lo mismo, aun con pivote al azar. Partición en tres: 1 nivel.
overlap({8, 10}, {10, 12})es falso, y dos clases que se tocan caben en una sola aula.- El intercambio del ejemplo sigue siendo válido en cada paso, y termina en la solución del greedy.
- Cada regla falsa da una respuesta válida y no óptima en su contraejemplo, y su primera elección no está en ninguna solución óptima.
- En 1500 instancias al azar, con muchos empates y bordes,
select_by_finishcoincide con la fuerza bruta.assign_roomsda una asignación válida, con tantas aulas como la profundidad, y la búsqueda exhaustivamin_rooms_brute, que no usa ningún teorema, da lo mismo.
El problema opcional
En esta semana, la sesión de laboratorio es la Práctica 1. El problema de la carpeta lab/class_schedule,
sobre horarios y aulas, queda como ejercicio opcional. Tiene su enunciado, un esqueleto y sus casos: entren a la
carpeta y corran make test. Los límites del enunciado merecen una cuenta antes de elegir los tipos de datos.
Resumen
- Una cota inferior habla de todos los algoritmos de un modelo, no de uno. Se demuestra con un argumento sobre el modelo, no probando programas.
- Un ordenamiento por comparaciones determinista se representa con un árbol de decisiones: nodos con comparaciones, hojas con resultados. El peor caso es la altura.
- Las n! disposiciones de la entrada deben llegar a hojas distintas, y un árbol de altura h tiene a lo sumo 2ʰ hojas. Por lo tanto, h ≥ log₂(n!).
- log₂(n!) = Θ(n log n): al menos n/2 factores valen al menos n/2, y a lo sumo son n factores de valor a lo sumo n. Para n ≥ 4, log₂(n!) ≥ (n/4) log₂ n.
- Para 3 elementos hacen falta 3 comparaciones: 2 dan a lo sumo 4 hojas, y hacen falta 6.
- La cota es sobre el peor caso: un mejor caso barato no la contradice. Y sobre el modelo: counting sort no compara, cuesta Θ(n + k), y solo sirve para enteros en un rango chico.
- Quicksort con pivote al azar: el azar está en el programa, así que no hay una entrada mala fija. Cerca de la mitad de los pivotes son razonables, y se esperan O(log n) niveles. Esto lo vimos con intuición y midiendo. Muchos elementos iguales siguen siendo un problema, y se arreglan con la partición en tres.
- Greedy: decidir con una regla y no volver atrás. Es fácil de escribir, y hay que demostrarlo.
- Los intervalos son semiabiertos: una clase que termina a las 10 no se cruza con una que empieza a las 10.
- Selección de intervalos: fallan “empieza antes”, “dura menos” y “menos cruces”. Funciona “termina antes”, con un argumento de intercambio: cambiar la primera diferencia con una solución óptima sin empeorarla, y revisar que no sobre nada al final.
- Válida no es óptima. Las reglas falsas siempre dan soluciones válidas.
- Partición de intervalos: el mínimo de aulas es la profundidad, el máximo de clases simultáneas. Es una cota inferior que el algoritmo por orden de inicio alcanza. Llenar aula por aula con la selección óptima no funciona.
Ejercicios
- ¿Cuál es ⌈log₂(n!)⌉ para n = 4? Dibujen el árbol de decisiones de un algoritmo que ordene 4 elementos con esa
cantidad de comparaciones en el peor caso. Compruébenlo como
sort_threeentest_examples.cpp, con las 24 permutaciones. - Sin usar la fórmula, muestren que n! ≤ nⁿ y que n! ≥ (n/2)^(n/2) para n = 7, escribiendo los factores. Luego expliquen por qué tirar la mitad de los factores no daña el resultado asintótico.
- Buscar en un arreglo ordenado. Una búsqueda en un arreglo de n elementos ordenados y distintos, que compara con preguntas de sí o no, puede responder cualquiera de las n posiciones o “no está”. Con un árbol de decisiones, demuestren que hace falta al menos ⌈log₂(n + 1)⌉ comparaciones en el peor caso.
- Un compañero dice: “Comprobar si un arreglo ya está ordenado cuesta n − 1 comparaciones. Entonces, si el arreglo está ordenado, ordenarlo cuesta n − 1. Esto contradice la cota.” Respondan con precisión en qué se equivoca. Luego, demuestren que todo algoritmo que compruebe que un arreglo está ordenado necesita al menos n − 1 comparaciones.
- Profundidad promedio. Demuestren por inducción que, en un árbol binario con N hojas donde cada nodo interno tiene dos hijos, la suma de las profundidades de las hojas es al menos N log₂ N. Con eso, concluyan que un ordenamiento por comparaciones determinista hace, en promedio sobre las n! entradas, al menos log₂(n!) comparaciones. Ayuda: si en un nodo solo se usa una de sus dos ramas, se puede saltar ese nodo, y las profundidades solo bajan.
- Cambien
quicksort_levels.cpppara usar como pivote la mediana de tres elementos fijos: primero, centro y último. Midan con entrada ordenada. ¿Se resolvió el problema? Con esta regla, construyan a mano una entrada de 12 elementos en la que varias particiones queden muy disparejas. - Pasen por las cuatro reglas de
greedy_rules.cppun contraejemplo propio para “dura menos” que no use el borde: que ninguna clase empiece exactamente donde otra termina. Después, escriban la regla “menos cruces” sin volver a contar: cuenten los cruces una sola vez al inicio. Comprueben que también falla con las once clases. - Por simetría. Demuestren con un argumento de intercambio que tomar la clase que empieza más tarde, entre las que caben, también da una solución óptima. ¿Qué cambia en la demostración? ¿Pueden deducirlo de lo ya demostrado, sin repetirla?
- Mantenerse adelante. Demuestren de otra forma que “termina antes” es óptima. Sean g₁, …, gₖ las clases del greedy y x₁, …, xₘ otra solución válida, por orden de fin. Demuestren por inducción que f(gᵢ) ≤ f(xᵢ) para todo i ≤ min(k, m), y deduzcan que k ≥ m.
- Clases con valor. Cada clase tiene un valor, y se busca el máximo valor total. Den un contraejemplo para “termina antes” y otro para “mayor valor primero”. Ejecútenlos con una función de fuerza bruta propia.
- Archivos en cinta. Hay n archivos con tamaños ℓ₁, …, ℓₙ en una cinta que se lee desde el inicio. Leer un archivo cuesta la suma de los tamaños desde el inicio hasta terminarlo. Todos se piden con la misma frecuencia. Demuestren con un intercambio de dos archivos vecinos que el orden de menor a mayor minimiza el costo promedio. Comprueben con todas las permutaciones de 6 archivos.
- Escriban una función que, con las clases y una respuesta de
assign_rooms, compruebe que la asignación es válida. Luego cambien enassign_roomsel<=por<, y encuentren la prueba detest_examples.cppque lo detecta. Expliquen qué significa esa prueba en términos del aula.