Apuntes · Capítulo 5Greedy y grafos
Huffman y Dijkstra, demostrados
Huffman y Dijkstra, demostrados
La semana pasada vimos el método para trabajar con greedy: escribir la regla, buscarle contraejemplos a ella y a sus parecidas, y demostrarla con un intercambio o con una cota inferior que el algoritmo alcanza. Lo aplicamos a clases en aulas, un problema pequeño. Esta semana lo aplicamos a tres problemas más serios, y dos de ellos ya los conocen.
En Estructuras de Datos armaron un compresor con Huffman y calcularon rutas sobre un mapa con Dijkstra. Programaron los dos, los probaron con archivos y mapas reales, y vieron que funcionaban. Lo que no hicimos fue demostrar que dan la mejor respuesta posible. Eso es lo que falta, y es lo que hacemos aquí. Esta semana no volvemos a enseñar esos algoritmos: los damos por conocidos y nos dedicamos a demostrarlos.
La primera sesión empieza con un problema nuevo, minimizar el retraso máximo, cuya demostración usa de otra forma las inversiones de la semana 2. Después viene Huffman, que necesita algo que no hemos usado todavía: un intercambio y además una inducción. La segunda sesión demuestra Dijkstra con un invariante, señala la línea exacta en la que hacen falta los pesos no negativos, y termina con una idea que amplía mucho lo que Dijkstra puede resolver: si importa algo más que el nodo, ese algo entra en el nodo.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción; de Minimizar el retraso máximo, el planteamiento y Dos reglas que fallan; Huffman: qué hay que demostrar; y de Dijkstra como greedy, El enunciado y Dos hechos previos.
En clase: Sesión A, Minimizar el retraso máximo, Huffman: qué hay que demostrar y Huffman: la demostración. Sesión B, Dijkstra como greedy y El grafo de estados.
Después de clase: Tres demostraciones, comparadas, el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El laboratorio y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, sec. 4.4 (Huffman Codes). CLRS, capítulo Greedy Algorithms, 4.ª edición. Sesión B: Erickson, secs. 8.3 (The Only SSSP Algorithm) y 8.6 (Best-First: Dijkstra’s Algorithm). CLRS, capítulo Single-Source Shortest Paths, 4.ª edición. Estos apuntes se pueden estudiar sin ellos, y para el retraso máximo son el texto.
Código. Los programas de este capítulo están en
code/week-05. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El problema de laboratorio está enlab/toll_routesy tiene su propiomake test.
Minimizar el retraso máximo
Un taller tiene una sola máquina y una lista de trabajos para hoy. Cada trabajo tiene una duración y un plazo, el instante en que el cliente lo espera. La máquina hace un trabajo a la vez y no lo interrumpe. Puede que no todos lleguen a tiempo, así que el dueño quiere repartir el daño: que el trabajo que más se atrase se atrase lo menos posible.
Definiciones. Hay n tareas. La tarea i tiene una duración tᵢ > 0 y un plazo dᵢ. Un horario es un orden de las tareas, sin tiempo muerto: la primera empieza en el instante 0, y cada una empieza justo cuando termina la anterior. Si fᵢ es el instante en que termina la tarea i en ese horario, su retraso (lateness) es
Lᵢ = fᵢ - dᵢEl retraso es negativo si la tarea termina antes de su plazo. El retraso máximo del horario es el mayor Lᵢ, y se busca un horario que lo minimice.
Dos comentarios sobre estas definiciones, para que nada quede colgando.
¿Por qué sin tiempo muerto? Porque no se pierde nada. Si un horario deja la máquina parada en algún momento, se adelanta todo lo que viene después hasta cerrar el hueco. Ninguna tarea termina más tarde, así que ningún retraso sube. Un mejor horario, si existe, existe también sin tiempo muerto. Por eso basta buscar entre las n! permutaciones.
¿Y si solo cuentan los atrasos de verdad? A veces se define el retraso como max(0, fᵢ − dᵢ), sin valores negativos. El máximo de esa cantidad es max(0, máximo de los Lᵢ), que crece con el máximo de los Lᵢ. Así que un horario que minimiza nuestro retraso máximo también minimiza ese otro. Usamos la versión con signo porque la demostración queda sin casos.
Dos reglas que fallan
Antes de demostrar nada, probemos ideas razonables. Hay dos que suenan bien.
- La que dura menos primero. Sacarse rápido lo que se pueda.
- La que tiene menos holgura primero. La holgura de una tarea es dᵢ − tᵢ, cuánto puede esperar sin atrasarse. Tiene pinta de ser la más urgente.
La función brute_min_max_lateness prueba todas las permutaciones y da el óptimo verdadero. Corramos build/lateness_rules:
$ build/lateness_rules
Contra dura menos:
  tareas (duración, plazo): A(1, 100) B(10, 10)
  óptimo por fuerza bruta: 0
  dura menos   : 1  orden AB
  menos holgura: 0  orden BA
  plazo antes  : 0  orden BA
Contra menos holgura:
  tareas (duración, plazo): A(1, 2) B(10, 10)
  óptimo por fuerza bruta: 1
  dura menos   : 1  orden AB
  menos holgura: 9  orden BA
  plazo antes  : 1  orden AB
En el primer bloque, A puede esperar hasta el instante 100, y hacerla primero le roba a B la unidad de tiempo que necesitaba. En el segundo, B tiene holgura 0 y A tiene holgura 1, así que “menos holgura” pone primero a B. Entonces A termina en 11 con plazo 2, y el retraso es 9. Haciendo A primero, B se atrasa apenas 1.
La duración de una tarea no dice nada sobre su urgencia. La holgura mezcla las dos cosas de una forma engañosa. La tercera regla de la salida no acierta aquí por casualidad.
La regla correcta: el plazo más cercano
Se ordenan las tareas por plazo, de menor a mayor, y se hacen en ese orden. A primera vista es casi insultante, porque no mira las duraciones.
algoritmo plazo_mas_cercano(tareas, n)
    ordenar tareas por plazo, de menor a mayor
    ahora ← 0
    maximo ← -∞
    para i desde 0 hasta n - 1 hacer
        ahora ← ahora + tareas[i].duracion
        maximo ← max(maximo, ahora - tareas[i].plazo)
    fin para
    devolver maximo
fin algoritmo
El costo es el de ordenar, O(n log n). Sigamos un ejemplo con cinco tareas. D y E tienen el mismo plazo, a propósito.
$ build/lateness_trace
tarea  duración  plazo  fin  retraso
  B         2      4    2       -2
  A         3      5    5        0
  C         1      7    6       -1
  D         4      9   10        1
  E         2      9   12        3
retraso máximo: 3

tarea  duración  plazo  fin  retraso
  B         2      4    2       -2
  A         3      5    5        0
  C         1      7    6       -1
  E         2      9    8       -1
  D         4      9   12        3
retraso máximo: 3
La segunda tabla cambia D y E de lugar, y el retraso máximo no se mueve. Los retrasos individuales sí cambian: D pasó de 1 a 3 y E de 3 a −1. Pero las dos juntas ocupan el mismo tramo, de 6 a 12, y la que termina última termina en 12 con plazo 9, sea cual sea. Esa observación es uno de los pasos de la demostración.
Demostración con inversiones
La semana 2 definió una inversión como un par de elementos en el orden contrario al esperado, y vimos que un arreglo sin inversiones está ordenado. Aquí se aplica lo mismo, con un cuidado adicional en los empates.
Definición. Una inversión de un horario es un par de tareas (i, j) tal que i va antes que j, en cualquier posición, y dᵢ > dⱼ. La desigualdad es estricta: dos tareas con el mismo plazo nunca forman una inversión.
El algoritmo produce un horario sin inversiones, y eso vale para cualquier forma de romper los empates del ordenamiento. Lo que vamos a demostrar es lo siguiente.
Teorema. El horario del plazo más cercano tiene el menor retraso máximo posible.
Técnica. Argumento de intercambio, en una versión un poco distinta a la de la semana pasada. En vez de arreglar la primera diferencia con el greedy, se van quitando inversiones de una solución óptima, sin empeorarla. La demostración tiene tres lemas y un cierre.
Lema 1: si hay una inversión, hay una inversión entre vecinas. Supongamos que ningún par de tareas vecinas está invertido. Entonces los plazos no bajan nunca al recorrer el horario, d₍₁₎ ≤ d₍₂₎ ≤ ⋯ ≤ d₍ₙ₎, y por transitividad ningún par está invertido, vecino o no. Leído al revés, es el lema. ∎
Lema 2: cambiar dos vecinas invertidas no sube el retraso máximo, y quita exactamente una inversión. Sean i y j vecinas, con i justo antes que j y dᵢ > dⱼ. Sea s el instante en que empieza i. Antes del cambio:
fᵢ = s + tᵢ fⱼ = s + tᵢ + tⱼDespués del cambio, j empieza en s:
f′ⱼ = s + tⱼ f′ᵢ = s + tᵢ + tⱼ = fⱼVeamos cada tarea.
- Las demás tareas no cambian. Las de antes no se enteran. Las de después tampoco, porque las dos juntas siguen ocupando el tramo de s a s + tᵢ + tⱼ. Aquí se usa que son vecinas.
- La tarea j no empeora. Termina antes que antes: f′ⱼ < fⱼ. Su retraso baja.
- La tarea i sí empeora, pero no pasa del viejo retraso de j. Ahora termina donde terminaba j, y tiene un plazo mayor:
L′ᵢ = f′ᵢ - dᵢ = fⱼ - dᵢ < fⱼ - dⱼ = LⱼLos dos nuevos retrasos son a lo sumo Lⱼ, el retraso anterior de j, y este es a lo sumo el máximo anterior. Por lo tanto, el máximo no sube.
Para las inversiones: el único par que cambió de orden relativo es (i, j). Cualquier otra tarea queda antes de las dos o después de las dos, igual que antes. Se fue la inversión (i, j), y no apareció ninguna. ∎
Lema 3: todos los horarios sin inversiones tienen el mismo retraso máximo. Tomemos un horario sin inversiones. Las tareas con un mismo plazo d están seguidas: si entre dos tareas de plazo d hubiera una de otro plazo c, esa formaría una inversión con la primera (si c < d) o con la segunda (si c > d). Además, los bloques van de plazo menor a plazo mayor. Por eso, dos horarios sin inversiones solo pueden diferir en el orden dentro de cada bloque.
Fijemos un plazo d. El bloque empieza en la suma a de las duraciones de todas las tareas con plazo menor que d, y termina en esa suma más las duraciones del bloque, llamémosla b. Ninguno de esos dos números depende del orden interno. Dentro del bloque todas tienen el mismo plazo, así que la de mayor retraso es la que termina última, y esa termina en b. El retraso máximo del bloque es b − d, para cualquier orden interno. El retraso máximo del horario es el mayor de estos valores entre todos los bloques, que tampoco depende del orden interno. ∎
Cierre. Sea O un horario óptimo, sin tiempo muerto. Si O tiene alguna inversión, por el Lema 1 tiene una entre vecinas, y la cambiamos. Por el Lema 2, el máximo no sube y hay una inversión menos. Como hay a lo sumo n(n − 1)/2 inversiones, después de un número finito de cambios llegamos a un horario O* sin inversiones, con retraso máximo a lo sumo el de O. Por el Lema 3, O* tiene el mismo retraso máximo que el horario del plazo más cercano, que tampoco tiene inversiones. Entonces el plazo más cercano tiene retraso máximo a lo sumo el de O, y O era óptimo. ∎
Veamos los cambios del Lema 2 en el ejemplo, empezando desde un horario malo. Como en el ordenamiento de burbuja, solo se cambian vecinas invertidas, y la columna de inversiones baja de a uno, como vimos en la semana 2 al intercambiar elementos vecinos.
orden  inversiones  retraso máximo  se cambia
DCEAB         8             8          DC
CDEAB         7             8          EA
CDAEB         6             8          DA
CADEB         5             8          CA
ACDEB         4             8          EB
ACDBE         3             6          DB
ACBDE         2             3          CB
ABCDE         1             3          AB
BACDE         0             3          ninguna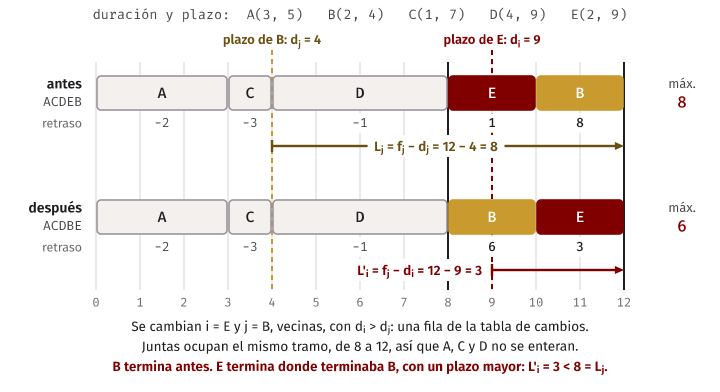
El retraso máximo nunca sube, y muchas veces no baja: un cambio puede dejarlo igual. Fíjense también en el final: BACDE tiene a D antes que E, igual que el horario inicial. Esos dos nunca se cambian, porque no forman inversión. Si un horario terminara con E antes que D, seguiría sin inversiones, y por el Lema 3 tendría el mismo máximo: es la segunda tabla de arriba.
Error común. Cambiar dos tareas invertidas que no son vecinas y creer que vale el mismo argumento. Las tareas del medio se corren, y pueden empeorar. Con X(1, 5), M(1, 2) e Y(5, 4), el par (X, Y) está invertido, y cambiarlo sube el máximo. Por eso el Lema 1 busca una inversión entre vecinas: las inversiones lejanas se quitan con varios cambios de vecinas.
X(1, 5) M(1, 2) Y(5, 4)
orden XMY: retraso máximo 3
orden YMX: retraso máximo 4
¿Qué línea falla con las reglas que no sirven? Con “la que dura menos”, el horario final puede tener inversiones, y ningún lema dice que eso sea óptimo. El Lema 2 es cierto para cualquier horario, pero solo sirve para comparar contra un horario sin inversiones, y el orden por duración no lo es. Si A(1, 100) va antes que B(10, 10), la demostración indica que el cambio no empeora nada, y en este caso lo mejora.
inline std::vector<int> order_by_deadline(const std::vector<Job>& jobs) {
    return order_by(jobs, [](const Job& job) { return job.deadline; });
}
order_by usa std::stable_sort, así que a igual plazo se conserva el orden de la lista. Por el Lema 3, eso no afecta
el resultado, y std::sort daría el mismo retraso máximo. Los retrasos son long long: si hay muchas tareas largas, el
fin de la última es la suma de todas las duraciones.
Idea clave. No hace falta que el horario óptimo sea único. Hay muchos, y aquí tampoco importa cuál se toma: el argumento los lleva a todos, sin empeorar, hasta un horario sin inversiones. Y todos esos valen lo mismo.
Huffman: qué hay que demostrar
Este problema ya lo conocen. Recordemos solo lo que necesita la demostración.
Un código sin prefijos comunes es un árbol binario con los símbolos en las hojas: el código de cada símbolo es el camino desde la raíz hasta su hoja. Si el símbolo x aparece f(x) veces y su hoja está a profundidad d(x), el texto codificado usa
costo(T) = suma de f(x) · d(x), sobre todos los símbolos xbits. Huffman une repetidamente los dos árboles de menor peso, donde el peso de un árbol es la suma de las frecuencias de sus hojas, hasta que queda uno solo. En Estructuras de Datos lo escribieron con un heap en O(n log n).
Vamos a fijar el enunciado con cuidado.
- Hay n ≥ 2 símbolos, todos con frecuencia positiva. Un símbolo que no aparece no necesita código. Con un solo símbolo el árbol sería una hoja sin bits, y no hay nada que decidir.
- Comparamos contra todos los árboles en los que los símbolos son exactamente las hojas. Pueden tener nodos con un solo hijo. Eso hay que descartarlo con un argumento, y no suponerlo.
- Cuando hay empates de peso, Huffman puede elegir de varias formas, y puede salir más de un árbol. El teorema tiene que valer para cualquier elección.
Teorema. Con cualquier forma de romper los empates, Huffman da un árbol de costo mínimo entre todos los árboles de ese conjunto de símbolos. Esto se dice también así: da un código óptimo entre los códigos sin prefijos comunes.
Ideas parecidas que fallan
Antes de demostrarlo, dos ideas que también suenan bien. La primera se conoce como el método de Shannon-Fano: dividir de arriba hacia abajo. Se ordenan los símbolos de mayor a menor frecuencia, se parte la lista donde las dos sumas queden lo más parejas posible, y se repite con cada parte. Cada bit divide las frecuencias a la mitad, más o menos, y eso parece lo mejor que un bit puede hacer. La segunda es un código en cadena: 0, 10, 110, 1110, con los más frecuentes arriba.
brute_min_cost es nuestro árbitro. Un árbol en el que todo nodo interno tiene dos hijos se arma con n − 1 uniones en
algún orden, así que probando todas las uniones posibles, sin ninguna regla, recorremos todos esos árboles.
$ build/huffman_rules
frecuencias: 15 7 6 6 5
  mejor árbol, por búsqueda exhaustiva: 87
  dividir parejo: 89  profundidades 2 2 2 3 3
  en cadena     : 91  profundidades 1 2 3 4 4
  Huffman       : 87  profundidades 1 3 3 3 3
frecuencias: 1 1 1 1 1 1 1 1
  mejor árbol, por búsqueda exhaustiva: 24
  dividir parejo: 24  profundidades 3 3 3 3 3 3 3 3
  en cadena     : 35  profundidades 1 2 3 4 5 6 7 7
  Huffman       : 24  profundidades 3 3 3 3 3 3 3 3
Dividir parejo pierde por poco, 89 contra 87, y por eso cuesta tanto detectarlo con ejemplos. Con 15, 7, 6, 6, 5, el primer corte es {15, 7} contra {6, 6, 5}, con sumas 22 y 17, y baja el 15 a profundidad 2. El mejor árbol lo deja solo a profundidad 1, y paga con los demás a profundidad 3. La diferencia con Huffman es la dirección: dividir parejo decide primero lo de arriba, y Huffman decide primero lo de abajo.
Empates
Antes de la demostración, miremos cuánto pueden cambiar las cosas los empates. huffman_all_ties recorre todas las
maneras de elegir un par en cada paso, entre los pares cuyos pesos son los dos menores.
Todas las formas de romper los empates:
frecuencias: 1 1 2 2
  profundidades 2 2 2 2  costo 12
  profundidades 3 3 1 2  costo 12
  profundidades 3 3 2 1  costo 12
frecuencias: 1 1 2 3 5 8
  profundidades 5 5 4 3 2 1  costo 45
Con 1, 1, 2, 2: se unen los dos 1 en un árbol de peso 2, y quedan tres árboles de peso 2. Se pueden unir dos cualesquiera, y salen árboles de formas distintas. Uno es balanceado y otro no, pero cuestan lo mismo. Por eso el enunciado no dice “el árbol óptimo”: puede haber varios.
Con 1, 1, 2, 3, 5, 8 también hay pesos repetidos, pero esos empates no llevan a ninguna parte. Los dos 1 se unen sí o sí, y después el 2 de la lista y el 2 recién armado también. Lo único que cambia es cuál queda a la izquierda, y sale una sola lista de profundidades, con costo 45.
Huffman: la demostración
Técnica. Dos lemas, y una inducción sobre el número de símbolos. Primero se demuestra que en algún árbol óptimo los dos símbolos menos frecuentes son hermanos en el nivel más profundo. Después se reduce el problema a uno con un símbolo menos.
Fijemos notación. x e y son dos símbolos que Huffman podría elegir en su primer paso. Es decir, f(x) ≤ f(y) y todo otro símbolo z cumple f(y) ≤ f(z). Con empates hay varios pares así, y cualquiera sirve. Noten que, por eso mismo, x tiene una frecuencia menor o igual que cualquier otro símbolo, e y tiene una frecuencia menor o igual que cualquiera distinto de x.
Primer paso: un árbol óptimo no tiene nodos con un solo hijo
Primero, hay que poder hablar de un árbol óptimo, y los árboles son infinitos si se permiten nodos con un solo hijo. El Lema A muestra cómo sacar esos nodos bajando el costo. Y los árboles sin esos nodos, con n hojas, son una cantidad finita. Por eso existe un árbol de costo mínimo.
Lema A. En un árbol de costo mínimo, todo nodo interno tiene exactamente dos hijos. A un árbol así se le llama árbol binario lleno (full binary tree).
Demostración, por contradicción. Supongamos que T es óptimo y que un nodo u tiene un solo hijo v. Quitemos u y pongamos a v en su lugar. Sigue siendo un árbol con los mismos símbolos en las hojas. Todas las hojas debajo de v suben un nivel, y las demás no cambian. Debajo de v hay al menos una hoja, con frecuencia positiva, así que el costo baja estrictamente. Contradicción con que T era óptimo. ∎
Aquí es donde se usa la frecuencia positiva. Con frecuencias cero, el costo podría quedar igual, y el lema tendría que decir “existe un óptimo así”.
Consecuencia. En un árbol lleno con al menos dos hojas, una hoja de profundidad máxima tiene un hermano, y ese hermano también es una hoja. Tiene hermano porque su padre tiene dos hijos. Si el hermano tuviera hijos, habría algo más profundo que la hoja de profundidad máxima, y eso es imposible.
Segundo paso: el intercambio
Lema B. Existe un árbol óptimo en el que x e y son hermanos, en el nivel más profundo.
Primero, la cuenta que hace falta. Si en un árbol se cambian de lugar dos símbolos p y q, con profundidades d(p) y d(q), solo cambian dos términos de la suma:
costo nuevo - costo viejo = f(p)·d(q) + f(q)·d(p) - f(p)·d(p) - f(q)·d(q)
                          = (f(p) - f(q)) · (d(q) - d(p))
Si p es a lo sumo tan frecuente como q, y q está al menos tan profundo como p, ese producto es menor o igual que cero. Es decir: mandar hacia abajo lo menos frecuente nunca empeora.
Demostración. Sea T un árbol óptimo, lleno por el Lema A, y sea D su profundidad máxima. Por la consecuencia de arriba, hay dos hojas hermanas a profundidad D. Vamos a poner ahí a x y a y. Hay que tener cuidado, porque x o y pueden ya estar en ese par.
Poner a x. Si x ya está en el par, no se hace nada. Si no, por lo menos una de las dos hojas del par no es y. Llamemos a a esa hoja, y cambiemos de lugar x con a. Como f(x) ≤ f(a), y a está a profundidad D ≥ d(x), la cuenta da un cambio menor o igual que cero. La hoja y no se movió.
Poner a y. Ahora x está en el par. Sea b el otro símbolo del par. Si b = y, ya terminamos. Si no, b es distinto de x, así que f(y) ≤ f(b). Y b está a profundidad D ≥ d(y). Cambiamos y con b, y otra vez la cuenta da un cambio menor o igual que cero. x no se movió.
Cambiar símbolos de lugar no altera la forma del árbol, así que seguimos con hermanos a profundidad D. El costo no subió, y T era óptimo, así que el árbol resultante también es óptimo. ∎
Con números: el árbol de abajo no es óptimo, y lo usamos solo para ver que los cambios no suben el costo.
$ build/huffman_trace
Intercambio, con frecuencias 1 2 3 4:
  árbol inicial:    profundidades 1 2 3 3  costo 26
  cambia 1 con 3:   profundidades 3 2 1 3  costo 22
  cambia 2 con 4:   profundidades 3 3 1 2  costo 20
  Huffman:          profundidades 3 3 2 1  costo 19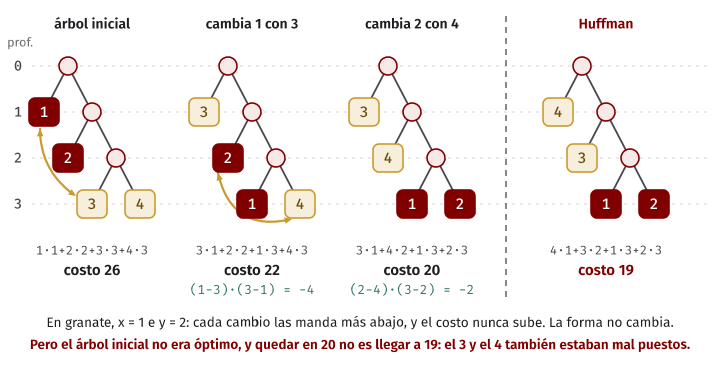
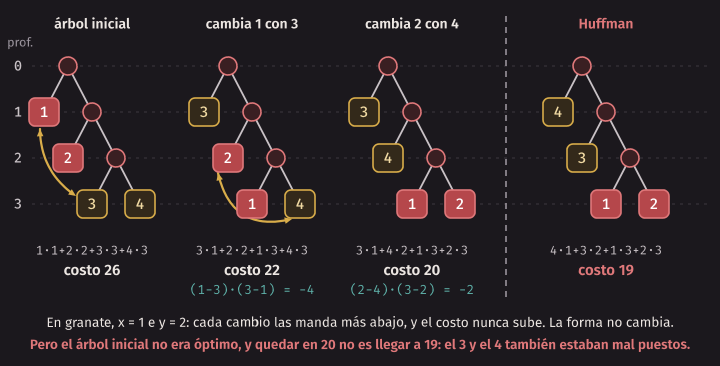
Lean la última fila con atención. Tras los dos cambios, el 1 y el 2 están abajo, y el costo bajó a 20. Pero el mejor es 19: el 3 y el 4 también estaban mal puestos. El intercambio no construye un árbol óptimo. Solo dice dónde pueden ir x e y en un árbol que ya era óptimo. No dice nada sobre el resto del árbol.
Error común. Creer que el intercambio ya termina la demostración. El Lema B habla de la primera unión. Huffman hace n − 1 uniones, y las siguientes son sobre árboles, no sobre símbolos. Todavía hay que justificar por qué repetir la misma regla sigue siendo correcto, y eso es lo que hace la inducción.
Tercer paso: reemplazar dos símbolos por uno
Sea C el conjunto de símbolos. Formemos C′ quitando x e y y agregando un símbolo nuevo z con f(z) = f(x) + f(y). Tiene un símbolo menos.
Lema C (relación de costos). Sea T un árbol sobre C donde x e y son hojas hermanas, y sea T′ el árbol sobre C′ que se obtiene quitando esas dos hojas y poniendo z en su padre. Entonces
costo(T) = costo(T′) + f(x) + f(y)Y la correspondencia funciona en los dos sentidos: todo árbol T′ sobre C′ da un árbol T sobre C, cambiando la hoja z por un nodo con x e y como hijos, y la igualdad vale igual.
Demostración. Sea h la profundidad de z en T′. Entonces x e y están a profundidad h + 1 en T. Los demás símbolos tienen la misma profundidad en los dos árboles, y sus términos se cancelan. Queda:
f(x)·(h + 1) + f(y)·(h + 1) = (f(x) + f(y))·h + f(x) + f(y) = f(z)·h + f(x) + f(y)que es el término de z en T′ más f(x) + f(y). ∎
Cuarto paso: la inducción
Teorema. Para todo n ≥ 2, en todo conjunto de n símbolos con frecuencias positivas, y con cualquier forma de romper los empates, Huffman da un árbol de costo mínimo.
Técnica. Inducción sobre n. La hipótesis se enuncia para todo conjunto de n − 1 símbolos y toda forma de romper los empates, porque la vamos a aplicar a un conjunto C′ que no conocemos de antemano.
Caso base, n = 2. Huffman une los dos símbolos, y deja a cada uno a profundidad 1, con costo f(x) + f(y). Ningún árbol puede costar menos: un símbolo a profundidad 0 sería la raíz, y entonces sería una hoja sin lugar para el otro. Así que los dos están a profundidad al menos 1.
Paso, n ≥ 3. Sea x, y el par que Huffman une primero, sea H el árbol que da al final, y sea C′ el conjunto reducido, con z = x + y.
Lo que hace Huffman después de la primera unión es correr sobre C′. El árbol con raíz z se comporta exactamente como un símbolo de frecuencia f(z). Las n − 2 uniones restantes son una corrida de Huffman sobre C′, con alguna forma de romper los empates, y dan un árbol H′. H es H′ con la hoja z reemplazada por el nodo con hijos x e y. Por la hipótesis de inducción, H′ es óptimo sobre C′.
La relación aplicada a H. Por el Lema C, en el sentido de T′ hacia T:
costo(H) = costo(H′) + f(x) + f(y)La relación aplicada a un óptimo. Por el Lema B, existe un árbol óptimo T* sobre C con x e y hermanos. Sea T*′ el árbol sobre C′ que se obtiene de T* quitando esas dos hojas. Por el Lema C, en el sentido de T hacia T′:
costo(T*) = costo(T*′) + f(x) + f(y)Se comparan. Como H′ es óptimo sobre C′, y T*′ es un árbol sobre C′, costo(H′) ≤ costo(T*′). Sumando f(x) + f(y):
costo(H) = costo(H′) + f(x) + f(y) ≤ costo(T*′) + f(x) + f(y) = costo(T*)H cuesta a lo sumo lo que cuesta un árbol óptimo. Entonces H es óptimo. ∎
Fíjense en qué papel cumple cada pieza. El Lema B garantiza que comprometerse con x e y hermanos no descarta al óptimo. La inducción dice que el resto se resuelve bien. El Lema C, usado dos veces, conecta los dos problemas: una vez para H y otra para T*. Sin el segundo uso no habría forma de comparar H con un árbol óptimo.
La inducción, con números
Con 1, 1, 2, 3, 5, 8, cada fila reemplaza los dos menores por su suma, como la inducción. El costo de cada fila es el costo de la siguiente más x + y, que es el Lema C.
Inducción, reemplazando los dos menores por su suma:
alfabeto                 x   y   costo = costo del siguiente + x + y
1 1 2 3 5 8              1   1     45 = 43 + 1 + 1
2 2 3 5 8                2   2     43 = 39 + 2 + 2
3 4 5 8                  3   4     39 = 32 + 3 + 4
5 7 8                    5   7     32 = 20 + 5 + 7
8 12                     8  12     20 = 0 + 8 + 12
La última fila es el caso base. Desenrollando la igualdad, el costo total es la suma de los pesos de todas las uniones: 2 + 4 + 7 + 12 + 20 = 45. Es otra forma de ver el costo: cada unión baja un nivel a todas sus hojas, y eso agrega exactamente su peso. Las pruebas comprueban que las dos cuentas siempre dan lo mismo.
El árbol tiene forma de cadena, porque cada suma sigue siendo de las más pequeñas de la lista.
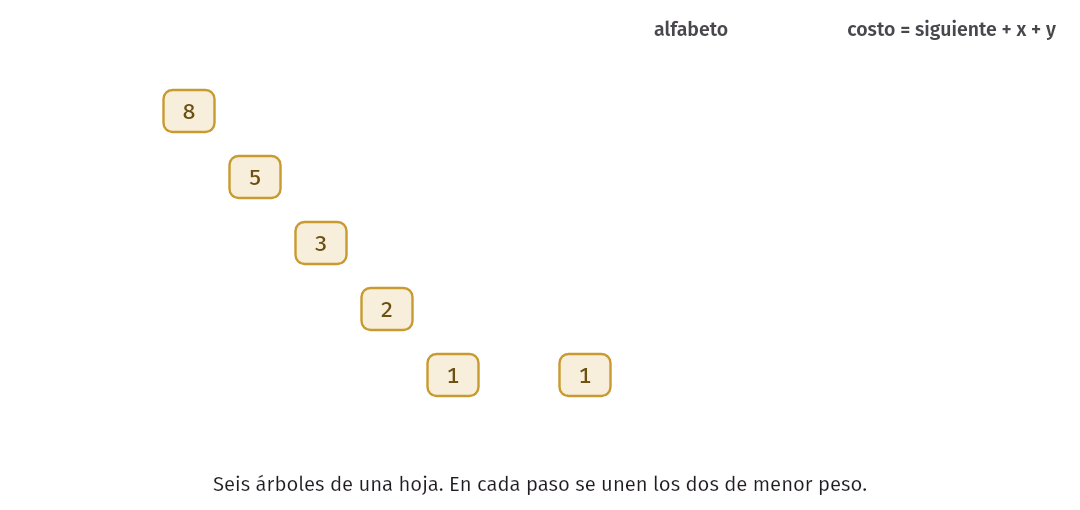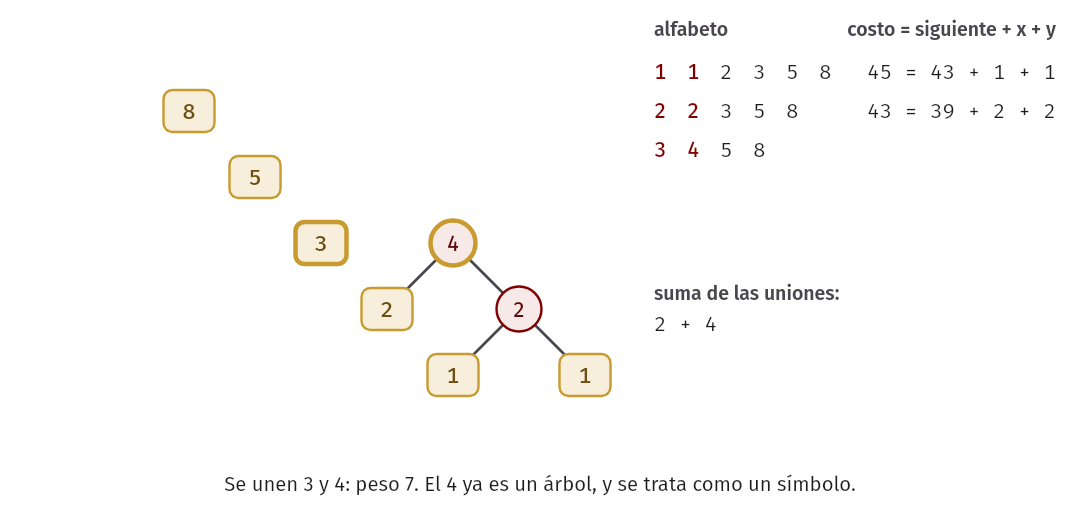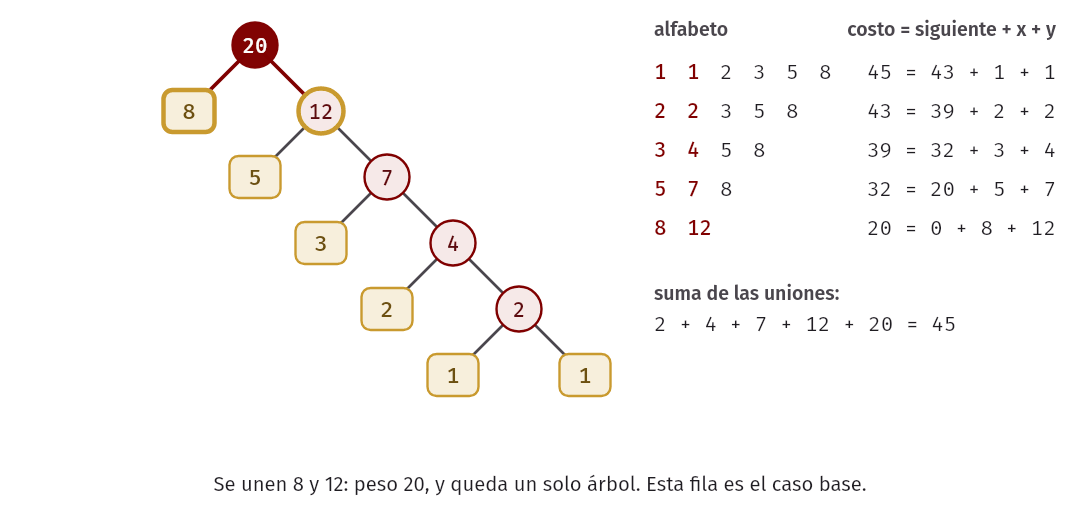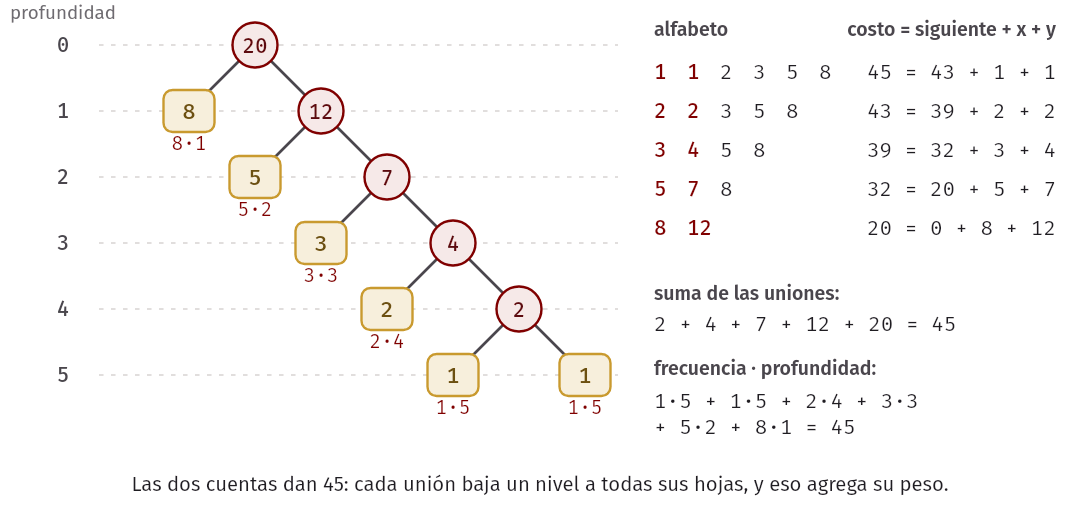
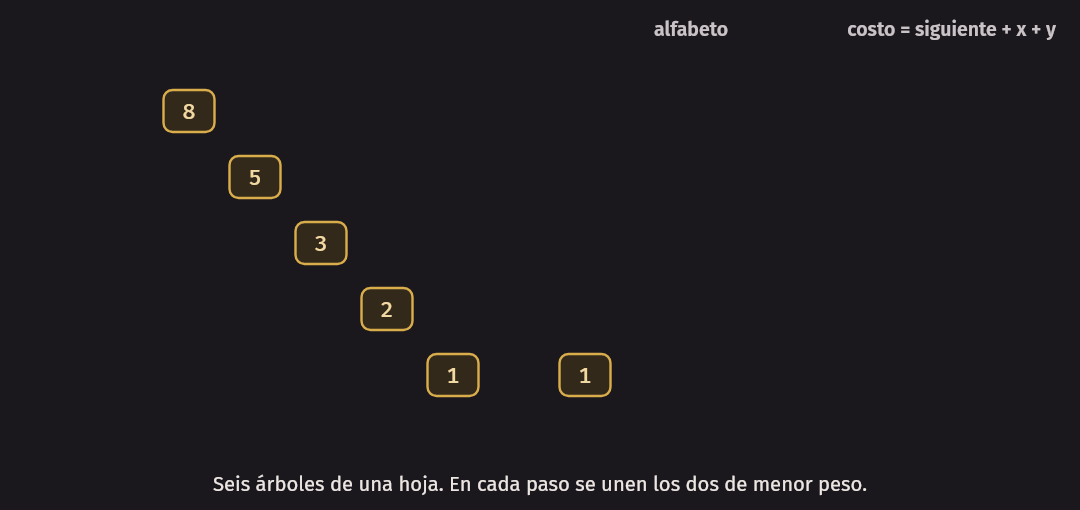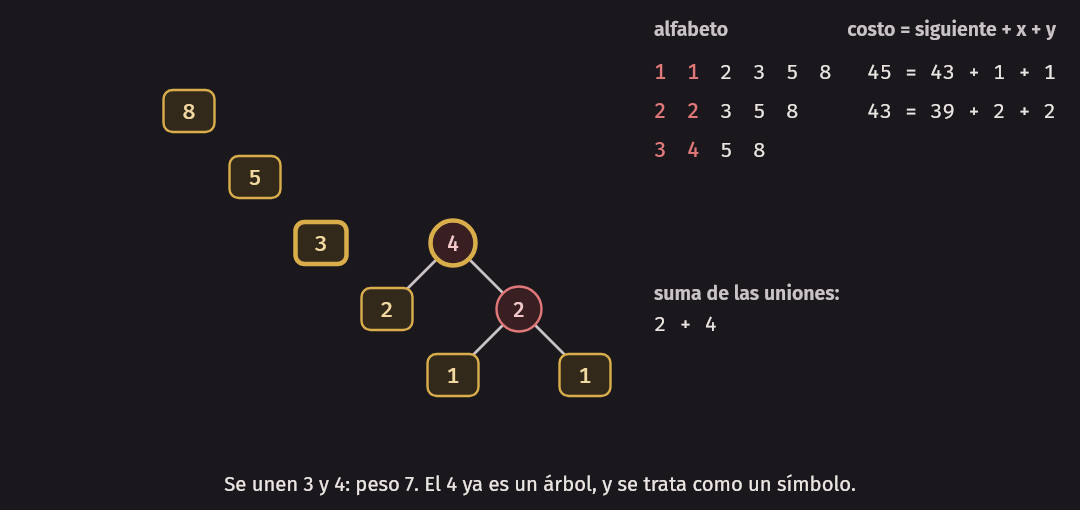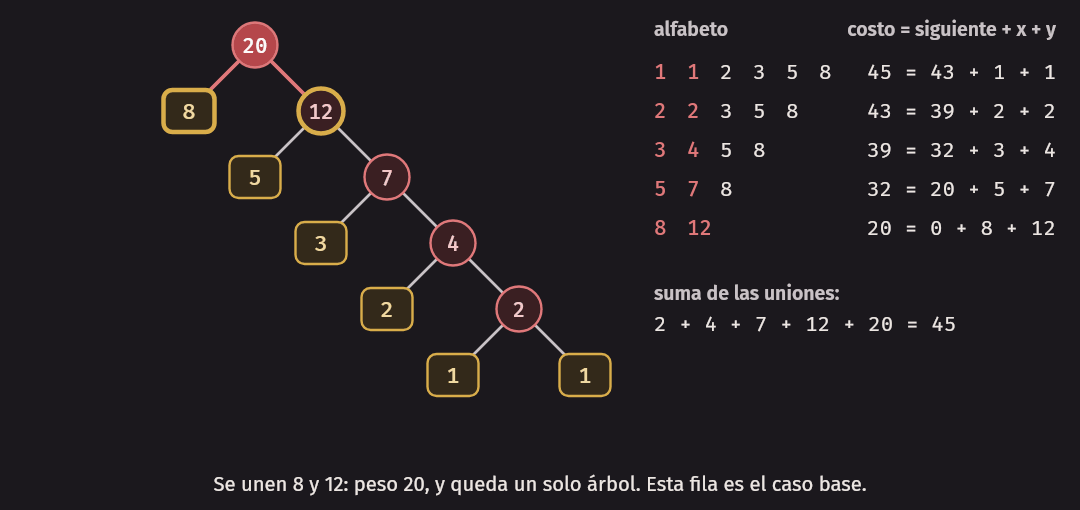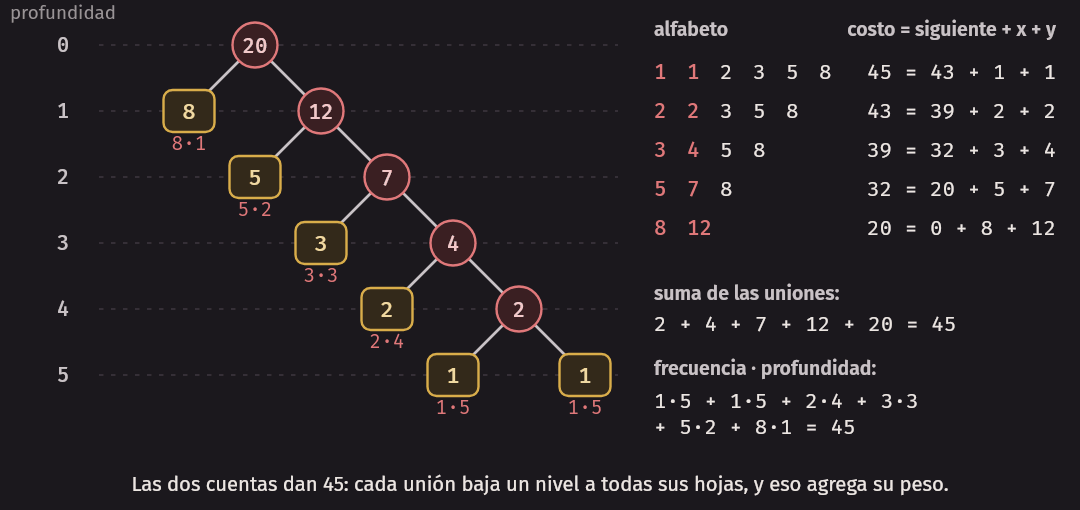
Las profundidades que imprime el programa son 5, 5, 4, 3, 2, 1, y 1·5 + 1·5 + 2·4 + 3·3 + 5·2 + 8·1 = 45. Un árbol tan desbalanceado no es un defecto: con estas frecuencias, que crecen tan rápido, cuesta menos que uno balanceado. Las pruebas confirman con la búsqueda exhaustiva que 45 es el mínimo.
En la práctica. “Óptimo” aquí tiene un significado preciso, y conviene no estirarlo. Huffman es el mejor código que asigna a cada símbolo una cadena fija de bits, sin prefijos comunes, según las frecuencias de los símbolos por separado. No promete ser la mejor compresión posible de un archivo. Como vieron en Estructuras de Datos,
gzipcombina Huffman con otra idea, reemplazar frases repetidas por una referencia a su copia anterior, y este teorema no dice nada sobre eso. Es como la cota de la semana pasada: el resultado vale dentro de su modelo.
Dijkstra como greedy
Pasamos a la segunda sesión. Dijkstra también es un greedy, aunque no se parezca a los anteriores: en cada paso fija para siempre el nodo con la menor distancia conocida y no vuelve a revisarlo. Es una decisión irrevocable, tomada solo con la información de ese momento. Eso es lo que hay que justificar.
El enunciado
Tenemos un grafo dirigido con pesos w(u, v) ≥ 0 y un origen s. Un grafo no dirigido se trata como dirigido: cada arista es un par de arcos, uno en cada sentido. Un camino de s a v es una secuencia de arcos consecutivos, que puede repetir nodos, y su largo es la suma de sus pesos. δ(v) es el menor largo de un camino de s a v, o ∞ si no hay ninguno.
Con pesos no negativos, δ(v) está bien definida: quitarle un ciclo a un camino no lo alarga, así que el mínimo se alcanza con un camino que no repite nodos, y de esos hay una cantidad finita.
Este es el algoritmo, con los nombres que vamos a usar. Es el mismo de Estructuras de Datos, escrito para el razonamiento. “Fijado” es lo que allá se llamaba “sacado”.
algoritmo dijkstra(grafo, s)
    d[v] ← ∞ para todo nodo v
    fijado[v] ← falso para todo nodo v
    d[s] ← 0
    meter (0, s) al heap
    mientras el heap no esté vacío hacer
        (x, u) ← sacar el menor del heap
        si no fijado[u] entonces
            fijado[u] ← verdadero
            para cada arco (u, v, w) de la lista de u hacer
                si d[u] + w < d[v] entonces
                    d[v] ← d[u] + w
                    meter (d[v], v) al heap
                fin si
            fin para
        fin si
    fin mientras
    devolver d
fin algoritmo
Como std::priority_queue no puede bajar la clave de una entrada, cuando d[v] mejora se mete otra entrada, y las
viejas quedan en el heap. Se reconocen al salir, porque su nodo ya está fijado. A eso se le llama borrado perezoso
(lazy deletion).
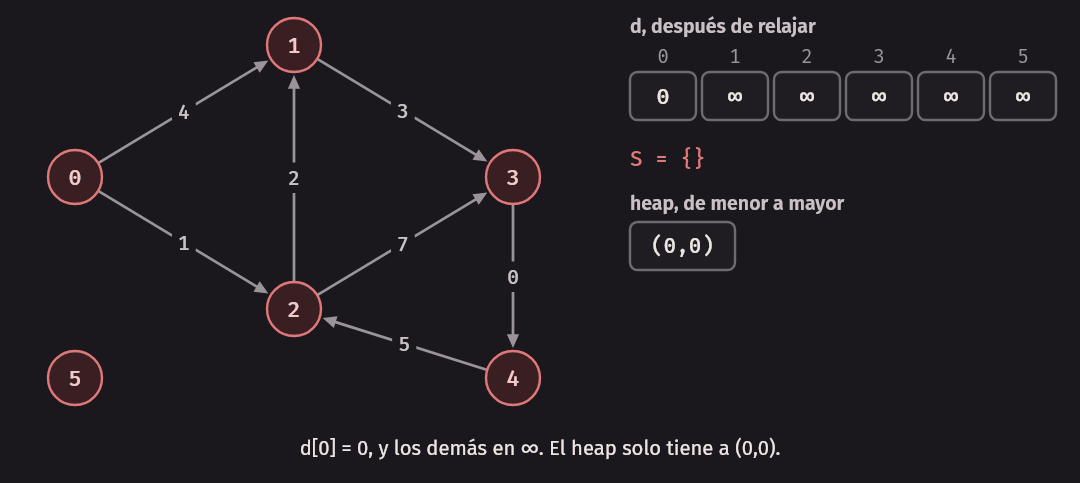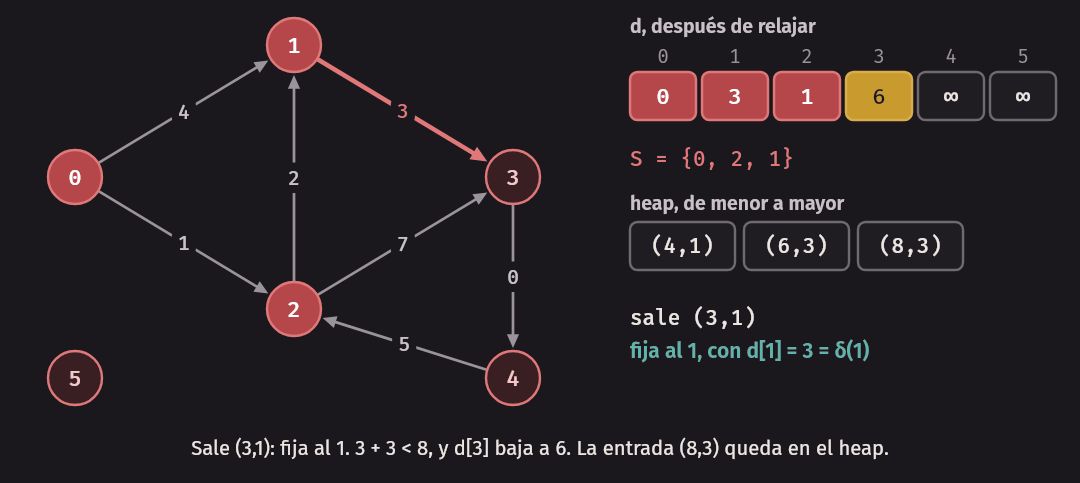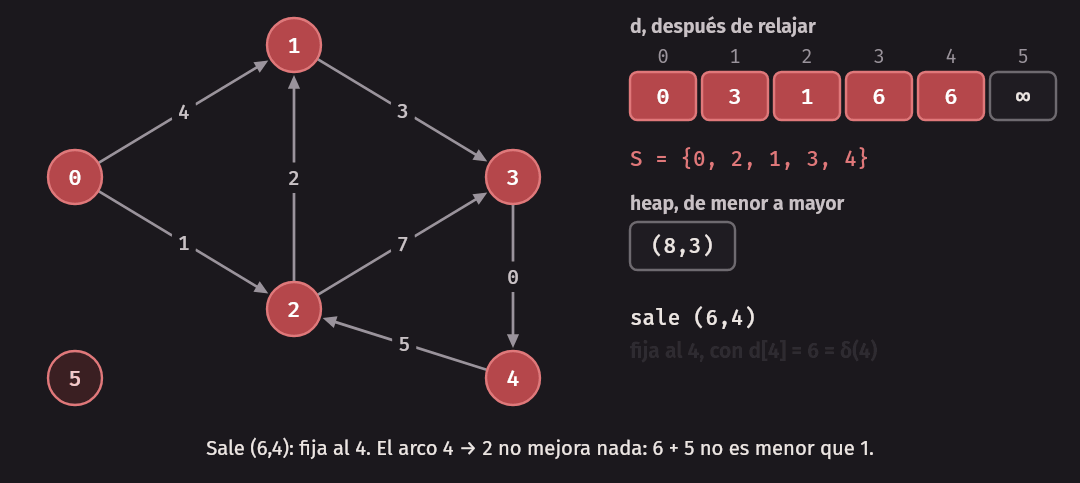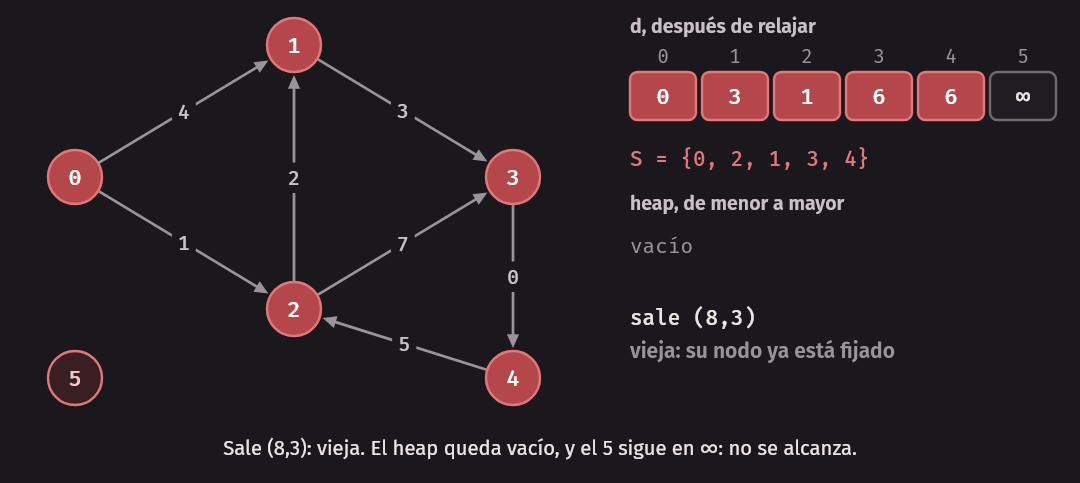
Un ejemplo, con el origen 0, un arco de peso 0 y un nodo al que no se llega:
0 → 1 (4)     0 → 2 (1)     2 → 1 (2)     2 → 3 (7)
1 → 3 (3)     3 → 4 (0)     4 → 2 (5)     el nodo 5 no tiene arcos
$ build/dijkstra_trace
sale qué pasa d[0] d[1] d[2] d[3] d[4] d[5] verdad
(0,0) fija al 0 0 4 1 inf inf inf 0
(1,2) fija al 2 0 3 1 8 inf inf 1
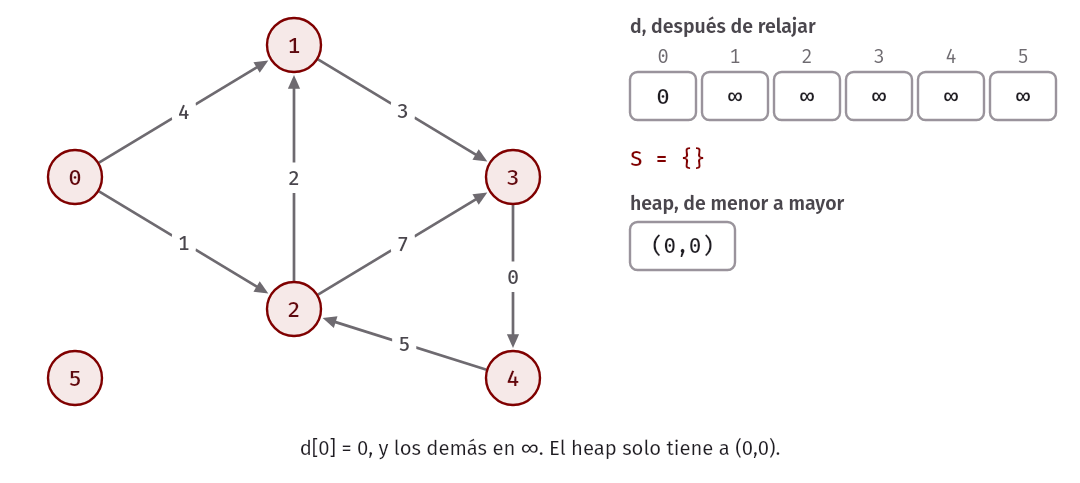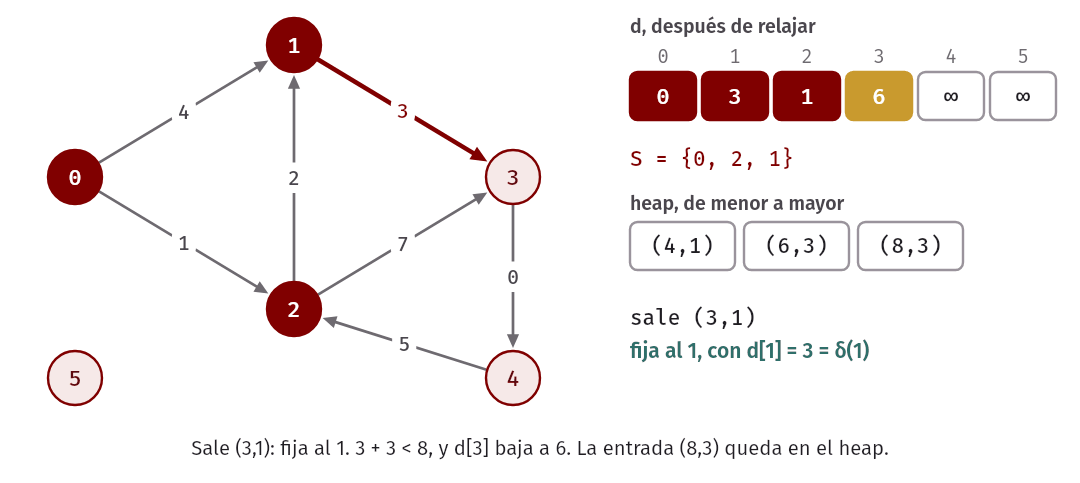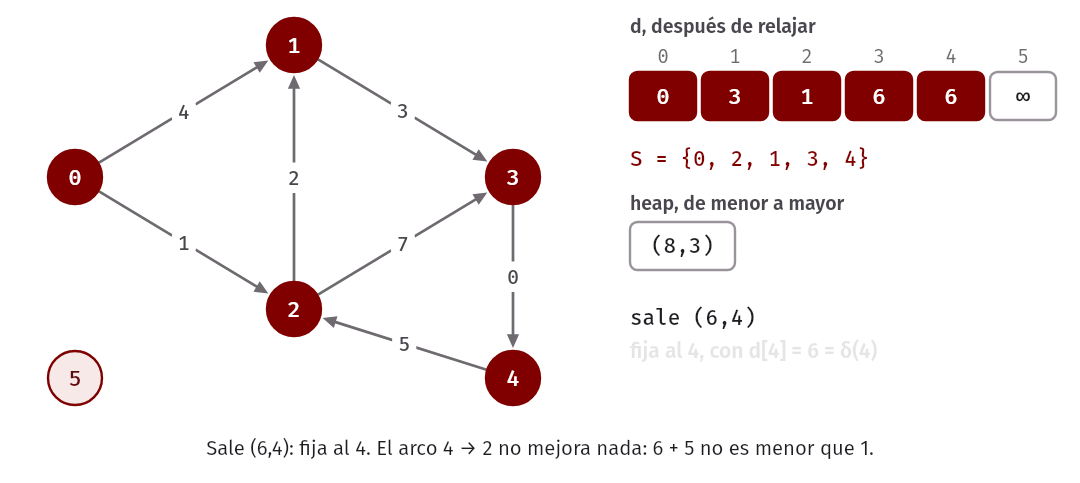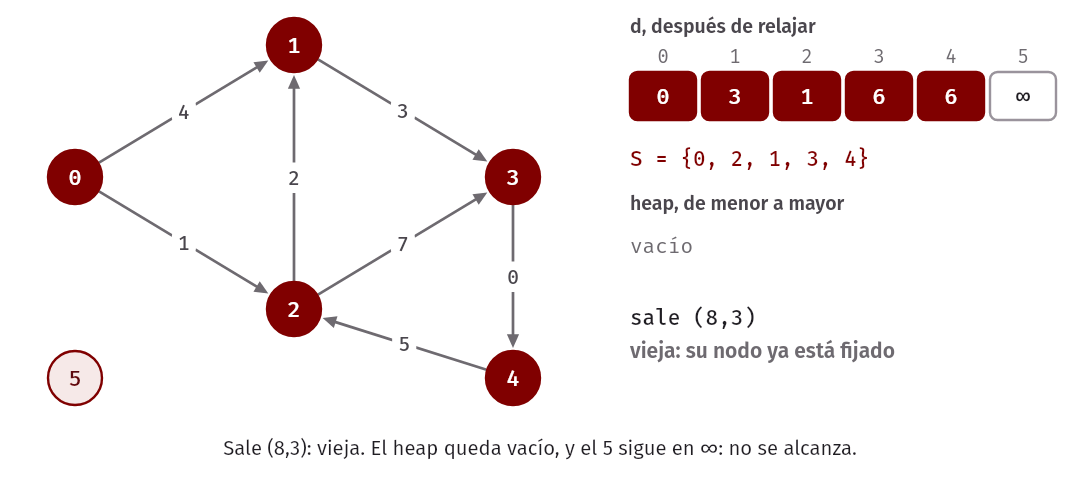
(3,1) fija al 1 0 3 1 6 inf inf 3
(4,1) vieja 0 3 1 6 inf inf
(6,3) fija al 3 0 3 1 6 6 inf 6
(6,4) fija al 4 0 3 1 6 6 inf 6
(8,3) vieja 0 3 1 6 6 infCada fila muestra d después de relajar los arcos del nodo fijado. d[1] empieza en 4 y baja a 3 cuando se fija el 2, y la entrada (4,1) queda en el heap hasta que sale y se ignora. Lo mismo le pasa a (8,3). El arco 3 → 4 de peso 0 no causa ningún problema: el 4 se fija con la misma distancia que el 3. El arco 4 → 2 no mejora nada, y el nodo 5 termina en ∞.
La última columna viene de relax_until_stable, un árbitro que relaja todos los arcos, una y otra vez, hasta que
nada cambia. No elige ningún orden, y por eso no depende de lo que queremos demostrar. Siempre que se fija un nodo, su
distancia ya es la verdad. Las pruebas comprueban eso en 2000 grafos al azar, en cada entrada que sale del heap.
Ideas parecidas que fallan
¿Por qué la regla es “el de menor distancia conocida”? Porque las versiones más simples no funcionan. La primera es dar por definitiva la distancia con la que se descubre un nodo, como en BFS, donde eso sí valía. La segunda es caminar desde el origen tomando siempre el arco más barato.
$ build/dijkstra_wrong
0 -> 1 (4), 0 -> 2 (1), 2 -> 1 (2). Distancia a 1:
  fijar al descubrir: 4
  Dijkstra:           3
  árbitro:            3
0 -> 1 (1), 1 -> 3 (10), 0 -> 2 (2), 2 -> 3 (2). Distancia a 3:
  arco más barato:    11
  Dijkstra:           4
  árbitro:            4
La primera se apura: el 1 se descubre por el arco de peso 4, y hay un camino de dos arcos más corto. La segunda solo mira el arco siguiente, y no el total acumulado. Dijkstra compara los totales desde el origen de todo lo que tiene a la vista, y por eso puede abandonar una rama y seguir por otra.
Dos hechos previos
Antes del invariante, dos hechos que no usan nada difícil.
Hecho 1: d[v] es el largo de un camino real, o ∞. Al inicio es cierto para s, con el camino vacío, y ∞ para los demás. Y cada asignación d[v] ← d[u] + w extiende un camino real de s a u con el arco (u, v). En consecuencia, d[v] ≥ δ(v) siempre, y además d[v] solo baja.
Hecho 2: la entrada que fija a u trae el menor d entre los nodos no fijados. Todo nodo no fijado con d[v] finito tiene en el heap la entrada (d[v], v), porque se metió cuando d[v] tomó ese valor, y solo sale cuando se saca. Las demás entradas de v traen valores anteriores de d[v], que son mayores. Entonces, cuando sale una entrada (x, u) de un nodo no fijado, se cumple x = d[u], porque esa es su entrada más pequeña. Y como salió la menor del heap, d[u] ≤ d[v] para todo nodo no fijado v con d[v] finito. Por lo tanto, las entradas viejas no estorban: o son de nodos fijados y se ignoran, o no salen antes que la entrada actual de su nodo.
El invariante
Teorema. En un grafo con pesos no negativos, cada vez que el algoritmo fija un nodo u, se cumple d[u] = δ(u). Al terminar, los nodos fijados son exactamente los alcanzables desde s, y los demás tienen d = ∞.
Técnica. Invariante, por inducción sobre el número de nodos fijados. El invariante es: para todo nodo fijado u, d[u] = δ(u). Sea S el conjunto de nodos fijados.
Caso base. El primer nodo en fijarse es s, con d[s] = 0. Y δ(s) = 0: el camino vacío mide 0, y ningún camino mide menos, porque los pesos no son negativos.
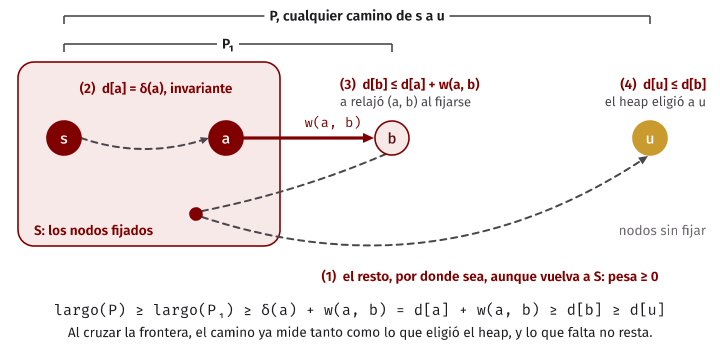
Paso. Supongamos que el invariante vale para S, que contiene a s, y que el siguiente nodo en fijarse es u. Tomemos cualquier camino P de s a u. Vamos a demostrar que P mide al menos d[u].
P empieza en s, que está en S, y termina en u, que no está. Entonces tiene un primer arco que sale de S. Llamémoslo (a, b), con a en S y b fuera de S. Sea P₁ la parte de P que va de s hasta b. El camino P se ve así:
Ahora, cuatro desigualdades seguidas:
largo(P) ≥ largo(P₁)                    el resto de P pesa ≥ 0        (1)
largo(P₁) ≥ δ(a) + w(a, b)              P₁ llega a a, y luego usa (a, b)
          = d[a] + w(a, b)              a está en S: invariante       (2)
          ≥ d[b]                        a relajó (a, b) al fijarse    (3)
          ≥ d[u]                        el heap eligió a u            (4)
Paso (3): cuando a se fijó, se miró el arco (a, b), así que quedó d[b] ≤ d[a] + w(a, b), y d[b] solo pudo bajar desde entonces. Paso (4): b no está fijado y su d es finito, y el Hecho 2 dice que u tiene el menor d entre los no fijados.
Por lo tanto, todo camino de s a u mide al menos d[u], es decir, δ(u) ≥ d[u]. El Hecho 1 da la otra desigualdad, d[u] ≥ δ(u). Entonces d[u] = δ(u). Y como d nunca baja de δ, ese valor ya no cambia: el nodo queda fijado de verdad. ∎
Quiénes quedan fijados. Supongamos que al terminar hay un nodo v alcanzable y no fijado. Un camino de s a v tiene un primer arco (a, b) que sale de los fijados. a relajó ese arco, así que d[b] es finito, y por el Hecho 2 b tiene una entrada en el heap. Pero el heap está vacío. Contradicción. Los no alcanzables no se fijan nunca: si tuvieran un d finito, por el Hecho 1 habría un camino hasta ellos. Por eso quedan con d = ∞. ∎
Sigamos el paso en el ejemplo, cuando se fija el nodo 1. S = {0, 2}, y d[1] = 3. Tomemos el camino P = 0 → 1, que usa el arco directo de peso 4. Su primer arco que sale de S es (0, 1), así que a = 0 y b = 1, y las desigualdades dicen 4 ≥ 4 ≥ 0
- 4 ≥ d[1] = 3. Ahora otro camino que pase por fuera: 0 → 2 → 3 → 4 → 2 → 1 repite el 2, y mide 1 + 7 + 0 + 5 + 2 = 15. Su primer arco que sale de S es (2, 3), con a = 2 y b = 3. Entonces 15 ≥ 8 (lo que mide hasta el 3), 8 = d[2] + 7, y en ese momento d[3] = 8 ≥ d[1] = 3. Al cruzar la frontera, el camino ya mide más que lo que eligió el heap.
Idea clave. La demostración es un argumento sobre la frontera: cualquier camino a u tiene que cruzar de los fijados a los no fijados por algún lado, y en ese cruce ya mide tanto como lo que el heap eligió. Por más vueltas que dé después, no se puede abaratar.
Dónde se usan los pesos no negativos
En la desigualdad (1), y es lo que hace funcionar todo. Dice que el tramo que falta, de b a u, no resta. Ese es el único lugar del paso inductivo en el que hace falta. (2) es la hipótesis de inducción, (3) es lo que hace el código, y (4) es la regla del heap, y ninguna mira el signo de los pesos. La misma idea aparece también en el caso base, para decir que volver a s no da un camino de largo negativo.
Veamos cómo se rompe. Tomemos cuatro nodos, con un arco negativo:
0 → 1 (1) 0 → 2 (4) 2 → 1 (-5) 1 → 3 (2)$ build/negative_edge
se fija con distancia verdad
0 0 0
1 1 -1 se rompió el invariante
3 3 1 se rompió el invariante
2 4 4
al final, Dijkstra: 0 -1 4 3
al final, árbitro: 0 -1 4 1Sigamos la demostración en el momento en que se rompe. S = {0}, y el heap elige u = 1, con d[1] = 1. Tomemos P = 0 → 2 → 1, de largo 4 − 5 = −1. El primer arco que sale de S es (0, 2), así que b = 2 y P₁ = 0 → 2, de largo 4. La desigualdad (1) pide largo(P) ≥ largo(P₁), es decir −1 ≥ 4, y eso es falso. Las otras sí se cumplen: 4 = d[0] + 4 = d[2], y d[2] = 4 ≥ d[1] = 1. Se rompió exactamente la línea que señalamos.
Y el daño se propaga. Más tarde, cuando se fija el 2, d[1] baja a −1, así que el programa termina con el valor correcto para el 1. Pero el 1 ya había relajado sus arcos con el valor 1, y nadie vuelve a leer su lista. Por eso el 3 queda en 3, y la verdad es 1.
Error común. Pensar que basta con que Dijkstra “suela funcionar” con unos pocos pesos negativos. En algunos grafos da la respuesta correcta por casualidad, igual que la regla de “menos cruces” de la semana pasada pasaba casi todas las pruebas. Sin pesos no negativos no hay demostración, y por lo tanto no hay garantía. Más adelante en el curso veremos algoritmos para pesos negativos.
¿Y si sumamos una constante?
La idea es tentadora: si el peso más negativo es −5, se suma 5 a todos los arcos, ya no hay negativos, y se corre Dijkstra. El problema es que un camino de h arcos sube h·c. Los caminos de muchos arcos suben más que los de pocos, y eso puede cambiar cuál gana. Con el grafo anterior y c = 5:
$ build/shift_weights
se suma 5 a cada peso
camino que gana tras sumar: 0 1 3  pesa 13 con la suma, 3 sin ella
camino mínimo original:     0 2 1 3  pesa 16 con la suma, 1 sin ella
árbitro, grafo original, distancia a 3: 1
Dijkstra responde bien sobre el grafo con la suma: ahí el camino mínimo sí es 0, 1, 3. Pero es otro problema, cuya respuesta no sirve para el original. En cambio, multiplicar todos los pesos por una constante positiva sí conserva cuál camino gana, porque cada largo se multiplica por lo mismo. Sumar compara mal porque cuenta los arcos.
Costo
Cada nodo se fija a lo sumo una vez, y entonces cada arco se mira a lo sumo una vez, y mete a lo sumo una entrada. El heap recibe a lo sumo E + 1 entradas, y cada operación cuesta O(log E). El total es O((V + E) log E). Si no hay arcos repetidos entre dos nodos, E ≤ V², así que log E ≤ 2 log V, y queda el O((V + E) log V) que vieron en Estructuras de Datos. Inicializar d cuesta Θ(V).
En C++. La cola de prioridad de la biblioteca da el mayor por defecto. Para el menor se usa
std::greater, con pares (distancia, nodo), que se comparan primero por la distancia. El valorUNREACHABLEes el máximo delong long, y nunca se le suma nada: solo se relajan arcos desde nodos fijados, cuya distancia es finita. Los campospopsychangesguardan lo que imprime la tabla de arriba, y no son parte del algoritmo.
inline DijkstraResult dijkstra(const Graph& graph, int source) {
    using Entry = std::pair<long long, int>;
    std::size_t n = graph.size();
    DijkstraResult result{std::vector<long long>(n, UNREACHABLE), std::vector<int>(n, -1), {}, {}};
    std::vector<bool> fixed(n, false);
    std::priority_queue<Entry, std::vector<Entry>, std::greater<Entry>> heap;
    result.distance[static_cast<std::size_t>(source)] = 0;
    heap.push({0, source});
    while (!heap.empty()) {
        auto [d, u] = heap.top();
        heap.pop();
        std::size_t index = static_cast<std::size_t>(u);
        result.pops.push_back({d, u, fixed[index]});
        if (fixed[index]) continue;
        fixed[index] = true;
        for (const Arc& arc : graph[index]) {
            std::size_t to = static_cast<std::size_t>(arc.to);
            if (d + arc.weight < result.distance[to]) {
                result.distance[to] = d + arc.weight;
                result.parent[to] = u;
                result.changes.push_back({result.pops.size() - 1, arc.to, result.distance[to]});
                heap.push({result.distance[to], arc.to});
            }
        }
    }
    return result;
}
El grafo de estados
Dijkstra responde “¿cuál es el camino más corto?”. Muchas veces la pregunta real viene con una condición: el camino más corto con a lo sumo k peajes, o que pase por una gasolinera, o que se pueda hacer antes de que se acabe la batería. Parece que hay que inventar un algoritmo para cada condición, y casi nunca hace falta. Lo que hace falta es cambiar el grafo.
El problema
Una red de ciudades con carreteras de doble sentido, algunas con peaje. Se quiere la distancia mínima de s a t pasando por a lo sumo k peajes, y una carretera con peaje cuenta cada vez que se recorre. Este es un ejemplo con cuatro ciudades y k = 1:
   0 ── 2  largo 2, sin peaje
   2 ── 1  largo 3, sin peaje
   0 ══ 1  largo 1, con peaje
   1 ══ 3  largo 1, con peaje
De 0 a 3 se quiere llegar con un solo peaje. 1 → 3 es la única carretera que llega a 3, y usa el peaje permitido. Entonces hay que llegar a la ciudad 1 sin haber pagado, y eso obliga a dar la vuelta: 0 → 2 → 1 → 3, con largo 2 + 3 + 1 = 6. La ruta 0 → 1 → 3 mide 2, pero usa dos peajes.
Por qué Dijkstra sobre las ciudades no alcanza
La distancia más corta a la ciudad 1 es 1, por la carretera con peaje. Si la ciudad 1 se fija con ese valor, se fija con el peaje ya gastado, y desde ahí no se puede seguir a 3. La llegada más larga, de largo 5 y sin peajes, es la que sirve, y Dijkstra sobre las ciudades ya la descartó.
Fíjense en qué falla de la demostración. El teorema sigue siendo cierto para el grafo de las ciudades. Lo que pasa es que la propiedad que se quiere ya no es una propiedad de la ciudad. “Lo mejor para llegar a 1” depende de cuántos peajes quedan. Dos llegadas a la misma ciudad no son comparables si una llegó con más distancia y menos peajes usados.
Hay dos formas típicas de equivocarse aquí, y las dos están en toll_mistakes.h.
- Un contador global. Una variable
usadospara toda la búsqueda, que sube cada vez que se mira una carretera con peaje. El peaje de una ruta se cuenta en contra de todas las demás, porque el contador no pertenece a ninguna ruta. - Una sola distancia por ciudad. Cada entrada del heap recuerda sus peajes, pero cada ciudad guarda un solo valor. Una llegada más corta pisa a una más larga con menos peajes.
$ build/toll_layers | tail -n 2
contador global: -1
una distancia por ciudad: -1
Las dos dicen que no hay ruta, y sí hay una, de largo 6.
Error común. Modelar los peajes con un contador global y no como parte del estado. Es lo primero que se le ocurre a todo el mundo, porque parece poco trabajo agregar una variable. Pero una búsqueda explora muchas rutas a la vez, y un solo contador no puede decir cuántos peajes lleva cada una. Lo que el problema necesita recordar por ruta tiene que vivir en el nodo.
La idea: lo que importa entra en el nodo
Para decidir bien, en cada punto hay que saber dos cosas: en qué ciudad estamos y cuántos peajes llevamos. Entonces ese par es el nodo.
Definición. El grafo de estados (state graph) de este problema tiene un nodo (c, j) por cada ciudad c y cada j de 0 a k: “estoy en c y llevo j peajes”. Son k + 1 capas, una por cada valor de j. Sus arcos son:
- Una carretera sin peaje de u a v, con largo w, da un arco (u, j) → (v, j) de peso w en cada capa. Se queda en la misma capa.
- Una carretera con peaje de u a v, con largo w, da un arco (u, j) → (v, j + 1) de peso w, para j de 0 a k − 1. Sube una capa. Desde la última capa no sale: ya no quedan peajes.
Cada carretera de doble sentido da esos arcos en los dos sentidos. Nuestro ejemplo queda así, con k = 1:
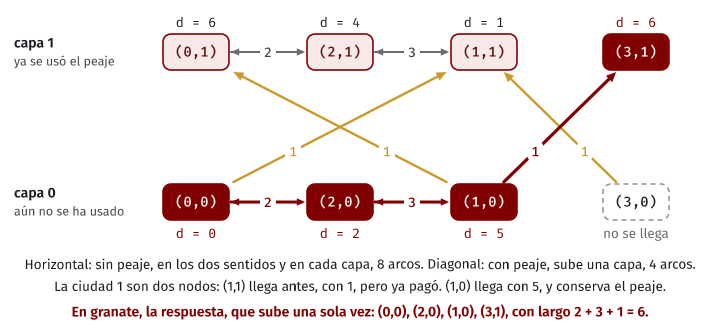
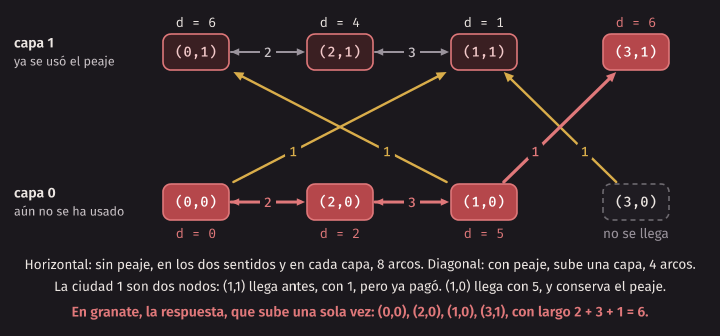
Las flechas horizontales son las carreteras 0–2 y 2–1, sin peaje, repetidas en cada capa, y cada una vale en los dos sentidos. Los peajes son los únicos arcos que suben, y son cuatro:
(0,0) → (1,1) (1,0) → (0,1) (1,0) → (3,1) (3,0) → (1,1)El programa toll_layers tiene los doce arcos de este grafo escritos a mano y corre sobre ellos el mismo
dijkstra de siempre, que no sabe qué es un peaje:
$ build/toll_layers
estado  distancia
(0,0)    0
(1,1)    1
(2,0)    2
(2,1)    4
(1,0)    5
(0,1)    6
(3,1)    6
a (3,0): no se llega
a (3,1): 6 por (0,0) (2,0) (1,0) (3,1)
contador global: -1
una distancia por ciudad: -1
La ciudad 1 aparece dos veces, en dos nodos distintos: (1,1) con distancia 1 y (1,0) con distancia 5. Ya no hay conflicto entre ellas. La primera es más corta y ya pagó. La segunda es más larga y conserva el peaje. Cada una se fija por su lado, y desde (1,0) se llega a (3,1).
La respuesta es el menor d entre todas las capas de la ciudad destino: una ruta puede usar menos de k peajes.
algoritmo distancia_con_peajes(red, s, t, k)
    construir el grafo de estados con las capas 0, ..., k
    d ← dijkstra(grafo de estados, (s, 0))
    devolver el menor d[(t, j)] con j desde 0 hasta k, o -1 si todos son ∞
fin algoritmo
Por qué es correcto
Afirmación. El menor d[(t, j)], con j de 0 a k, es la distancia mínima de s a t entre las rutas con a lo sumo k peajes.
Técnica. Una correspondencia entre rutas y caminos del grafo de estados, que conserva el largo, en los dos sentidos. Con eso, el teorema de Dijkstra hace el resto, porque los pesos del grafo de estados son largos de carreteras, y no son negativos.
De una ruta a un camino. Tomemos una ruta de s a t con a lo sumo k peajes. Recorrámosla llevando la cuenta j de los peajes usados hasta cada punto, empezando en (s, 0). Cada carretera sin peaje corresponde a un arco que no cambia j. Cada carretera con peaje corresponde a un arco que sube j en uno, y ese arco existe porque j + 1 ≤ k. Así se llega a (t, j) con el mismo largo total, y j es el número de peajes de la ruta.
De un camino a una ruta. Tomemos un camino de (s, 0) a (t, j). Si nos quedamos solo con las ciudades, cada arco corresponde a una carretera, y es una ruta de s a t con el mismo largo. Cada subida de capa es un peaje, y las capas solo suben, de 0 a j. Así que la ruta tiene exactamente j ≤ k peajes.
Por lo tanto, el mínimo sobre las rutas válidas es igual al mínimo sobre esos caminos, que es el menor δ(t, j) entre las capas. Si no hay ninguna ruta válida, tampoco hay camino, y todos dan ∞. ∎
¿Hay que pasar dos veces por una ciudad? Con estos pesos, nunca hace falta. Si una ruta repite una ciudad, se le quita el tramo entre las dos visitas: el largo no sube, porque ese tramo no pesa negativo, y los peajes no suben, porque se cuentan los mismos o menos. Aun así, el grafo de estados no necesita saberlo. Un camino en él puede pasar por (1,0) y luego por (1,1), y eso no da un resultado mejor ni uno equivocado: simplemente la demostración cubre también esos casos.
Otra restricción, en C++
Veamos la misma idea programada con otra condición, una donde repetir ciudades sí hace falta. Dos choferes se turnan al volante: uno maneja un tramo, y el otro el siguiente. El contrato pide que al llegar maneje el mismo que salió. Es decir, el número de tramos tiene que ser par.
Lo que hay que recordar es la paridad de los tramos recorridos. Nuestro código lo generaliza un poco: un número de tramos múltiplo de c. El estado es (ciudad, tramos módulo c), y cada arco va del resto r al resto (r + 1) mod c.
// Recorrido mínimo de source a target con un número de tramos múltiplo de c.
// El estado (ciudad, resto) se guarda como ciudad * c + resto. Los arcos no se construyen:
// salen de la lista de la ciudad, y todos van del resto r al resto (r + 1) mod c.
inline WalkResult min_walk_multiple(const Graph& graph, int source, int target, int c) {
    using Entry = std::pair<long long, std::size_t>;
    std::size_t layers = static_cast<std::size_t>(c);
    std::size_t states = graph.size() * layers;
    std::vector<long long> distance(states, UNREACHABLE);
    std::vector<std::size_t> parent(states, states);
    std::vector<bool> fixed(states, false);
    std::priority_queue<Entry, std::vector<Entry>, std::greater<Entry>> heap;
    std::size_t start = static_cast<std::size_t>(source) * layers;
    distance[start] = 0;
    heap.push({0, start});
    WalkResult result{UNREACHABLE, {}, 0, 0};
    while (!heap.empty()) {
        auto [d, state] = heap.top();
        heap.pop();
        result.pops++;
        if (fixed[state]) continue;
        fixed[state] = true;
        std::size_t city = state / layers;
        std::size_t next_rest = (state % layers + 1) % layers;
        for (const Arc& arc : graph[city]) {
            result.relaxations++;
            std::size_t next = static_cast<std::size_t>(arc.to) * layers + next_rest;
            if (d + arc.weight < distance[next]) {
                distance[next] = d + arc.weight;
                parent[next] = state;
                heap.push({distance[next], next});
            }
        }
    }
    std::size_t goal = static_cast<std::size_t>(target) * layers;
    result.distance = distance[goal];
    return result;
}
Aquí omitimos las líneas del final, en las que state_graph.h reconstruye el recorrido con parent.
Fíjense en dos técnicas. El estado se guarda en un solo entero, ciudad * c + resto, para que las distancias quepan en
un arreglo simple. Y los arcos no se construyen: se calculan al vuelo, a partir de la lista de adyacencia de la ciudad.
Con eso, la memoria de los arcos no se multiplica por el número de capas. Lo único que hay que guardar por estado es la
distancia.
Una línea con los tramos 0–1, 1–2, 2–3, de largo 2 cada uno, y luego un triángulo de largo 1 colgando del nodo 1, por los nodos 4 y 5:
$ build/driver_turns
sin la regla: 6 por 0 1 2 3
con número par de tramos, solo la línea: no hay recorrido
con número par de tramos, con el triángulo: 9 por 0 1 5 4 1 2 3
Sin la regla, son 3 tramos, y no sirve. Solo con la línea no hay solución: cada tramo cambia la paridad del número de la ciudad, de modo que de 0 a 3 siempre son tramos impares, por más que vaya y vuelva. Con el triángulo, el camión da una vuelta de 3 tramos, que cambia la paridad, y pasa dos veces por la ciudad 1. Eso no es ningún problema: son dos estados distintos, (1, impar) y (1, par).
Comparen con los peajes. Ahí repetir ciudad nunca ayuda, porque cada vuelta solo agrega largo y peajes. Aquí sí ayuda, porque la vuelta cambia lo que hay que recordar. El grafo de estados no necesita saber cuál de los dos casos tiene: trabaja igual con ambos.
Idea clave. Para cualquier condición sobre caminos, pregunten: ¿qué tengo que saber en este punto para decidir bien lo que sigue? Si la respuesta es “algo más que el nodo”, eso va en el nodo. Después, Dijkstra corre sin cambios, y su demostración vale, siempre que los pesos del nuevo grafo sigan sin ser negativos.
El costo del grafo de estados
Con k peajes, y con E contando arcos dirigidos, de modo que una carretera de doble sentido cuenta dos:
- Nodos: V · (k + 1), una copia de cada ciudad por capa.
- Arcos: a lo sumo E · (k + 1). Un arco sin peaje tiene k + 1 copias, una por capa. Uno con peaje tiene k copias, porque la última capa no lo usa. En el ejemplo, E = 8 y k + 1 = 2. La cota es 16, y hay 12 arcos.
- Dijkstra: O((V + E) · (k + 1) · log(V · (k + 1))), reemplazando V por V(k + 1) y E por E(k + 1) en el costo de antes. Aquí log de E(k + 1) es del mismo orden que log de V(k + 1), si no hay carreteras repetidas.
Es decir: el costo crece casi linealmente con el número de capas. Si k es chico, es muy poco lo que se paga por resolver un problema bastante más difícil. Si lo que se recuerda tiene muchos valores, el grafo crece igual: guardar el conjunto de ciudades visitadas, por ejemplo, daría 2^V capas, y ahí la idea ya no sirve.
Midamos con el grafo de resto módulo c, donde el número de capas es c. Es un grafo al azar de 20 000 ciudades y 100 000
arcos. Los conteos son exactos. Los tiempos son de una corrida en el contenedor del curso, con -O2, el menor de 3 intentos,
en una máquina compartida, y dependen de la máquina.
$ make bench
build/state_graph_bench
capas    estados    sacadas  arcos mirados      ms
    1      20000      28963          99260     3.7
    2      40000      57886         198520     8.1
    4      80000     115685         397040    17.9
    8     160000     230835         794080    36.5
   16     320000     466512        1588160    80.5
   32     640000     957475        3176320   172.9
Los arcos mirados son exactamente 99 260 por el número de capas: cada capa mira los mismos arcos. Son menos de los 100 000 por capa, porque algunas ciudades no se alcanzan desde el origen. El tiempo se duplica o un poco más en cada fila. Eso es lo que se espera de un costo casi lineal con un factor logarítmico, aunque con una sola corrida en una máquina compartida no se puede afirmar más que eso.
En la práctica. Esta forma de modelar sirve para muchas restricciones de rutas: cuántos transbordos lleva un viaje, cuánta carga queda en una batería medida en unidades enteras, o si ya se pasó por un punto obligatorio. El método es siempre el mismo, y el límite también: el número de estados tiene que ser manejable. Antes de programar, multipliquen ciudades por capas, y arcos por capas.
Tres demostraciones, comparadas
Esta semana usamos tres formas de demostrar que un greedy funciona. Ninguna es una receta que se aplique sin pensar, y conviene ver en qué se parecen.
| Qué se transforma o se mantiene | Qué garantiza no empeorar | Qué completa el argumento | |
|---|---|---|---|
| Retraso máximo | Un horario óptimo, cambiando vecinas | La tarea que empeora no pasa del retraso viejo de la otra | Todos los horarios sin inversiones valen lo mismo |
| Huffman | Un árbol óptimo, cambiando hojas de lugar | Mandar abajo lo menos frecuente no sube el costo | Inducción, sobre un símbolo menos |
| Dijkstra | Un invariante sobre los nodos fijados | Lo que falta de un camino no pesa negativo | Todo camino cruza la frontera por algún arco |
En las dos primeras se empieza de una solución óptima y se la acerca al greedy, como en la semana 4. Lo que cambia es qué hay que agregar: en el retraso máximo, un lema sobre empates. En Huffman, toda una inducción, porque la regla se aplica a árboles que no existían en el problema original. Dijkstra no parte de ninguna solución óptima: mantiene una afirmación sobre lo ya decidido, y la extiende de a un nodo. Cuando un greedy construye la solución pieza por pieza y cada pieza queda definitiva, un invariante suele ser la forma más directa.
En los tres casos hubo que decir qué pasa con los empates: plazos iguales, frecuencias iguales, distancias iguales. Las pruebas que ignoran los empates suelen tener un agujero justo ahí.
El laboratorio
El problema está en lab/toll_routes: rutas con a lo sumo k peajes, como las de esta sección, ahora con la entrada
completa. Los enunciados de este curso cuentan una situación, y elegir la técnica es parte del trabajo. El orden que
sugerimos es este.
- Lean el enunciado, y hagan a mano la cuenta de cuántos estados y arcos da el peor caso. Revisen también cuál es la mayor distancia posible, y qué tipo de dato le alcanza.
- Respondan la pregunta de “Para pensar antes de programar” del enunciado.
- Programen la solución con
std::priority_queue, y corranmake test. - Imprimir -1 es parte de la respuesta: hay rutas que existen, pero no con esos peajes.
- Si les queda tiempo, la extensión del cupón, al final del enunciado.
El código de la semana
En code/week-05:
| Archivo | Qué contiene |
|---|---|
scheduling.h |
Job, retrasos, inversiones, las tres reglas de orden y la fuerza bruta |
huffman.h |
huffman, code_cost, la búsqueda exhaustiva, todos los empates, y las dos ideas que fallan |
shortest_paths.h |
Graph, dijkstra con su registro de entradas, dos ideas que fallan, y el árbitro relax_until_stable |
state_graph.h |
min_walk_multiple, el grafo de estados de tramos módulo c |
toll_mistakes.h |
Las dos formas equivocadas de contar peajes, para ver dónde fallan |
lateness_rules.cpp |
Los contraejemplos de las reglas de orden |
lateness_trace.cpp |
El ejemplo de cinco tareas, y los cambios de vecinas |
huffman_rules.cpp |
Las ideas que fallan, y lo que hacen los empates |
huffman_trace.cpp |
El intercambio y la inducción, con números |
dijkstra_trace.cpp |
Dijkstra paso a paso, con la verdad al lado |
dijkstra_wrong.cpp |
Dos ideas parecidas a Dijkstra que fallan |
negative_edge.cpp |
Dónde se rompe el invariante con un arco negativo |
shift_weights.cpp |
Sumar una constante cambia cuál camino gana |
toll_layers.cpp |
El ejemplo de los peajes, con los arcos escritos a mano |
driver_turns.cpp |
El recorrido con número par de tramos |
state_graph_bench.cpp |
La medición de arriba, con make bench |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. La medición va con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
build/test_examples
Todas las pruebas de la semana 5 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- Cada regla falsa de orden da un retraso mayor que el óptimo en su contraejemplo.
- En 1500 instancias al azar, con muchos plazos repetidos, el plazo más cercano coincide con la fuerza bruta.
- Todos los horarios sin inversiones de una instancia tienen el mismo retraso máximo.
- Cambiar dos vecinas invertidas quita exactamente una inversión y nunca sube el máximo, y al terminar no quedan inversiones.
- En 400 instancias, Huffman coincide con la búsqueda exhaustiva, con todas las formas de romper los empates. Las dos cuentas del costo dan lo mismo.
- 1, 1, 2, 3, 5, 8 cuesta 45, y sus empates dan una sola lista de profundidades. 1, 1, 2, 2 da tres, todas de costo 12.
- La relación del Lema C se cumple en todos los árboles de instancias pequeñas, incluidos los que no son de Huffman.
- En los óptimos de instancias pequeñas, un símbolo más frecuente nunca está más hondo que uno menos frecuente.
- En 2000 grafos al azar, con pesos 0 incluidos, cada entrada que fija un nodo trae la distancia del árbitro, y se fijan exactamente los alcanzables.
- El recorrido par coincide con una tabla por número de tramos, que no usa grafo de estados, en 2000 grafos.
Resumen
- Retraso máximo: en un horario sin tiempo muerto, el retraso de una tarea es su fin menos su plazo. Fallan “la que dura menos” y “la de menos holgura”. Funciona el plazo más cercano, que ni mira las duraciones.
- La demostración quita inversiones entre vecinas de una solución óptima. Cada cambio no sube el máximo, porque la tarea que empeora termina donde terminaba la otra y tiene un plazo mayor. Dos tareas con el mismo plazo no forman inversión, y todos los horarios sin inversiones tienen el mismo máximo.
- Huffman: el costo es la suma de frecuencia por profundidad, y también la suma de los pesos de las uniones. Dividir parejo de arriba hacia abajo no es óptimo.
- La demostración tiene tres piezas. Un árbol óptimo es lleno. Por intercambio, existe un árbol óptimo con los dos menos frecuentes como hermanos abajo. Por inducción, usando dos veces costo(T) = costo(T′) + f(x) + f(y), el resto sale reemplazando esos dos por su suma.
- El intercambio solo no alcanza: la inducción no es un detalle. Los empates pueden dar árboles distintos, del mismo costo.
- Dijkstra es un greedy que fija el nodo con menor distancia conocida. El invariante es que todo nodo fijado tiene su distancia correcta, y se demuestra mirando el primer arco de un camino cualquiera que sale de los fijados.
- Los pesos no negativos se usan en una línea: lo que falta del camino no resta. Con un arco negativo esa línea es falsa, y se ve en un ejemplo. Sumar una constante no arregla nada, porque un camino de h arcos sube h·c.
- Grafo de estados: si para decidir hace falta recordar algo más que el nodo, eso entra en el nodo. Con k peajes hay V(k + 1) nodos y a lo sumo E(k + 1) arcos, y Dijkstra corre sin cambios, con su demostración incluida.
- Un contador global no sirve, porque no pertenece a ninguna ruta. Guardar una sola distancia por ciudad tampoco, porque llegar antes puede haber gastado los peajes que hacían falta después.
Ejercicios
- Con frecuencias 2, 3, 3, 4, 9, corran Huffman a mano y calculen el costo de las dos formas: frecuencia por profundidad
y suma de uniones. Pasen el resultado por
huffman_all_tiesybrute_min_cost. ¿Hay empates que cambien la forma del árbol? - Más frecuente, más arriba. Demuestren que, en un árbol óptimo, un símbolo más frecuente no puede estar más profundo que uno menos frecuente. Usen la cuenta del intercambio, y digan dónde hace falta que la desigualdad entre frecuencias sea estricta.
- Con las mismas tareas del ejemplo de cinco, escriban a mano un horario en el que el retraso máximo sea 3 y que tenga al
menos una inversión. ¿Eso contradice algo? Después, compruébenlo con
max_lateness. - Suma en vez de máximo. Cambien el objetivo: minimizar la suma de los retrasos Lᵢ, con signo. Muestren que el plazo más cercano ya no sirve, con un contraejemplo pasado por una fuerza bruta propia. Demuestren con un intercambio de vecinas que la regla correcta es otra, y digan cuál.
- Tareas que llegan tarde. Agreguen a cada tarea un instante de llegada, antes del cual no se puede empezar. Den un contraejemplo que muestre que ordenar por plazo ya no da el óptimo, permitiendo tiempo muerto. ¿Qué línea de la demostración deja de valer?
- Sin ordenar otra vez. Si las frecuencias ya vienen ordenadas, Huffman se puede correr en Θ(n) sin heap, con dos
colas: una con las hojas y otra con los árboles armados. Demuestren que los árboles armados salen en orden no
decreciente de peso, y programen esta versión. Compárenla con
huffmanen instancias al azar. - Frecuencia cero. Si se permiten frecuencias cero, ¿qué parte del Lema A deja de valer tal como está escrita? ¿Sigue siendo cierto el teorema? Corrijan el enunciado del lema y demuestren el resultado.
- Busquen un grafo pequeño con un arco negativo, distinto del de estos apuntes, en el que Dijkstra responda bien para
todos los nodos, y otro en el que falle. En el segundo, digan qué desigualdad del paso inductivo es falsa y con qué
números. Compruébenlo con
dijkstrayrelax_until_stable. - Den un contraejemplo propio de que sumar una constante cambia el camino mínimo, esta vez con todos los pesos positivos desde el inicio. Después, demuestren que multiplicar todos los pesos por una constante c > 0 no cambia cuál camino es mínimo.
- Parar al llegar. Demuestren que Dijkstra se puede detener cuando sale del heap una entrada no vieja de t, y que no se puede cuando entra. Den un grafo para el segundo caso, y córranlo.
- El camino más ancho. Cada arco tiene una capacidad, y el ancho de un camino es la menor capacidad entre sus arcos. Se busca el camino de mayor ancho de s a t. Cambien Dijkstra para resolverlo, y adapten las desigualdades de la demostración. ¿Qué cumple aquí el papel de los pesos no negativos? Programen la versión y compárenla con una búsqueda exhaustiva.
- Diseñen los estados. Para cada problema, digan qué es un nodo, cuántos nodos y arcos hay, y cuál es el costo.
Programen el segundo con
min_walk_multiplecomo modelo. (a) Una batería con capacidad para C kilómetros enteros, que se recarga por completo solo en algunas ciudades, y una carretera se puede tomar solo si alcanza la carga. (b) El camino más corto de s a t que pasa por al menos una de las ciudades de un conjunto dado. (c) Un recorrido donde dos carreteras seguidas no pueden ser del mismo color.