Apuntes · Capítulo 6Greedy y grafos
Árboles de expansión mínima y DFS
Árboles de expansión mínima y DFS
La semana pasada le pusimos demostración a Dijkstra: un greedy que fija un nodo a la vez y nunca vuelve atrás. Esta semana cerramos la parte del curso sobre greedy y grafos con dos temas más. Los dos usan herramientas que ustedes ya tienen, union-find, heaps y DFS, y les agregan lo que faltaba: la razón por la que funcionan.
La primera sesión responde una pregunta práctica: hay que conectar varios lugares y cada conexión posible tiene un precio, ¿cómo se conecta todo al menor costo? La respuesta es un árbol de expansión mínima. Kruskal y Prim lo calculan con reglas distintas, y los dos se justifican con un solo resultado, la propiedad del corte, que se demuestra con el argumento de intercambio de la semana 4.
La segunda sesión vuelve a DFS, ya conocido de Estructuras de Datos, con un dato que allá no usamos: a qué hora empieza y a qué hora termina cada nodo. Con esos tiempos se detectan ciclos, se obtiene un orden topológico y se calculan las componentes fuertemente conexas en tiempo lineal. El algoritmo de esas componentes es de los más cortos del curso, y también de los que menos se entienden sin demostración: hay un grafo que se invierte, y si se olvida invertirlo la respuesta sale mal sin ningún aviso.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, El problema: conectar todo al menor costo, Ideas parecidas que fallan, DFS con tiempos de inicio y de fin y Tipos de arista.
En clase: Sesión A, de La propiedad del corte, con pesos distintos a Agrupar con la máxima separación. Sesión B, de DFS con tiempos de inicio y de fin a Componentes fuertemente conexas.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, Recursión profunda: una pila que sí termina y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Erickson, cap. 7, en especial secs. 7.2 (The Only Minimum Spanning Tree Algorithm), 7.4 (Prim) y 7.5 (Kruskal). CLRS, capítulo Minimum Spanning Trees, 4.ª edición. Sesión B: Erickson, secs. 6.1 (Preorder and Postorder), 6.2 (Detecting Cycles), 6.3 (Topological Sort), 6.5 (Strong Connectivity) y 6.6 (Strong Components in Linear Time). CLRS, capítulo Elementary Graph Algorithms, 4.ª edición. Estos apuntes se pueden estudiar sin ellos.
Código. Los programas de este capítulo están en
code/week-06. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los dos problemas de laboratorio están enlab/network_designylab/curriculum, y cada uno tiene su propiomake test.
El problema: conectar todo al menor costo
Tenemos un grafo no dirigido y conexo G, con V nodos y E aristas. Cada arista e tiene un peso w(e): el precio de instalar ese tramo de fibra, de tender ese cable, de asfaltar ese camino. Queremos elegir aristas de modo que todos los nodos queden conectados y la suma de los pesos sea la menor posible.
Con pesos positivos, lo elegido no puede tener un ciclo. Si lo tuviera, quitar cualquier arista del ciclo deja todo igual de conectado y sale más barato. Un conjunto de aristas que conecta todo y no tiene ciclos es un árbol, y por eso la respuesta tiene esa forma.
Definición. Un árbol de expansión (spanning tree) de G es un subconjunto de aristas que forma un árbol y toca todos los nodos. Su peso es la suma de los pesos de sus aristas. Un árbol de expansión mínima (minimum spanning tree) es un árbol de expansión de peso mínimo.
Definido así, el problema tiene sentido con cualquier peso, incluso negativo: se busca entre los árboles, no entre todos los subgrafos conexos. Más adelante veremos que los algoritmos no se enteran del signo.
Vamos a usar tres hechos de Matemática Discreta sobre un árbol T con V nodos:
- T tiene exactamente V − 1 aristas. Y un conjunto de V − 1 aristas que conecta V nodos es un árbol.
- Entre dos nodos de T hay exactamente un camino dentro de T.
- Si se le quita una arista, T se parte en exactamente dos pedazos, con un extremo de esa arista en cada uno.
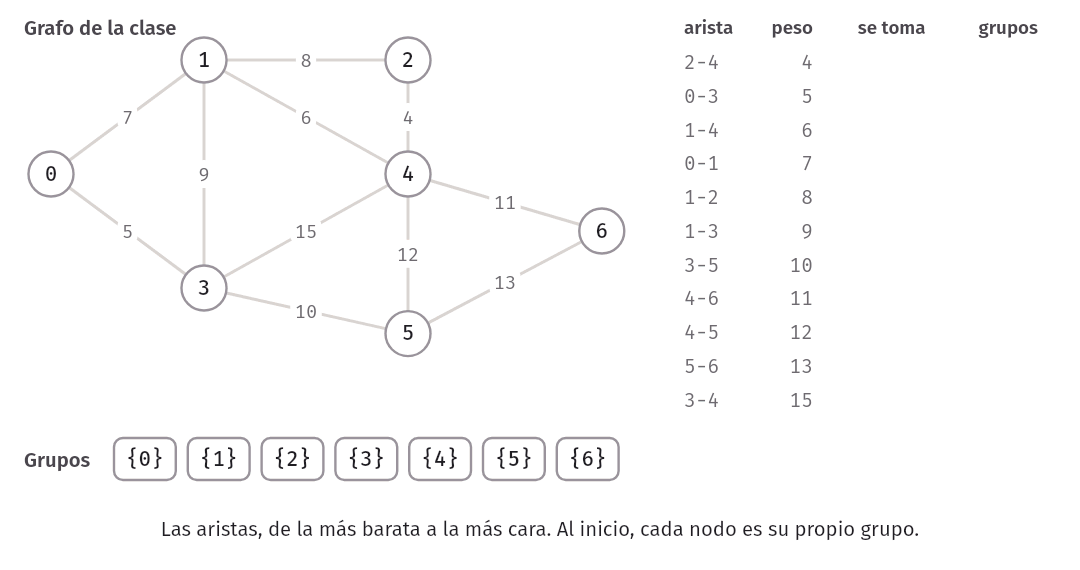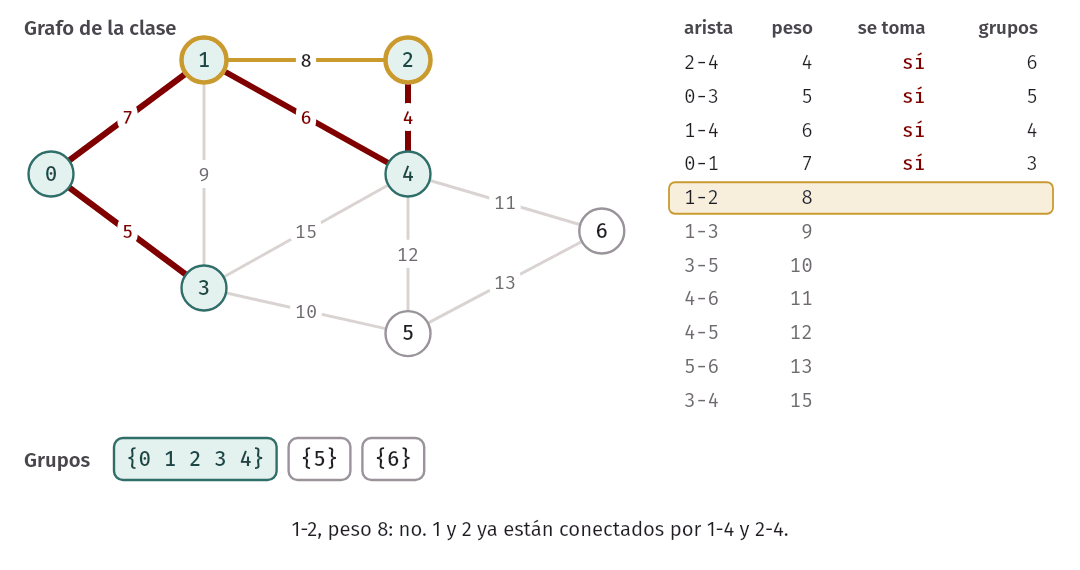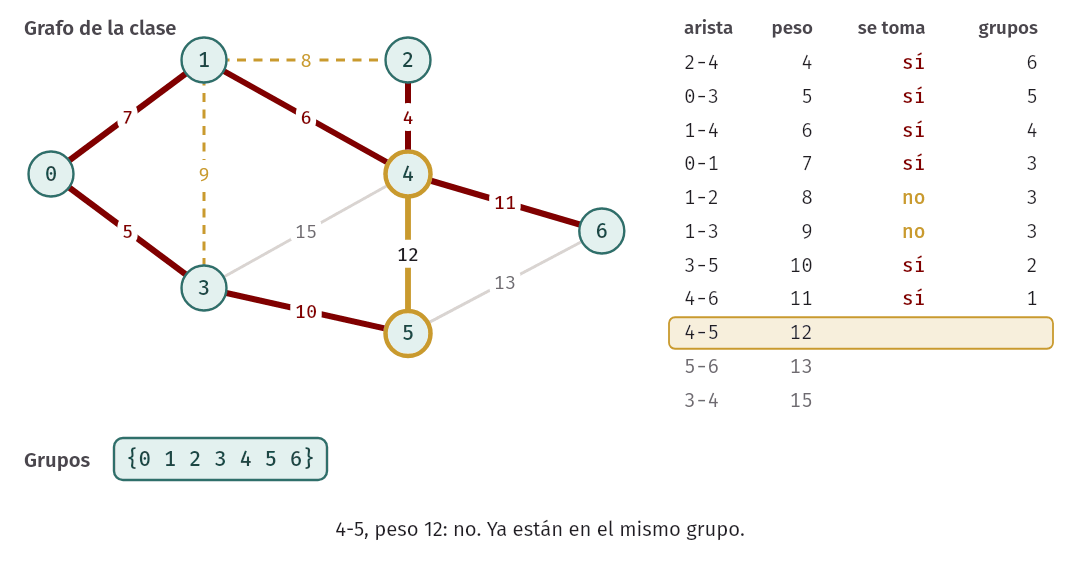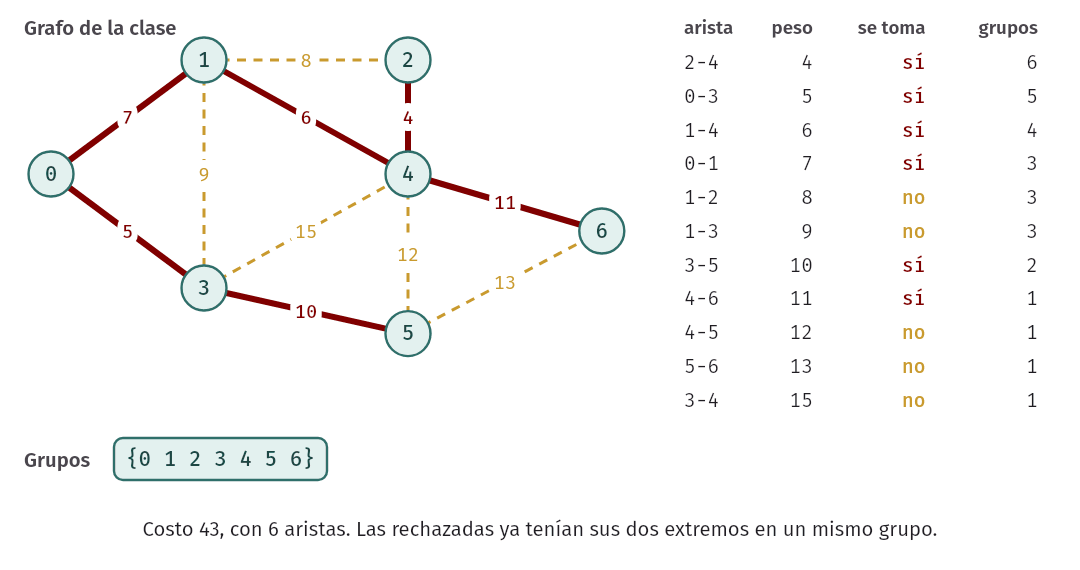
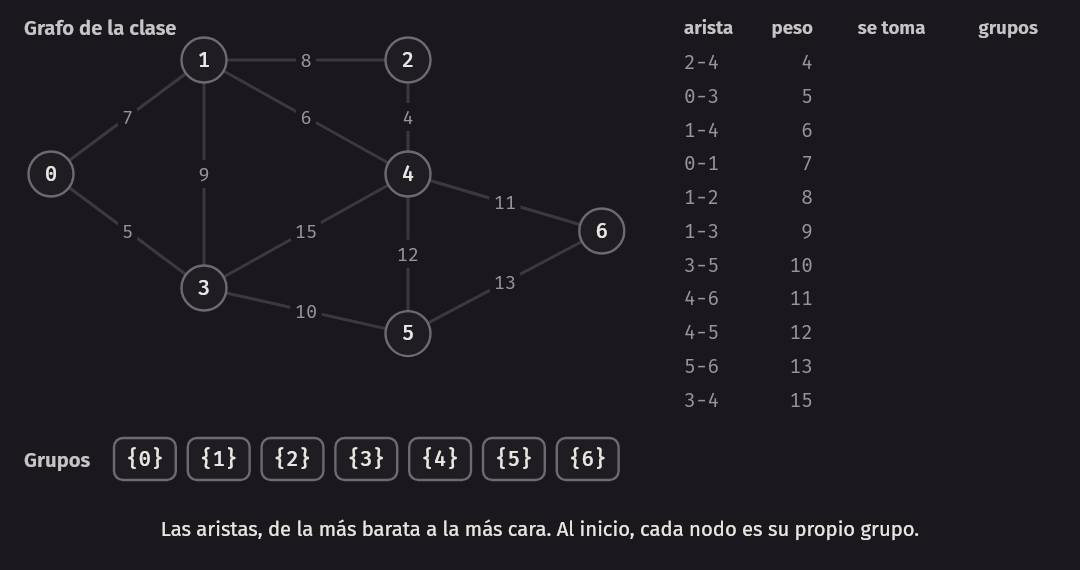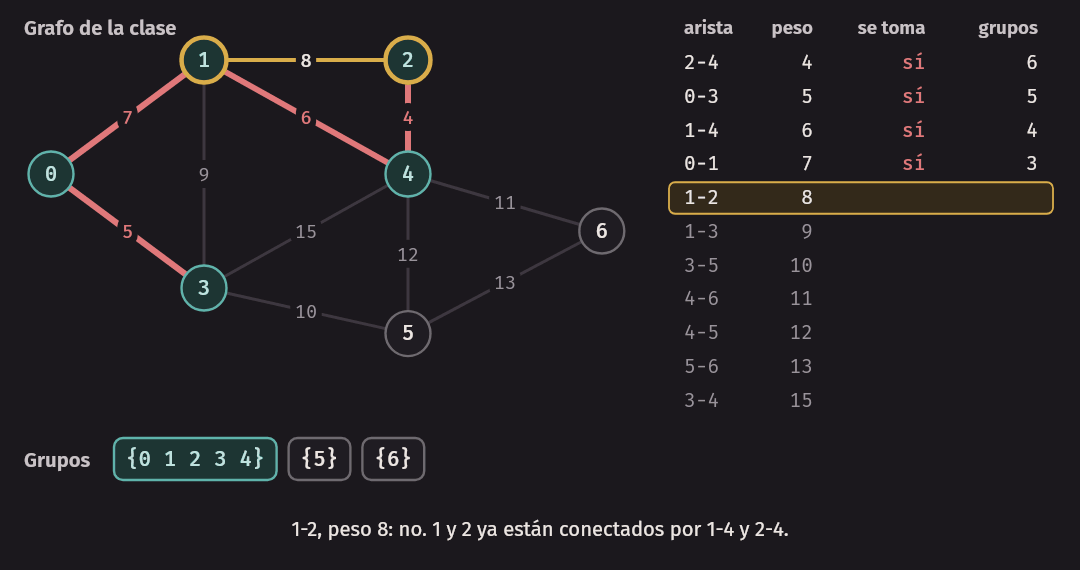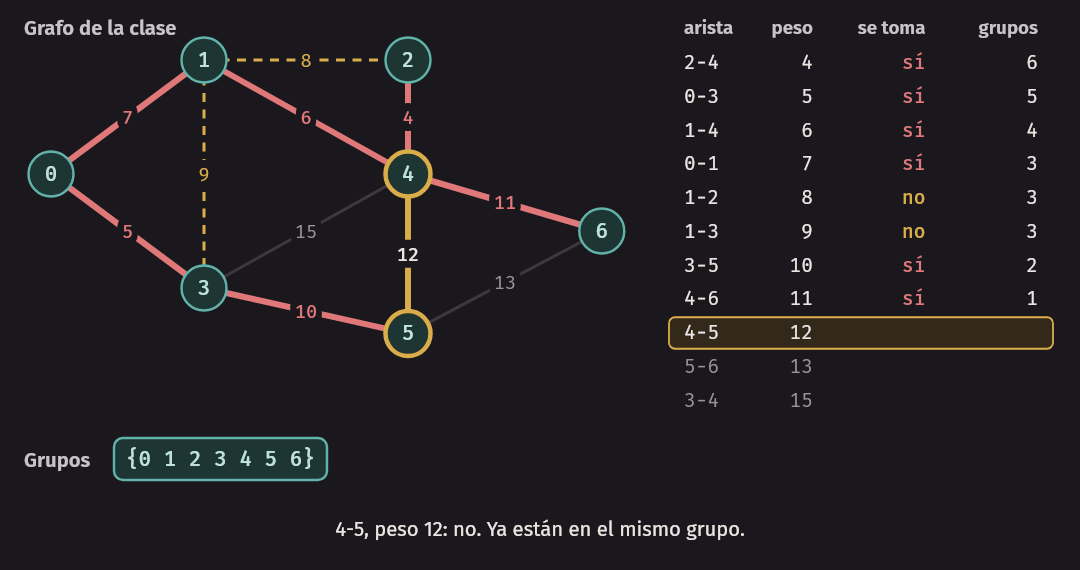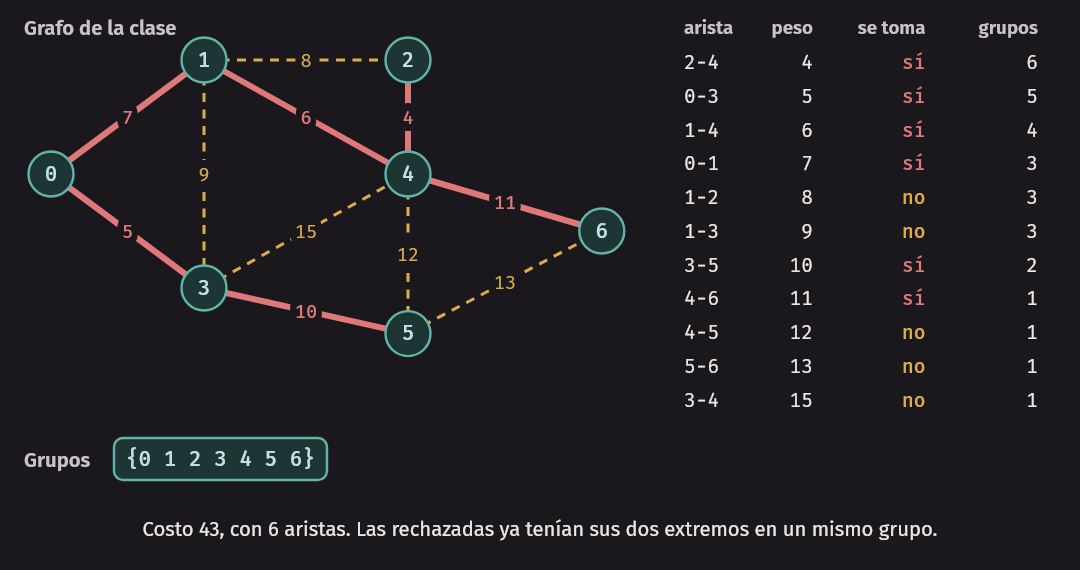
Este es el grafo con el que vamos a trabajar en toda la sesión. Tiene 7 nodos y 11 aristas, todas de peso distinto.
La notación 2-4:4 quiere decir “la arista entre 2 y 4 pesa 4”.
0-1:7   0-3:5   1-2:8   1-3:9   1-4:6   2-4:4
3-4:15  3-5:10  4-5:12  4-6:11  5-6:13

    1 ---8--- 2
   /|\       /
  7 9  6    4
 /  |   \  /
0   |    4 ---11--- 6
 \  |   /|         /
  5 | 15 12       13
   \|/   |      /
    3 --10-- 5 -
Un programa puede probar todos los árboles de expansión de un grafo tan pequeño. Hay 141, y el de menor peso pesa 43. Con grafos más grandes eso no es opción: un grafo completo con V nodos tiene V^(V−2) árboles de expansión. Esta fuerza bruta sirve para otra cosa: es el árbitro contra el que vamos a comparar todo lo demás.
Ideas parecidas que fallan
Antes de demostrar nada, veamos tres ideas razonables. Las tres están en mst_traces.cpp, corridas sobre el mismo
grafo. Esta es la última parte de su salida:
$ build/mst_traces
Fuerza bruta: 141 árboles de expansión, mínimo 43, 1 de ese costo

Las n - 1 aristas más baratas:
  aristas: 2-4:4 0-3:5 1-4:6 0-1:7 1-2:8 1-3:9
  costo 39, grupos 3, no es árbol de expansión
Cada nodo elige su arista más barata:
  aristas: 0-3:5 1-4:6 2-4:4 3-5:10 4-6:11
  costo 36, grupos 2, no es árbol de expansión
Árbol de caminos mínimos desde 0:
  aristas: 0-3:5 0-1:7 1-4:6 1-2:8 3-5:10 4-6:11
costo 47, grupos 1, es árbol de expansión- Las V − 1 aristas más baratas. Tiene el número justo de aristas y cuesta 39, menos que el óptimo. Pero no sirve: 1, 2 y 4 forman un ciclo, 0, 1 y 3 forman otro, y 5 y 6 quedan sueltos. Un costo menor que el óptimo es la señal de que la respuesta no es válida.
- Cada nodo elige su arista más barata. Todas las aristas elegidas son buenas, como veremos, pero no alcanzan: quedan dos grupos, {0, 3, 5} y {1, 2, 4, 6}.
- El árbol de caminos mínimos. Dijkstra desde 0 también da un árbol de expansión, y este sí es válido. Pesa 47. Es el mismo error que encontramos en greedy la semana 4: válido no es óptimo. Volveremos a este caso, porque es el error más común del tema.
La propiedad del corte, con pesos distintos
Las reglas correctas se apoyan en un solo teorema. Necesitamos una definición.
Definición. Un corte de G es una partición de sus nodos en dos conjuntos no vacíos, S y V ∖ S. Una arista cruza el corte si tiene un extremo en cada lado.
Empezamos suponiendo que todos los pesos son distintos. Eso evita hablar de empates, y los vemos justo después.
Teorema (propiedad del corte, pesos distintos). Sea G conexo con pesos distintos y sea (S, V ∖ S) un corte. La arista más barata que cruza el corte pertenece a todo árbol de expansión mínima de G.
Técnica. Argumento de intercambio: si un árbol no contiene esa arista, se cambia una de sus aristas por ella y se obtiene un árbol más barato.
Sea e = (u, v) la arista más barata que cruza el corte, con u en S y v fuera. Sea T un árbol de expansión que no contiene a e. Vamos a demostrar que T no es mínimo.
Paso 1: hay una arista de T que cruza el corte. Por el hecho 2, T tiene un camino P de u a v. El camino empieza en S y termina fuera de S, así que en algún punto pasa de un lado al otro. Sea f una arista de P que cruza el corte. Como e no está en T, f ≠ e.
Paso 2: T′ = T − f + e es un árbol de expansión. Por el hecho 3, quitar f parte a T en dos pedazos. El camino P es el único camino de u a v en T, y usa f. Entonces, sin f, u y v ya no están conectados: quedan uno en cada pedazo. La arista e une justamente esos dos pedazos, así que T′ conecta todos los nodos. Tiene el mismo número de aristas que T, V − 1. Por el hecho 1, es un árbol de expansión.
Paso 3: T′ pesa menos. Las dos aristas e y f cruzan el corte y e es la más barata de todas las que lo cruzan. Como los pesos son distintos, w(e) < w(f). Luego w(T′) = w(T) + w(e) − w(f) < w(T).
Así que T no es mínimo. Por lo tanto, todo árbol de expansión mínima contiene a e. ∎
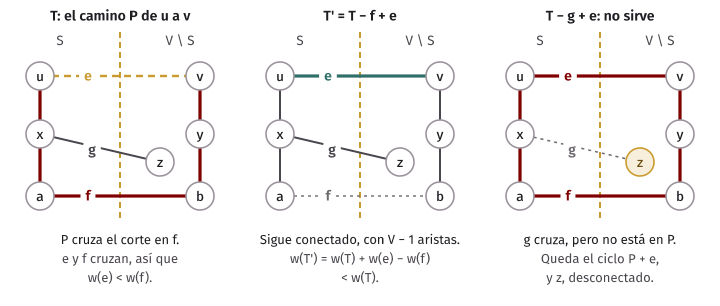
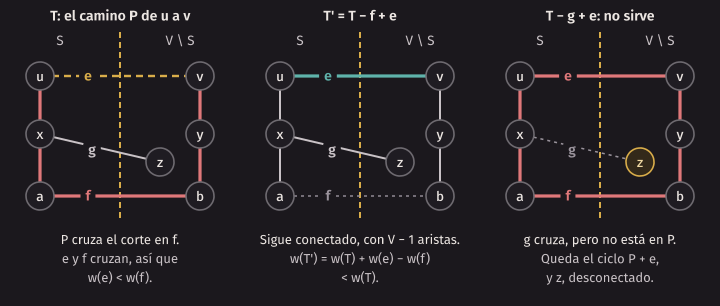
Error común. Quedarse en el Paso 1 y elegir cualquier arista de T que cruce el corte. Hay que elegir una del camino entre u y v. Si se saca otra que también cruce pero no esté en P, T − f + e tiene el ciclo formado por P y e, y deja dos partes desconectadas. El Paso 2 es lo que justifica esa elección: solo las aristas de P, al salir, separan a u de v.
Corolario: con pesos distintos hay un solo árbol mínimo
Un árbol de expansión mínima existe, porque hay una cantidad finita de árboles de expansión y G es conexo. Más abajo veremos que Prim encuentra uno eligiendo siempre “la más barata de un corte”. Con pesos distintos, cada una de esas V − 1 aristas está en todo árbol mínimo. Un árbol mínimo tiene exactamente V − 1 aristas, así que todos son el mismo. Por eso la fuerza bruta del ejemplo dice “1 de ese costo”.
Empates: qué cambia con pesos repetidos
Si hay pesos iguales, el teorema tal como está es falso. El programa ties_demo lo muestra con el ejemplo más
pequeño:
$ build/ties_demo
Triángulo con tres pesos 1:
  árbol mínimo: 0-1 0-2
  árbol mínimo: 0-1 1-2
  árbol mínimo: 0-2 1-2
  cortes y una arista más barata de cada uno:
    {0} | {1 2}: 0-1 con peso 1, la más barata
    {2} | {0 1}: 0-2 con peso 1, la más barata
    {1} | {0 2}: 1-2 con peso 1, la más barata
  juntas forman 1 grupo y un ciclo
Hay dos cosas que mirar.
Primero, hay tres árboles mínimos, y ninguna arista está en los tres. Así que “pertenece a todo árbol mínimo” ya no vale.
Segundo, y esto es lo delicado: se podría pensar que basta con debilitar el enunciado a “una arista más barata de un corte pertenece a algún árbol mínimo”. Eso es cierto, pero no alcanza para justificar un algoritmo. Miren el programa: cada una de las tres aristas es la más barata de su corte, y cada una está en algún árbol mínimo. Y las tres juntas forman un ciclo. Un greedy toma varias aristas, y necesita que todas juntas quepan en un mismo árbol mínimo. Saber que cada una cabe en alguno no da eso.
El enunciado correcto lleva en cuenta lo ya elegido.
Definición. Un corte respeta a un conjunto de aristas F si ninguna arista de F lo cruza.
Teorema (propiedad del corte, general). Sea G conexo, con cualquier peso. Sea F un conjunto de aristas contenido en algún árbol de expansión mínima. Sea (S, V ∖ S) un corte que respeta a F, y sea e una arista de peso mínimo entre las que cruzan ese corte. Entonces F ∪ {e} también está contenido en algún árbol de expansión mínima.
Con F vacío se obtiene el enunciado débil. Y la versión con pesos distintos ya sale de aquí, salvo lo de “todo árbol”.
Técnica. El mismo intercambio. La diferencia es que ahora la desigualdad no es estricta, y que hay que cuidar de no sacar nada de F.
Sea T un árbol de expansión mínima que contiene a F. Sea e = (u, v) como en el enunciado.
Caso 1: e está en T. Entonces F ∪ {e} ⊆ T y terminamos.
Caso 2: e no está en T. Como antes, el camino P de u a v en T empieza de un lado del corte y termina del otro, así que tiene una arista f que cruza el corte, con f ≠ e. Sea T′ = T − f + e.
- T′ es un árbol de expansión, por el mismo argumento del Paso 2 anterior, que no usó los pesos.
- f no está en F, porque f cruza el corte y el corte respeta a F. Entonces F sigue completo en T′, y además está e: F ∪ {e} ⊆ T′.
- e es de peso mínimo entre las que cruzan, y f cruza, así que w(e) ≤ w(f). Luego w(T′) = w(T) + w(e) − w(f) ≤ w(T).
- T es mínimo, así que w(T′) no puede ser menor que w(T). Entonces w(T′) = w(T), y T′ también es mínimo.
En los dos casos, F ∪ {e} está en un árbol de expansión mínima. ∎
Veamos por qué esto descarta el ciclo del triángulo. Con F = {0-1}, el corte {2} | {0 1} lo respeta, y se puede agregar 0-2. Ahora F = {0-1, 0-2}. Para agregar 1-2 habría que usar el corte {1} | {0 2}, y ese corte no respeta a F: lo cruza 0-1. El teorema no autoriza ese paso.
Idea clave. Con empates no hay un árbol mínimo sino varios, todos del mismo peso. Lo que se mantiene es la invariante “lo elegido hasta ahora cabe en algún árbol mínimo”, y ese árbol puede ir cambiando en la demostración. Un intercambio con desigualdad no estricta cambia de árbol sin empeorarlo.
test_examples.cpp lo comprueba por fuerza bruta en 120 grafos al azar con pesos de 1 a 3, muchos empates: para
subconjuntos F al azar de un árbol mínimo, para todos los cortes que respetan a F, y para toda arista de peso
mínimo
de cada uno de esos cortes, busca entre todos los árboles mínimos uno que contenga a F y a esa arista. Siempre lo
hay.
Kruskal: de la arista más barata a la más cara
Kruskal mira las aristas de la más barata a la más cara. Toma cada una que no forme un ciclo con lo ya tomado. Lo tomado es un bosque: varios árboles sueltos, que se van uniendo. Para preguntar si una arista forma un ciclo se usa union-find: forma ciclo si y solo si sus dos extremos ya están en el mismo grupo.
algoritmo kruskal(n, aristas)
    ordenar aristas por peso, de menor a mayor
    crear un union-find con n grupos
    elegidas ← lista vacía
    para cada arista (u, v) en aristas hacer
        si find(u) ≠ find(v) entonces
            union(u, v)
            agregar (u, v) a elegidas
        fin si
    fin para
    devolver elegidas
fin algoritmo
Esta es la corrida sobre el grafo de la clase. Se ve qué aristas rechaza: 1-2 con peso 8 ya no sirve porque 1 y 2 quedaron conectados por 1-4 y 2-4, y 1-3 tampoco, por 0-1 y 0-3.
$ build/mst_traces
Kruskal:
  arista  peso  se toma  grupos después
  2-4       4  sí      6
  0-3       5  sí      5
  1-4       6  sí      4
  0-1       7  sí      3
  1-2       8  no      3
  1-3       9  no      3
  3-5      10  sí      2
  4-6      11  sí      1
  4-5      12  no      1
  5-6      13  no      1
  3-4      15  no      1
  costo 43, 6 aristas
Coincide con la fuerza bruta. Con un grafo conexo se podría parar en cuanto quede un grupo, a la altura de 4-6, pero eso no cambia el peor caso.
inline std::vector<Edge> kruskal(int n, const std::vector<Edge>& edges) {
    UnionFind sets(n);
    std::vector<Edge> forest;
    for (const Edge& e : sorted_by_weight(edges)) {
        // Invariante: forest está contenido en algún árbol de expansión mínima.
        if (sets.unite(e.u, e.v)) forest.push_back(e);
    }
    return forest;
}
unite devuelve falso si los dos ya estaban en el mismo grupo. UnionFind está en mst.h, en pocas líneas sobre
un
std::vector, con unión por tamaño y compresión de caminos. Esta función devuelve un bosque: si el grafo no es
conexo,
da un árbol por componente, con menos de n − 1 aristas. Revisar ese caso le toca a quien la llama.
Por qué es correcto
Afirmación. Si G es conexo, Kruskal devuelve un árbol de expansión mínima, con o sin empates.
Técnica. Invariante de ciclo, usando la propiedad del corte general en cada arista aceptada.
Invariante. Antes de cada vuelta, F (las elegidas hasta ahora) está contenido en algún árbol de expansión mínima. Al inicio F está vacío y la invariante es cierta, porque existe un árbol mínimo.
Una arista rechazada no cambia F. Ahí no hay nada que comprobar.
Una arista aceptada. Sea e = (u, v) una arista que Kruskal acepta. u y v están en grupos distintos de F. Tomemos como S el grupo de u, es decir, los nodos conectados con u por aristas de F. Es un corte: u está adentro y v está afuera.
- El corte respeta a F. Por definición de grupo, ninguna arista de F sale de S.
- e es de peso mínimo entre las que lo cruzan. Sea g otra arista que cruza el corte, y supongamos que se miró antes que e, es decir, en la lista ordenada va antes. Entonces, cuando se miró, o se aceptó o se rechazó. Si se aceptó, está en F, y eso no puede ser, porque nada de F cruza el corte. Si se rechazó, sus extremos ya estaban en un mismo grupo, y los grupos nunca se dividen, así que siguen juntos, y g no cruza el corte. Contradicción en los dos casos. Entonces toda arista que cruza el corte se mira después de e o es e, así que pesa al menos w(e).
Por el teorema, F ∪ {e} está en algún árbol mínimo. La invariante se mantiene.
Al terminar, F es un árbol de expansión. F no tiene ciclos, porque nunca se aceptó una arista con los dos extremos en un mismo grupo. Supongamos que F dejó dos grupos o más. Como G es conexo, hay una arista de G entre dos grupos distintos de F. Cuando Kruskal la miró, sus extremos estaban en grupos distintos, porque los grupos solo se unen. La habría aceptado, y ahora estarían juntos. Contradicción. Luego F conecta todo y tiene V − 1 aristas.
F está contenido en un árbol mínimo, que también tiene V − 1 aristas. Entonces F es ese árbol. ∎
La demostración no usó nada sobre cómo se rompen los empates: vale para cualquier orden entre aristas del mismo peso. Órdenes distintos pueden dar árboles distintos, todos del mismo peso:
Cuadrado con pesos 2, diagonal 0-2:3 y 3-4:1:
  árbol mínimo: 0-1 1-2 2-3 3-4  costo 7
  árbol mínimo: 0-1 1-2 3-0 3-4  costo 7
  árbol mínimo: 0-1 2-3 3-0 3-4  costo 7
  árbol mínimo: 1-2 2-3 3-0 3-4  costo 7
  Kruskal, con la lista como viene:  costo 7
  Kruskal, con la lista invertida:   costo 7
  Prim desde 0:                      costo 7
  Prim desde 4:                      costo 7
Costo
- Ordenar: O(E log E).
- E operaciones de union-find, a un costo amortizado casi constante, O(E · α(V)), como se vio en Estructuras de Datos.
- Total: O(E log E). El ordenamiento domina.
En un grafo simple, E < V², así que log E < 2 log V, y O(E log E) es lo mismo que O(E log V). Si los pesos vienen ya ordenados, o son enteros en un rango chico y se puede usar counting sort, queda casi lineal.
Prim: crecer desde un nodo
Prim mantiene un solo árbol, que empieza en un nodo y crece. En cada paso agrega la arista más barata que sale del árbol, es decir, la que cruza el corte entre los nodos del árbol y los demás.
Para hallar esa arista rápido se usa una cola de prioridad. Hay un detalle: std::priority_queue no permite
cambiar la
prioridad de lo que ya está adentro, ni sacar algo del medio. Entonces usamos borrado perezoso (lazy deletion):
cuando
un nodo entra al árbol, se meten todas sus aristas hacia afuera, sin tocar lo que ya había. Algunas de las aristas
que
están en la cola dejarán de cruzar el corte. Se quedan ahí hasta que salgan, y en ese momento se descartan.
algoritmo prim(n, grafo, origen)
    en_arbol ← arreglo de n valores falso
    cola ← cola de prioridad vacía
    elegidas ← lista vacía
    agregar_nodo(origen)
    mientras cola no esté vacía hacer
        sacar de cola la entrada de menor peso (peso, v, desde)
        si no en_arbol[v] entonces
            agregar (desde, v) a elegidas
            agregar_nodo(v)
        fin si
    fin mientras
    devolver elegidas
fin algoritmo

algoritmo agregar_nodo(u)
    en_arbol[u] ← verdadero
    para cada vecino v de u, con peso w, hacer
        si no en_arbol[v] entonces
            meter en cola la entrada (w, v, u)
        fin si
    fin para
fin algoritmo
La corrida desde 0. Noten las líneas de “descartada”: son las entradas viejas.
Prim desde 0 (arista que sale de la cola, y qué pasa):
  0-3:5   entra 3, quedan 4 en la cola
  0-1:7   entra 1, quedan 5 en la cola
  1-4:6   entra 4, quedan 7 en la cola
  4-2:4   entra 2, quedan 6 en la cola
  1-2:8   descartada: 2 ya está en el árbol
  3-1:9   descartada: 1 ya está en el árbol
  3-5:10  entra 5, quedan 4 en la cola
  4-6:11  entra 6, quedan 3 en la cola
  4-5:12  descartada: 5 ya está en el árbol
  5-6:13  descartada: 6 ya está en el árbol
  3-4:15  descartada: 4 ya está en el árbol
  costo 43, entradas 11, descartadas 5, aristas del grafo 11
Las aristas elegidas son las mismas seis de Kruskal, como debe ser con pesos distintos, pero en otro orden. Prim no mira las aristas de menor a mayor: tomó la de peso 5 antes que la de peso 4, porque a esa todavía no se podía llegar.
inline PrimResult prim(int n, const std::vector<Edge>& edges, int source) {
    using Entry = std::tuple<int, int, int>;  // peso, nodo de afuera, nodo del árbol
    auto adj = adjacency(n, edges);
    std::vector<bool> in_tree(static_cast<std::size_t>(n), false);
    std::priority_queue<Entry, std::vector<Entry>, std::greater<Entry>> heap;
    PrimResult result;

    auto add_node = [&](int u) {
        in_tree[u] = true;
        for (const Neighbor& nb : adj[u]) {
            if (!in_tree[nb.to]) {
                heap.push({nb.weight, nb.to, u});
                result.pushes++;
            }
        }
    };

    add_node(source);
    while (!heap.empty()) {
        auto [weight, v, from] = heap.top();
        heap.pop();
        if (in_tree[v]) {
            result.stale_pops++;  // sus dos extremos ya están adentro: no cruza el corte
            continue;
        }
        result.tree.push_back({from, v, weight});
        add_node(v);
    }
    return result;
}
En C++.
std::priority_queuepor defecto saca el mayor. Constd::greatersaca el menor. Una tupla se compara elemento por elemento, así que el peso va primero. Elauto [weight, v, from] = heap.top()copia: hay que hacerlo antes delpop, porquetopdevuelve una referencia a algo quepopdestruye.
Por qué es correcto
Afirmación. Si G es conexo, Prim devuelve un árbol de expansión mínima, con o sin empates.
Técnica. Invariante de ciclo, con la propiedad del corte general. Aquí el corte es siempre el mismo tipo: S son los nodos del árbol.
Primero una propiedad de la cola. Antes de cada vuelta, toda arista que cruza el corte (S, V ∖ S) está en la cola. Sea (u, v) una arista, con u en S y v fuera. Cuando u entró al árbol, v no estaba, porque los nodos nunca salen. Entonces se metió la entrada (w, v, u). Esa entrada no ha salido: si hubiera salido, como v no estaba en el árbol, v habría entrado.
Y todo lo que hay en la cola tiene desde en S. Las entradas cuyo v está en S tienen los dos extremos adentro y no
cruzan
el corte: son las viejas. Las demás sí lo cruzan. Por lo tanto, la primera entrada que sale y no se descarta es
una arista
de peso mínimo entre las que cruzan el corte.
Invariante. F, las aristas elegidas, está contenido en algún árbol mínimo, y forma un árbol sobre S. Al inicio, F está vacío y S = {origen}. En una vuelta que agrega (u, v): el corte (S, V ∖ S) respeta a F, porque todas las aristas de F tienen sus dos extremos en S; y (u, v) es de peso mínimo entre las que lo cruzan. Por el teorema, F ∪ {(u, v)} está en algún árbol mínimo. Además, v estaba fuera, así que sigue siendo un árbol, ahora sobre S ∪ {v}.
Al terminar. La cola está vacía, así que ninguna arista cruza el corte. Como G es conexo, eso solo puede ser si S son todos los nodos. Entonces F es un árbol con V nodos, contenido en un árbol mínimo: es ese árbol. ∎
Costo
Contemos las entradas. Una arista (u, v) entra a la cola cuando entra al árbol el primero de sus extremos, y el otro está afuera. Cuando entra el segundo, el primero ya está adentro, así que no se mete de nuevo. Cada arista entra a lo sumo una vez. Por eso hay a lo sumo E entradas y a lo sumo E salidas, cada una a un costo O(log E). Lo demás es Θ(V + E), de armar la lista de adyacencia y recorrerla.
- Total: O(E log E). En un grafo simple, log E < 2 log V, así que es O(E log V).
- Con aristas paralelas, E puede pasar de V². Se puede guardar solo la más barata de cada par, o dejar el costo en O(E log E).
En el ejemplo: 11 aristas, 11 entradas, y 5 descartadas. En un grafo conexo, las entradas aceptadas son exactamente V − 1, así que las descartadas son E − (V − 1): 11 − 6 = 5.
Una cola con “cambiar prioridad” tendría a lo sumo V entradas y el mismo orden de costo, O(E log V). El borrado perezoso gasta un poco más de memoria a cambio de usar la cola de la biblioteca sin tocarla.
Midiendo
make bench corre Kruskal y Prim con grafos al azar conexos y pesos al azar hasta 10⁹. Está compilado con -O2, y
toma el
menor de 3 intentos. Las columnas de entradas y descartes son exactas. Los tiempos son de una corrida en el
contenedor del
curso, en una máquina compartida, y dependen de la máquina.
$ make bench
build/mst_bench
       V         E  kruskal ms   prim ms    entradas  descartes costo igual
   50000    200000        14.5      35.4      200000     150001        sí
  200000    800000        65.2     186.4      800000     600001        sí
  800000   3200000       288.4    1244.5     3200000    2400001        sí
  100000   3200000       277.2     693.8     3200000    3100001        sí
    3000   3200000       271.0     609.5     3200000    3197001        sí
Las entradas valen E y los descartes valen E − (V − 1), exactamente como dice la cuenta. Los dos algoritmos dan el mismo costo. Y en estas corridas Kruskal es más rápido, entre 2 y algo más de 4 veces. Eso es lo que muestra la medición, para esta implementación y estos grafos, y no es una ley: el orden de costo no predice constantes. Con E multiplicado por 16, de la primera fila a la tercera, Kruskal tarda unas 20 veces más y Prim unas 35. Las dos cuentas crecen más rápido que E, y la de Prim más de lo que explicaría el factor log E. Con estas filas no podemos separar el log de otros efectos de la máquina, así que no le ponemos una causa.
Prim frente a Dijkstra
Si Prim les parece familiar, es porque es casi Dijkstra. Solo cambia una línea: la clave con que una arista entra a la cola.
Prim:      para cada vecino v de u, con peso w:  meter (w,            v, u)
Dijkstra:  para cada vecino v de u, con peso w:  meter (dist[u] + w,  v, u)
Se parecen mucho en el código. Resuelven problemas distintos.
| Prim | Dijkstra | |
|---|---|---|
| Clave de v | Peso de la mejor arista desde el árbol hasta v | Largo del mejor camino desde el origen hasta v |
| Qué minimiza | Suma de pesos del árbol | Distancia de cada nodo al origen, por separado |
| El origen | No importa: el peso final es el mismo | Es parte del problema |
| Pesos negativos | Funciona | Falla, como se vio la semana 5 |
| Tipo de grafo | No dirigido | Dirigido o no dirigido |
La demostración de Prim no usó el signo de los pesos en ningún lado: solo comparó pesos entre sí. La de Dijkstra sí lo usa.
dijkstra en mst.h tiene casi la misma forma de prim, y sobre el grafo de la clase eligió el árbol de 47 del
principio.
Error común. Creer que un árbol de expansión mínima contiene los caminos mínimos entre sus nodos. No los contiene, y el contraejemplo cabe en un triángulo:
$ build/mst_vs_paths
Triángulo: 0-1:2 1-2:2 0-2:3
  árbol de expansión mínima: 0-1:2 1-2:2 costo 4
  de 0 a 2 dentro de ese árbol: 4
  de 0 a 2 en el grafo:         3
  árbol de caminos desde 0:  0-1:2 0-2:3 costo 5
El árbol mínimo conecta todo con 4, pero para ir de 0 a 2 da la vuelta y paga 4, cuando la arista directa cuesta 3. Y el árbol de caminos desde 0 da las mejores distancias desde 0, y pesa 5. Ningún árbol da las dos cosas en este grafo. Son dos preguntas distintas: cuánto cuesta construir la red, y cuánto cuesta un viaje dentro de ella.
Sumar una constante
Otra diferencia, que sale de la misma raíz. Sumemos c a todas las aristas.
Sumar una constante c a todas las aristas de 0-1:1 1-2:1 0-2:3 2-3:2 1-3:4
 c  árbol de expansión mínima    costo  distancia 0 a 2  camino
 0  0-1 1-2 2-3                  4      2                0-1-2
 1  0-1 1-2 2-3                  7      4                empate
 2  0-1 1-2 2-3                  10     5                0-2
10  0-1 1-2 2-3                  34     13               0-2
Afirmación. Sumar c a todas las aristas no cambia cuáles son los árboles de expansión mínima.
Todo árbol de expansión tiene exactamente V − 1 aristas. Entonces todos suben exactamente (V − 1)·c, y su orden por peso queda igual. ∎
Con los caminos no pasa: un camino de k aristas sube k·c, y los caminos con más aristas suben más. En la tabla, el camino 0-1-2 ganaba con c = 0, y con c = 2 gana la arista directa. Por eso sumar una constante no arregla una arista negativa para Dijkstra: no conserva cuál es el camino mínimo.
En cambio, en un árbol mínimo sí se puede. Si les preocupa un peso negativo, sumen lo que haga falta para que todos sean positivos, y el árbol mínimo es el mismo. Es otra forma de ver que el signo no importa aquí.
En la práctica. Un árbol de expansión mínima modela bien el costo de construir una red que solo tiene que quedar conectada: fibra, cables, tuberías. Si un corte de una sola arista no se puede tolerar, un árbol no alcanza, porque toda arista de un árbol es un punto único de falla. Y solo usa los nodos que se le dieron: si se permite poner puntos intermedios para ahorrar, el problema cambia, y pasa a ser el árbol de Steiner, que es NP-difícil.
Agrupar con la máxima separación
Kruskal sirve también para un problema que a primera vista no tiene que ver: agrupar.
Tenemos V objetos y una distancia entre cada par: una arista por par, o solo las que importen. Queremos dividirlos en k grupos no vacíos de modo que los grupos queden lo más separados posible.
Definición. Sea C una partición de los nodos en k grupos, con k ≥ 2. Su separación (spacing) es el menor peso entre las aristas con extremos en grupos distintos.
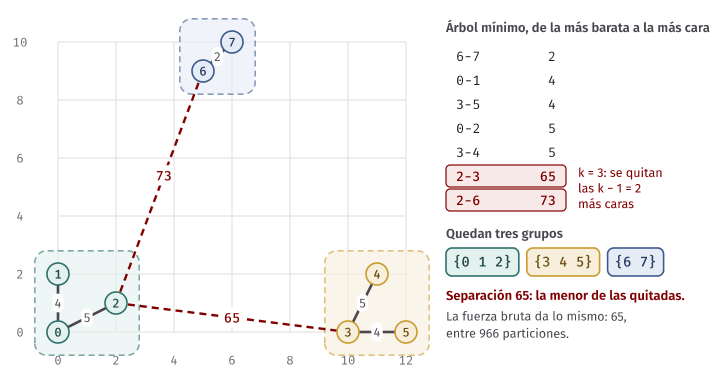
Queremos la partición de mayor separación. Con ocho puntos del plano y k = 3 se ve qué se busca: tres nubes, cada una lejos de las otras.
Algoritmo. Calcular un árbol de expansión mínima y quitarle las k − 1 aristas más caras. Quedan k pedazos, y esos son los grupos. Es lo mismo que parar Kruskal cuando quedan k grupos.
algoritmo agrupar(n, aristas, k)
    arbol ← kruskal(n, aristas)
    ordenar arbol por peso, de menor a mayor
    quitar de arbol las últimas k - 1 aristas
    devolver los grupos que deja arbol
fin algoritmo
Veamos una idea parecida que falla: quitar las k − 1 aristas más caras del grafo, en vez de las del árbol. En un grafo con muchas aristas casi nunca separa nada. Abajo, en los ocho puntos, sigue todo conectado.
$ build/clustering_demo
Puntos: 0=(0,0) 1=(0,2) 2=(2,1) 3=(10,0) 4=(11,2) 5=(12,0) 6=(5,9) 7=(6,10)

Árbol de expansión mínima, de la arista más barata a la más cara:
  6-7:2 0-1:4 3-5:4 0-2:5 3-4:5 2-3:65 2-6:73

k = 2: {0 1 2 3 4 5} {6 7}
  separación 73, fuerza bruta 73 entre 127 particiones
k = 3: {0 1 2} {3 4 5} {6 7}
  separación 65, fuerza bruta 65 entre 966 particiones
k = 4: {0 1 2} {3 5} {4} {6 7}
  separación 5, fuerza bruta 5 entre 1701 particiones

Idea que falla, k = 3: quitar las 2 aristas más caras del grafo completo
  quedan 1 grupo
Los pesos son distancias al cuadrado, para trabajar con enteros. Eso ordena igual que la distancia, y por eso los grupos son los mismos. El programa compara con todas las particiones posibles: 966 para k = 3. Y coincide.
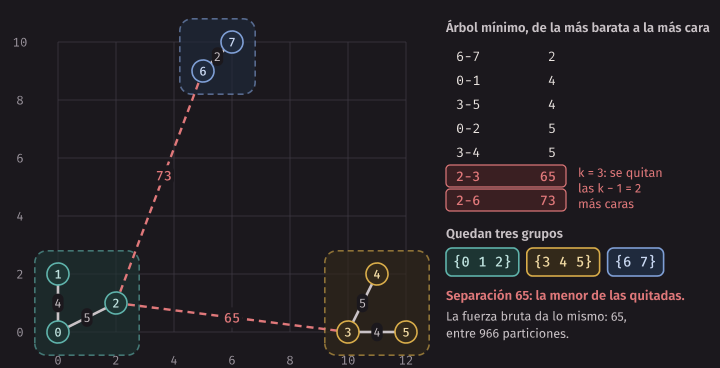
Afirmación. Sea G conexo, y sea T un árbol de expansión mínima cualquiera. Sea C la partición que se obtiene al quitarle a T k − 1 aristas de las más caras, con cualquier elección entre empates. Entonces ninguna partición en k grupos tiene mayor separación que C.
Técnica. Primero se calcula exactamente la separación de C. Después se muestra que cualquier otra partición tiene una arista barata que la cruza.
Sea d* el menor peso entre las aristas quitadas. Todas las aristas que se quedaron en T pesan a lo sumo d*, porque se quitaron las más caras.
Paso 1: la separación de C es exactamente d*.
- Es a lo sumo d*. La arista quitada de peso d* tiene sus extremos en grupos distintos, porque el camino de T entre ellos era esa misma arista, y ya no está.
- Es al menos d*. Supongamos que una arista g = (x, y) de peso menor que d* une grupos distintos de C. Entonces g no está en T, porque las de T que unen grupos distintos son las quitadas, y pesan al menos d*. El camino de T entre x e y tiene que usar alguna arista quitada f, porque si solo usara aristas que se quedaron, x e y estarían en el mismo grupo. Igual que en la propiedad del corte, T − f + g es un árbol de expansión: quitar f separa a x de y, y g los vuelve a unir. Pesa w(T) + w(g) − w(f) < w(T), porque w(g) < d* ≤ w(f). Eso contradice que T sea mínimo.
Paso 2: cualquier otra partición C′ en k grupos tiene separación a lo sumo d*. Si toda pareja de nodos que C pone junta también estuviera junta en C′, cada grupo de C estaría dentro de un grupo de C′. Como las dos tienen k grupos no vacíos, serían la misma partición. Entonces hay dos nodos a y b en un mismo grupo de C y en grupos distintos de C′.
Como a y b están en un mismo grupo de C, hay un camino entre ellos usando solo aristas que se quedaron en T. El camino empieza en un grupo de C′ y termina en otro, así que alguna de sus aristas tiene los extremos en grupos distintos de C′. Esa arista pesa a lo sumo d*. Por lo tanto, la separación de C′ es a lo sumo d*. ∎
Noten que no hizo falta suponer pesos distintos. test_examples.cpp compara con todas las particiones en 300
grafos al azar, con
hasta 7 nodos y muchos empates, y para todo k posible.
En la práctica. Esto se conoce como agrupamiento por enlace simple (single-linkage). Optimiza exactamente lo que dice, la separación, y nada más: no le importa si los grupos quedan parejos ni compactos. Una cadena de puntos cercanos queda en un mismo grupo aunque sus extremos estén lejos, y un punto apartado puede quedar solo, como el 4 con k = 4 arriba.
DFS con tiempos de inicio y de fin
Pasamos a la Sesión B. Ahora los grafos son dirigidos, y las aristas son pares ordenados: u → v.
Ustedes ya vieron DFS en Estructuras de Datos: desde un nodo, bajar por el primer vecino sin marcar, y al quedarse sin vecinos, volver. Ahí nos importaba qué nodos se alcanzan. Ahora vamos a anotar algo más. Un reloj empieza en 0 y avanza 1 cada vez que un nodo empieza o termina.
algoritmo dfs_completo(grafo, n)
    reloj ← 0
    para u desde 0 hasta n - 1 hacer
        si inicio[u] = 0 entonces
            visitar(u)
        fin si
    fin para
fin algoritmo

algoritmo visitar(u)
    reloj ← reloj + 1
    inicio[u] ← reloj
    para cada vecino v de u hacer
        si inicio[v] = 0 entonces
            visitar(v)
        fin si
    fin para
    reloj ← reloj + 1
    fin[u] ← reloj
fin algoritmo
Es un DFS completo: si desde el primer nodo no se alcanza todo, sigue con el siguiente sin visitar. Todo nodo se visita exactamente una vez, y toda arista se mira una vez, así que cuesta Θ(V + E).
En cada momento, un nodo está en uno de tres estados. Los vamos a usar en todas las demostraciones.
| Estado | Condición | Significa |
|---|---|---|
| Sin visitar | Todavía no tiene inicio |
Nadie llamó a visitar con él |
| Abierto | Tiene inicio y no tiene fin |
Su llamada está en curso: está en la pila |
| Cerrado | Tiene fin |
Su llamada ya terminó |
Los nodos abiertos son exactamente los de la pila de llamadas, y en la pila, cada uno llamó al siguiente. Así que los nodos abiertos forman un camino, desde la raíz actual hasta el nodo que se está visitando.
Los intervalos se anidan
Cada nodo u tiene un intervalo [inicio[u], fin[u]]. Como las llamadas se abren y se cierran como paréntesis, dos intervalos nunca se cruzan a medias.
Afirmación. Dados dos nodos distintos u y v, sus intervalos son disjuntos, o uno está completamente dentro del otro.
Supongamos que u empieza primero. Si v empieza después de que u terminó, son disjuntos. Si no, v empieza mientras la llamada de u está en curso, así que la llamada de v está dentro de la de u, y termina antes. El intervalo de v queda dentro. ∎
El lema del camino libre
Todo lo que viene se apoya en este resultado. Dice qué nodos se visitan dentro de la llamada de otro.
Lema (camino libre). Si al momento de empezar u existe un camino de u a x con todos sus nodos sin visitar (salvo u, que acaba de empezar), entonces x empieza y termina dentro del intervalo de u.
Técnica. Inducción sobre la posición en el camino.
Sea u = x₀, x₁, …, xₖ = x ese camino. Vamos a ver que cada xᵢ empieza durante la llamada de u. Para x₀ es cierto. Supongamos que xᵢ empezó durante la llamada de u, con i < k. Cuando se visita xᵢ, en algún momento se mira su arista hacia xᵢ₊₁. En ese momento hay dos posibilidades. Si xᵢ₊₁ está sin visitar, se visita ahí mismo, dentro de la llamada de xᵢ. Si ya está visitado, empezó antes de ese momento, y empezó después de que empezara u, porque estaba sin visitar cuando u empezó. En los dos casos, empezó durante la llamada de u.
Entonces x empieza durante la llamada de u, y por la anidación, termina antes que u. ∎
Corramos un ejemplo. Lean la tabla de abajo siguiendo el reloj.
$ build/dfs_traces
Grafo con ciclos:
  nodo  inicio  fin
     0       1    8
     1       2    5
     2       3    4
     3       6    7
     4       9   12
     5      10   11
El grafo es 0 → 1, 0 → 2, 0 → 3, 1 → 2, 2 → 0, 3 → 2, 4 → 3, 4 → 5 y 5 → 4. Los vecinos se miran en ese orden. El intervalo [3, 4] de 2 está dentro del [2, 5] de 1, que está dentro del [1, 8] de 0. Y el [6, 7] de 3 está dentro del de 0, y es disjunto con el de 1.
Si se escribe cada inicio como un paréntesis que abre y cada fin como uno que cierra, en orden de reloj, quedan bien balanceados:
(0 (1 (2 2) 1) (3 3) 0) (4 (5 5) 4)Tipos de arista
Cuando visitar(u) mira una arista u → v, el estado de v la clasifica. Cada arista cae exactamente en un tipo.
| Tipo | Estado de v al mirarla | Condición con tiempos |
|---|---|---|
| De árbol (tree) | Sin visitar: por aquí se visita v | inicio[u] < inicio[v] < fin[v] < fin[u] |
| Hacia atrás (back) | Abierto: v es un antecesor de u, o u mismo | inicio[v] ≤ inicio[u] < fin[u] ≤ fin[v] |
| Hacia adelante (forward) | Cerrado, y v empezó después que u | inicio[u] < inicio[v] < fin[v] < fin[u] |
| De cruce (cross) | Cerrado, y v empezó antes que u | inicio[v] < fin[v] < inicio[u] < fin[u] |
Una arista de árbol y una hacia adelante tienen los mismos tiempos. Se distinguen en que la de adelante llega a un nodo que ya se había visitado por otro camino. Un lazo, u → u, cuenta como arista hacia atrás: al mirarla, u está abierto.
  arista  tipo
  0 -> 1  árbol
  1 -> 2  árbol
  2 -> 0  atrás
  0 -> 2  adelante
  0 -> 3  árbol
  3 -> 2  cruce
  4 -> 3  cruce
  4 -> 5  árbol
  5 -> 4  atrás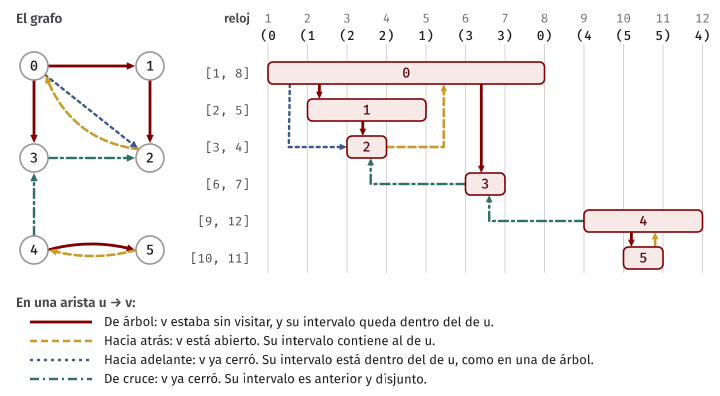
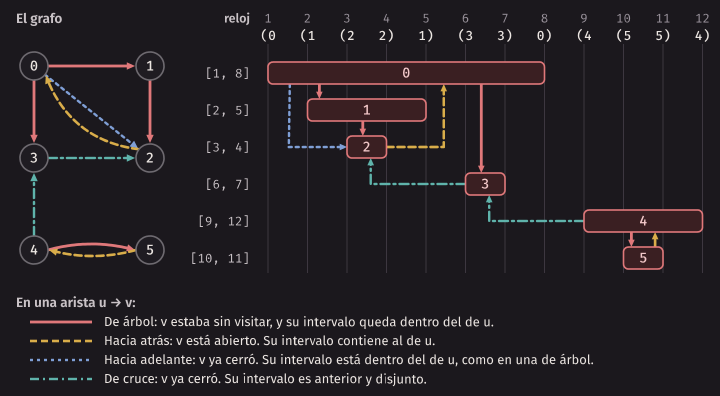
Miren 2 → 0: al mirarla, 0 está abierto, en la pila. Y hay un ciclo: 0 → 1 → 2 → 0. Lo mismo con 5 → 4 y el ciclo 4 → 5 → 4. Eso no es casualidad.
Esta clasificación es para grafos dirigidos. En uno no dirigido, cada arista se mira desde sus dos lados, y solo aparecen de árbol y hacia atrás. Es un buen ejercicio, y está al final.
Arista hacia atrás equivale a ciclo
Teorema. Un grafo dirigido tiene un ciclo si y solo si un DFS completo encuentra una arista hacia atrás. Vale para cualquier orden de nodos y de vecinos.
Técnica. Dos direcciones. La primera es directa. La segunda usa el lema del camino libre.
(⇒ de arista hacia atrás a ciclo.) Sea u → v una arista hacia atrás. Al mirarla, v está abierto. Los nodos abiertos forman un camino de aristas de árbol, y el último es u, el que se está visitando. Entonces hay un camino de v a u, de aristas de árbol. Si v = u, es un lazo, que ya es un ciclo. Si no, junto con u → v forma un ciclo.
(⇐ de ciclo a arista hacia atrás.) Sea C un ciclo. Sea x el nodo de C que empieza primero, y sea y su antecesor en el ciclo, de modo que y → x es una arista de C. Si el ciclo es un lazo, y = x. Cuando x empieza, los demás nodos de C están sin visitar, porque x fue el primero. Siguiendo C desde x se llega a y por nodos sin visitar: es un camino libre. Por el lema, y empieza y termina dentro del intervalo de x. Entonces, durante la visita de y, x sigue abierto. En esa visita se mira la arista y → x, y al mirarla x está abierto. Es una arista hacia atrás. ∎
Fíjense que la segunda dirección no dice que cada arista de cada ciclo sea hacia atrás. Dice que hay al menos una por ciclo. En el ciclo 0 → 1 → 2 → 0, solo 2 → 0 lo es.
test_examples.cpp lo prueba en 1500 grafos al azar, de hasta 9 nodos, comparando con una matriz de quién alcanza
a quién.
Orden topológico
Definición. Un orden topológico de un grafo dirigido es un orden de sus nodos en el que toda arista u → v va de un nodo a otro posterior. Si el grafo tiene un ciclo no existe, porque en un ciclo cada nodo tendría que ir antes que el siguiente, y al dar la vuelta un nodo iría antes que sí mismo. Un grafo dirigido sin ciclos se llama DAG.
El algoritmo es DFS, y una sola idea: lo que termina último va primero.
algoritmo orden_topologico(grafo, n)
    correr dfs_completo(grafo, n), agregando cada nodo a una lista cuando termina
    devolver esa lista al revés
fin algoritmo
No hace falta ordenar por tiempo de fin, porque los nodos van terminando en orden.
Afirmación. En un DAG, para toda arista u → v, fin[v] < fin[u]. Por lo tanto, el orden decreciente de fin es topológico.
Técnica. Casos sobre el estado de v cuando visitar(u) mira la arista.
- v sin visitar. Se visita v dentro de la llamada de u, así que termina antes: fin[v] < fin[u].
- v abierto. Sería una arista hacia atrás, y por el teorema anterior habría un ciclo. En un DAG eso no pasa.
- v cerrado. v ya terminó, y u todavía no, porque se está visitando. Entonces fin[v] < fin[u].
En los dos casos posibles, fin[v] < fin[u]. Así que en orden decreciente de fin, u va antes que v. ∎
Este es un DAG con 6 nodos, que podrían ser las tareas para armar un programa:
DAG: 0->1 0->2 1->3 2->3 2->4 3->5 4->5
  nodo  inicio  fin
     0       1   12
     1       2    7
     2       8   11
     3       3    6
     4       9   10
     5       4    5
  terminan en este orden: 5 3 1 4 2 0
  orden decreciente de fin: 0 2 4 1 3 5  es topológico
Si el grafo tiene un ciclo, el programa igual da una lista, sin ningún aviso:
Con un ciclo: 0->1 1->2 2->0 2->3
  orden decreciente de fin: 0 1 2 3  no es topológico
Error común. Sacar el orden sin comprobar antes que no haya ciclos. La lista siempre sale, y parece un orden. Si el problema no garantiza un DAG, hay que buscar aristas hacia atrás: el nodo abierto al mirar la arista avisa del ciclo durante el mismo DFS. O comprobar la lista al final, con
is_topological, que revisa todas las aristas en Θ(V + E).
Hay otra forma de sacar un orden topológico: ir quitando nodos sin aristas de entrada. Ustedes ya tienen lo necesario para escribirla. Sirve, pero lo que sobra al final no son solo los nodos del ciclo: también están los que dependen de ellos.
Componentes fuertemente conexas
Definición. Dos nodos u y v son mutuamente alcanzables si hay un camino de u a v y otro de v a u. Un nodo es mutuamente alcanzable consigo mismo, por el camino de cero aristas. Esta relación es reflexiva, simétrica y transitiva, así que parte a los nodos en clases. Cada clase es una componente fuertemente conexa (strongly connected component).
Un nodo que no está en ningún ciclo es una componente de un solo nodo. Un DAG tiene tantas componentes como nodos.
Definición. El grafo de componentes de G tiene un nodo por cada componente, y una arista de C a D, con C ≠ D, si G tiene una arista de algún nodo de C a alguno de D.
Afirmación. El grafo de componentes es un DAG.
Supongamos que tiene un ciclo que pasa por dos componentes distintas C y D. Entonces, desde un nodo de C se llega a uno de D, y desde ese de D se vuelve a C. Dentro de cada componente se llega de cualquier nodo a cualquier otro. Luego todos los nodos de C y de D son mutuamente alcanzables, y C y D serían una sola componente. Contradicción. ∎
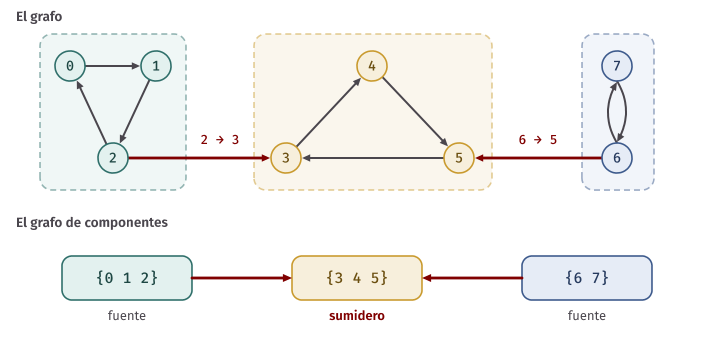
Esto da la imagen que hay que tener: todo grafo dirigido es un DAG de componentes. Y un DAG tiene al menos un sumidero (sink), un nodo sin aristas de salida, y al menos una fuente (source), un nodo sin aristas de entrada.
Este es el grafo de ejemplo, con sus tres componentes:
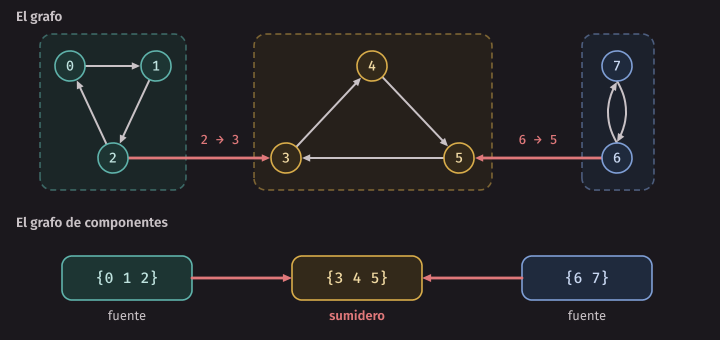
La idea
Si tuviéramos un nodo de una componente sumidero, sería fácil: un recorrido desde él alcanza exactamente su componente, porque de ahí no se puede salir. Se marca, y luego se hace como si no estuviera. Ahora hay otro sumidero entre lo que queda. Y así se sigue. El problema se reduce a esto: ¿cómo se consigue un nodo de una componente sumidero, en un orden que siga sirviendo después?
La respuesta usa los tiempos de fin, pero en el grafo invertido. Sea rev(G) el grafo con todas las aristas al revés. Tiene las mismas componentes que G, porque un camino de ida y vuelta sigue siéndolo. Y lo que en G es un sumidero, en rev(G) es una fuente.
Kosaraju-Sharir
algoritmo componentes(grafo, n)
    invertido ← el grafo con todas las aristas al revés
    correr dfs_completo(invertido, n), anotando los nodos en orden de fin
    comp ← arreglo de n valores -1
    actual ← 0
    para cada nodo r, en orden decreciente de fin, hacer
        si comp[r] = -1 entonces
            recorrer grafo desde r, por nodos con comp = -1, poniéndoles comp ← actual
            actual ← actual + 1
        fin si
    fin para
    devolver comp
fin algoritmo
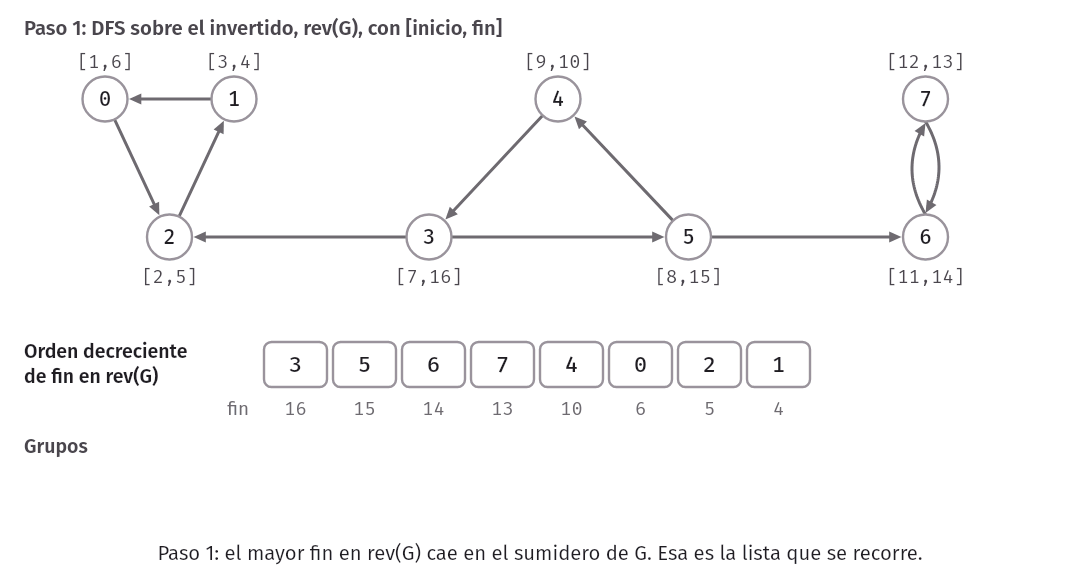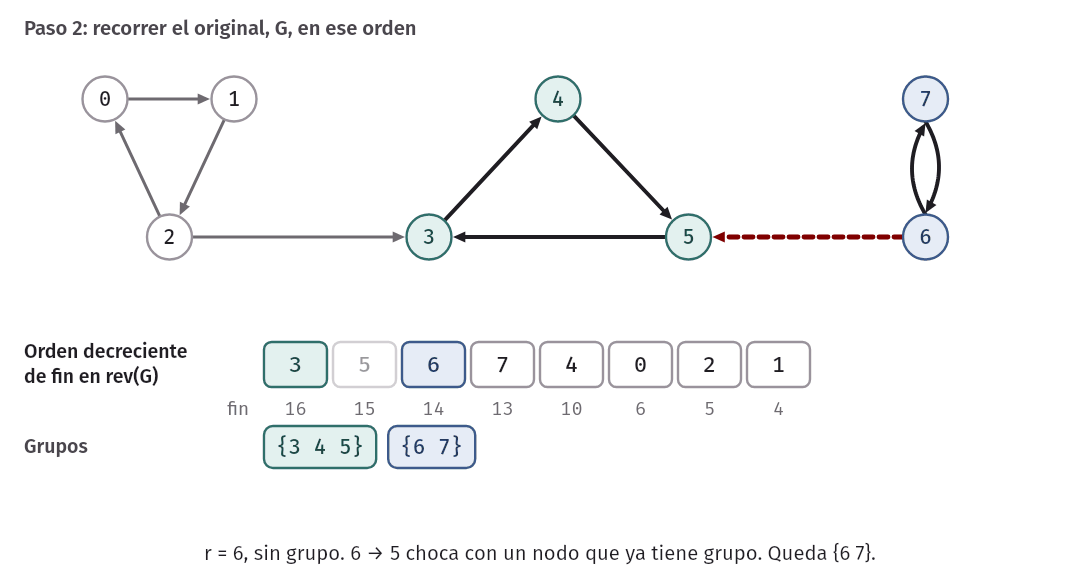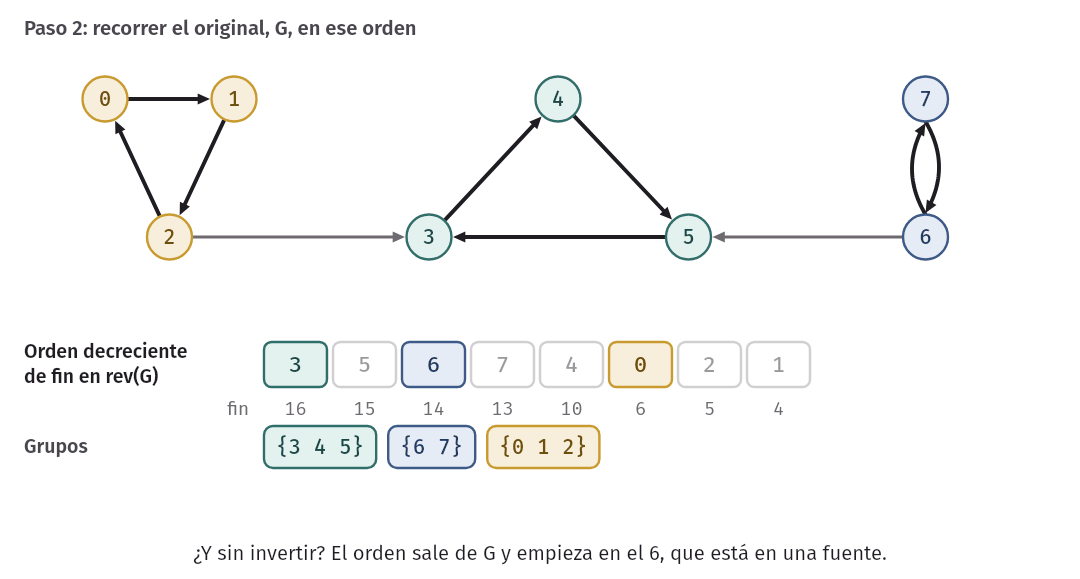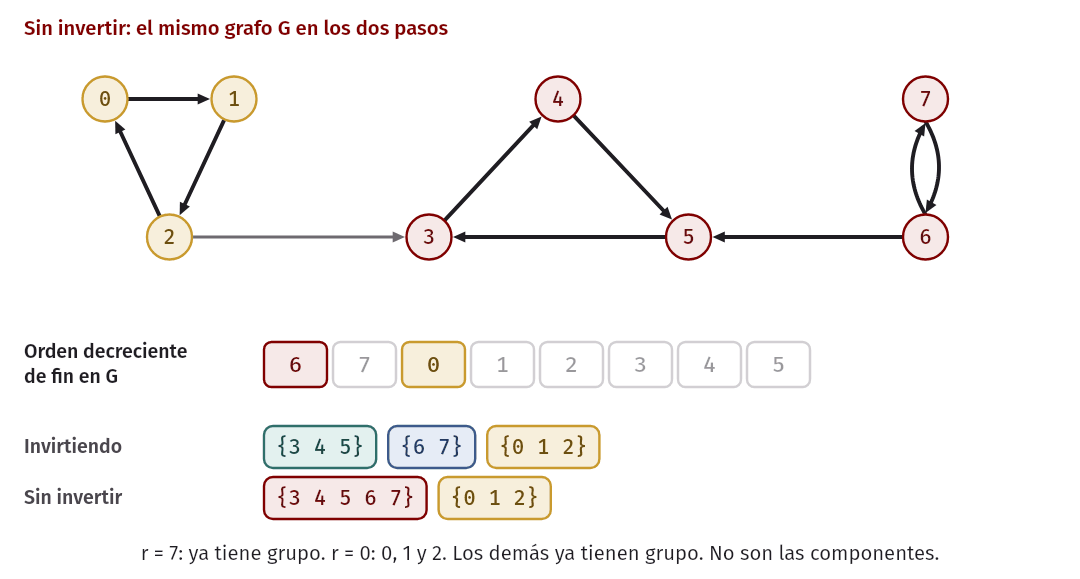
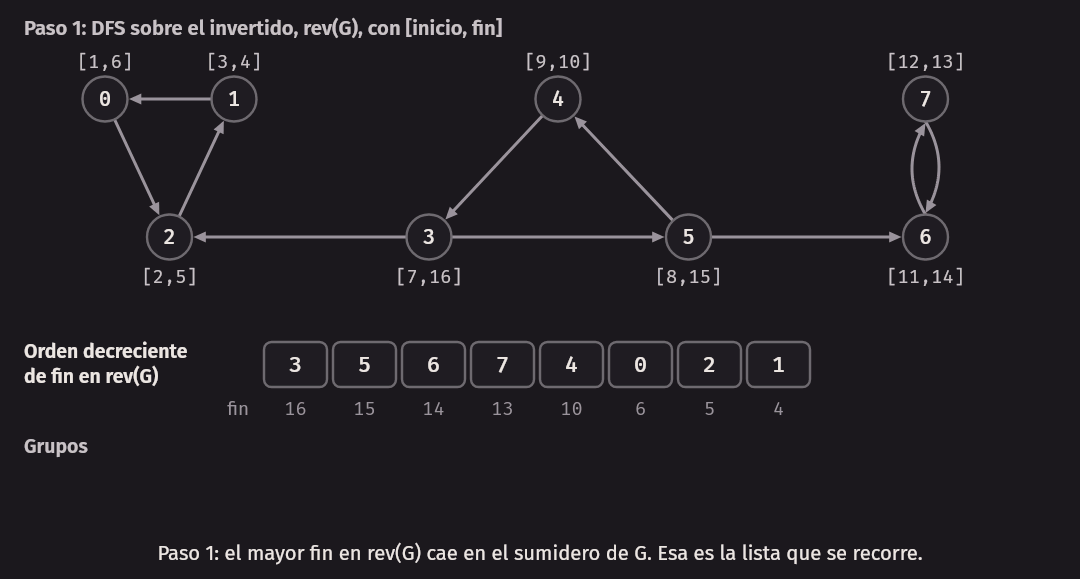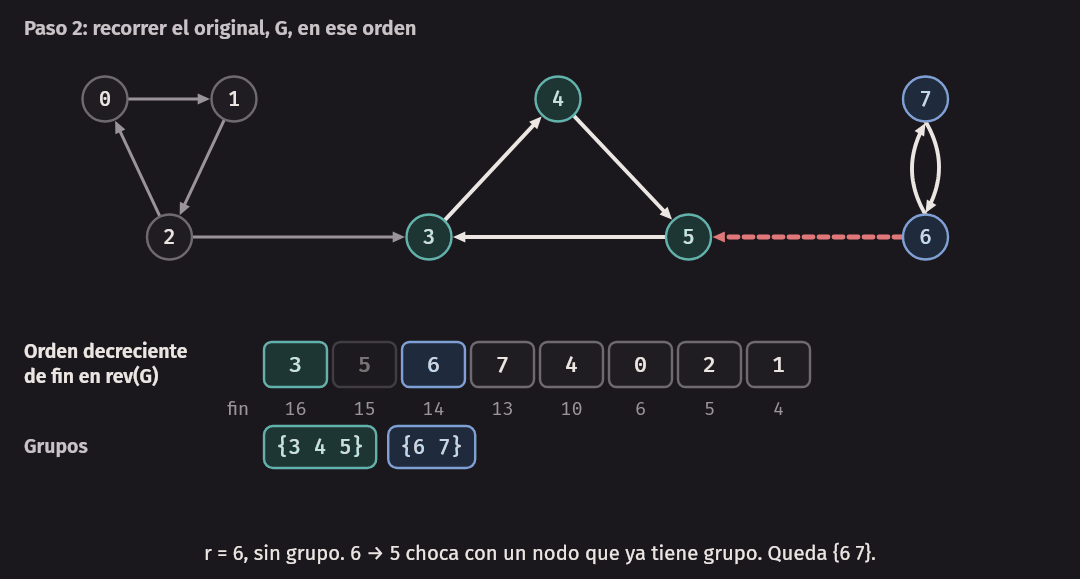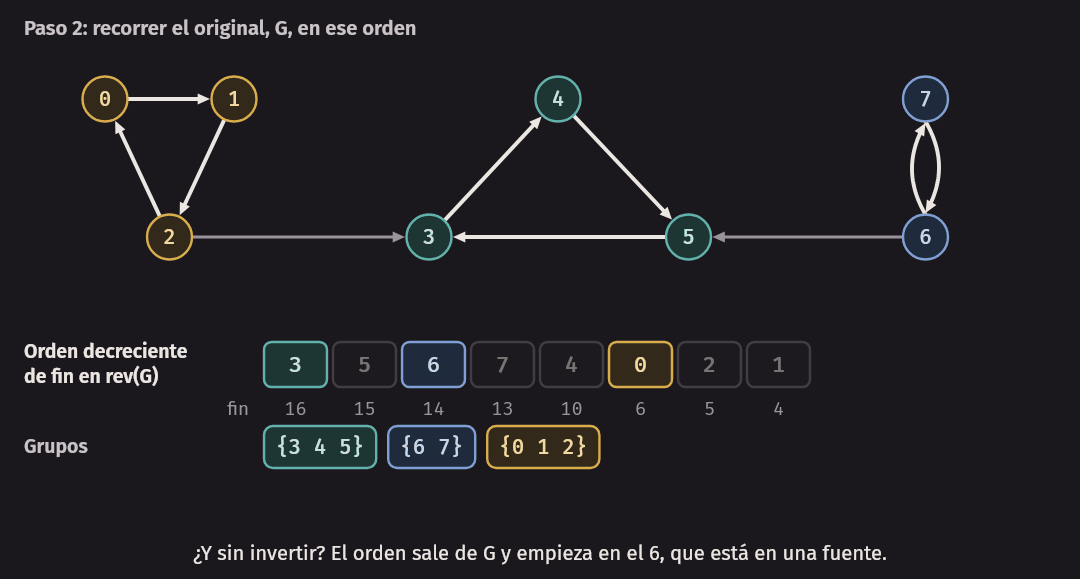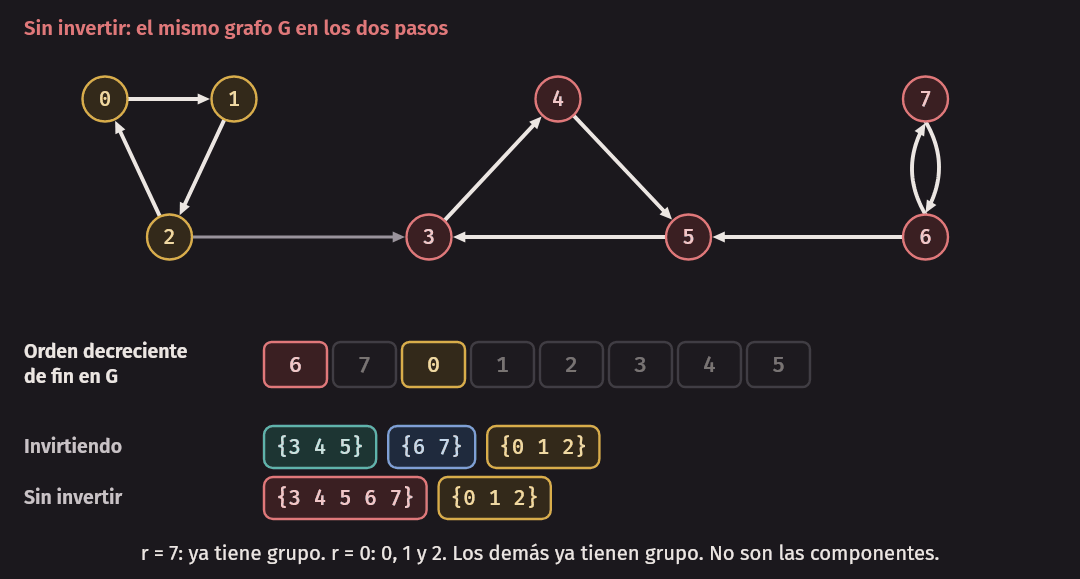
Esto es: DFS sobre el invertido para el orden, y recorrido sobre el original en orden decreciente de fin. Corramos el ejemplo.
$ build/scc_traces
Grafo: 0->1 1->2 2->0 2->3 3->4 4->5 5->3 6->5 6->7 7->6

Paso 1, DFS sobre el grafo invertido:
  nodo  inicio  fin
     0       1    6
     1       3    4
     2       2    5
     3       7   16
     4       9   10
     5       8   15
     6      11   14
     7      12   13
  terminan: 1 2 0 4 7 6 5 3
  orden decreciente de fin: 3 5 6 7 4 0 2 1

Paso 2, recorrer el original en ese orden:
  {3 4 5} {6 7} {0 1 2}
  por la definición: {0 1 2} {3 4 5} {6 7}

Grafo de componentes (numeradas como salieron):
  1->0 2->0
Sigamos el Paso 2 con la lista 3 5 6 7 4 0 2 1, sobre el grafo original:
| r | ¿Ya tiene grupo? | Recorrido en el original | Grupo |
|---|---|---|---|
| 3 | no | 3 → 4 → 5 → (3 ya tiene) | {3, 4, 5} |
| 5 | sí | ||
| 6 | no | 6 → 5 (ya tiene), 6 → 7 → (6 ya tiene) | {6, 7} |
| 7, 4 | sí | ||
| 0 | no | 0 → 1 → 2 → (0 ya tiene), 2 → 3 (ya tiene) | {0, 1, 2} |
| 2, 1 | sí |
El primer recorrido empezó en 3, en la componente sumidero, y no pudo salir. Los siguientes intentaron salir, por 6 → 5 y 2 → 3, y chocaron contra nodos que ya tenían grupo.
Por qué funciona
La demostración tiene dos partes. Primero, un lema sobre tiempos. Después, el teorema.
Fijemos un DFS completo sobre rev(G), y llamemos fin a sus tiempos. Para una componente C, sea fin(C) el mayor tiempo de fin entre sus nodos.
Lema. Si G tiene una arista de la componente C a otra componente D, entonces fin(D) > fin(C).
Técnica. Dos casos, según cuál de las dos componentes empieza primero en el DFS sobre rev(G). En rev(G), la arista va de D a C.
Sea x el primer nodo de C ∪ D que empieza en ese DFS. Cuando empieza, todos los demás nodos de C ∪ D están sin visitar.
Caso 1: x está en D. En rev(G), desde x se llega a todo D, porque D es una componente. Y usando la arista de D a C, se llega a todo C. Todos esos caminos pasan solo por nodos de C ∪ D, que están sin visitar. Por el lema del camino libre, todos los nodos de C ∪ D terminan dentro del intervalo de x. Entonces fin(D) ≥ fin[x], y todo nodo de C termina antes que x. Por lo tanto fin(D) > fin(C).
Caso 2: x está en C. En rev(G), desde x se llega a todo C por nodos sin visitar, así que todos terminan dentro del intervalo de x, y fin(C) = fin[x]. Desde x no se puede llegar a D en rev(G): si se pudiera, como en rev(G) hay una arista de D a C, C y D serían mutuamente alcanzables, y serían una sola componente. Los nodos que empiezan dentro del intervalo de x son alcanzables desde x, así que ningún nodo de D empieza ahí. Y tampoco antes, porque x fue el primero. Entonces todo D empieza después de que x termina, y fin(D) > fin[x] = fin(C). ∎
En palabras: siguiendo una arista de G entre componentes, fin aumenta. La componente con mayor fin no tiene aristas de salida hacia otra componente, porque esa otra tendría un fin mayor. Es un sumidero de G. Es exactamente lo que queríamos.
Teorema. Cada recorrido del Paso 2 marca exactamente una componente fuertemente conexa de G.
Técnica. Inducción sobre el número de recorridos.
Supongamos que los primeros t recorridos marcaron exactamente t componentes completas. Sea r el siguiente nodo sin grupo en orden decreciente de fin, y sea C su componente.
Por la hipótesis, lo marcado es una unión de componentes completas, y r no está marcado, así que ningún nodo de C está marcado. Como r tiene el mayor fin entre todos los no marcados, fin(C) = fin[r]. Además, si otra componente D tiene un nodo sin marcar, está toda sin marcar, y entonces fin(D) < fin(C).
El recorrido alcanza todo C. Desde r se llega a todos los nodos de C dentro de C, y están sin marcar.
El recorrido no sale de C. Sea v → w una arista de G con v en C y w en otra componente D. Por el lema, fin(D) > fin(C). Por lo que acabamos de decir, D no puede estar sin marcar. Entonces w ya está marcado, y el recorrido no pasa por ahí.
Luego este recorrido marca exactamente C. Por inducción, vale para todos los recorridos. Al final todos los nodos tienen grupo, porque el ciclo los revisa a todos. ∎
Hay dos cosas que salen gratis de la demostración:
- El Paso 2 no necesita un DFS. El argumento solo usa qué se alcanza, y por eso
label_in_orderes un recorrido simple, sin tiempos. - Las componentes salen de sumidero a fuente. Cada arista entre componentes va de una numerada más tarde a una numerada antes. Leídas al revés, las componentes están en orden topológico. En el ejemplo: {0 1 2} y {6 7} antes que {3 4 5}.
Costo. Invertir el grafo es Θ(V + E). El DFS y el recorrido son Θ(V + E) cada uno. Total: Θ(V + E).
inline std::vector<int> strong_components(const Digraph& g) {
    std::vector<int> order = dfs_iterative(reversed(g)).finish_order;
    std::reverse(order.begin(), order.end());
    return label_in_order(g, order);
}
test_examples.cpp compara el resultado con la definición, usando la matriz de alcanzables, en 3000 grafos al
azar, y comprueba también el lema, con los tiempos
de cada corrida.
Error común. Procesar el grafo sin invertirlo, y obtener componentes mezcladas.
components_without_reversingsaca el orden del mismo grafo:
Sin invertir:
  orden decreciente de fin en el original: 6 7 0 1 2 3 4 5
  {3 4 5 6 7} {0 1 2}
  no son las componentes
El mayor fin en el DFS sobre G cae en una componente fuente de G, no en un sumidero: es el lema, leído en el otro grafo. Aquí es el 6. Y un recorrido desde una fuente se lleva todo lo que puede alcanzar, 6 y 7 junto con 3, 4 y 5, que son otra componente. No hay ningún aviso. El programa da grupos que parecen razonables.
Existe una versión equivalente, la de CLRS: el orden sale del grafo original, y el recorrido se hace sobre el invertido. Funciona por lo mismo, cambiando G por rev(G), porque las componentes de los dos son las mismas. Lo que nunca funciona es usar el mismo grafo en los dos pasos. En este curso usamos siempre la versión de arriba, la del grafo invertido primero.
Idea clave. Un recorrido desde un nodo de un sumidero no se puede escapar de su componente. Todo el algoritmo es una forma de visitar las componentes de sumidero a fuente, sin saber cuáles son.
Recursión profunda: una pila que sí termina
En Estructuras de Datos vieron que un DFS recursivo sobre un camino largo agota la pila. Ahora ese problema es más serio, porque en esta sesión todo depende de DFS, y los grafos de un problema real pueden tener caminos larguísimos.
deep_recursion arma un camino de n nodos y lo recorre de las dos maneras. Se compila con -O2, como en el juez. El
límite de la pila es el que tiene el contenedor por defecto: ulimit -s responde 8192, en KB. Las corridas siguientes
se hicieron con bash -c, en ese mismo contenedor, para que quedara el mensaje del shell:
$ bash -c 'build/deep_recursion 100000; echo "código de salida: $?"' 2>&1
con pila explícita: terminaron 100000 nodos
con recursión: terminaron 100000 nodos
código de salida: 0
$ bash -c 'build/deep_recursion 1000000; echo "código de salida: $?"' 2>&1
con pila explícita: terminaron 1000000 nodos
bash: line 1: 69076 Segmentation fault      build/deep_recursion 1000000
código de salida: 139
El 69076 es el número del proceso, y cambia en cada corrida. Con un millón de nodos, cada uno con su marco de llamada,
los 8 MB no alcanzan. El programa muere sin un mensaje útil, y el juez lo reporta como RE. Cambiar el límite de la
pila no es una solución, porque el programa tiene que correr donde se lo pongan.
La versión con pila explícita guarda en cada elemento lo mismo que un marco de llamada: qué nodo es y por cuál de sus aristas iba. Eso es lo que permite saber cuándo termina un nodo: cuando se le acaban las aristas.
inline DfsTimes dfs_iterative(const Digraph& g) {
    int n = static_cast<int>(g.size());
    DfsTimes t;
    t.start.assign(static_cast<std::size_t>(n), 0);
    t.finish.assign(static_cast<std::size_t>(n), 0);
    int clock = 0;
    std::vector<std::pair<int, std::size_t>> stack;
    for (int root = 0; root < n; root++) {
        if (t.start[root] != 0) continue;
        t.start[root] = ++clock;
        stack.push_back({root, 0});
        while (!stack.empty()) {
            auto [u, next] = stack.back();
            if (next == g[u].size()) {
                t.finish[u] = ++clock;
                t.finish_order.push_back(u);
                stack.pop_back();
                continue;
            }
            stack.back().second++;
            int v = g[u][next];
            if (t.start[v] == 0) {
                t.start[v] = ++clock;
                stack.push_back({v, 0});
            }
        }
    }
    return t;
}
El auto [u, next] = stack.back() copia los dos valores, y por eso se pueden seguir usando después del
push_back, que puede mover la memoria del std::vector. Para avanzar la
posición sí se escribe sobre el elemento de la pila: stack.back().second++.
test_examples.cpp comprueba, en 1500 grafos al azar, que esta versión da los mismos inicios, los mismos fines y
el mismo orden que la recursiva.
Error común. Usar el atajo de meter todos los vecinos en la pila y anotar cada nodo al sacarlo. Se vio en Estructuras de Datos que eso visita los mismos nodos en otro orden. Ahora el problema es más grave: no da tiempos de fin, porque un nodo se saca antes que todo lo que cuelga de él. Con un grafo de tres nodos ya falla:
El atajo de la pila, en 0->1 0->2 1->2:
  pila con (nodo, siguiente), terminan: 2 1 0  al revés: 0 1 2  topológico
  atajo, orden al sacar: 0 2 1  no topológico
  atajo, al revés:       1 2 0  no topológico
El atajo saca el 0, mete 1 y 2, y saca el 2 antes de haber visto el 1. Ni esa lista ni la lista al revés sirven como orden topológico. Para saber qué se alcanza, el atajo va bien, y por eso se puede usar en el Paso 2. En el Paso 1, donde hacen falta tiempos de fin de verdad, no.
El código de la semana
| Archivo | Qué contiene |
|---|---|
mst.h |
UnionFind, kruskal, prim, dijkstra, las ideas que fallan, la fuerza bruta y el agrupamiento |
digraph.h |
DFS recursivo y con pila, tipos de arista, orden topológico, Kosaraju-Sharir y el error de no invertir |
mst_traces.cpp |
Kruskal y Prim paso a paso, y las ideas que fallan |
mst_vs_paths.cpp |
El contraejemplo del triángulo y la tabla de sumar una constante |
ties_demo.cpp |
Los empates del triángulo y del cuadrado |
clustering_demo.cpp |
Los ocho puntos, con k de 2 a 4 |
dfs_traces.cpp |
Tiempos, tipos de arista, orden topológico y el atajo |
scc_traces.cpp |
Kosaraju-Sharir y lo que pasa sin invertir |
deep_recursion.cpp |
La pila explícita contra la recursión, sobre un camino largo. No entra en make test |
mst_bench.cpp |
La medición de Kruskal y Prim, con make bench |
test_examples.cpp |
Las pruebas de lo que afirma este capítulo |
Las pruebas se compilan con -g -fsanitize=address,undefined. Las mediciones y el programa que agota la pila van
con -O2 y sin sanitizers.
$ make test
mkdir -p build
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined mst_traces.cpp -o build/mst_traces
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined mst_vs_paths.cpp -o build/mst_vs_paths
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined ties_demo.cpp -o build/ties_demo
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined clustering_demo.cpp -o build/clustering_demo
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined dfs_traces.cpp -o build/dfs_traces
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined scc_traces.cpp -o build/scc_traces
g++ -Wall -Wextra -std=c++20 -g -fsanitize=address,undefined test_examples.cpp -o build/test_examples
g++ -Wall -Wextra -std=c++20 -O2 mst_bench.cpp -o build/mst_bench
g++ -Wall -Wextra -std=c++20 -O2 deep_recursion.cpp -o build/deep_recursion
build/test_examples
Todas las pruebas de la semana 6 pasaron.
Estas pruebas comprueban, entre otras cosas, lo siguiente:
- Sobre el grafo de la clase, Kruskal, Prim desde cada nodo y la fuerza bruta dan 43. Las tres ideas que fallan, fallan.
- La propiedad del corte, en sus dos versiones. Con pesos distintos, la más barata de cada corte está en el único árbol mínimo. Con empates, F más e cabe en un árbol mínimo, para todos los F, los cortes y las aristas que se probaron.
- Kruskal, con la lista en dos órdenes, y Prim, desde cada nodo, coinciden con la fuerza bruta en 600 grafos al azar, con muchos empates, y en un tercio de ellos con pesos negativos.
- Prim nunca mete más de E entradas en la cola.
- El árbol mínimo no contiene el camino mínimo en el triángulo. Sumar una constante no cambia los árboles mínimos, en 200 grafos al azar.
- Agrupar coincide con la mejor partición en 300 grafos al azar, para todo k.
- Los tiempos del ejemplo, los tipos de arista, que los intervalos se anidan y que hay arista hacia atrás si y solo si hay ciclo.
- En un DAG, fin[v] < fin[u] para toda arista u → v. El atajo de la pila no da un orden topológico en el grafo de tres nodos.
- Kosaraju-Sharir coincide con la definición en 3000 grafos al azar, las componentes salen de sumidero a fuente y se cumple el lema. Sin invertir, sí hay grafos en los que falla.
Los problemas de laboratorio
Esta semana hay dos, y cada uno tiene su enunciado, un esqueleto y sus casos: entren a la carpeta y corran make test.
lab/network_design, Diseñar una red: el costo mínimo de conectar las sedes de una empresa, o decir que no se puede. Hagan la cuenta del costo total antes de elegir tipos de datos.lab/curriculum, Los prerrequisitos de una malla: el mínimo de semestres para terminar una malla, o la lista de cursos atrapados en un ciclo. Lean con cuidado qué significa “atrapado” en el enunciado, y piensen en lo que pasa con un caso de recursión profunda. Uno de los casos es la propuesta de malla de la carrera.
Resumen
- Un árbol de expansión mínima conecta todos los nodos con el menor peso total. Es un árbol: V − 1 aristas, un solo camino entre cada par.
- Propiedad del corte, pesos distintos: la arista más barata que cruza un corte está en todo árbol mínimo. Por intercambio: el camino de T entre sus extremos cruza el corte en alguna f, y T − f + e es un árbol más barato. El árbol mínimo es único.
- Con empates: si F está en un árbol mínimo, el corte respeta a F, y e es de peso mínimo entre las que lo cruzan, entonces F ∪ {e} está en algún árbol mínimo. El F es necesario para que las elecciones del greedy quepan todas juntas.
- Kruskal: de la arista más barata a la más cara, con union-find. El corte es el grupo de un extremo. O(E log E).
- Prim: crecer un árbol con una cola de prioridad y borrado perezoso. El corte son los nodos del árbol. Cada arista entra a la cola a lo sumo una vez. O(E log V) en un grafo simple.
- Prim y Dijkstra tienen casi el mismo código y otra clave: el peso de la arista, contra la distancia desde el origen.
- Un árbol mínimo no da caminos mínimos. Sumar una constante no cambia el árbol mínimo, porque todos los árboles tienen V − 1 aristas, y sí cambia los caminos mínimos, porque tienen distinto número de aristas.
- Agrupar: quitar las k − 1 aristas más caras de un árbol mínimo da la mayor separación posible.
- DFS con tiempos: los intervalos se anidan. El lema del camino libre dice qué se visita dentro de cada llamada.
- Tipos de arista: de árbol, hacia atrás (a un nodo abierto), hacia adelante, de cruce. Hay arista hacia atrás si y solo si hay ciclo.
- Orden topológico: decreciente de fin. En un DAG, u → v implica fin[v] < fin[u]. Con un ciclo la lista sale igual, y no vale: hay que revisar.
- Componentes fuertemente conexas: forman un DAG. Kosaraju-Sharir: DFS sobre el invertido para el orden, y recorrido sobre el original en orden decreciente de fin. Si G tiene una arista de C a D, fin(D) > fin(C). Así que cada recorrido empieza en un sumidero de lo que queda y no se escapa. Θ(V + E).
- Sin invertir salen componentes mezcladas, sin aviso.
- Recursión profunda: un DFS recursivo sobre un camino largo agota la pila. La pila explícita de (nodo, siguiente arista) da los mismos tiempos. Meter todos los vecinos, no.
Ejercicios
- Corran a mano Kruskal y Prim desde el nodo 6 sobre el grafo de la clase, escribiendo las tablas. ¿Las aristas
son las mismas? ¿Salen en el mismo orden? Comprueben con
mst_traces.cpp, cambiando el origen. - Propiedad del ciclo. Con pesos distintos, demuestren por intercambio que la arista más cara de un ciclo no está en ningún árbol de expansión mínima. Después, usen eso para justificar en una línea por qué Kruskal puede rechazar una arista sin perder nada.
- Si los pesos son distintos, el árbol mínimo es único. ¿Vale lo contrario? Den un grafo con pesos repetidos y un
solo árbol mínimo, y compruébenlo con
all_minimum_trees. - Sin empates, por perturbación. Sumen a cada peso un número muy pequeño y distinto, de modo que los pesos queden distintos y se conserve el orden entre pesos que ya eran distintos. Demuestren que el árbol mínimo del grafo perturbado es un árbol mínimo del original. Comparen con la demostración de la versión general: ¿cuál prefieren?
- El peor tramo. Demuestren que, en un árbol de expansión mínima, el camino entre u y v minimiza el peso de su arista más cara, entre todos los caminos de u a v en el grafo. Esto es lo que sí da un árbol mínimo, en lugar del camino mínimo. Compruébenlo por fuerza bruta con grafos pequeños al azar.
- Árbol de expansión máxima. Adapten
kruskalpara hallar el árbol de expansión de mayor peso, y justifiquen por qué basta con eso, usando lo que se dijo sobre pesos negativos y sumar una constante. ¿Qué cambia en Prim? - Cambien
primpara meter una entrada solo si mejora la mejor clave que se conoce de ese nodo. Demuestren que sigue siendo correcto. Corranmst_benchy comparen entradas y descartes con la tabla de arriba. ¿Cambia el orden de costo? - Sigan
visitara mano sobre el grafo con aristas 0 → 2, 1 → 0, 2 → 1, 2 → 3, 3 → 4, 4 → 3, 5 → 4. Escriban los tiempos y el tipo de cada arista. Comprueben endfs_traces.cpp. - Grafos no dirigidos. Demuestren que, en un DFS sobre un grafo no dirigido, ninguna arista es de cruce, y que toda arista es de árbol o une un nodo con un antecesor. ¿Qué parte de la tabla de tipos usaron?
- Orden único. Demuestren que un DAG tiene exactamente un orden topológico si y solo si tiene un camino que
pasa por todos los nodos. Escriban una función de costo Θ(V + E) que lo decida, usando
reverse_finish_order. - Corran Kosaraju-Sharir a mano sobre un grafo de 6 nodos de su elección, con al menos dos componentes de más de un nodo. Después, corran también la versión de CLRS: el orden del original y el recorrido en el invertido. Demuestren que las dos dan las mismas componentes y digan en qué orden sale cada una.
- Un nodo que llega a todos. Demuestren que, si algún nodo alcanza a todos los demás, el último nodo que
termina en un DFS completo también los alcanza a todos. Escriban una función que halle un nodo así, o diga que
no existe, en Θ(V + E) y sin recursión, y pruébenla contra
reach_matrix.